Claude 水印这事,这两天刷屏了,而且舆论明显分裂:一边是"以后用 AI 写东西会不会被查出来"的恐慌,一边是疯狂给一个叫 watermarks-remover 的开源去水印项目点星——截至 8 月 24 日,它已经拿到了 1.75 万星。
先把结论放前面:你每天在用的 Claude,此刻大概率还没有水印——但缓冲期不会太长。这篇把"水印怎么打、打到谁、查得到什么、查不到什么"一次说清楚。
事情是怎么开始的
8 月 2 日起,欧盟 AI 法案的透明度条款(第 50 条)生效:面向欧盟市场的 AI 公司,必须给 AI 生成或编辑的内容打上机器可识别的标记。TechCrunch 7 月,包括 OpenAI、Google、Meta、微软在内,约 190 家机构签署了《AI 生成内容透明度行为准则》。Anthropic 官方 8 月 11 日,有媒体率先曝出 Anthropic 确认了水印计划;8 月 14 日,官方干脆发了长文,把原理、范围、限制全部摊开讲。
注意一个细节:这不是欧洲特供,官方明说"因为还没有可靠的办法按地区区分,所以全球范围一起上"。Anthropic 官方
先说最关键的:你正在用的模型还没轮到
水印的分界线是 2026 年 8 月 2 日:
之后发布的模型:出厂自动带水印;
之前发布的模型:有过渡期,陆续补装。
官方的口径是:8 月 2 日之后发布的所有 Claude 模型支持打标,老模型"未来几个月"补上。The Decoder 翻译一下:你现在能用的主力模型——包括 7 月 24 日刚发布的 Opus 5——全部在 8 月 2 日之前发布,也就是说此刻还没有水印。小红书上也有博主自己扫了输出字节,确实一个隐形字符都没找到。小红书
但别把这当成豁免,这是倒计时。而且水印是模型级别的:Claude 平台、API、Claude Code、Claude Cowork、Claude Tag 全部覆盖,复制粘贴时水印也会跟着文字走,还可能扛过一部分编辑。TechCrunch
水印是怎么打进文字里的
官方的解释其实挺优雅,一句话版本:不改内容,只改"运气"。大模型写字是一个词一个词往外蹦的,很多位置上几个候选词意思几乎一样——官方举的例子是"天气很冷,天空是 overcast 还是 grey"——选哪个对读者没区别,原本就靠随机数决定。水印做的事,就是把这个随机数换成"密钥 + 前文"算出来的序列。读者读起来毫无感觉,但拿着密钥的人可以做统计检验:这段文字的用词模式,像不像用这把钥匙生成的。
这套方法叫 SynthID-Text,是 Google DeepMind 2024 年发表在 Nature 上的方案,思路源头可以追溯到 Scott Aaronson 2022 年的提议。Nature
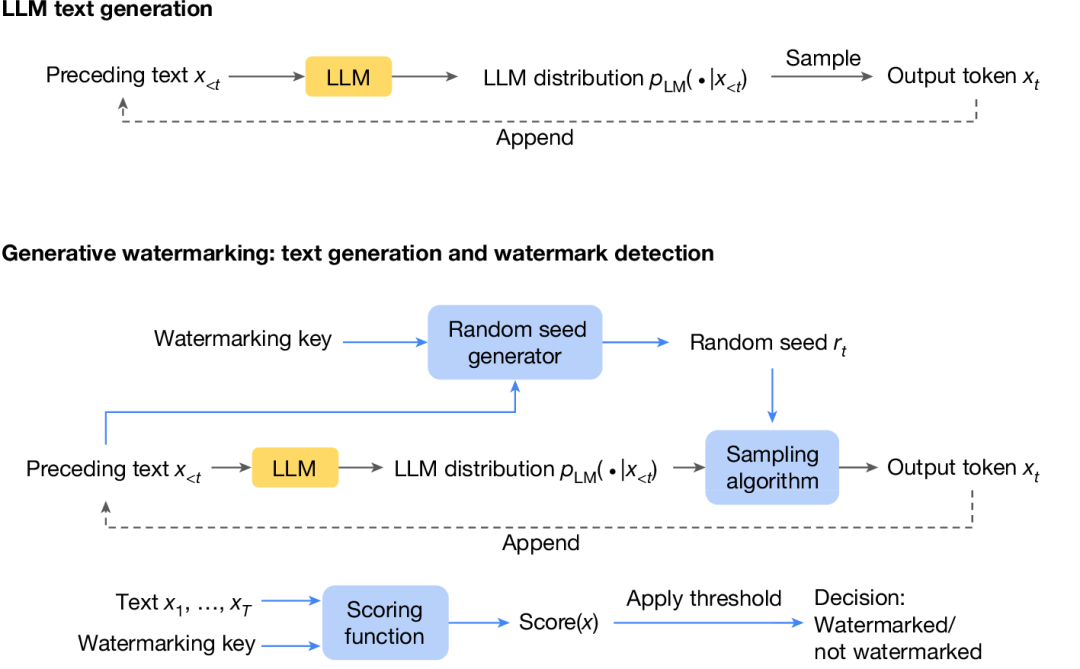
官方同时给了几个承诺:不影响输出质量、不加隐藏字符、不加价不降速、不含任何身份信息,也无法追溯到具体的人、组织或对话。Anthropic 官方 图片类输出走的是另一条路:C2PA 元数据凭证,相当于给文件附一张加密签名的"出生证明",任何支持 C2PA 的工具都能读。至于怎么查,官方说会推出水印检测 API,时间——“很快”。
但承诺不是所有人都买账
Markdown 的共同创造者 John Gruber 写了长文开炮:没有两个同义词意思完全相同,让密钥而不是语义来决定选哪个词,等于允许系统偶尔把一个更差的词推上去,"毫无影响"这个说法就是错的。The Decoder
他还怼了官方引用的点赞/点踩实验——用这个衡量质量本身就不靠谱:"没人会因为聊天机器人把菠萝写成香蕉就点踩。"他甚至怀疑,Gemini 口碑一直弱于 Claude 和 ChatGPT,部分原因就是 SynthID 水印早就在 Gemini 上开着。The Decoder
Reddit 上更热闹,直接吵成两派。恐慌派的一位用户留下了被广泛转发的一段话:被抓的会是让 Claude 重排一段话的学生、让 AI 总结 200 页采访录音的记者、卡文时找同义词的作者,“他们走出这个流程时,额头上多了一个数字纹身”。TechCrunch
另一边毫不留情:“看看这人吧”“先深呼吸”“你连骂 Claude 都要用 Claude 来写”。支持派最狠的一句话,是反问为什么会有人反对:“这件事根本找不到反对的理由,除非你想骗人”。TechCrunch
水印到底能查出什么:比你想的弱得多
这部分官方倒是罕见地老实,限制一条条写得很清楚:
它只能回答"这段文字有 Claude 参与的概率",不能证明是谁写的,也认不出别的 AI——别家用不同的密钥,甚至完全不同的方法;
文本太短查不准,越长置信度越高;
事实密集的段落水印很稀——"牛顿最著名的著作叫 Principia……"后面只能是 Mathematica,没有选择空间,水印无处下手;
让 Claude 只做语法和标点校对,水印可能稀到检测不出来;
代码的水印比一般文字稀得多——语法只有一种写法是对的,水印主要藏在注释这种可写可不写的地方;
翻译相反,全篇都带水印,因为每个词都是 Claude 选的;
轻度编辑去不掉水印,但整篇重写、每个词都换掉就可以——官方还补了一句:都重写成这样了,还能不能叫 AI 生成,本身就存疑。Anthropic 官方
另外提醒一句:水印和 Pangram 这类第三方 AI 检测工具是两回事。检测工具没有密钥,靠的是 AI 的行文腔调做判断——比如 AI 偏爱"这不是 X,而是 Y"这类句式——误报率完全不是一个量级。
13 天 1.75 万星:去水印项目爆火
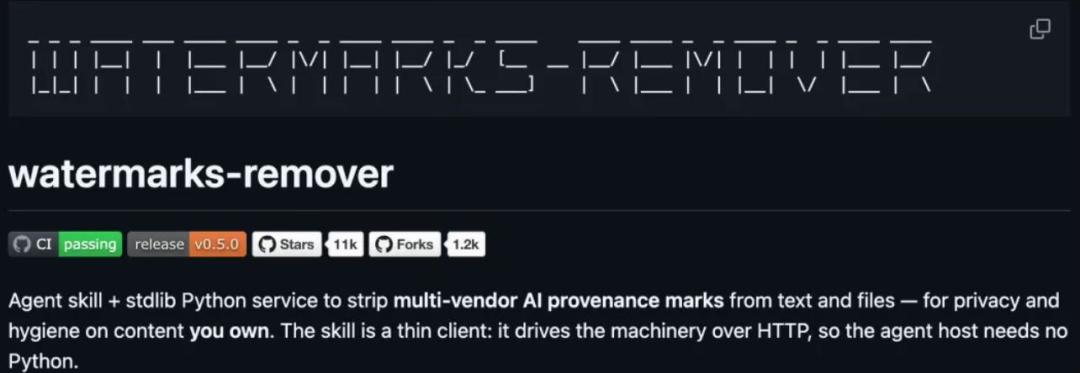
最戏剧性的是时间线:8 月 11 日消息曝出当天,GitHub 上就出现了一个叫 watermarks-remover 的开源项目,到 8 月 24 日已经拿到 1.75 万星——这个速度超过绝大多数明星开源项目。它针对的也不只是 Claude:Unicode 文本清理、统计重写钩子、C2PA 元数据剥离,一条流水线能带走好几家 AI 的痕迹。GitHub
另有 Declaude 这类改写工具。其开发者 James Padolsey 直接批评欧盟规则"任意",认为它"主要打到普通用户,对故意规避的人没什么用"。The Decoder 社区里流传的项目截图,星标徽章还停在 11k,那是几天前的快照——截至发稿实测已经是 17,523 星,涨速本身就是焦虑程度的最好证明。
这场猫鼠游戏值得看,但不建议把它当解决方案:水印的密钥在 Anthropic 手里,规则可以持续更新。而对国内用户来说,真正的风险从来不是欧盟法规,而是平台、期刊、客户自己越来越严的 AI 披露要求。
落到不同的人,怎么处理
内容创作者/自媒体:检测命中不等于"整篇 AI 写的",但平台不会跟你细究。保留创作证据链——大纲、素材、修改历史,比任何去水印工具都可靠。订阅平台 Substack 上个月已经和 Pangram 合作,专门标记 AI 生成的内容,其 CEO 甚至发明了"Claudefishing"这个词来形容用 AI 量产内容的行为。TechCrunch
学生/科研:别把 Claude 的段落直接交上去。水印本身告不了你,但学校和期刊的 AI 披露规则可以,而且正在变严。
办公党:让 Claude 只帮你润色、校对,水印稀到基本查不出来,不用焦虑;真让它整篇代写,那有没有水印都是另一回事了。
程序员:Claude Code 写的代码本体水印很稀,影响小;但 commit message、PR 描述、README 这类自由文本在覆盖范围内,提交前过一眼。
企业/法律场景:两个点要留意。一是水印跟着文字走,复用旧模板会把带标记的段落一起继承,多个模型协作时一份文件里可能叠着几种水印;二是检测 API 在路上,届时"AI 参与度"会变成可验证的数字——合同里禁用 AI 的条款、按工作量谈价的场景,都会被它影响。
接下来盯什么
三件事:官方检测 API 的落地时间(目前只有"soon");老模型打标的具体排期;以及签了准则的约 190 家机构里,OpenAI、Google、Meta 们的水印什么时候跟上——那才是真正改变游戏规则的时刻。TechCrunch
一句话总结:这个水印不锁人,只锁文字,而且暂时还没锁到你正在用的模型。但文字会流动,"复制粘贴即交付"的日子,确实开始倒计时了。