这10天,本地大模型圈被一批新机器刷屏:2L上下的小盒子,焊着192GB统一内存,售价奔着5万去,宣传口径是"完全离线本地跑320B大模型"。极摩客EVO-X5 Pro的测评视频2万多播放、120条评论,一半在算账。另一边,小红书资讯帖预告10月23日DGX Spark 64GB开售、$4999起——旧门票刚铺货,新门票就进场。这篇只回答一个问题:46999买到的到底是什么,哪里和你下单前的想象不一样。哔哩哔哩小红书
第一本账:门票——46999到底买了什么
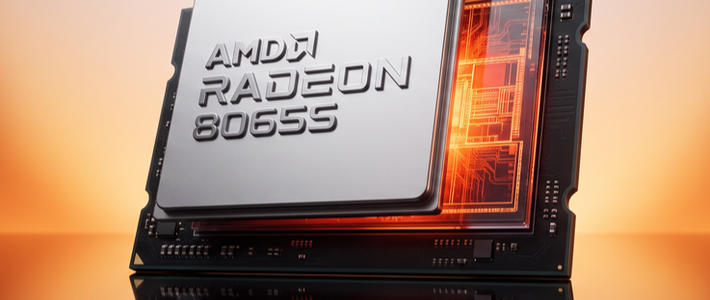
9月30日AMD媒体沟通会把方案摆上桌:锐龙AI Max+ PRO 495(代号Gorgon Halo),16核32线程Zen 5、40计算单元Radeon 8065S核显,LPDDR5X-8533、带宽约273GB/s,VGM可变显存最多把160GB内存划给GPU——上一代395的上限是128GB内存、96GB显存。官方的卖点是"全球首款能以4bit量化在本地跑超3000亿参数模型的x86客户端处理器"。知乎
但口径里夹着三行小字:
这代本质是Refresh:“CPU还是Zen 5,GPU还是40单元的RDNA 3.5,核心并没有动,只有内存容量这一项算硬升级”(知乎10月11日沟通会实录文)。容量翻倍的成本直接写在价签上——TOPC自己的口径:192GB的495,价格是128GB的395的两倍。知乎小红书
首批全是PRO商用型号,面向企业和专业市场;不带PRO的消费版"预计今年晚些时候"才出。知乎
内存正处涨价周期:同一时期,DDR5 32GB套装从900元涨到3800、DRAM合约价单季涨58%到63%,创十五年新高。192GB焊在板上不是厂商黑心,但你确实在内存高位接盘。
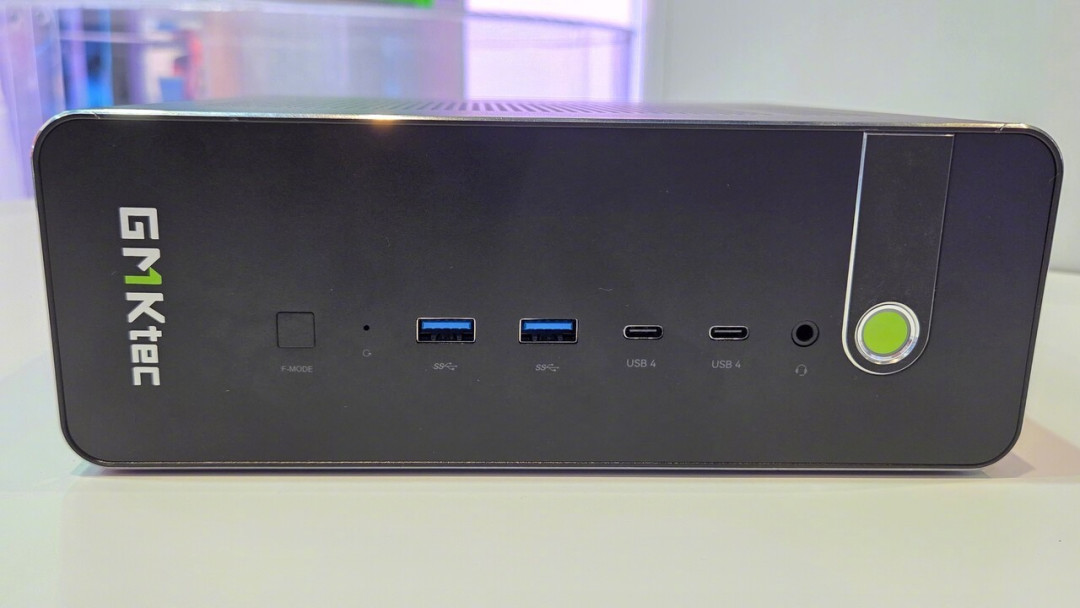
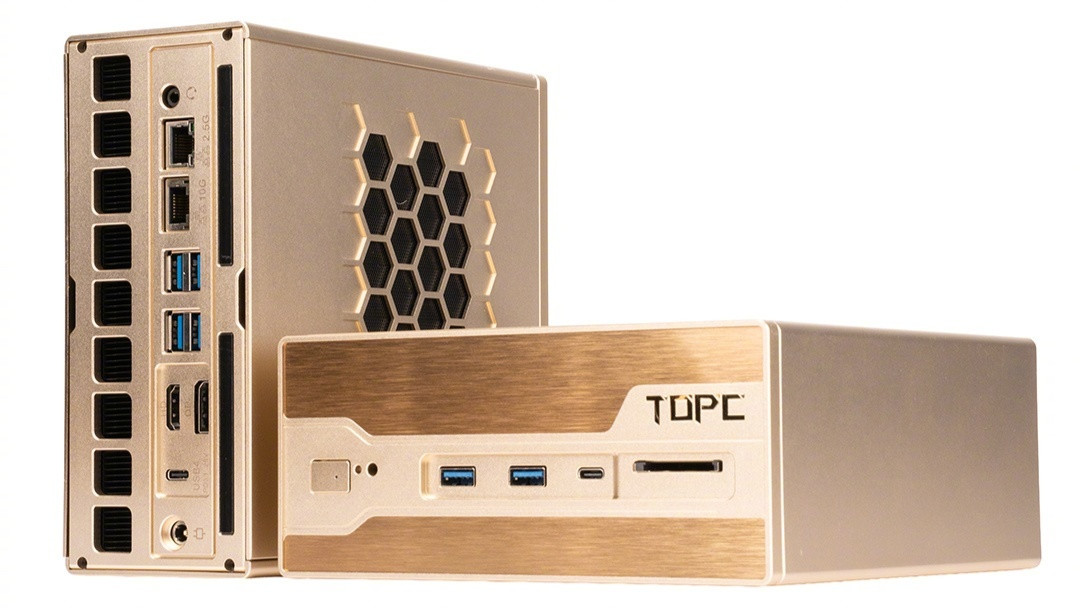
价签摆齐:极摩客EVO-X5 Pro 192G+2T首发46999、192G+4T卖49999,出自10月9日的极摩客×AMD×京东联合发布会。TOPC TXA2-495 45999起,2.5L、4个M.2、万兆、双USB4。还有阿迈奇F9A、铭凡MS-S1 Max-P495、磐镭、Framework Desktop、超聚变FusionXpark M495——同一颗芯片挤了七八个盒子。测评视频评论区的高赞画风:“省流 46999 起”“这价钱都可以买两台395了”“打个对折差不多”。哔哩哔哩小红书知乎
还有一条很实在的下单摩擦:本来要下单,最后卡死在不能用优惠券上。哔哩哔哩
第二本账:带宽——四组数字摆进同一张表
同一颗495,跑同一档模型,报出来的速度差在哪?
AMD官方(192G、VGM 160G):GLM-5.3-Flash 320B 4bit,最高20 tok/s;Qwen3.8-Flash-Next(125B主参+51B嵌入),最高42 tok/s。知乎
阿迈奇F9A官方实测(10月19日微博):320B跑14.57 tok/s;122B的Qwen3跑31.30 tok/s、首Token约1秒;20B的GPT-OSS跑85.68 tok/s、首Token 0.32秒。微博
极摩客测评转报(10月19日B站,DeepSeek-V4-Flash 284B Q4):短提示约16 tok/s;1万token输入,首字要等97秒;Qwen3.8-Flash-Next开1M上下文能到60 tok/s。同视频另一条自报更狠:“实测吐字速度只有40多,几乎没有实用价值。”
第三方控制对照(知乎10月15日:128GB的395整机 vs 4060Ti 16G+128G内存老工作站,Strata同版本、权重SHA逐片相同,跑111GB的Flash-Next):解码中位44.8对31.9 tok/s。约4K输入时395更快,到约32K输入,反而是4060Ti整机的预填充和总等待占优;600—900字方案文档一轮,两边都没及格,各有一轮把8192输出预算耗完、正文为空。知乎
读懂这四组数,先拆"320B"的口径:320B是总参数,速度取决于激活参数和内存带宽——所以14到20 tok/s和85 tok/s都是真的,它们说的是同一台机器上不同大小的激活量。“能跑320B"成立,但它的意思是MoE+4bit、慢速常驻,不是 dense 模型那种世界。真正的分水岭在输入端:273GB/s的总线,评论区转报1万token输入首字要等97秒,意味着这机器吃的是长会话、低输入频次的活。小红书评论里吵得最凶的就是这一条——编程Agent"300:1的输入输出比、98%以上缓存率,云端8小时搞完的活本地要一两天”;反方顶回去:"prefill纯靠算力,凭什么要求迷你主机和机架卡一个算力。"两句话都值得记下:它的甜区是24小时挂着Flash系MoE跑长驻任务,不是高频大输入的Agent工位。微博哔哩哔哩
第三本账:生态——纸面数字和你能拿到的数字差一截
开源项目SnowLLM直接发文:现有推理框架大多为别的GPU写,搬到这颗芯片"只发挥了大约一半左右的性能"。知乎
NPU暂时用不上:Linux NPU驱动还未支持;小红书热评说得更糙——“模型不按AMD的NPU优化,大部分时间你只能用它GPU或CPU那一部分,只能作为验证机”。小红书
Windows要留约32GB给系统、想跑满建议换Linux(B站评论区转报)。
极摩客发布会之外已经有人给出B端用法:20台EVO-X5 Pro同平台组网,做私有化AI实训算力池。也有人给出垂直用法:“跑LLM不行,跑MiniMax H3生成视频倒是不错。”哔哩哔哩
官方口径自己也留了余地,要看首批机器的实际评测和驱动完善情况再做决定。也就是说,今天卖46999的,是一台"容量确定、速度待验证、生态打折"的机器。知乎
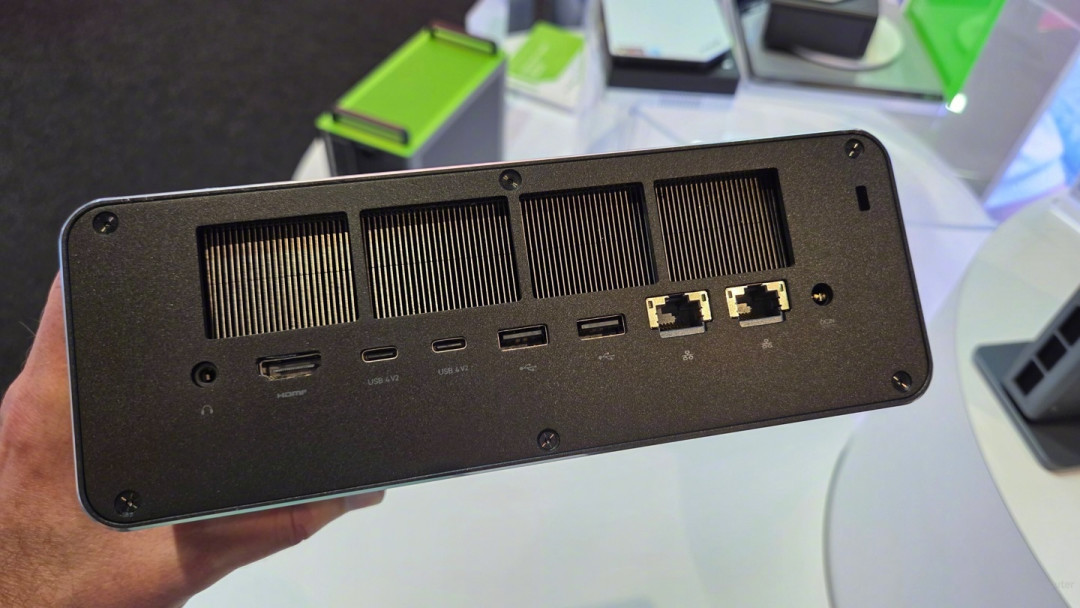
同一张预算表:4万7还能怎么花
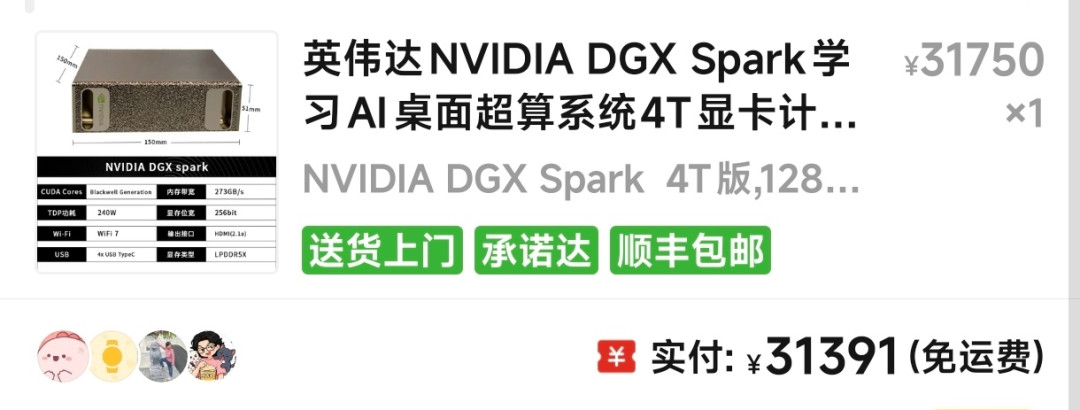
DGX Spark 64GB:10月23日开售、$4999起(小红书10月18日资讯帖)。容量装不下满血320B,但原生CUDA、生态不用打折,评论区已经站队:"这价格必然选spark。"两种门票:买容量,还是买生态。小红书
RTX Spark系笔记本(华硕ProArt创16等,10月19日微博官方还在推"至高支持120B本地运行"、火热开售):128GB、能带走,和桌面盒子错位竞争。微博
DIY多卡自报阵营:两张2080Ti+128G DDR3跑Flash"60tps";5070Ti 16G显存+96G内存Strata Q3"能到80t/s";48G魔改4090单请求27B"92.2 tok/s"。全是自报没有第三方控制,但方向一致:单卡+内存卸载的每块钱吐字速度更快。对照实验的另一半真相也得说——权重过百GB后,老4060Ti们要等234秒的"备忘录"甚至空手而归,DIY不是零成本。哔哩哔哩
纯云端:“搞个NUC,省下来的钱买API,绝对能用到内存降价”——这条高赞评论,是4万7账单的另一面。
结论:三个判断
"320B门票"是真的,但夹着四行小字:只有MoE+4bit跑得动、容量到位而带宽没到位、软件生态打对折、内存正处涨价高点。证据覆盖官方自测×1、厂商自测×1、测评转报×1、第三方控制对照×1、百条评论墙,尚无满一个月机主持仓帖,结论只能说到"能跑但交活打折"这一层。
适合掏钱的:数据不出域的24小时离线场景、学校/实训池组网、挂着Flash-Next跑长驻任务且不苛求首字速度的重度本地党。45999—49999的价格带里,首发优惠与券规则(目前不少机型不能用券)值得先问清再下单。
不合适的:追单请求速度、跑大输入编程Agent、顺便还想打游戏的——这台不是你最好的座位。继续盯三个日子:10月23日Spark 64GB实售价、AMD消费版非PRO型号落地、框架优化进度(SnowLLM说的"一半性能"缩不缩水)。
把"能跑320B"翻译成"每天几点能拿到什么活",是这台机器现在唯一值得吵的问题。评论区欢迎晒你的账单和首字延迟。