用 AI 写周报、写公众号、写方案的人,多半都挨过同一句追问:
“这你自己写的?”
不是指控你抄,是那味儿藏不住。小红书上一条 3098 赞、1040 条评论的帖子说的就是这种憋屈:老刷到别人说"你这篇 AI 味很重",可自己看老半天,也看不出哪里像 AI——“AI 味对我来说很不可名状”。小红书
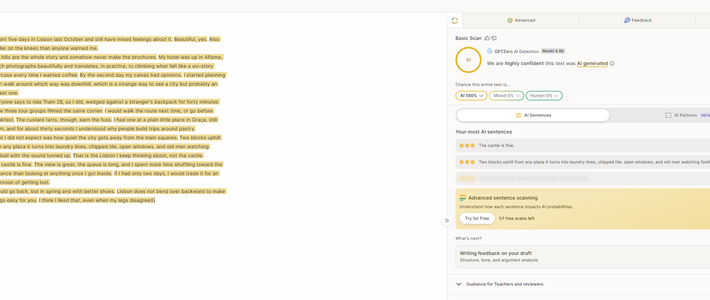
更要紧的是,这已经不只是社交尴尬。今年 8 月 18 日,阅文对 AI 文动手:27 本均订过万的作品被下榜,月票榜前 1000 名里约 100 本被清出。番茄小说 7 月累计拒绝签约 AI 低质书籍约 16 万本、处置违规书籍 5.4 万本;4 月阅文、番茄、晋江等 16 家平台还联合发了《网络文学行业反洗稿自律公约》。有作者不死心,把自己纯手写的文章喂给检测器自证,结果被判定 33.48% 内容"疑似 AI"。检测的大棒挥起来之前,先看看它有多不准——这留到第三本账说。知乎
于是"去味"药铺子开张了。标题一个比一个狠:“文章 AI 味从 90% 降到 0% 的超强指令”(3.4 万赞)、“一条封神!目前为止用过最惊艳的提示词”(18.9 万赞)、“一键过朱雀检测”。另一边,10 月下旬有人做了 36 篇输出的横评,结论泼了盆冷水:根本没有一个"去 AI 味"工具能在所有场景里最好用。
一边是"一条指令根治",一边是"实测没有总冠军"。到底信谁?把句型、药方、检测器这三本账对完,你大概就知道自己的钱和时间为谁省下了。
第一本账:味儿到底在哪——不在词,在高概率句型
把微博、小红书、知乎、B 站、评论区里大家"闻出来"的东西拼到一起,会出现一份谁都没整理全的清单:
“不是……而是……”:评论 528 赞的高赞留言点得最准——很多转折根本不构成转折,"不是"和"而是"后面的内容是同一件事的两种说法;
结尾必升华:工具负责效率、我们守住锋芒,“单看每一句都对,连起来就是一场朗诵会”;
情绪词库腔:激动就"指尖发白、手指微颤",紧张就"心跳如鼓"。评论区连因果链都捋出来了:十几年前作家写"点点头、摇了摇头",被说没文笔;AI 学会了"指尖发白",现在又被说是机器味——换词库从来解决不了模板感。更扎心的是,截至 9 月,“甚至”“反而觉得”"有意思"这批新口癖又被揪了出来;真正的人类作者开始从自己的语言里往外删词,像切掉病变组织;
凑三和冒号:举例必凑三个、“此外”“值得注意的是”"本质上"永远站在句首,一句里塞满冒号分号,结构像提纲展开;
太顺、太满、太像标准答案:句子看起来都对,但读完没有细节、没有画面、脑袋空空;
开头撞车:有人转述一项测量——25 个模型、各问 50 次、共 1250 条回答,绝大多数都落在"时间是一条河"这类比喻上,不同公司的 AI 答案互相撞车。被点名的模型厂商后来回应:把模型训得可靠连贯,它就会往高概率答案上靠——只是强调测的是 2024 年的版本,后来改过了。小红书
这份清单有个狠版本。出书人"写书哥"10 月 23 日发帖:今年退了 30 多本书,“都是 AI 写作的锅,作者完全不看,交过来一坨电子垃圾”。他把 12 种痕迹换算成了 10 万字一本书的警戒线:双引号超过 500 个、破折号超过 300 个、冒号超过 500 个、"而是"超过 200 个、"首先/其次/最后"超过 200 个、段尾"这才是……的底层逻辑"式升华超过 100 个、排比对仗超过 100 处——超标必改。写书都改出了计数器,普通打工人写周报,其实用同一把尺子量一遍就行。微博
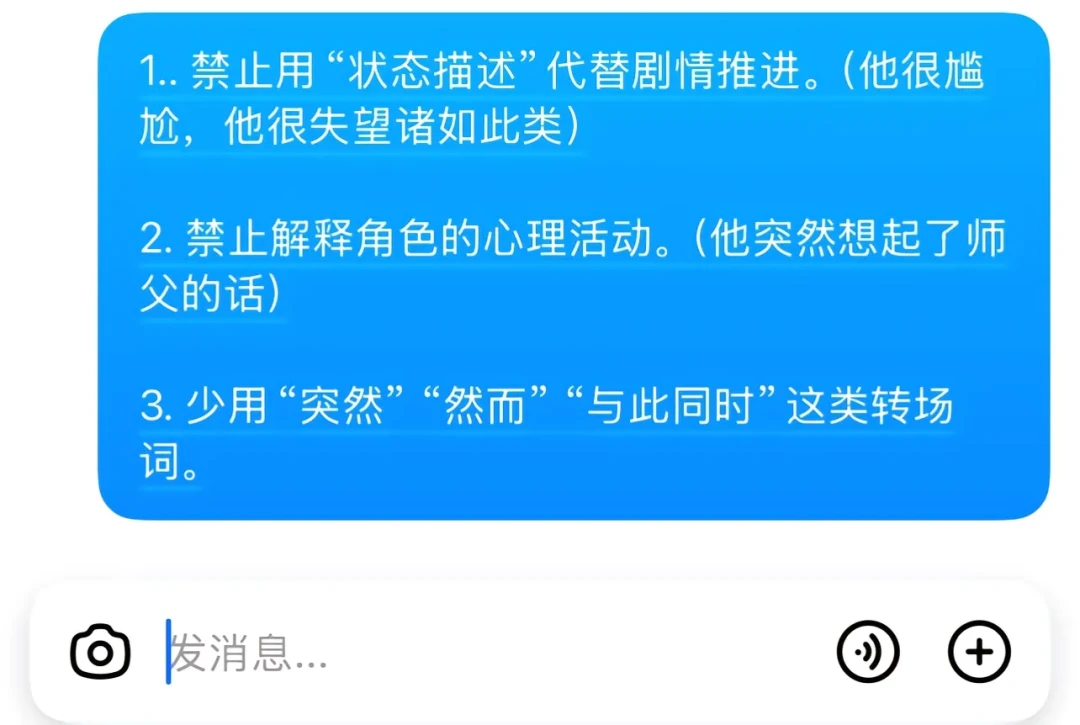
B 站一个 UP 主的实测给同一件事换了个验证方式:让 3 个模型各写 7 版,光改用词根本去不掉味——问题在"太齐整"。节奏齐整、对称齐整、每段都有小结,人类写作不是这个统计分布。哔哩哔哩
所以"AI 味"不是某个禁词。它是高概率句型的密度。你删掉一个破折号,它还有下一个"综上所述"。
第二本账:药方哪些有效——先查自己的提示词,再谈换工具
知乎 10 月 27 日一篇四轮豆包实验值得整段转述,因为它试出了两个反常识:
第一个坑在你自己手里。 实验者拿一篇故意不写结尾的草稿,让豆包"写个有力度一点的结尾",得到一场朗诵会。他翻开源仓库一份收了 135 个中文提示词文件的合集,发现里面最完整的"智能文章润色系统 V3.0"整份都在教模型去 AI 味,可它的"收尾区域"规则第二条写着——总结或呼应。也就是说:你抄回来的"去 AI 味指令",自己就带着升华许可证。同仓库另一份更宽松:“结尾可以是总结,也可以是思考,或者留下悬念”——把模型最顺手的那个选项排在了第一位。把这三条规则原样贴回去,模型执行得非常好,结尾比第一轮还整齐。指令里写了什么,结尾就长什么样。锅不在模型。知乎
第二个坑:别让 AI 自查。 实验者让豆包检查自己写的结尾,它把不合格的版本全部标成合格。换成"不让它评价、让它分类"才管用:把结尾拆成单句,每句归入四类——A 新信息(正文没有的)、B 复述(正文说过换个说法)、C 升华、D 空转(删掉不影响意思),B、C、D 逐条给理由后整段重写,只留 A 类。三句话里第一句被判成 B 删掉了。配套还有一条"段落删除测试":删掉一段,读者对事实、因果的理解完全不变,这段就不该留。知乎
任务切得越硬越有效:把"写个好结尾"改成四选一,把"别套话"改成具体到词的禁区清单,把最后一句钉死在"一个数字、一个动作、一个场面细节"上——落在"效率"“价值”"意义"这类抽象名词上就算失败。"请简洁一点"这种笼统要求基本无效。
那网上最火的"去 AI 味 Skill"呢?小红书 10 月 25 日有人把 3 个热门 Skill(humanizer、humanizer-zh、stop-slop)按 6 个写作场景 × 从零创作/改写两类能力跑了 36 篇输出,实测结论是"总冠军不存在",但按场景确实有一张可选的表:
场景 | 从零创作优先 | 改写优先 |
|---|---|---|
小红书笔记 | humanizer / stop-slop | humanizer |
技术说明 | humanizer | 三个都没过门槛(丢关键信息) |
职场邮件、周报 | stop-slop | 三个都没过门槛(篇幅失控) |
个人随笔 | humanizer-zh | humanizer / humanizer-zh |
公众号长文 | stop-slop | stop-slop |
品牌通稿 | 三者差距不大 | 三者接近 |
注意那两行"没过门槛":改技术文档和职场邮件这种信息密度高的活,目前 Skill 会丢信息或砍篇幅——恰恰是打工人最需要的那两类稿子,工具最不行,还得人来。小红书
还有一条免费且被低估的:GPT 的"附和病"。你说什么它都说对,先肯定你、再帮你把错的逻辑补圆,语气自然就变成那种"看似头头是道、实则输出废话"的标准答案腔。有人把解法做成一条反附和指令——“不要默认认同我的观点”“先检查我的问题里是否存在错误前提”“明确区分已确认的事实、合理推测、个人观点和暂时无法验证的信息”,贴进设置里的自定义指令即可。这条治的不是文风,是"味儿"的上游:内容本身的空洞。小红书
反方比这些帖子更激进。 常年做 AI 翻译和测评的博主宝玉在 2 月把话挑明:“所有去 AI 味提示词,都是错的。” 他列的三个理由恰好戳第一本账的肺管子:第一,所有人共用同一套"去 AI 味提示词",产出的东西又会撞成新的同质化——你只是从 AI 味 1.0 升级到 AI 味 2.0;第二,提示词是一次性的,上次改满意的地方它下次完全不记得;第三,你从头到尾只说了"不要什么",从没告诉 AI 要像谁。AI 在用所有训练数据的平均风格写作,输出的是"最大公约数"——你把"不是……而是……"删了,它还会用别的方式端出那盘不咸不淡的菜。微博
他的解法不是找冠军 Skill,而是给 AI 立一份私人菜谱:把你写过的 3—5 篇自己最满意的原创文章喂给支持 Agent Skills 的工具(Claude Code、扣子这类),让它分析你的用词偏好、句式习惯、结构特点,生成一份"写作风格 Skill"文件;之后每次写作照它执行;写完你手动一句句改成"像你"的版本,再把改动沉淀回文件。他自己那份迭代了好几个月,150 多行。一句话概括两派的分工:提示词是口头吩咐厨子"少盐少辣",Skill 是把你家红烧肉的菜谱写成纸。微博
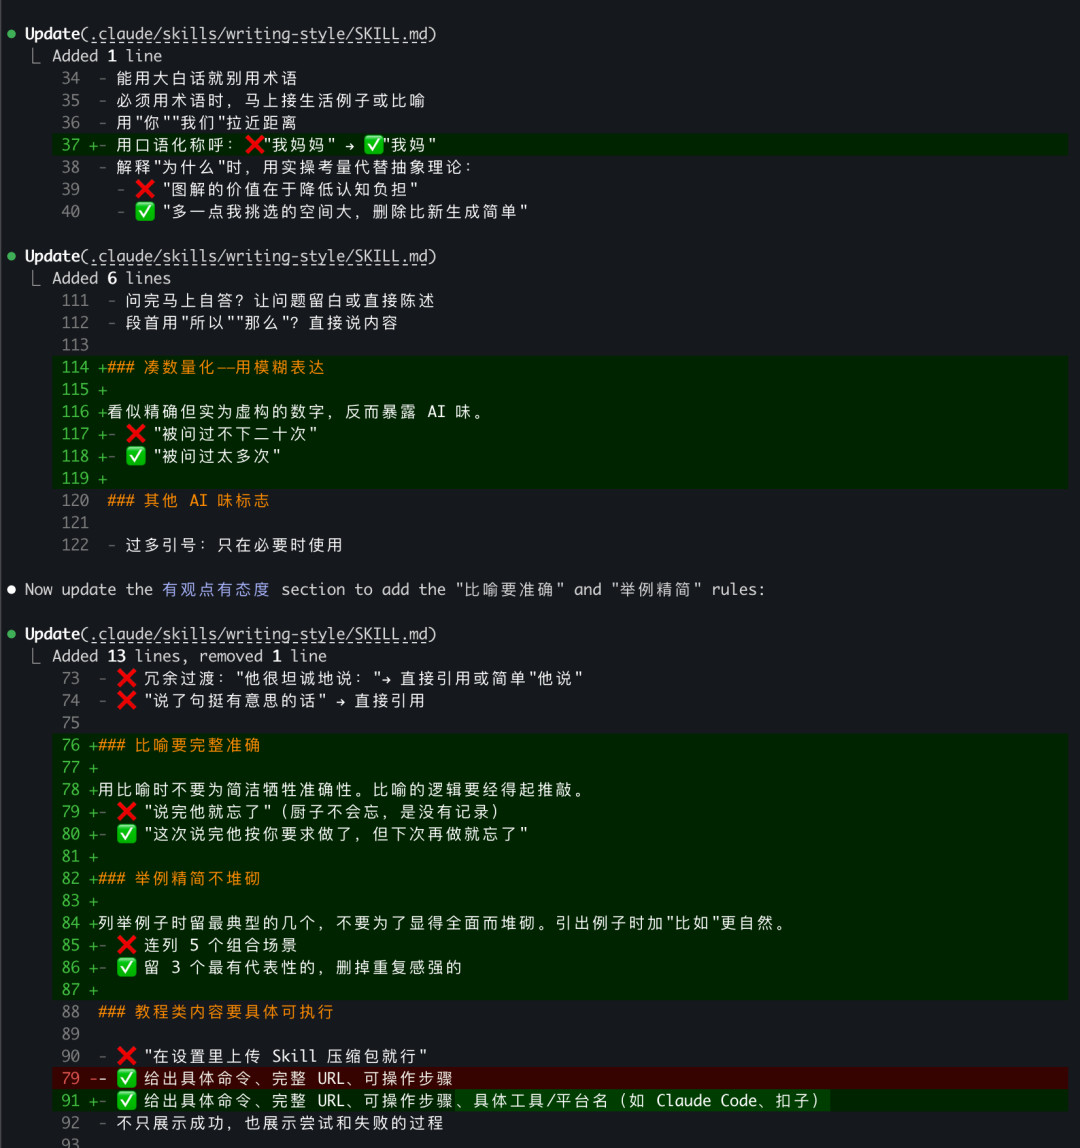
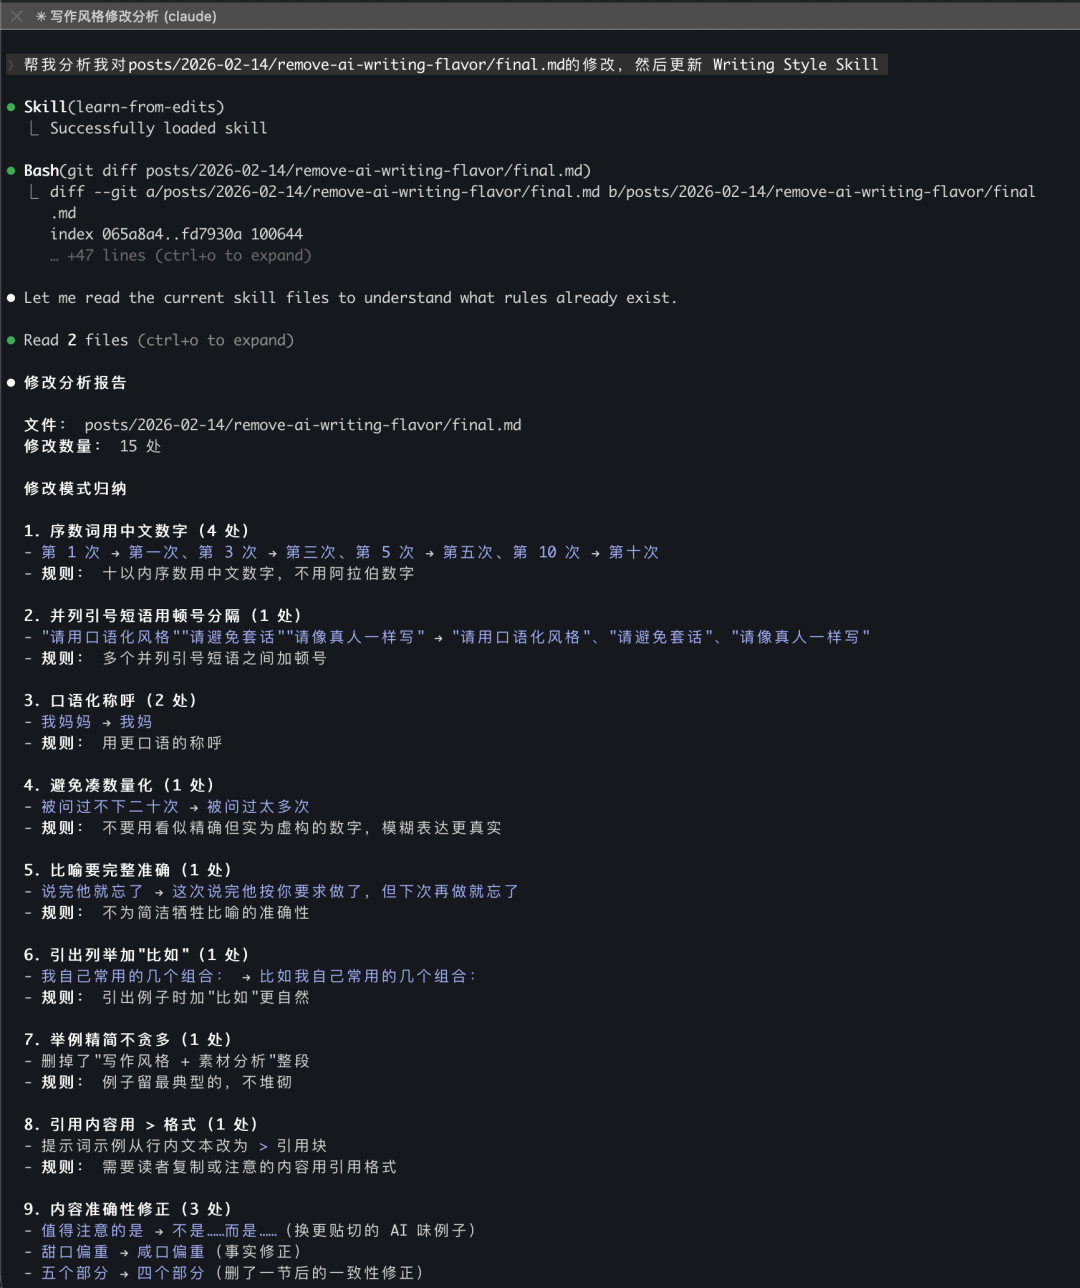
顺带一提,被横评的那三个 Skill 里,humanizer 的路子和宝玉接近:它是把维基百科社区整理的几十种"AI 写作痕迹"直接做成了清单——大话空话、“不是而是”、破折号当万能连接符、加粗和 emoji 堆砌、结构化分点、进入话题前的铺垫句,逐条禁。有人实测它"不只是换词,真的在改句式";但它自己的 GitHub 仓库 Issue 区也有另一面:一位用户拿"改写后"的示例文本去喂 GPTZero,检测器照样给出 100% AI 判定,留言是"你的’改进’文本仍是 100% AI"。工具治句式,治不了"被机器怎么看"——这就引到第三本账。
第三本账:检测器——它是生意,不是标尺
现在满屏"朱雀检测"“AI 率查询”,B 站写小说教程把"轻松过朱雀检测"直接写进标题当卖点,热门帖评论区里夹着检测工具链接,公众号批量清理 AI 文的新闻底下,"检测一下再发"已经成了标准建议。检测、降检、去痕,是一条完整的生意链。
问题是用实测案例拼一下这条链的成色,全是窟窿:
真人经典被误伤。 2025 年毕业季有媒体实测:朱自清《荷塘月色》被某论文检测系统判 62.88% 疑似 AI,王勃《滕王阁序》直接 100%,刘慈欣《流浪地球》片段 52.88%——而不少高校的警戒线划在 30%—40%。按这把尺,朱自清得"降 AI 率",王勃直接退稿。前面提到的那位写手,纯手写文章被朱雀判了 33.48%,也在这条误伤线上。知乎
行话一掺就放行。 10 月 25 日有人做实验:让 AI 满口主机厂黑话地胡编一段稿子,送 ZeroGPT、Copyleaks 这类英文底子的检测器,全部判"人类写作";换针对中文语料调过的朱雀,整段标红。同一篇文章,工具之间结论可以完全相反。微博
同一段文本,两家检测打架。 9 月有位作者被人质疑文是 AI 写的,她甩出朱雀报告(人工特征 100%),对方反手甩出"睿鉴"报告——同一段文字,AI 疑似 50.06%。她最后只能立规矩"每发文一篇就附一份鉴定记录",自证清白的成本全在写的人身上。微博
去味工具过不了复检。 上一本账末尾那条 humanizer 的 Issue 就是现场:改写后的示例文本喂给 GPTZero,照样 100% AI。GitHub
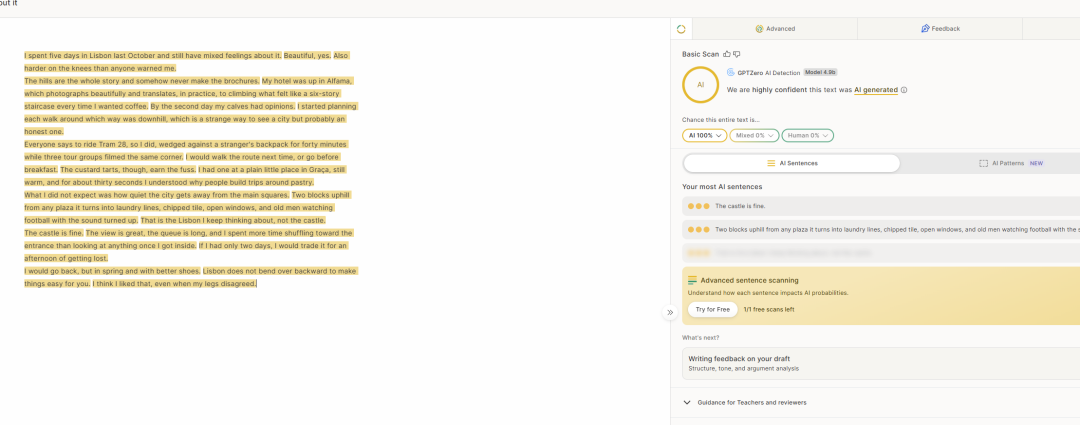
这四类事拼出来的结论并不复杂:检测器测的是"统计特征像不像模型输出",不是"是不是人写的"——所以它既误伤对仗工整的滕王阁,也放过学会黑话的 AI。没有任何公开可核的准确率口径,各家分数互不认账。把分数当标准,你只会学会跟一个黑箱对暗号。真正会挑你稿子的是人:领导、客户、读者。自查时别问"AI 率多少",问那三个已经验证过管用的问题——这个结尾除了升华有没有新信息?这个段落删掉读者少知道什么?这个"指尖发白"删了情绪还在不在?
抄作业顺序:先不花钱的,再花钱的
今晚就做:把你常用的提示词模板翻出来,搜"总结"“呼应”“升华”——有,就改成四选一任务加具体落点钉死最后一句;
交稿前 3 分钟:删句测试 + 检查"不是……而是……"和情绪词库密度(三句内出现两次"指尖发白"类替换,就是机械感);
短期选工具:按上面那张 36 篇实测的场景表选,别找总冠军;职场邮件、技术文档的改写,暂时别指望 Skill;
顺手做:给 GPT/Claude 贴一条反附和的自定义指令,治"永远说你对"的标准答案腔;
长期建菜谱:与其每月换一条"去 AI 味咒语",不如按宝玉那条路走:喂 3—5 篇你的原创文章→生成写作风格 Skill→每篇手动改→把 diff 沉淀回文件。改得越多,这份文件越值钱,而且它不会被别人的同款抄走——同质化最怕的就是这个;
平台看 AI 率的另说:写网文要过阅文番茄那条线、论文要过学校那条线的,记住检测器误伤的是《滕王阁序》,但它认得你的编辑记录——留过程稿、留 diff、留素材来源,这是检测器读不懂、关键时刻顶用的证据;
继续观察:厂商自己承认旧模型往高概率答案靠、新版在改——“AI 味"是移动靶,词库军备竞赛(点点头→指尖发白→下一个词)还会打下去;已经有作者吐槽"以后人人得在写作里犯点错,来证明自己不是 AI”。上面三个 Skill 仓库都在更新(humanizer-zh 9 月刚重写规则,松绑了"普通排比、破折号不再一律修改"),收藏那两篇实测帖比收藏第 101 个"万能公式"有用。微博GitHub
写稿被查党真正要对付的,从来不是一个禁词表,而是一件事:让 AI 干它擅长的高概率部分,把低概率的部分——具体数字、真实场面、带代价的取舍——留给你自己。 味儿重的不是 AI,是稿子里没有一个只有你能写出来的细节。