10月22日,深圳九天睿芯宣布半年累计融资10亿元。第二天,亿铸科技公布10亿元级融资。10月28日,杭州微纳核芯两个月完成超20亿元融资。芯东西半导体产业纵横36氪
一周之内,三家做存算一体芯片的公司,把超过40亿元装进了口袋。为什么是现在?
先看AI推理卡在哪。训练拼的是并行计算,推理的权重已经固定,每生成一个词,却要把模型从头到尾读一遍。
以Llama-3-70B为例,FP16精度下光权重就有约140GB。每处理一个token,都要把它从显存搬到计算单元附近。模型越大,搬运越贵。知乎
黄仁勋说过,GPU有70%的时间在等待数据。端侧更难看:CNCC2026给出的数字是,数据反复搬运消耗了超过90%的能耗;推理场景里,这个比例普遍在七成以上。36氪CCF知乎
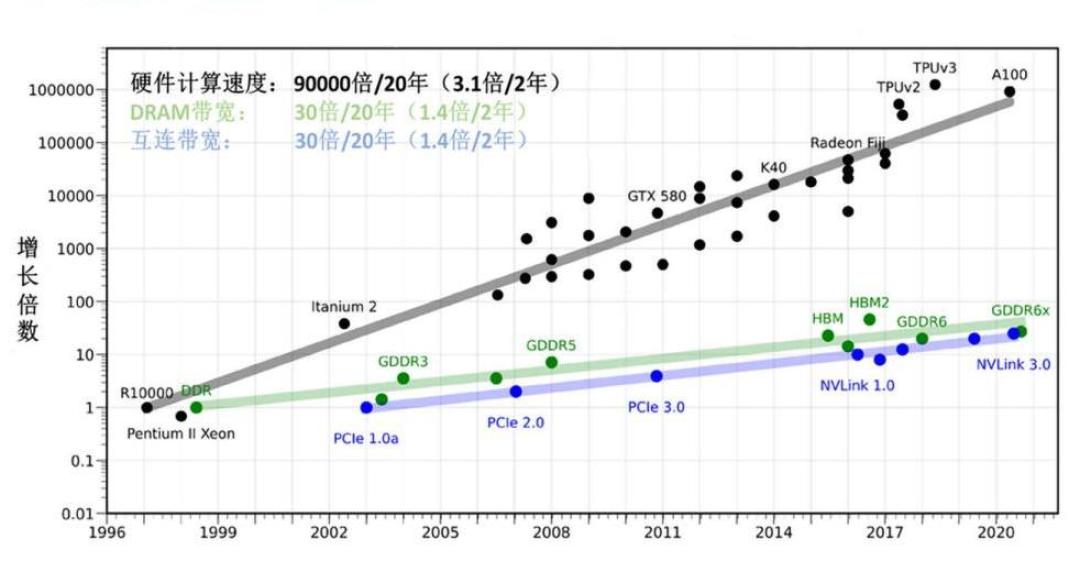
算力单元再快,数据供不上,也只能空转。业界给这件事起了个名字:存储墙。
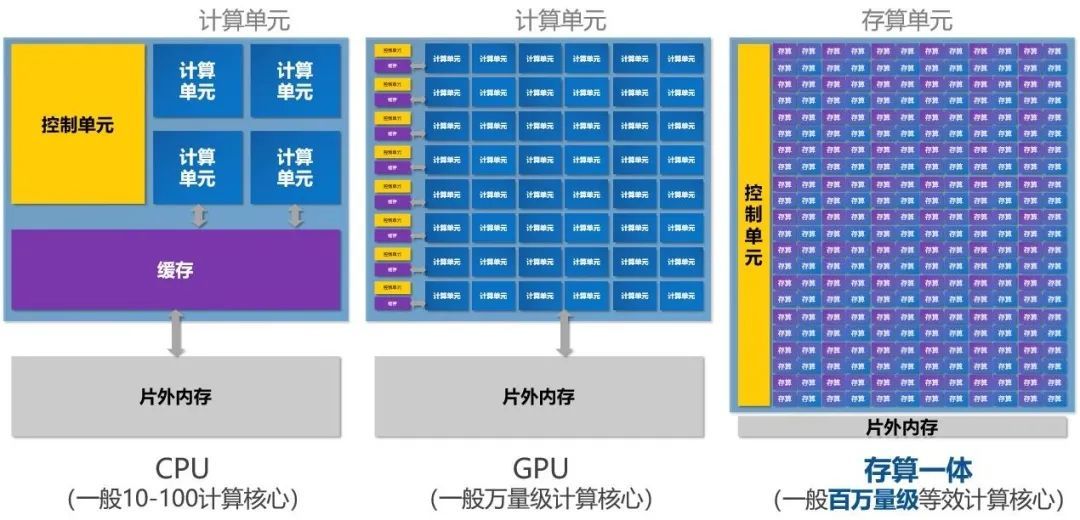
存算一体的思路很直接:既然搬运最贵,那就别搬了,把计算放进存储阵列里。
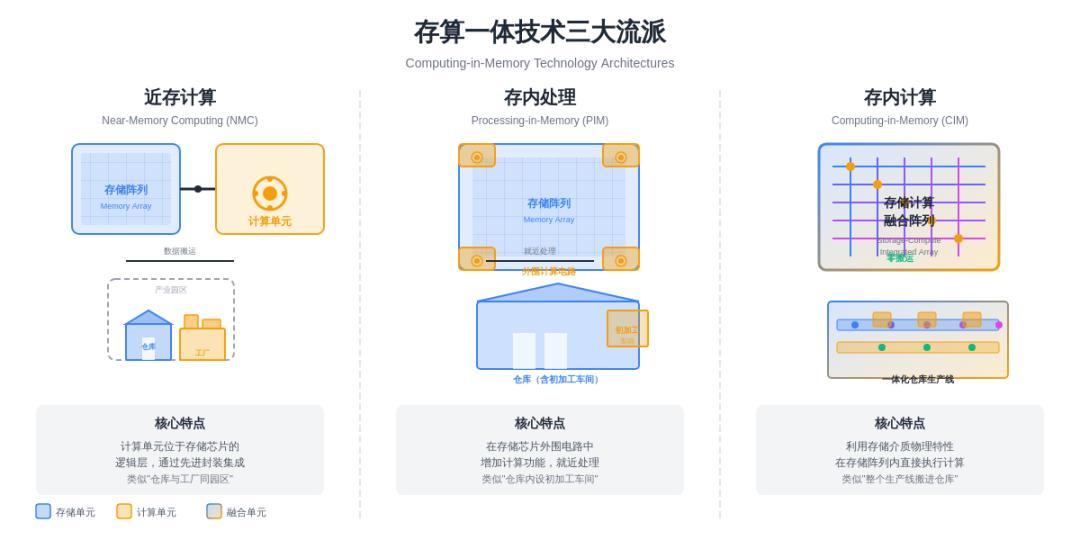
原来的芯片像工厂,仓库和生产线隔得很远,每生产一个零件都要来回运料;存算一体相当于把生产线搬进仓库,原料就在手边。
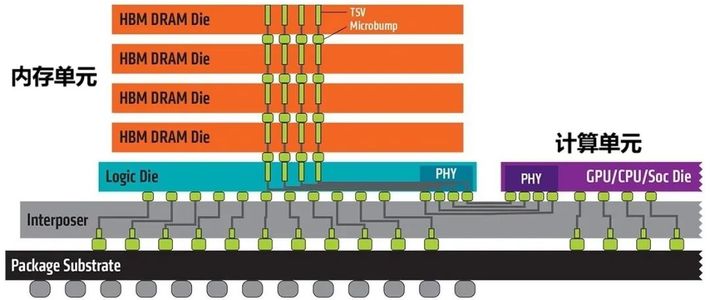
业界把它分成三条路。近存计算把计算单元放到存储旁边,靠封装缩短距离;存内处理在存储芯片外围加一点计算;存内计算最激进,直接让存储阵列参与乘加运算。
介质也分好几派:SRAM快但占面积,DRAM容量大但工艺难,Flash便宜但慢,ReRAM等新型器件能效高、良率还在爬坡。
微纳核芯走的是“3D-CIM”:把DRAM堆到计算单元旁边做近存,用SRAM阵列做存内计算,再用RISC-V核做异构调度。
公司称,其SRAM存算一体比传统架构提升4到6倍算力密度、5到10倍能效比;第一代三颗芯片已全部投片,预计2027年初送测。36氪
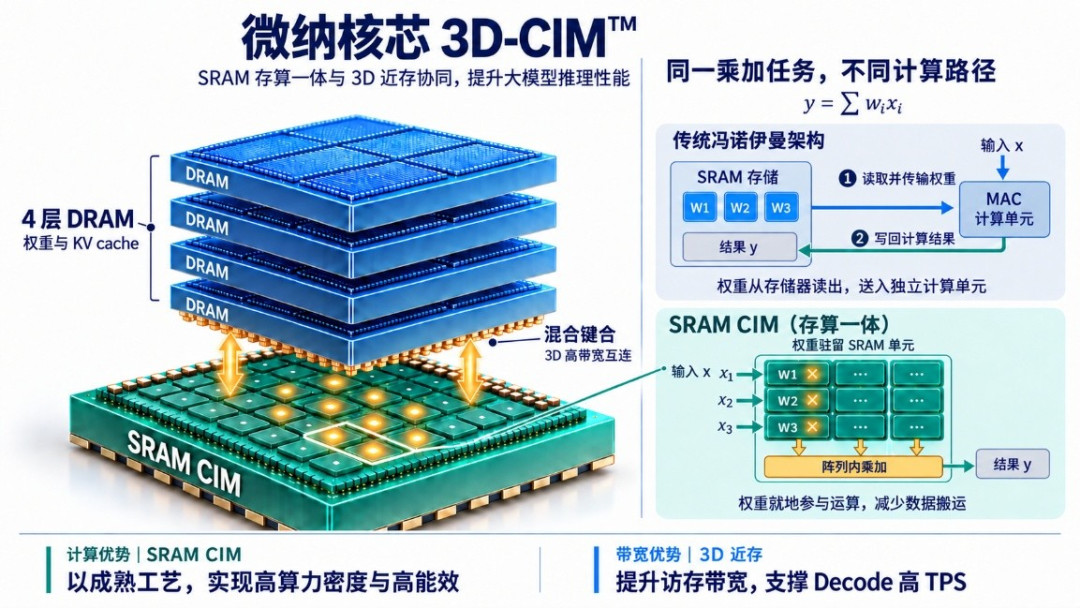
叶乐说,22nm就能做到传统7nm的算力密度,成本降4倍。CCF
亿铸科技押的是3D DRAM加全数字存算一体,主打通用性。
公司公开的数据是,相比主流云端GPU,功耗约1/5、成本约1/6。36氪
熊大鹏的说法更直接:12到28nm的成熟工艺,能做先进工艺GPU的性能,不依赖EUV和HBM。
九天睿芯把SRAM存算一体和高带宽闪存HBF放在一起。ADA400板卡单卡容量超2TB、带宽超4TB/s;在“单卡+4块SSD”上跑DeepSeek-V4,解码约20TPS。芯东西
这些数字要打折。多数对比来自公司自测,基准和模型不统一;能效翻几倍,不等于能省几倍的钱。
学术界也给了旁证。ISSCC2026上,清华、华为和字节的团队用28nm做了颗混合存内计算芯片,跑推荐系统时QPS提升66倍,QPS/W提升181倍。36氪
成熟工艺加架构创新,确实能从“搬数据”里抠出数量级。
但存算一体不是万能钥匙。它擅长的是推理,尤其是访存密集、计算/访存比低的大模型解码;训练仍然归GPU。
它也很难包打所有模型:动态批处理、长上下文、多精度,都要求硬件灵活。模拟存算还要面对器件噪声、温度漂移和ADC开销,精度上去了,能效优势可能又被吃掉。
更现实的约束是软件。CUDA和PyTorch攒了十几年,算子库、编译器、开发者习惯都在。
存算一体公司得自己补软件栈,还要让客户把模型迁过来。微纳核芯的第一代芯片2027年初才送测,亿铸和九天睿芯的量产爬坡才刚开始。
资本可提前两年下注,客户不会。
所以,这40亿元买的不是“取代GPU”的故事,而是一个更窄的判断:当AI从训练转向推理,算力成本从买卡转向电费和带宽,把数据留在原地就会变成一门生意。
这个判断能否成立,不看发布会的TOPS/W,而看两年后客户是否愿意为每百万token少付钱买单。芯片行业不缺新架构,缺的是把新架构跑进机房和手机里的人。