前阵子刷屏的那篇 Claude 工程师文章,造了一个词:认知投降。它的高赞讨论里有一句话特别扎心——有人问你,AI 这段写了什么、为什么这么写、具体怎么实现,你答得上来吗?Agent 一次性甩出 6000 行 PR,你有时间看吗?大部分时候你只知道它写完了,你跑了一下,没问题,next。知乎知乎知乎
这个说法能火,是因为太多人对号入座了——知乎问题下的热评坦率承认,不降智的情况下真的可以一直按回车,人是有惰性的。也有人自曝:"我现在基本不写代码了,review 都不太 review,只看它改了哪几个文件,不要太离谱就好。"另一条评论说得更白:“我一直坚持让 AI 逐条解释,好安慰自己代码还在掌控中——但我自己心里清楚,控了个寂寞。”知乎
崩坏的三个阶段
讨论里被反复引用的共识,是把这个状态分成三段:
认知卸载:活儿交给 AI,判断权在自己手里。你知道它改了什么、为什么改、哪里没动。这就是正常分工,好比开车之后没人再跑步通勤——跑步还在,只是不再当交通工具。
推迟判断:能跑就当真,检查这步被无限延期。
认知投降:AI 的答案悄悄变成你自己的判断,连"需要检查"这个意识都没了。
用 AI 不是病,从第一段滑到第三段才是,而且滑的时候基本无感。知乎
退化的证据,不是杞人忧天
Anthropic 做过一次随机对照实验:学习阶段用 AI 的一组,后续测验比对照组低了 17 个百分点,速度也没快多少。剑桥 Miles Cranmer 那场《How to Avoid AI Brain Rot》的演讲讲得更直白:AI 能让你的作品越来越好,但这不代表你自己的能力在同步提高。差别就藏在错误里——自己动手、卡住、试错的过程,恰恰是能力生长的必要困难。AI 把过程全代劳了,你只带走了结果。小红书小红书
更隐蔽的是退化的方向。知乎今天凌晨刚出现的讨论把话说明白了:长期靠 Codex、Claude Code 这类 Agent,很多人会进入"识别能力还在,生成能力掉线"的状态——AI 写的 LRU 缓存你能看懂,让你徒手实现,节点摘除、容量淘汰就写不对;代码里埋着 O(n²) 的坑,你连该警惕哪儿都不知道。监督 AI 的前提,是你得知道问题可能长什么样。知乎
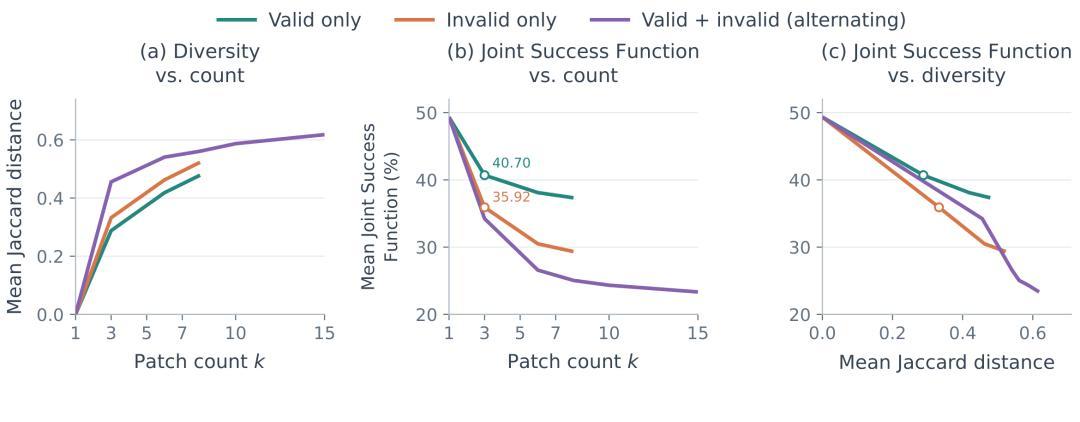
这条防线为什么值得较真,数据也不站在"跑通即合格"这边:36氪报道的 TestPrism 研究里,Coding Agent 生成的测试候选一多,联合合格率从单一参照下的高估水平一路跌到四成上下——很多"能跑"的改动,换个测试组合就现了原形。36氪
但另一边的高票说法也得放进来。"古法编程"那个 480 万人气的问题里,51 赞的评论一针见血:稍微大点的商业项目,都得拆成小模块一个一个让 AI 做,没有拆解项目的专业能力,你连让 AI 干活的资格都没有。分水岭从来不是打字速度,而是拆解能力和审查能力。知乎
评论区总结的防滑清单
吵归吵,真正天天用 AI 写代码的人已经攒出一套实操打法:
小步交付:让 Agent 动手前先列出要改哪些文件,一次只做一个小模块,验收完再进下一个;
测试先行:先让它写一个能复现 bug 的测试,再让它修。顺序反过来,靠谱程度直线上升;
核心手写:关键接口、状态机自己写,反过来让 AI review;胶水代码、单测、文档随便它发挥;
不查不提交:“AI 写的每一行代码,没检查不提交”;
踩坑变门禁:同一个坑它踩第二次,就写成 lint 规则或 CI 卡点,比在 prompt 里叮嘱十遍管用;
回车前留一问:每次按下回车前,试着一句话说清这步在干嘛。说不清,先检查。
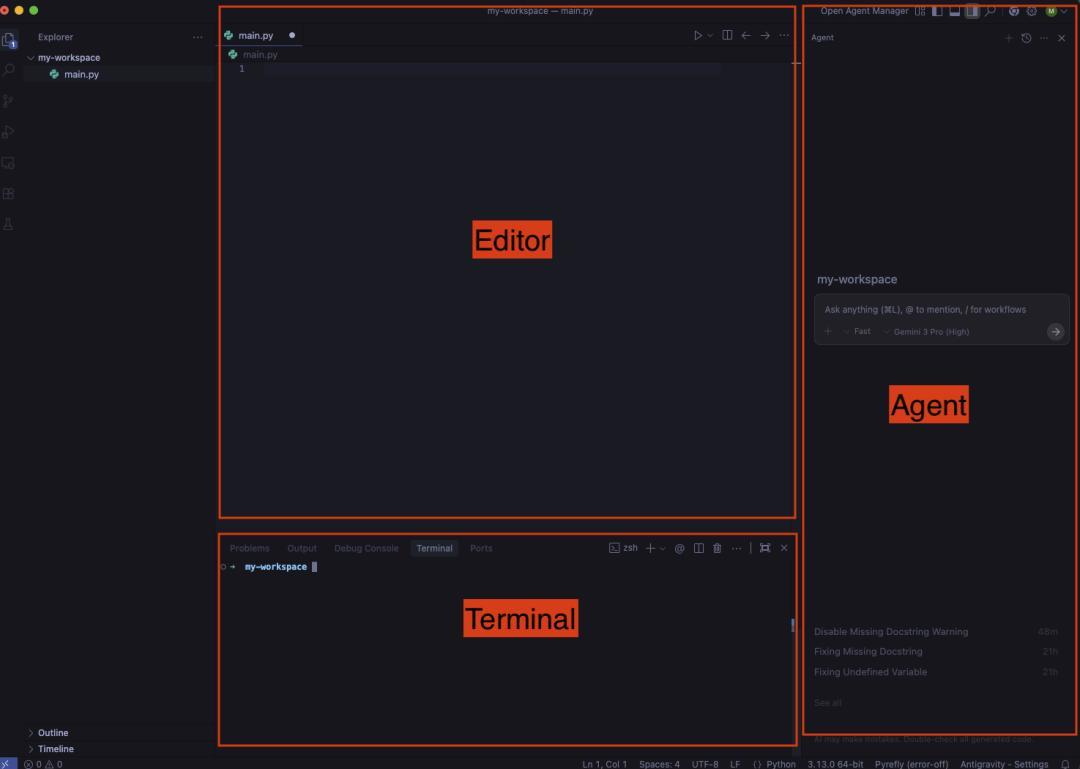
“先列清单、逐条验收、再进下一项”——上面这些条目的共同内核,是把 Agent 的工作切回人能读得完的颗粒度。有人的日常就是:核心接口和对外代码自己手写一版,让 AI 反过来 review,有问题自己改或者盯着 AI 改。知乎
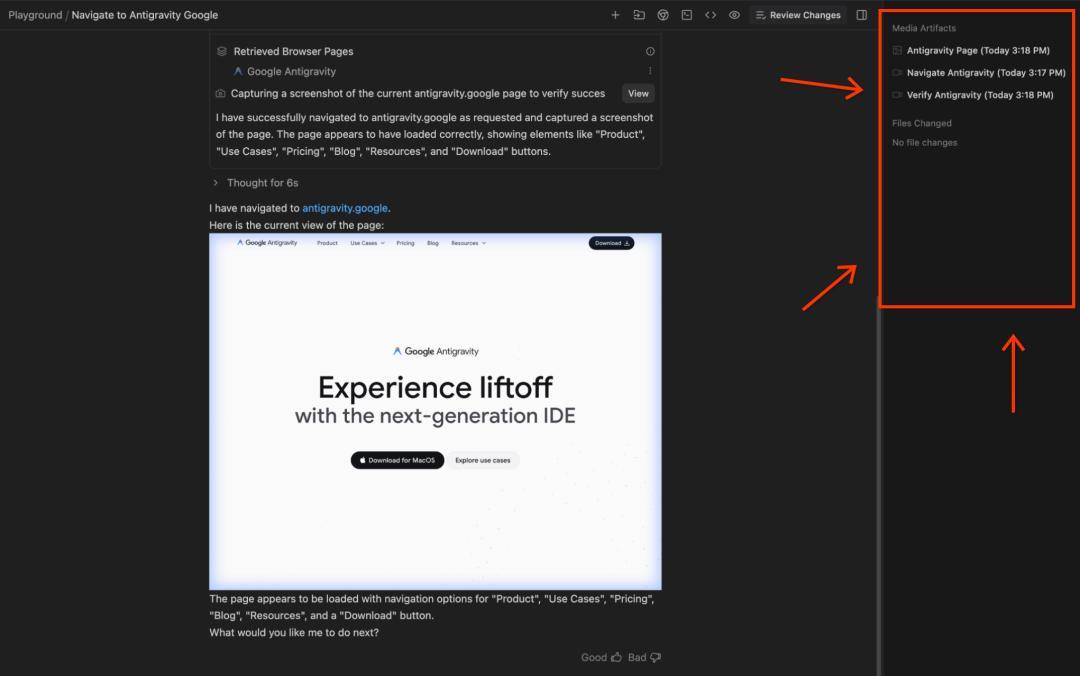
团队层面同样有解。Grok 团队的 Lauren Tan 在 AI 工程峰会上的演讲被总结成三条——把反复出错的地方变成机器可检查的规则;先清理代码库里的坏示范,Agent 会照抄它们;让 Agent 跑给你看,用截图、录屏、可重跑的测试代替"我测过了"。小红书
最后
用 AI 增强自己,而不是用 AI 替代自己。那场剑桥演讲的收尾是这句,这场争论也可以拿它收尾。回车可以一直按,甚至这辈子都可以不用古法编程——只要你能随时说清,哪一行出问题会让你最疼。以后程序员之间的差距,多半不在谁写得快,而在谁还留着那句"为什么"的提问权。