

DeepSeek服务限流,Kimi把单次输入上限收到四万字符。很多解读停在“需求太猛、算力不够”这一层,这只说对了一半。更真实的情况是:能力上限和成本结构同时触顶了。上半年靠榜单攒下的信心,下半年被真实任务一趟趟打回去。差的不是三个月的身位,是质上的一个代际。
看一下对手在做什么。11月9日,Anthropic发布Claude Fable 5.2:1000个Agent连续跑30小时,完成费马大定理的形式化证明;不间断工作8天,从零造出一套能在笔记本上跑的操作系统;顺手还解决了两个黑洞物理难题。定价输出每百万token 40美元。Opus 5.5更早上市,主打长周期编程和知识工作,价格是它的一半。这些不是跑分,是能交付的工程结果。而国产模型最擅长的,仍然是在对话框里把一句话回答得漂亮。
必须承认一个事实:DeepSeek这类模型走的是“小参数+高效率”路线,蒸馏、量化之后推理成本极低,在客服问答、文案润色、会议摘要、日常对话这些任务上,体验不输海外,价格只有人家的几十分之一。但任务一旦变长、变复杂——跨文件改代码、长链条调试、多步科研推理——能力就断崖式下滑。结果就是国产大模型事实上被挤进“国内简单对话”这个格子,干着流量最大的活,也是最不值钱的活。这叫守住了市场,不叫追上了技术。
张一鸣的说法可以对照:字节要真正追平国际前沿,最早也得2029到2030年,瓶颈在预训练数据规模。字节有现金流、有场景、有人才,尚且给出三年起步的预期,说明钱和用户规模换不来底层能力。
这套差距是复利型的。海外真正强的不是某个模型,而是硬件、算力、模型、样本、收入串起来的一个闭环:顶配芯片和万卡级集群供得起,就能把训练连续跑上几个月,把上下文长度、Agent环境、合成数据一起往上堆;模型越强,接到的真实任务越复杂,跑出来的执行轨迹就越多;这些轨迹再变成下一代的训练样本,模型又强一层,最后用每百万token几十美元的定价把算力钱赚回来。跑得越久、任务越复杂,领先就越多,环节之间自己给自己加油。
国内卡住的正好是这条链的起点。芯片供给受限,单集群规模和连续训练时长上不去,只能绕到推理侧做优化,用蒸馏的小模型去接简单任务。样本也就换了一档:喂进去的是客服问答、文案改写、日常对话,不是跨文件改代码、跑科研实验那种高复杂度轨迹。训练越多、任务越复杂、样本越多就越领先,这套机制在海外是被放大的,在国内转不起来。所以差距不会匀速缩小,只会越拉越大。
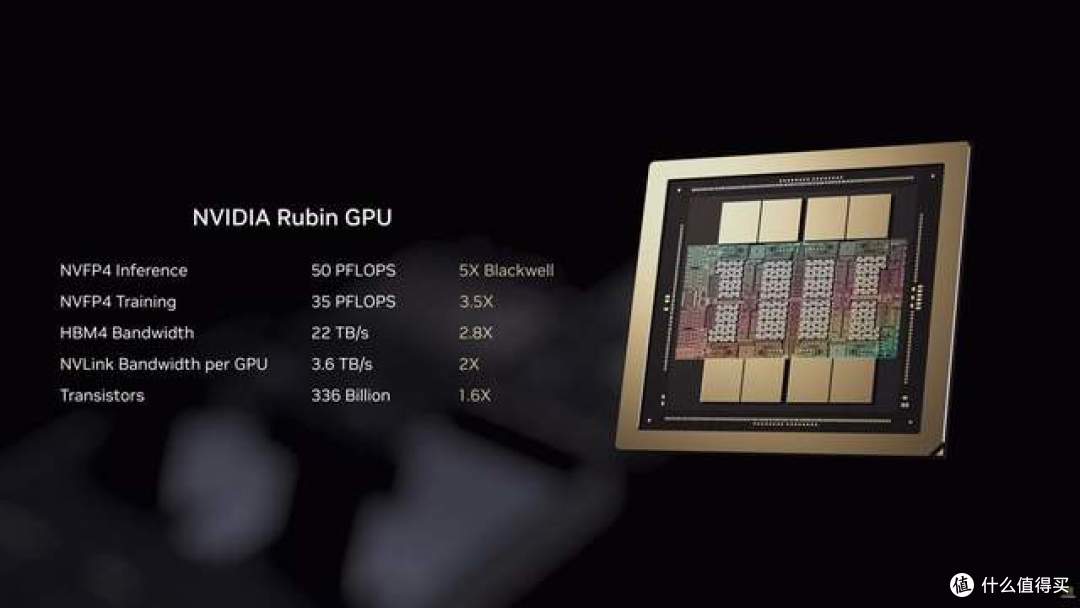
“算力出海”这个词在研报里很热闹,但在真正做事的人那儿,几乎没人提。原因很硬:电不能跨境传输,数据中心不能装船。中国信通院的人讲过,海外平台调用中国模型的量看着很大,可那些数据中心实体大多部署在海外,开发者用的是部署在海外云上的服务,本质是模型出海,不是算力出海。跨境光缆往返就是几十毫秒,实时交互根本扛不住。
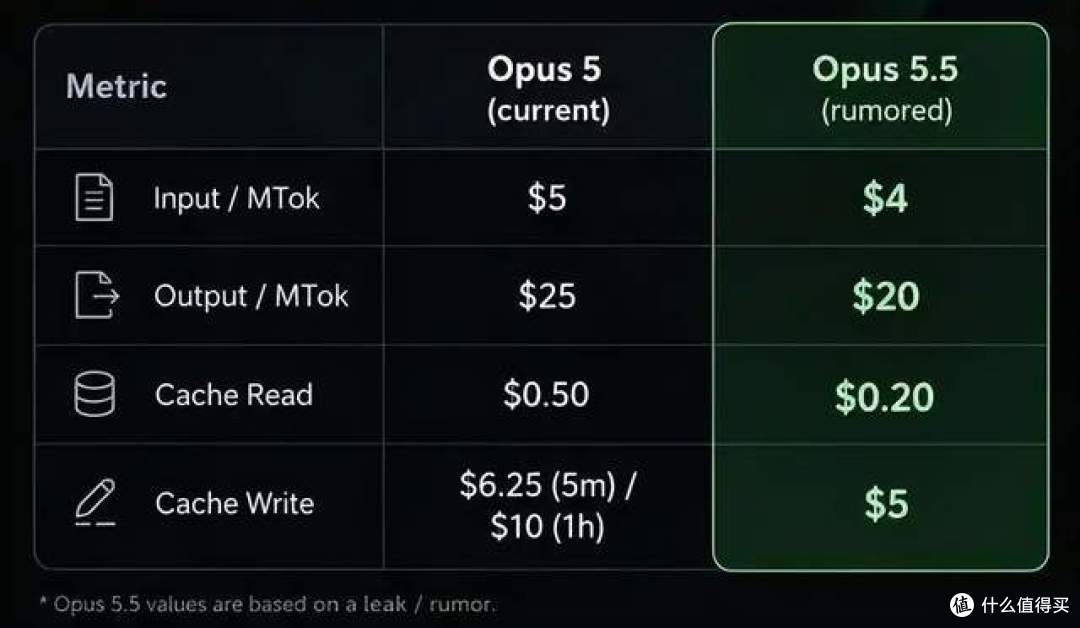
电费这张牌更站不住。一台两千五百万的机器,按三年折旧,每小时就是近千元的硬件成本;它一小时耗十来度电,电价三块、五块还是十块,摊到每小时只差几十块,在这张账上几乎没有区别。再看定价:充100美元,二十分钟就烧完,折人民币七百多块,电费占不到百分之一。决定成本的是芯片价格、集群互联、研发摊销和token产出效率,不是几毛钱的电价。拿电价解释AI竞争力,是算错了账。
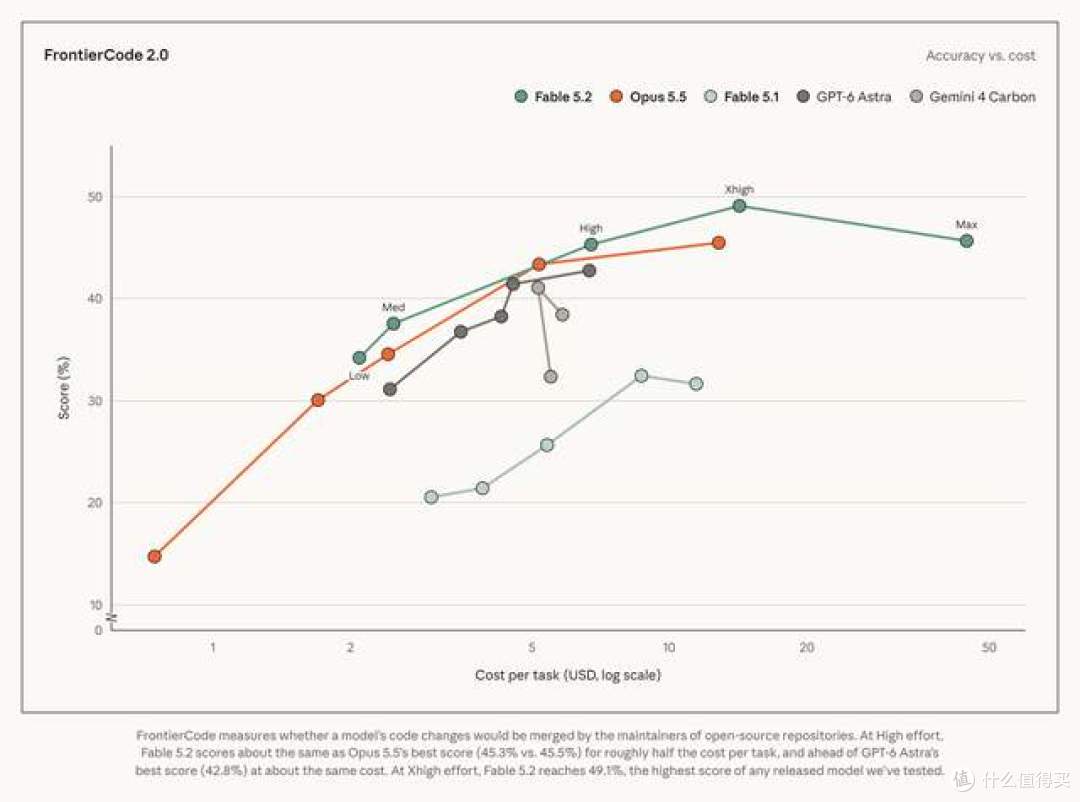
所以别再用“长期耐力”“侧翼赛道”给自己找台阶。DeepSeek限流不是意外,是真实水位的一次暴露:简单任务又便宜又好,复杂任务接不住,数据、芯片、工程能力都还差着一个代际。承认难看,但比继续开庆功会强。
当前文章无评论,是时候发表评论了