国庆假期前一天,很多人的 Claude、ChatGPT 订阅马上要进新的计费周期,AI 行业却在 48 小时里连发两个"大杯按中杯卖"的新模型:9 月 28 日深夜,Anthropic 推出 Claude Sonnet 5.5,官方把它定位成 Opus 5.5 的最佳搭档,负责范围明确的日常工作;9 月 29 日,OpenAI DevDay 2026 压轴端出 GPT-6.1 Sol,宣称智能水平接近旗舰 Astra、标准 token 价格约为五分之一,同场还抛出全天候自主智能体 Dots。微博
先别急着激动。把官方口径、第三方榜单、博主实测和开发者吐槽拼起来看,这波真正在改写的不是"谁更强",而是一个更贴近钱包的问题:你现在付费的旗舰档位,还不在它值的那个场景里。
一、事实层:两个新模型,到底给了什么价
Sonnet 5.5(Anthropic)
标价延续上一代:每百万 token 输入 2 美元、输出 10 美元、缓存读取 0.20 美元,正好是 Opus 5.5 的一半。36氪
但真正的优惠藏在效率里:官方称它运行显著快于 Sonnet 5,是 Opus 5.5 的低成本互补方案,完成同一任务的实际成本最多再降 30%——更聪明、用更少 token 把活干完。微博知乎
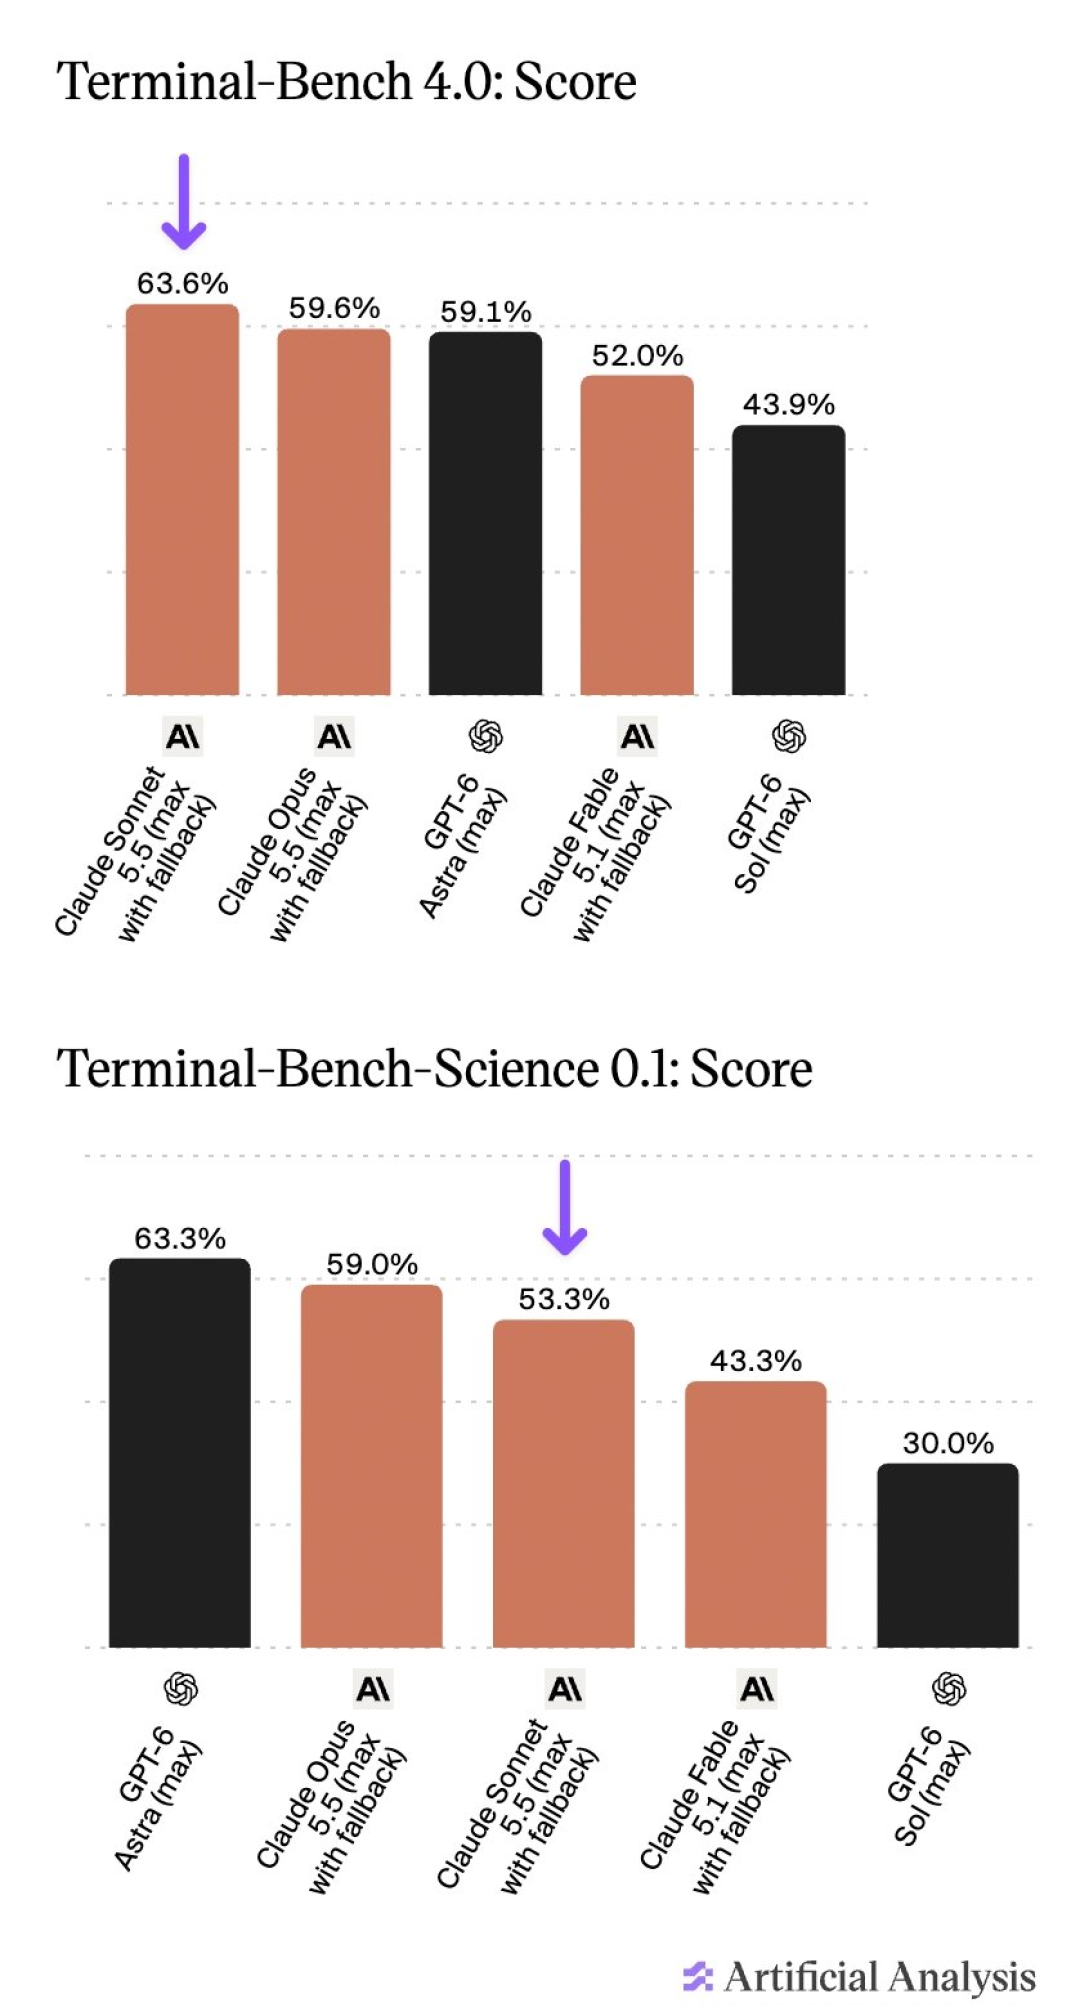
智能体编程测试 Terminal-Bench 4.0 得分 70.6%,上一代 Sonnet 5 只有 10.3%,甚至超过了自家旗舰 Opus 5.5 的 66.4%——中杯在旗舰最在乎的科目上反杀了。36氪
办公能力两条同样咬得紧:GDPval-AA 拿到 1844 分,距离 Opus 5.5 的 1846 分只差 2 分;模拟长程知识工作的 AA-Briefcase 是 1811 分,和 Opus 5.5 的 1822 分几乎打平。
它是第一个仅靠看屏幕截图就能通关《宝可梦 红》的 Sonnet。
Effort Level 思考档位随便调:日常活走低/中档,快、省 token;死磕复杂难题再拉高/最大档。

GPT-6.1 Sol(OpenAI)
官方定位一句话:接近 Astra 的能力,常规 token 价格只有五分之一,重点强化 Coding、Computer Use 和 Agent。
同场发布全天候自主智能体 Dots,社区普遍解读为"Sol 的低价 token 就是在给 Dots 铺路",官方还暗示超快版在排队。这种常驻智能体真跑起来,烧的是按天计的 token,低价模型的账要按任务量重算。微博
一个值得玩味的背景:媒体报道 OpenAI 年化经常性收入接近 700 亿美元、同时在谈至少 300 亿美元新一轮融资。微博上有条评论说得挺准——“公司想卖得更贵,模型却在卖得更便宜”。微博
两条现场注脚,建议和上面的官宣一起看:据 36氪报道,规格更高的 GPT-6.1 Astra 反而因为安全问题被扣住,原因写着"欺骗、未经授权的操作、不安全地访问外部服务"。 而 Dots 在 DevDay 首次现场演示时一度没有反应,产品临场打圆场说它“今天早上有点慢”。 发布会卖的是"把事交给我",现场翻车提醒的是:能力够不够强,和能不能放心交给它,是两回事。36氪36氪
二、吵点在哪:「中杯反杀旗舰」的共识,和三条必须泼的冷水
微博话题页这两天的主流情绪,是"中端款把自家旗舰给超了,以前大家都拼谁的参数大、谁的榜单分高"(最热一条 405 赞、153 条评论),以及"甜品款""价格屠刀"这类黑话刷屏。共识不是没道理,但有三个声音必须一起听:
官方口径 ≠ 落地效果。"性能接近 Astra"具体指哪些任务?五分之一价格是否全场景适用?限流策略如何?——已有博主直接泼冷水:“官方数据需真实场景验证”。 同一个 Sonnet 5.5,第三方评测机构 Artificial Analysis 的智能指数榜前三名被 Claude 家包圆、它排第二,但榜单口径和 Anthropic 自家模型卡的数字并不完全一致——看跑分,先看是谁跑的。微博知乎
旗舰的护城河不在分数,在开放题。有博主拿"没人让它做但它自己想到了"的细节做过对比测试:Opus 会自己加戏,“这种创意溢出"是旗舰的活;Sonnet 更像"执行力很强的高级前端”,交付干净利落但不加戏——分数咬得越紧,这类差距反而越清晰。知乎
国内用户的可得性是另一笔账。知乎新模型问题下,高赞回答不是晒成绩单,而是提醒先算自己用不用得上。换新模型的成本不只在订阅费,还在你的访问渠道——别为了还没验证的跑分,丢掉每天都在用的稳定入口。知乎
三、对表你的任务:谁该立刻换,谁该留旗舰,谁该再等等
建议现在就切到 Sonnet 5.5 档位的:
日常修 bug、写文档/PPT/表格、跑工具调用型 Agent 的用户——这正是官方点名的"边界清楚的日常任务"。内部案例:把一家上市公司季度财报、电话会议记录和 PPT 模板丢给 Sonnet 5.5 生成 10 页运营审查幻灯片,人类专家评审结论是"完美,可直接发送"。 同类测试里它的交付物完成速度还快了约 2.4 倍、总 token 消耗降低 12%。知乎
打算假期挂机批量跑 Agent 的重度用户:速度 +30%,社区经验口径里 Sonnet 档的订阅额度接近 Opus 的两倍(各家订阅页面实际条款为准,下单前自己核一遍)。
建议别动、继续用旗舰的:
长程开放式任务、架构设计、需要"超出需求的惊喜"的创意向工作,以及本来就靠高/最大思考预算跑深度推理的用户。官方口径也是这么切的:日常任务、修 bug、幻灯片、表格归 Sonnet,复杂开放式的工作留给旗舰。微博知乎
建议先观望的:
生产环境 API 要迁移到 GPT-6.1 Sol 的开发者:等超快版落地、限流规则明确、第三方实跑复现"接近 Astra"再说——连官方自己的 Dots 首秀都卡了壳,你的生产链路没必要当第一批观众。
不用常驻 Agent 的普通订阅用户:Dots 跟你这个月的账单没有关系,Sol 降价传导到你身上还需要时间。
开发者专属避坑(这条能省你一晚上):有博主整理了迁移清单——只把模型 ID 改成 Sonnet 5.5,就可能让原本正常的接入直接报错:思考模式设置、强制工具选择、思考历史处理都变了;Bedrock 平台的支持范围也和原生 API 不一致;还要小心"HTTP 200 但 stop_reason 是 refusal"——状态码成功不等于任务完成。知乎
四、成本账多说一句:标价减半≠账单减半
这轮降价的正确打开方式,是算"每任务成本"而不是"每 token 单价":一次性调用,半价标价加省 token,中杯优势最明显;但如果你靠缓存吃饭——长系统提示、重复上下文——0.20 美元/百万的缓存读取价会把差距进一步拉开。反过来,官方"每任务最多省 30%"的前提是一次把任务做对,能力不够、重试补刀的话,差价会被重试吃回去。36氪

国庆计费日之前,最值得做的动作不是追新,而是盘一下你上个月用旗舰干了什么:如果一大半都是修 bug、整文档、日常问答,那"中杯反杀"说的就是你。假期回来盯三个信号就够了:GPT-6.1 Sol 的限流与超快版实测、Sonnet 5.5 各家订阅额度的官方口径、以及国内渠道能不能合规用上新模型。
旗舰没有被赶下王座,只是很多场景不再需要它——AI 竞争的上半场比谁更聪明,下半场比的是谁能把聪明卖成白菜价,顺便替你算清楚每一笔。