这周AI工作台的评论区里,出现频率最高的一句话不是"真好用",也不是"不太行",而是一句抱怨:活没干完,积分先干完了。
UP主模真真注册WorkBuddy第二天就发了条实测视频,标题直接就是这句话,播放1.1万、评论刷了167条。 微博那边,有人晒自己"积分只有这点了,看我能不能在用完前把游戏做出来,几个免费模型每天的免费额度我全用光的",有人说"workbuddy+GPT法力无边,就是积分烧得太快",还有人用了两个月Lobster和WorkBuddy,得出的结论是"Workbuddy用着用着额度就没了,Lobster没遇到过"。 小红书更直接,一条《这三个坏习惯烧掉你的积分》攒下138赞173藏,评论区全是"我中枪了"。哔哩哔哩微博小红书
这不是某一家产品的毛病,是2026年这一波"按积分干活"的AI Agent共同的账本问题:订阅费你看得懂,积分你去不掉。这篇就替你把这本账算清三件事:积分到底烧在哪、同样一笔积分怎么花出60倍差距、以及这几天正在关门的白嫖窗口,赶不赶得上。
一、积分烧掉的不是"答案",是你每轮都要重新付的"上下文"
绝大多数人的直觉是:问题越复杂、答案越长,扣积分越多。错了。
模真真把测试做成了流水账:同一个对话里连发21条消息,第一条让AI完整读一份1760行的长文档,后面问20个问题,每一轮扣多少积分,直接读本地日志里的实扣记录,最后按"1000×总token÷实扣积分"折算。 结果很反直觉:输出只占总量不到1%。每一轮真正的大头,是系统提示、缓存命中和重复注入的上下文。说白了,你问第20个问题的时候,模型是把前面所有内容再"读"一遍才回答你,这一遍"再读"就是要花钱的。哔哩哔哩
所以决定烧多少的关键变量不是任务难度,而是缓存命中率。同一份文档连续追问,第2轮开始大部分上下文走缓存,便宜;一个对话里不断换主题,每轮都要重新灌全量上下文,贵。视频评论区那个极端案例很能说明问题:有人拿它做开发,“99%的缓存命中,51亿token不到2000积分,比官方API便宜很多”;同一位又说"做PPT就不行,缓存命中很低,消耗很大"。 同一件事,两种用法,单位成本差出一个数量级。这就是为什么"我到底做错了哪一步,怎么一溜烟全没了"会成为评论区高频问题——没人做错在提问上,错在计费口径的理解上。哔哩哔哩
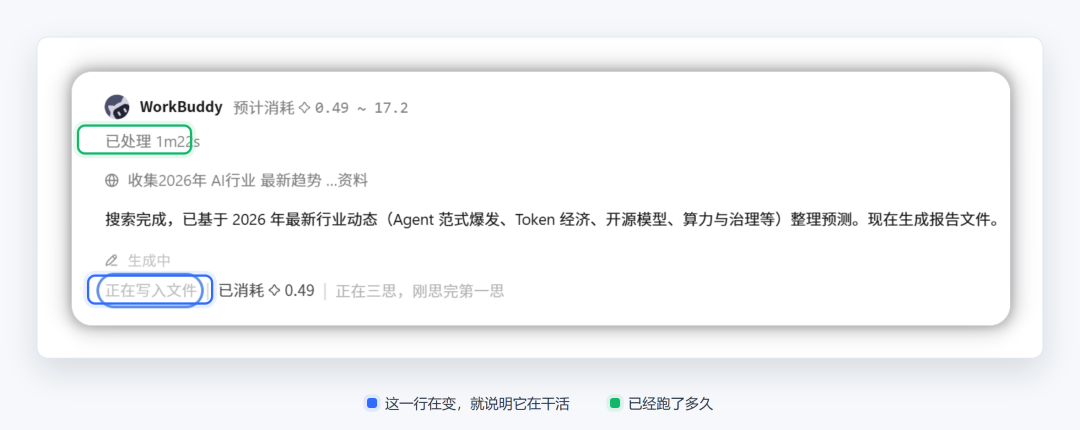
二、1000积分的单价表:首尾差60倍,选模型比升级额度管用
模真真把1000积分在12个模型上各跑了一遍,折算出每个模型大概能跑多少token、每轮实际扣多少积分。 以下是这组实测里最有信息量的几行(口径:同场景长对话、缓存率88%–93%,横向对比用,不是任何人的绝对值):哔哩哔哩
模型 | 1000积分约可跑token | 每轮实扣 |
|---|---|---|
DeepSeek-V4.1-Flash 闲时 | 7.17亿 | 1.97积分 |
DeepSeek-V4.1-Flash 高峰 | 3.69亿 | 4.52积分 |
GLM-5.3-Flash | 2.51亿 | — |
MiniMax-M3 | 5995万 | — |
Kimi-K2.6 | 2424万 | — |
Kimi-K3 | 1205万 | — |
三个可直接抄走的使用结论:
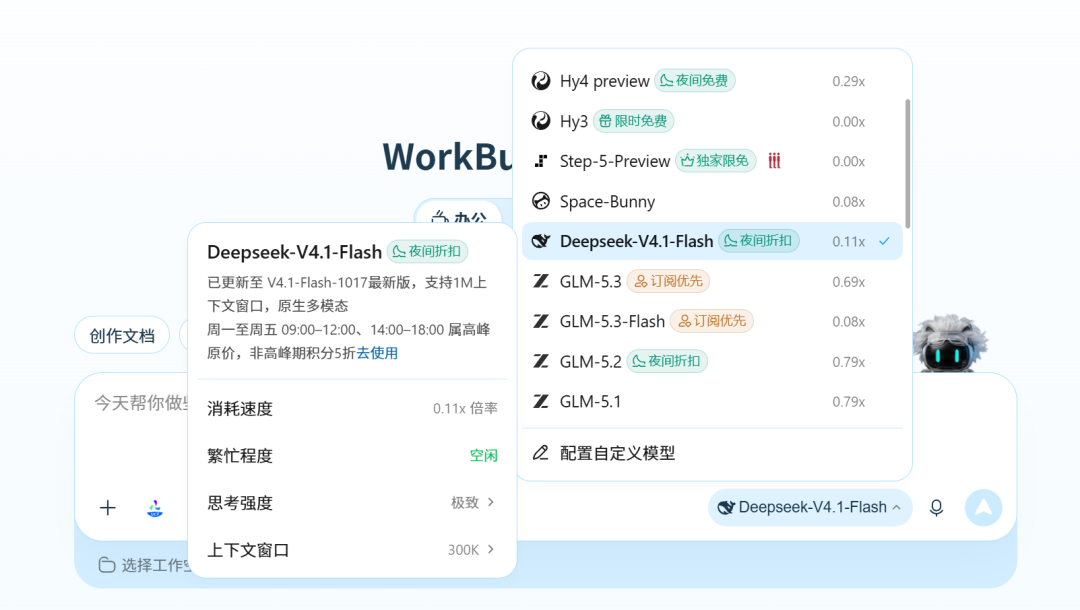
同一模型,闲时和高峰差2.3倍。DeepSeek-V4.1-Flash闲时每轮1.97积分、高峰4.52积分。重活往夜里排,不丢人,是省钱。
最便宜的模型能跑7.17亿token,最贵的只有1205万,差近60倍。评论区那句"选对模型比升级额度管用多了"是这组数据最直白的注脚。有人算过锚点:WorkBuddy约1积分相当于DeepSeek官方API的0.07元——你觉得贵的时候,多半是选错了模型,不是选错了平台。哔哩哔哩
别被"倍率"字面骗了。评论区有人问"GLM-5.3-Flash倍率才0.06,怎么才跑这点token"——倍率低不等于绝对便宜,还要看模型本身的上下文规模。这就是为什么需要横向实测,而不是对照官方倍率表心算。
海外那边同一时间也在算这本账:SemiAnalysis把各家订阅套餐的额度按API价格折算再除以月费,发现不同套餐的"含金量"能差出10倍,Claude、MiniMax的倍数偏高,GPT相对低,而且对话和Agent两种用法的折算结果也不一样。 结论殊途同归:计费的差价,永远比标价的差价大。哔哩哔哩
三、社区流传的"三个坏习惯",对两个、纠正一个
小红书那条高收藏帖列了烧积分的三个坏习惯:让AI读整本PDF、一直在同一个对话里聊天、选错贵模型。 结合上面那套机制,逐条核对一下——小红书
选错贵模型:成立,而且是大头。60倍差距摆在那。
让AI读整本PDF再逐段问:半对。读整本PDF本身很贵(全量灌入),但灌完之后连续追问反而便宜,因为缓存率高。真正浪费的是"读完就关"——一次性任务没必要喂整本,挑章节、给摘要,够用就停。
“一直在同一个对话里聊天”:这条在多数情况下要反着听。实测方案恰恰是21条消息全在同一个对话里——同一主题的连续追问,留在原对话里吃缓存才是省钱解;只有当你换主题时,旧上下文才会被全量重新计费,这时候才该开新窗口。判断标准就一条:接下来问的和前面的内容还有没有强依赖。
一句话总结:新开会话的时机对了省一大截,时机错了(一天开8个新窗口问同一份文档)反而8倍烧。这条社区误传,恰好是缓存机制最容易被直觉搞反的地方。
四、这几天正在关门的窗口:能白嫖的先白嫖
积分政策这周动得很密,都是官方口径。WorkBuddy内腾讯Hy3限时免费到10月31日,Hy4 Preview每晚23:00–08:00免费,同样到10月31日;GLM-5.2夜间挂0.79倍率,积分立减;阶跃Step-5-Preview的独家限免只到10月25日,这个窗口本周末就关。哔哩哔哩
官方价格动作也在同步出现。小米MiMo-V2.6-Pro重新上线,积分系数从0.18x降到0.13x,等于官方降价28%。 10月16日WorkBuddy发了DeepSeek服务异常的补偿公告:返还10月8日至14日受影响用户消耗的积分,国内版全量用户每人再送500积分——去账户里看一眼,别错过已经到账的。10月19日教育公益版上线,全国所有教师均可连续一年免费领取积分,入口就在左上角应用里。 家里有老师的,这是全互联网目前最划算的一份AI额度。微博微博
按实测表里的用法折算:每天赠送的100积分差不多就是一个PPT的量,夜间混元4免费。非重度用户理论上可以一直白嫖,重度用户则应该把大任务卡进免费、夜间窗口。窗口期就这么几天,10月25日和10月31日两个日期,现在收藏比什么都值。
五、两个提醒:限流和新号演示
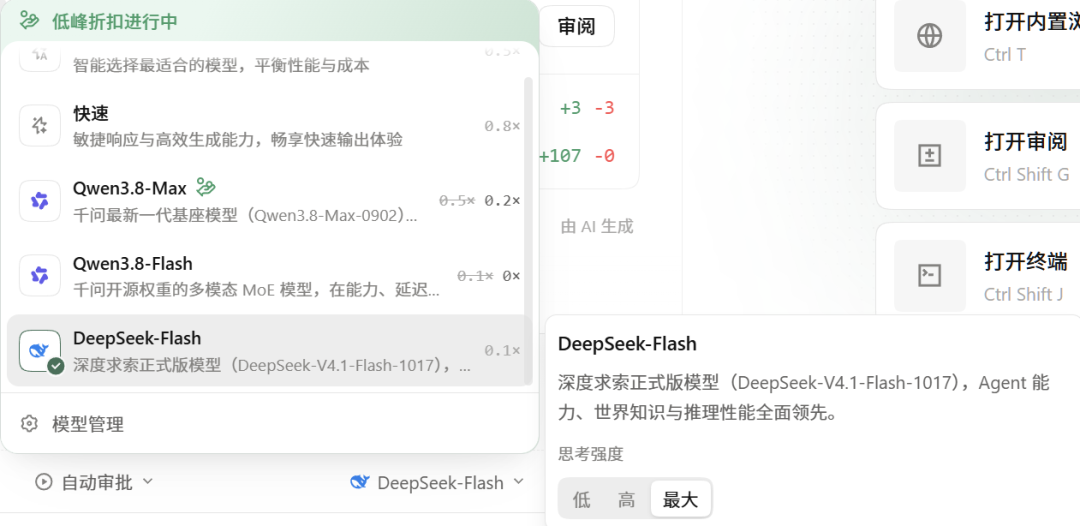
一是有积分也可能用不掉。评论区吐槽很集中:“四千多积分还没开始蹬爽就被限了”,“有用量上限,有积分也没用”。 平台对每日用量有软上限,接大活之前先看当日剩余额度和限流提示,别把最急的活儿排在月底额度见底的那几天。哔哩哔哩
二是新号第一脚别踩"演示"坑。有人第一次打开某个AI Agent创作工具,让AI自己先演示了一下能干什么——一句话烧了30000积分。 新工具上手,先问清楚单次任务的积分扣法,用小任务试水,别让热情的演示替你消费。小红书
六、最后:值不值得把活交给AI,按人头对号
轻度用户(偶尔一个PPT、整理一次会议纪要):每天赠送积分+夜间免费窗口就够,别买任何套餐。
中度干活党(开发、写稿、做课件,有连续上下文):值得。选闲时DeepSeek-Flash或限免的Hy系模型,同主题别开新窗口,按实测数据,同样的积分够你多干3–5倍的活。
重度视频用户(抽卡、漫剧、短片):这是另一本账,视频平台按生成次数计费、废片率高,积分消耗逻辑完全不同,混用上面的经验会踩坑,需要单独看素材生成的省钱实测。
律师、教研这类批量整理证据/材料的:微博上一位律师的原话是,客户发了20多个录音、整理证据这种活"烧token也不心疼"——对他来说时间成本远高于积分成本。判断标准只有一个:你的时薪和积分单价谁高。微博
下周值得继续盯的信号:10月31日限免结束后Hy3/Hy4是否恢复原价、GLM-5.3-Flash倍率会不会继续下调、以及各工作台会不会跟进"先充后用"。积分清零和低价拉新的窗口期不会太久——36氪那篇讲AI创作平台计费乱象的文章标题已经说明了趋势:“价差12倍、低消套路、积分清零,AI超创该算账了”。36氪
账已经算完了。剩下的就一件事:趁窗口还在,把活派出去。