10月20日,PyTorch Conference 2026 首日,谷歌把 TorchTPU 正式开源了——这是谷歌和 Meta 的 PyTorch 团队共建的 TPU 原生后端,Apache-2.0 协议,0.2.0 版本已经挂上 PyPI。 卖点是一行代码:把 `.to(“cuda”)` 改成 `.to(“tpu”)`。同一天,vLLM、SGLang、Hugging Face Transformers v5、TorchTitan 全部发布 TPU 集成;隔一天,亚马逊把同路的 TorchNeuron 甩给了 Trainium。知乎
圈子里"CUDA 护城河被一行代码凿穿"的声音又开始刷屏。作为替大家把发布会博客、GitHub 仓库和第三方评测都翻完的人,先说结论:提速是真的,替代还没发生,"CUDA 要完"更不是今天的事实。要不要换芯片,取决于你的负载属于哪一格。
先纠正三个流传很广的说法
第一,这不是横空出世。 项目 2025 年中就立项了,今年 4 月谷歌开发者博客已经公开过"Eager First"的设计,路透社去年 12 月的报道标题直接就叫《Google works to erode Nvidia’s software advantage with Meta’s help》。 那几天微博科技圈的讨论热度不小,12 月 27 日"英伟达或被谷歌 TPU 逼到墙角"的话题下吵了 61 条评论。 10 月 20 日是开源加生态全家桶落地,不是首发。换句话说:想上车的人,其实早就有十个月预热期了。知乎微博
第二,XLA 没被杀死。 TorchTPU 的编译路径仍然是 TorchDynamo 抓图 → StableHLO → OpenXLA 编译,被取代的只是 PyTorch/XLA 那条 2020 年推出的 lazy 接入老路(要改源码划定编译区、编译延迟大、没有原生 eager,这些毛病是谷歌官方自己点名的)。 但 PyTorch/XLA 至今没有正式的弃用/EOL 公告,谷歌只是把新后端定位为替代路径;JAX 那边也明确说了 vLLM-JAX 和 SGLang-JAX “仍然是重要项目,继续维护”。有个比喻挺准:PyTorch 正在变成 AI 界的 JVM——字节码和虚拟机都还在,换掉的只是你写代码时要伺候的那套规矩。知乎
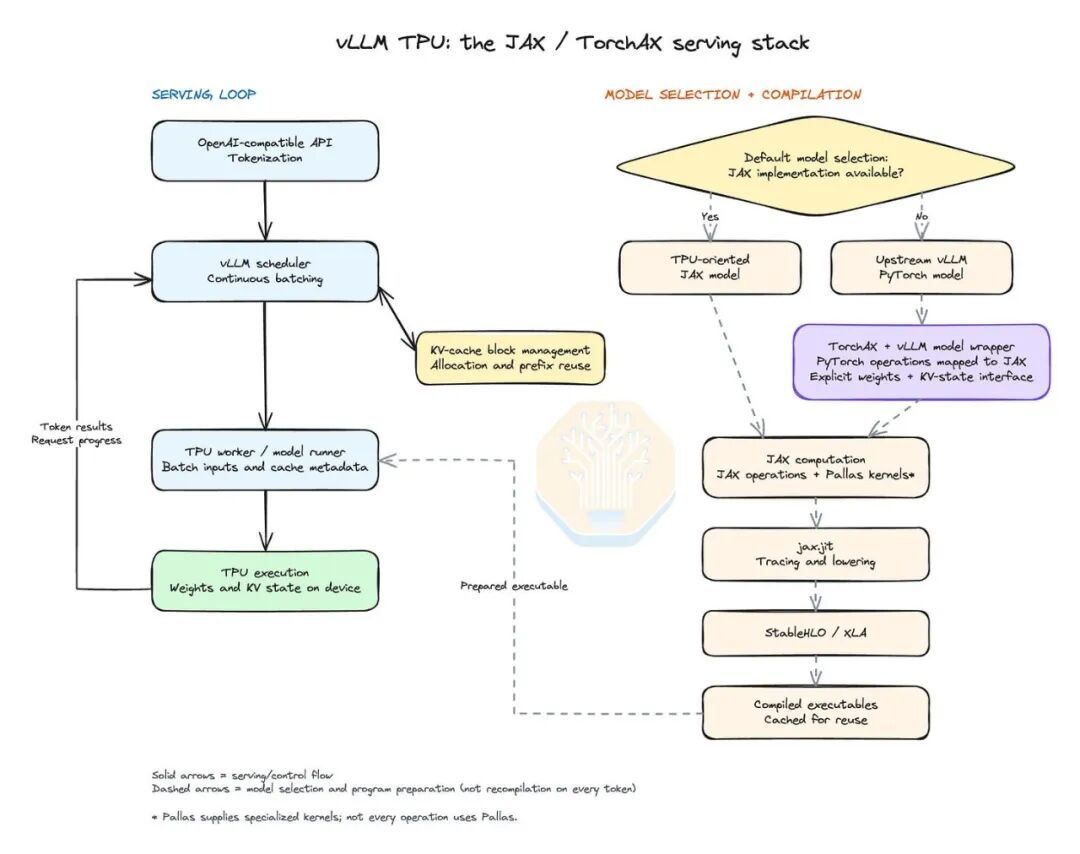
第三,同一天还有个没上热搜的新闻。 财联社 10 月 21 日报道,谷歌云与英伟达宣布 Vera Rubin 基础设施全面可用,规模要扩到 96 万块 Rubin GPU。 谷歌在两条线上同时下注:TPU 给成本党,英伟达给时延敏感党。这是"双栈",不是"改朝换代"。微博
到底能省多少:先看清哪些数字站得住
被引用最多的三组数据,条件都得摊开讲:
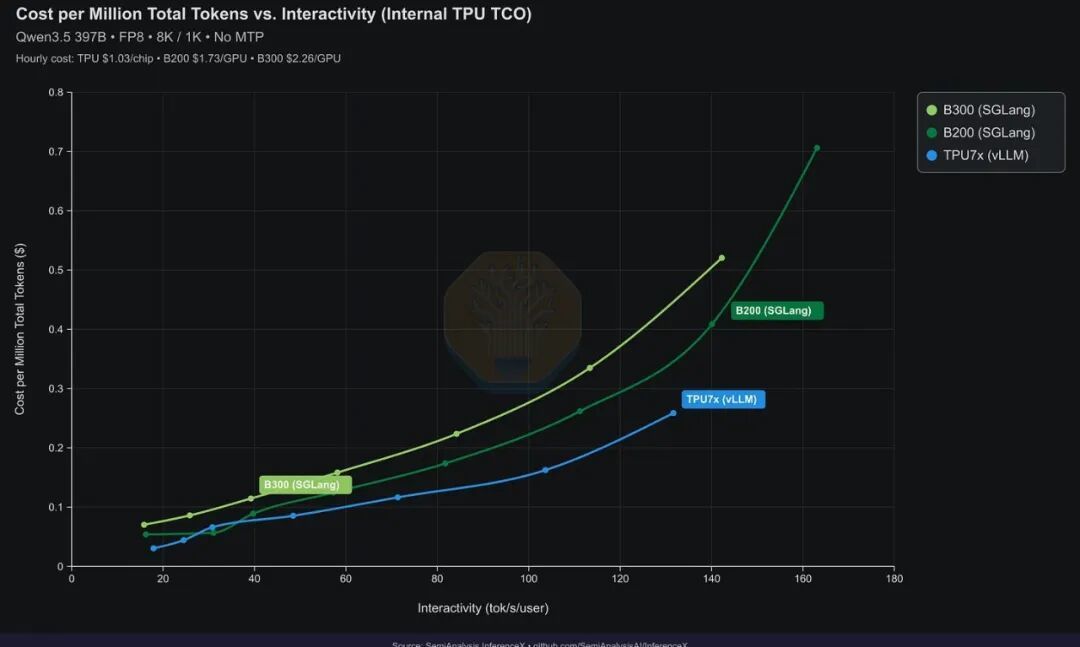
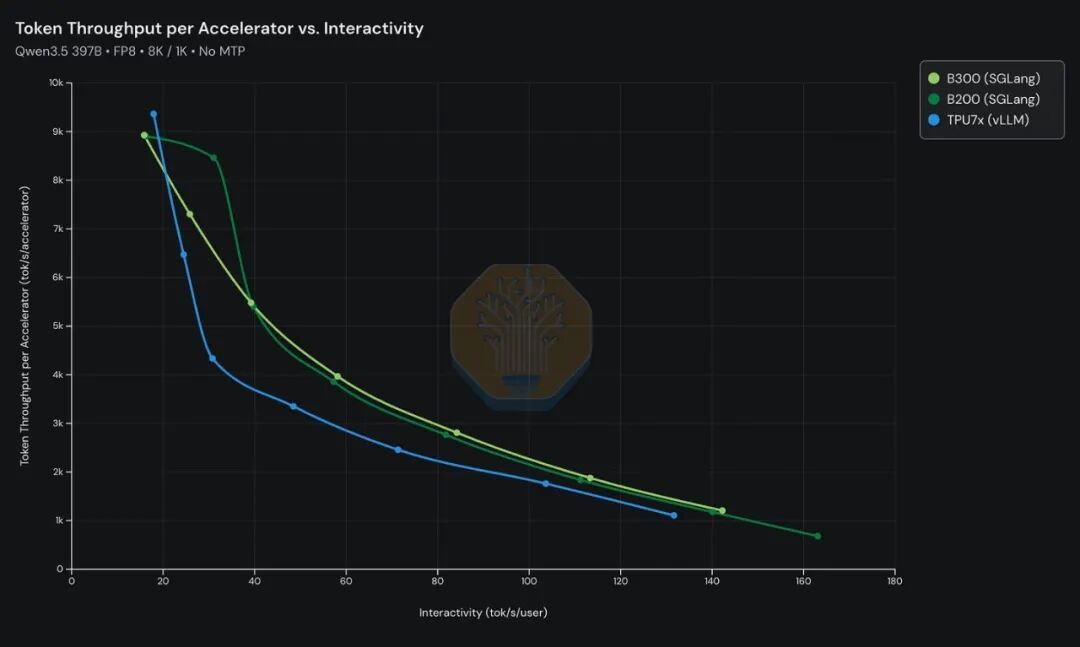
成本面(SemiAnalysis 的 InferenceX 测试,FP8 开源模型、同等每用户生成速度条件下):每用户 100 token/s 的交互速度下,TPU v7(Ironwood)每百万 token 成本约 0.181 美元,B200 是 0.222,B300 是 0.276——便宜约 19% 和 34%;按每美元产出 token 数算,比 B200 多 50.4%,比 B300 接近翻倍。36氪
速度面(Inferact 的公开 benchmark,16 块 TPU v7 对 16 块 GB200,同一引擎同一模型):跑 Kimi K3 配 DeepSeek 的 DSpark 推测解码,709 token/s 对 452,快 57%;关掉推测解码、batch=1 裸速,249 对 127,接近翻倍;跑 Qwen 差距更大,1515 对 695。精度无损,GPQA-Diamond 94.4%、GSM8K 97.2%,与 GPU 结果完全一致。量子位
但也有数字站不住的方向:TPU v7 不支持 FP4,跑 FP4 量化模型英伟达仍然领先;高并发 256 时首 token 时延(TTFT)TPU 要 5.41 秒,B200 是 3.75、B300 只有 2.40,快响应对话场景 TPU 反而慢。 对比 GB300 NVL72 的分离式服务,中延迟区间英伟达还有约 30% 性价比优势(TPU 外部分离路径还没优化完)。而且那套把 92 层 MoE 焊成单个 Pallas 程序、让编译从 30 分钟降到 90 秒的 megakernel,是针对 K3 模型结构手写的——换个架构就要重新适配。36氪量子位
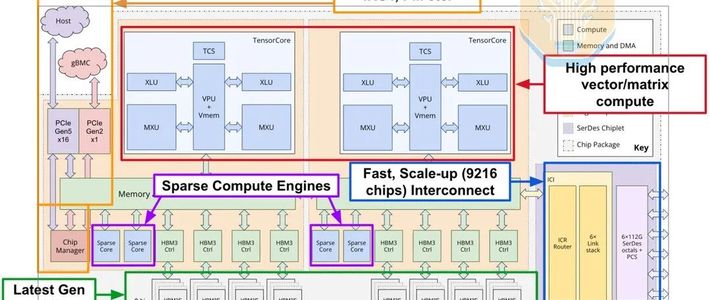
最反直觉的一点:赢的那块芯片内存带宽反而更低(TPU v7 是 7380 GB/s,GB200 是 8000)。 胜负手在软件层,不在参数表——Ironwood 这张架构图里你能看到,算力堆之外真正决定效率的是内存层级和片上调度:量子位
这也是整件事的本质:芯片厂商抢的不再是你的采购单,是你每天写代码的默认工作流。
谁该现在试,谁该再等等
值得马上开一个 TPU 实例做评估的:
部署 FP8 开源权重的推理服务,尤其 Qwen、Kimi、GLM 系——谷歌首批支持模型就是 Qwen 3.5 397B FP8,后续扩展到 Kimi K3 和 GLM 5.3;
批量、离线、对单 token 成本敏感的任务:蒸馏语料、批量生成、跑评测;
还没绑定任何硬件的新项目:一行 `.to(“tpu”)` 的试用成本几乎为零。
建议再等等的:
FP4 量化负载(等原生 FP4 的 TPU v8i);
低时延对话产品(TTFT 吃亏,外部分离式路径还没补齐);
写了大量 CUDA 自定义 kernel、重度依赖 Triton/Inductor 工具链的代码——TorchTPU 走的是 StableHLO + XLA,不是 Inductor + Triton,那些 kernel 带不过去;
已有成熟 PyTorch/XLA 或 JAX 产线的团队:官方建议迁移,但后端差异、版本兼容和回归测试都得自己排期,别一把梭。
看完之后最该做的动作,不是加购显卡也不是退订 GPU,而是挑一个真实模型做影子测试,盯四个问题:编译稳不稳定、动态 shape 会不会反复重编译、常用算子覆盖全不全、线上出故障有没有诊断工具。这四个答案,才决定它能不能接生产流量。知乎
为什么是现在,以及接下来盯什么
同一周里,DeepSeek 开源了 DeepInfer,谷歌开源了 TorchTPU,皮查伊在专访里把话挑明:算力分配第一顺位是前沿 AI,云业务短期收入随时可以牺牲。 镜像着看就懂了:引擎和适配层都不稀缺了,稀缺的是芯片,和芯片背后的吉瓦。微博
接下来三个信号值得持续盯:vLLM/SGLang 官方 first-class 支持列表会不会加上 TPU;TPU v8i 的原生 FP4 和分离式优化能不能抹平英伟达的优势项;PyTorch/XLA 会不会发正式弃用公告——那是谷歌全面转向的明确信号。
护城河没塌,但开始松动了。真正的选择权,从来不是代码看起来能不能换设备,而是换过去以后,你清楚自己省了什么、又新花了什么。