10月28日上午(北京时间),第三方评测机构 Artificial Analysis 把智能指数升级到 v5,这是该机构自今年1月上线 v4 以来评测标准改动最大的一次重构。 次日IT之家发布榜单快讯,确认 DeepSeek V4.1 Flash 1017 在这版新榜单新增的代码基准 FrontierCode 2.0 上,拿下了开源模型最高成绩。小红书IT之家
但这个"登顶"要两头一起读。已经开放权重的模型里,1017 的综合分(max 配置)只有 32 分,和 GLM-5.3 并列开源最高,距头部闭源旗舰差着 26 分以上。 另一头,v5 发布当天由 Claude Opus 5.5 以 58 分居首,同日发布的新模型 Gemini 4 Carbon 随后以 59 分登顶。 更关键的结构性变化是:开源与闭源顶配之间的分差,从旧版 v4.3 的大约 3 分,被 v5 这把更严的尺子一下子拉大到了 12 分。 换句话说,开源模型第一次在"代码能不能进生产主线"这种硬标准上站到了自己阵营的最前面,而它与闭源旗舰的科研短板,也被同一份榜单同时照了出来。知乎知乎小红书
FrontierCode 2.0 这把新尺子,考的是"该不该合并"而不是"会不会写"
v5 最核心的动作在题目上:60% 的评测权重首次建立在私有测试集或隐藏答案之上,用来压缩公开题库被训练数据"污染"、厂商"为了跑分而跑分"的空间。 新增的两项测试都指向真实工作流:代码修改用的是 Cognition 在10月28日刚发布的 FrontierCode 2.0,132 个任务全部来自真实代码库,按改动能否达到维护者愿意合并的标准评分,任何一项关键检查没过就记零分。 相比 1.0 只问"这个 PR 你合不合",2.0 进一步问"该不该合",还故意把提示词写得欠指定,不把工程决策全喂给模型,逼它自己拿主意。 这正是这项"开源第一"含金量的来源:它比的是写出来的代码配不配进真实仓库的主干分支,而不是过去被反复吐槽的答题式跑分。当然也要说清位置——FrontierCode 2.0 的总榜第一仍是 Claude Opus 5.5,1017 是开源阵营里跑得最快的。IT之家知乎微博
一张榜单,涨跌两头:工程在追,科研露馅
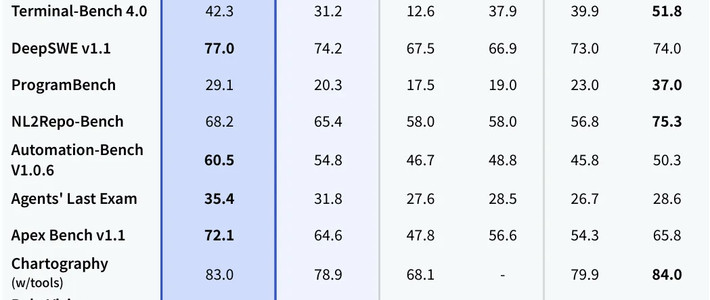
1017 的涨是可查的:距离上一版发布 37 天,Terminal-Bench 4.0 从 31.2 分涨到 42.3 分;在 DeepSWE v1.1 软件工程基准上它拿到 77.0,超过上一版的 74.2,也超过了官方对比组里 Claude Opus 5 的 74.0 和 GPT-5.6-Sol 的 73.0。 一个开源权重的模型,工程科目站到了这个身位的闭源旗舰前面,这在半年前还很难成立。小红书
跌同样清楚:Terminal-Bench-Science 科研工作流里,GPT-6 Astra 的 max 配置能通过 63% 的任务,1017 的 max 配置只有 13%。 无工具 HLE 上它 42.6 分对 56.3 分,从零写大程序的 ProgramBench 是 29.1 对 37.0。开源掉分最狠的两块——硬核推理和科研 Agent,恰恰是 v5 新加权的科目,这正是分差被拉到 12 分的具体落点。知乎
分数之外,用量那一头也是第一
OpenRouter 最新周榜(10月19日至25日)上,1017 单周调用量 33.6 万亿 token,环比增长 801%,登顶全球;第二名是刚被它替换下来的旧版 V4.1 Flash(18 万亿,环比下滑 45%),迁移速度本身就是需求信号。 这个版本也解释了热度的来路:10月17日晚线上模型直接换成 1017,延续 552B 总参数、输入只激活 8B、输出 16B 的非对称 MoE 架构,API 调用名称和价格都没动。36氪知乎
便宜也不只是补贴:10月20日 DeepSeek 开源推理框架 DeepInfer 时披露,单集群一天服务 155 万亿 token,线上平均输入缓存命中率 96%,单卡每小时收入 38 美元(按谷价)——agent 类负载天然的长前缀反复命中,才是低价的结构底座。 不过这个"第一"的口径有边界:它只统计经 OpenRouter 中转的公开调用流量,厂商自有 API、App 和私有化部署都不在池内。 也有分析指出,801% 的分母被版本切换压小,把新旧两版合并计算后实际周环比约 42%。知乎36氪小红书
这份榜单该怎么用:先补跑分之外的三个提醒
跑分和真实产出之间还隔着脚手架:同一个模型跑同一个 Terminal-Bench 4.0,官方用 Claude Code 框架跑出 42.3,Artificial Analysis 独立测试只给 26.8%——"模型加 harness"才是真实生产力,选型时这 15 个点的落差不能忽视。 也有开发者提出,FrontierCode 2.0 评测里不同阵营的模型使用了各自的 harness——Claude 家配 Claude Code、OpenAI 配 Codex,其余开源模型统一用 Devin,开源侧的分数可能被结构性压低。知乎微博
对普通团队,这件事可以落成三条判断:第一,别拿 v5 分数和旧榜单直接横比,尺子换过了;第二,看分项和单任务成本,别只盯总分——同一旗舰从 low 档开到 max 档,分数能涨 20 多分,成本也会跟着翻数倍,档位本身就是成本选项。 第三,agent、批量编码、长文档场景,1017 已经是默认主力候选;硬核科研推理和从零写大型项目,仍要靠闭源旗舰。至于下一轮洗牌——开发者在 DeepSeek 官方代码仓库的测试文件里发现了三个从未公开的模型标识符 deepseek-v5、deepseek-v5-open、deepseek-v5-next,目前看还是发布前的占位符,但按五周一个 minor update 的节奏,这份榜单很快又会重排一次。小红书知乎