一场直播里,主讲人说“我们打算下周发布”。字幕先蹦出“我们打”,停两秒,改成“我们打算不”,又过一秒,才补成“我们打算下周发布”。知乎
人看字幕,闪三下还能忍。可屏幕后面如果挂着一个语音 Agent,它可能在“我们打”那一秒去理解“打架”,在“我们打算不”那一秒又切到否定逻辑。等第三版字幕出来,动作已经发出去了。
网易有道开源的 Confucius4-R2T2,盯的就是这个缝隙。它提了个反常识的判断:实时语音识别的瓶颈,不只是听得准不准、出字快不快,还有“已经吐出去的字,能不能不反悔”。
过去几年,流式识别的默认做法是“先出再改”。延迟压得越低,改得越勤。屏幕上的字像草稿,随时会被下一段音频推翻。对看字幕的人,这是闪烁;对下游系统,这是一份不能立刻执行的合同。微博
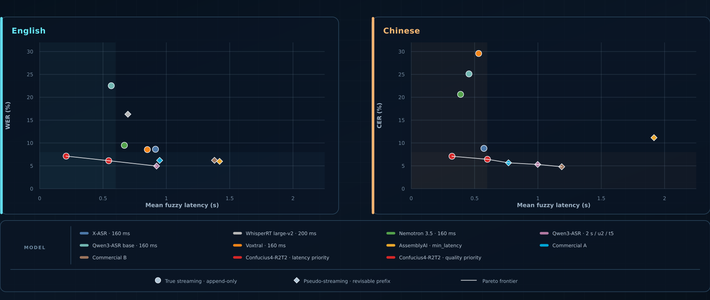
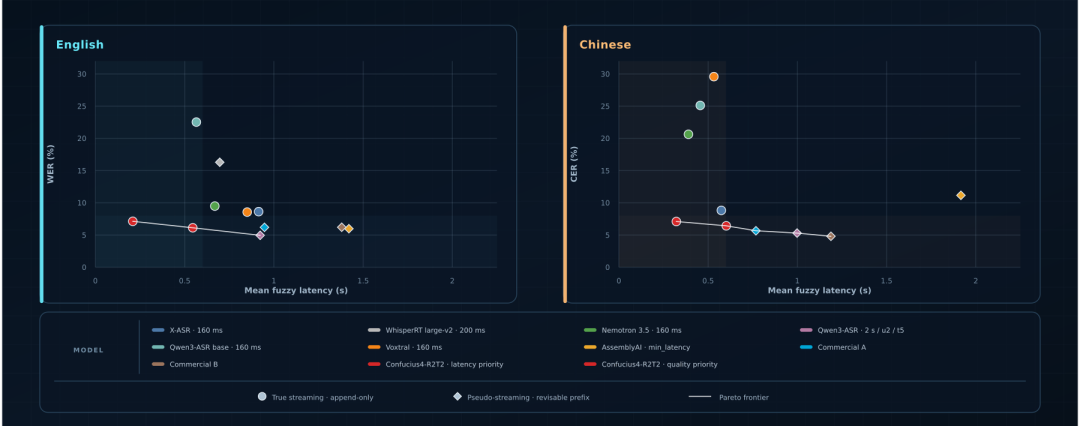
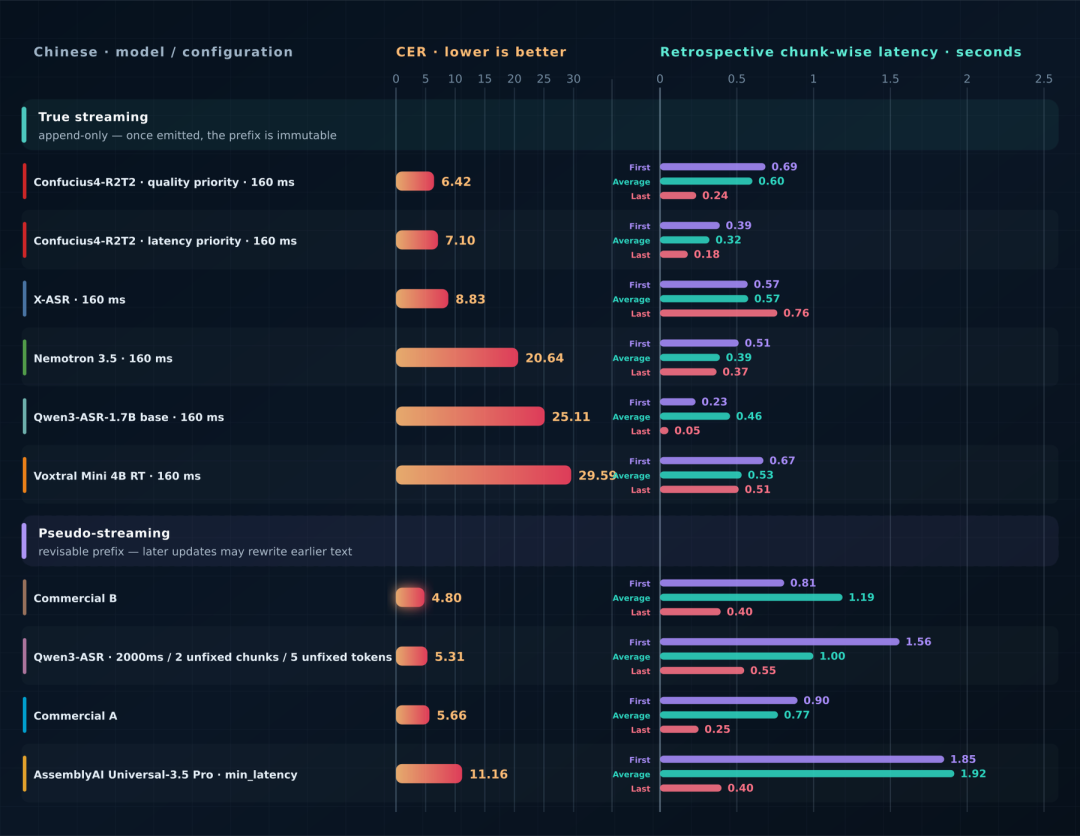
把两种路线画在同一张延迟-错误率图上:圆点是只增不改,菱形是随时回改;两个红点,是有道的两档配置。
R2T2 走的是另一条路:只增不改。模型把音频切成可调的块,最小 80 毫秒一段:当前这段里,哪些字已经稳到“后面不会再变”,就永久提交;没把握的部分先压着,等更多上下文。知乎
这套机制叫最长稳定前缀。训练时用一个更强的离线模型当老师,标出每段音频“迟早不会变”的前缀,再让 R2T2 学会什么时候该等。
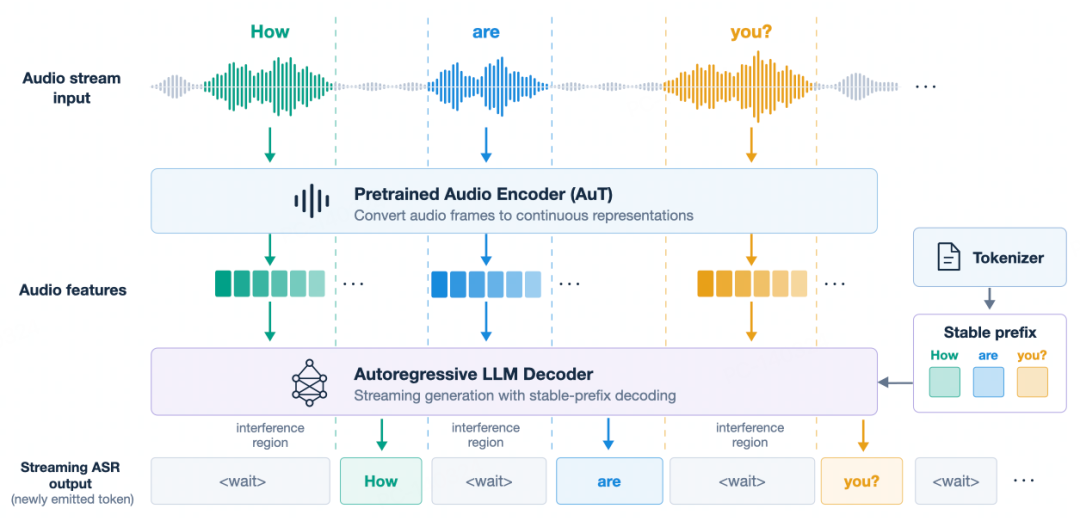
这有点像同传。新手听到第一个词就开口,错了再改;老手会等半句,确认方向没错才说话。R2T2 学的是后者的克制。
光靠提示词约束不够。已经提交的内容,在解码路径上直接锁死。回改不是一个选项,而是一条走不通的路。知乎
代价也明摆着:它会多等一会儿。官方给的平均延迟是 200 到 600 毫秒,解码块从 80 毫秒到 2 秒可调,想快用小块,想准用大块。知乎微博
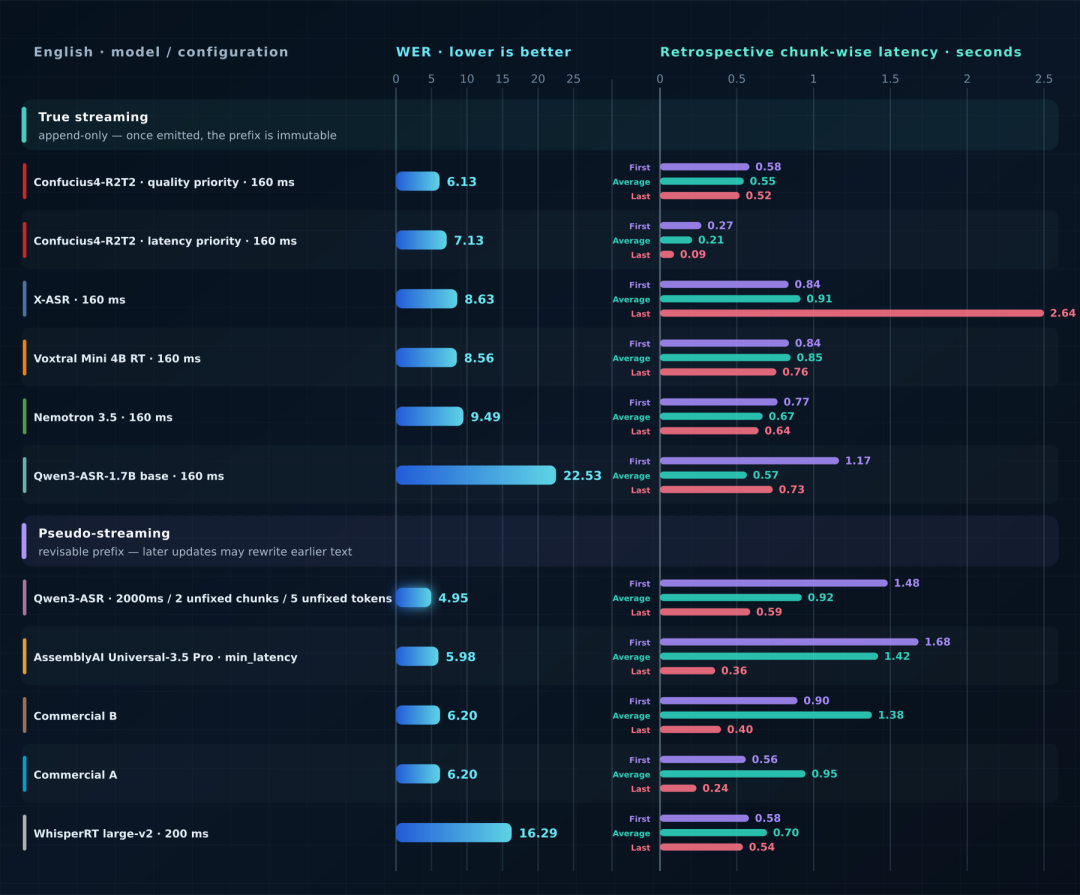
官方图表给出的中文 CER 是 6.42%、英文 WER 6.13%,说法是接近离线识别。
模型只有 2B,普通轻薄本能跑。微博
发布后,Hugging Face 主动搭了 ZeroGPU 在线 Demo,第三方把它移植进纯 C++ 的 audio.cpp,还出了从 Q2 到 Q8 的 GGUF 量化版本。知乎微博
配套的 14B 翻译模型 T3PO 负责边听边译,两个模型接起来,就是一条“边说、边识别、边翻译”的同传链路。
两款模型先后登上 Hugging Face 的 ASR 和 Translation Trending 榜首。知乎微博
但别把它当成万能药。官方重点优化的是中英文,其他语言的流式表现还没公开完整基准;延迟数字也跟解码块大小、硬件配置绑在一起。知乎
技术拆解里还提到一个细节:默认实现给末尾留了一个可微调的 token 窗口。要做到“一个字都不能动”,得把这个窗口关掉,再重新评估准确率。
对普通用户,变化可能只是字幕晚半拍,但不再跳来跳去。对做语音产品的人,这是一次提醒:延迟低不等于能信。你可以做个测试,在字幕出现的瞬间触发下游动作,看它会不会被后一句推翻。会,就还是伪流式。
网易有道过去被人记住的是词典和翻译笔。这次它把“什么时候该等”做进了模型里,卖的不是更快的字,是更敢用的字。