10月20日,DeepSeek干了一件业界没人干过的事:把支撑自家线上服务的推理框架DeepInfer,以Apache 2.0协议免费开源。知乎知乎
这相当于一家天天排队的餐馆,把后厨运转手册一起公开。数字很炸:单一集群每天处理155万亿token,每卡每小时收入38美元(按谷价)。官方实测缓存命中率96%,前缀对上就从盘里捞结果、跳过重算。仓库很快攒下2.2万星。有媒体顺手算出"单卡年营收33万美元"。评论区更把"收入"直接改写成"利润",连回本周期都排出来了。知乎知乎
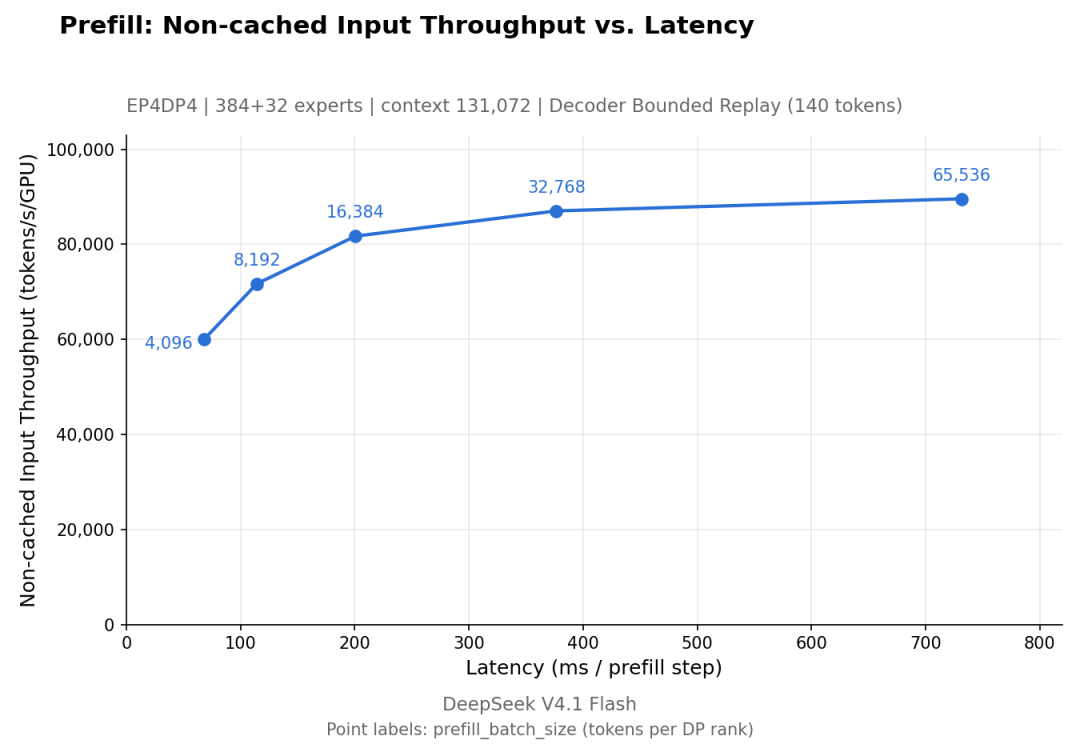
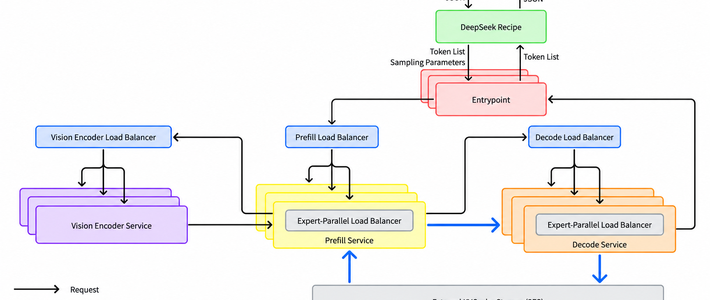
但先别激动,翻到README最后几行:三项"not included"。开源版不含KV缓存系统、Prefill/Decode分离部署、跨副本负载均衡——翻译成人话:交出的是发动机,不是整车;这三样恰恰是把离线跑分变成线上服务的轮子和底盘。小团队看到Apache 2.0就以为"能直接上生产",压测时会发现自己在补缓存和路由,而不是调框架。知乎
转折在第五天到账:两份"追平"声明先后发来。vLLM称并入DeepSeek开源的kernel后,batch 8–256下解码吞吐与DeepInfer差距在6%以内,还按DeepSeek的谷价算出每卡每小时38.96美元收入。SGLang更彻底,公开双方commit与基准脚本,prefill吞吐最高1.04倍,顺手补齐了那三件缺失组件。讽刺的是,DeepInfer本身就基于vLLM构建——学生开源了笔记,老师把笔记编进教材,然后宣布分数打平。vLLM官方博客微博微博知乎
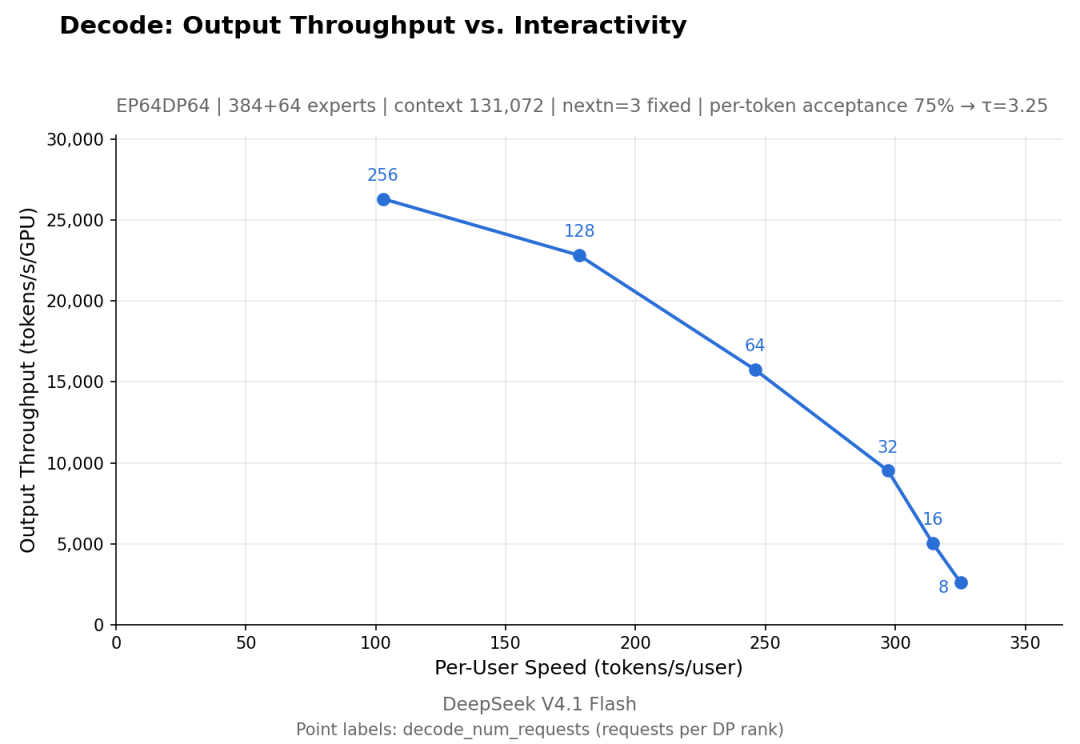
但两份声明目前都只能信一半:全是项目方自报,至今无第三方复跑;独立换算认为DeepInfer解码仍领先约1.5倍,两种说法并存。这跟你有什么关系?就算不碰显卡也是好消息:军备竞赛的本质是"用更少的卡、更少的电服务同一个模型",效率一旦成为基线,先降的是API调用价,然后是AI会员成本。如果你是自托管爱好者,记住三句:一看README缺失清单,协议不等于开箱即生产;二见"追平"先要复现脚本,一张图不如一份脚本可信;三等第三方复现再下场,等两周不会错过,抢跑才可能亏钱。微博
开源真正的赢家,从来不是最先下载的人,而是能等到数字被验证的人。