你可能没注意过:视频会议里的 AI 字幕,为什么总在跳字闪回、说出去的字又自己吞回去改口?这不是 bug,而是行业惯例——流式语音识别默认"允许回改",先蹦出来的字随时会被新版本覆盖。人是忍得了闪一下,AI 忍不了:Voice Agent 按第一版字幕执行了动作,第二版到了,动作已经发出去,改不回来了。知乎
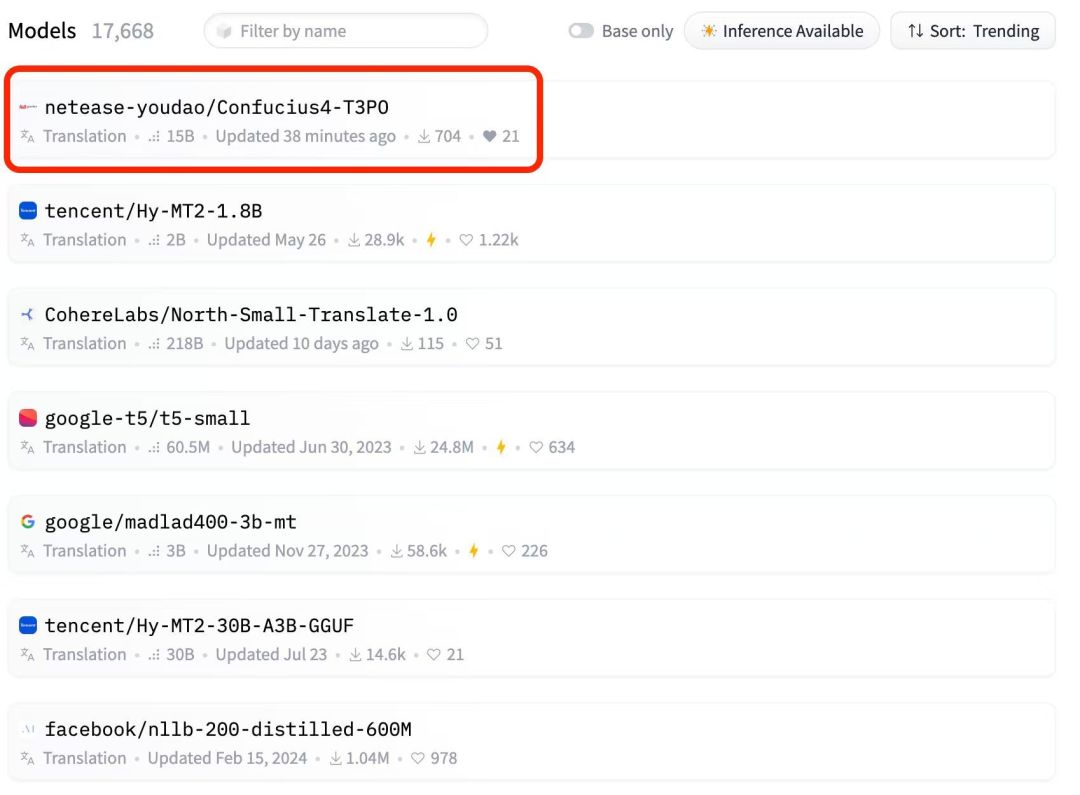
9 月下旬,网易有道开源了子曰 Live 系列的两款实时模型:真流式语音识别 Confucius4-R2T2 和流式翻译 Confucius4-T3PO,先后登顶 Hugging Face 的语音识别和翻译两张细分热榜,搞了个"双登顶"。澎湃新闻新智元
发布仅 5 天,R2T2 就坐在 ASR 榜第一,OpenAI 家的 Whisper-large-v3 排第六,英伟达 Nemotron 掉到第八。新智元
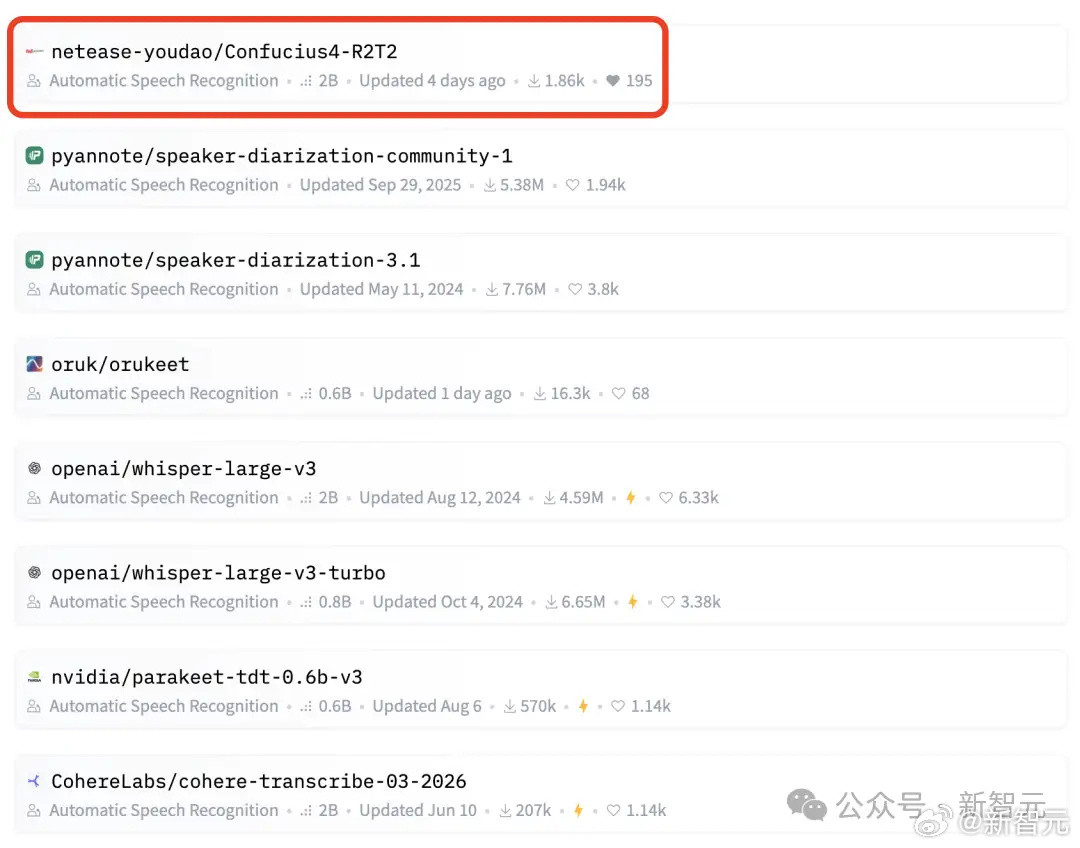 网易有道R2T2、T3PO双登HuggingFace热榜相关讨论
登顶第一的模型,第一课学的不是"说快点",是"等"
大部分玩家卷的是"怎么预测得更快",R2T2 把问题反着问:什么时候应该先别预测?海外开发者 Alex Prompter 说得直接:有道的 Confucius4-R2T2 反过来关注另一个问题——什么时候模型应该先不要预测。蚁工厂
它的规矩简单粗暴:输出不可逆。模型每 80 毫秒对当前音频做一次决策,听稳了的部分永久 commit 锁定,没把握的部分继续等音频;已 commit 的字,上了屏就不再改。已输出的文字只增不吞,在一些专业、严肃的会议里观感直接好一档。知乎蚁工厂
训练时它请了个离线强模型当老师,给每段音频前缀标出"最迟也不会再变"的最长稳定前缀(LSP),逼模型学会"等半句再开口"的克制——跟同声传译老手一模一样:新手听到第一个词就翻、翻错再改,老手等半句,确认方向不会错才张嘴。知乎
 真流式语音识别模型的Commit/Wait机制讨论
数据也不虚:中文字错率 6.42%,英文 WER 6.13%,延迟 0.55 秒,准确率几乎不输离线模型。知乎
2B 小体格,轻薄本就能跑
按开发者实测口径:R2T2 专注真流式听写,体量仅 2B,普通轻薄本就能跑,延迟低至几百毫秒;14B 的 T3PO 负责边读边译,两者直接串联就是一套完整的同传链路,整套方案已支持 vLLM 高吞吐推理,跨国会议字幕、直播转译、硬件端侧集成都接得住。爱可可-爱生活
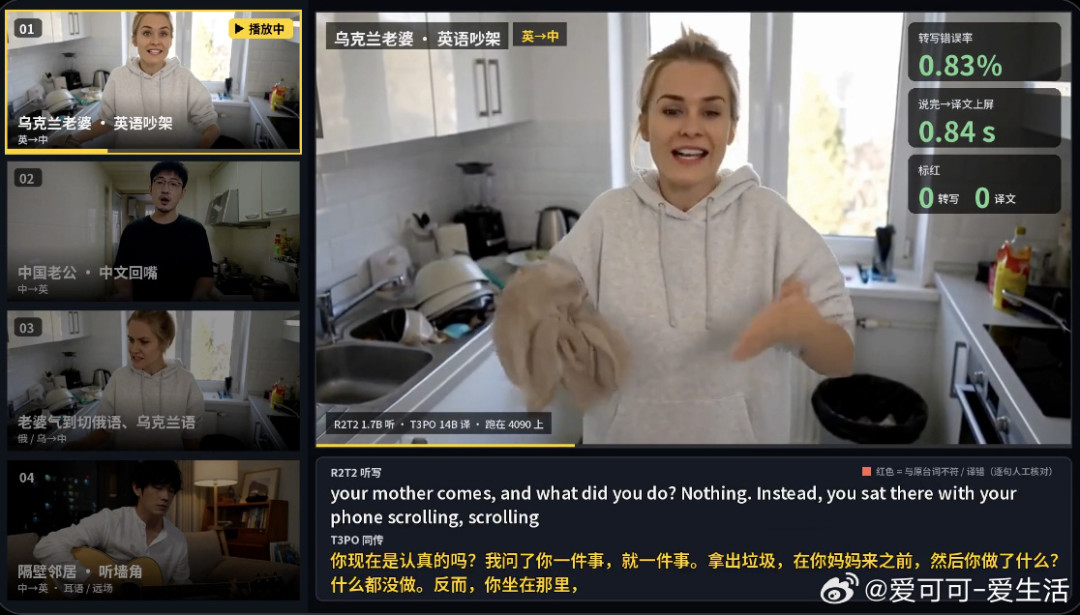 有道子曰Live实时同传组合模型介绍
开源后的社区反应也算罕见:Hugging Face 官方团队主动基于 R2T2 搭好了 ZeroGPU 在线 Demo 并免费送算力,第三方开发者把它移植进纯 C++ 框架 audio.cpp,海外量化社区也开始跟进适配。推特上也连刷了两天这两款小模型,讨论点都落在同一个反常识上——它解决的不是"更快",是"下游敢不敢立刻相信它的输出"。澎湃新闻蚁工厂
跟用有道的你有什么关系?
云笔记的会议转写、有道翻译的实时同传、词典笔和答疑笔的听说链路,背后吃的都是"子曰"这一套模型能力。9 月 18 日的有道 AI Open Day 上,首席科学家段亦涛刚把子曰模型矩阵和子曰 Live 同传模型当主打发布。更实惠的一层是:开源 = 免费、可本地跑、语音不用上云,对会议录音敏感的办公党可以直接关注。纵相新闻
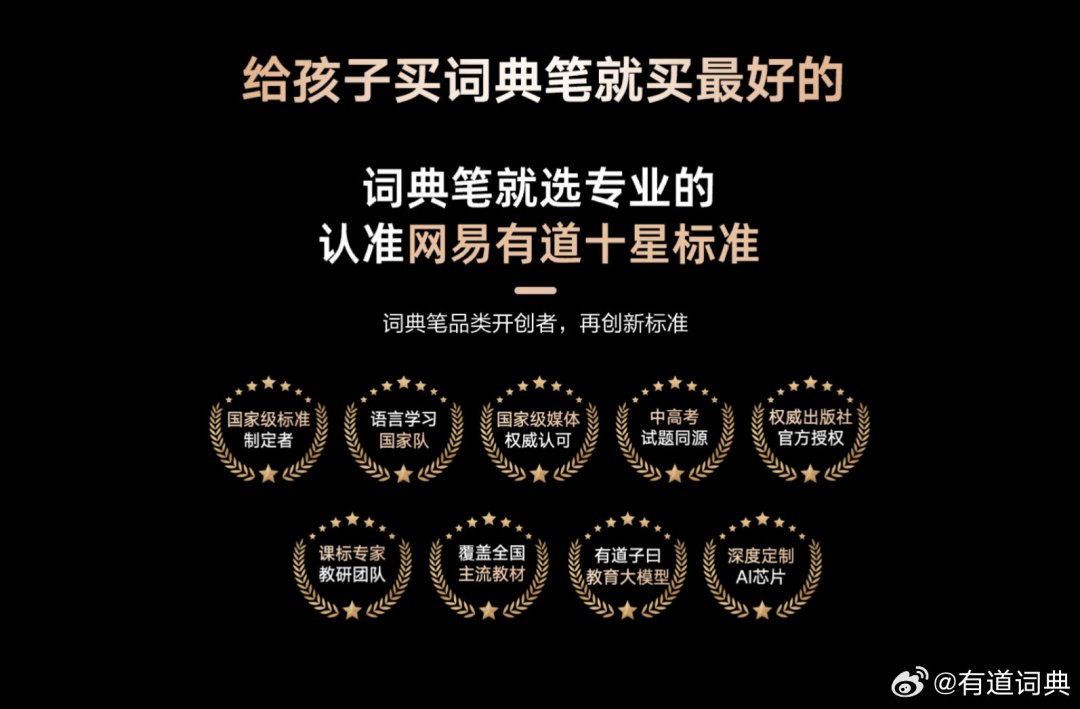 有道词典笔产品线
也别急着神化:6.42% 是跑分口径,实际体验受设备、网络影响;中英文之外 29 种语言的流式表现还没放出完整基准,别拿它当全能翻译机。知乎
一句话,前半场 AI 竞赛拼的是谁嘴快,后半场有道证明了:比"说得快"更值钱的,是"说到做到"。一家做词典笔起家的公司,把语音识别干到全球两张热榜第一——这年头,说话不反悔的 AI,才敢把活儿交给它。