


















29
38
摄像头,AI端侧硬件的下一个风口
2026-10-23 23:50:27
0点赞
0收藏
0评论
2026年世界移动通信大会上,联想展出了一台叫AI Workmate的概念设备。
它看起来像一盏台灯和一个投影仪的混合体。最显眼的部分是顶部那对500万像素RGB摄像头,官方描述是“两只正常工作的眼睛”,能实现立体3D录像和深度增强。联想给它的定位是“始终在线的办公桌伴侣”,支持语音和动作控制,可以扫描文档、整理笔记、协助创建演示文稿。
一台办公设备,最核心的传感器是摄像头。这件事放在两年前不太成立。放在今天,逻辑正在变得清晰:当AI Work从“打字提问”变成“比划着下需求”,摄像头就成了端侧硬件必须补上的那一块拼图。
——
比划,是比打字更高效的指令
先想一个具体的场景。
你桌面上摊着一份纸质合同,旁边是打开的笔记本。你想让AI帮你把合同里的关键条款摘出来,生成一个对比表格。用键盘,你需要描述“第三页第二段那个关于违约金的条款”,用语言,你需要说清楚“左边那份文件里标红的那一条”。
但如果你能直接用手在合同上划一个范围,说“就这一段,做成表格”——AI同时看到你划的范围、你手指指向的位置、桌面上文件的相对关系,指令的传递效率完全不同。手指划过的轨迹本身就是信息,摄像头负责把这层信息完整地交给AI。
腾讯WorkBuddy在9月的生态发布会上,把这件事讲得很直白。WorkBuddy负责人刘毅说,再强大的AI模型,如果无法贴近用户的真实工作现场,“就始终隔着一层‘人翻译需求给机器’的损耗”。在软件界面里,Agent的感官仅限于键盘和鼠标;进入现实工作场景,它需要摄像头作为“眼睛”。
WorkBuddy开放硬件生态时,把智能摄像头和AR眼镜、便携摄像机并列,列为Agent在物理世界的感知入口,支持“文档识别、白板转录、空间信息捕捉”。注意“空间信息捕捉”这个表述。键盘输入的是文本,语音输入的是语义,摄像头输入的是空间关系——物体在哪、手在做什么、视线朝向哪里。这三类信息叠加在一起,才是“比划着下需求”完整的技术含义。
学术界的进展比产品端更激进。南洋理工大学MMLab团队2026年发布的Hand2World,让用户在空中比划手势,AI就能生成手伸进场景里抓杯子、翻书、开盒子的第一人称交互视频,而且可以边看边调整,形成闭环交互。论文里有一句话点出了这件事的本质:世界模型已经有了“眼睛”和“腿”,能感知、能移动,但缺少一双“手”。摄像头要补的,就是让AI从“看见你在比划什么”走向“理解你想让我做什么”。
——
摄像头不再是“拍照的”,是“看懂的”
过去摄像头的产品定义,围绕的是“记录”——拍清楚、拍好看、拍得远。AI Work需要的摄像头,定义完全不同:它要的是理解。
小湃科技6月发布的ClawStation Pro,旗舰版可以同时接入4路摄像头做实时视频分析,本地部署了优化过的多模态大模型,推理精度提升16%,功耗降低37%。它的架构里,端侧摄像头负责基础视觉识别,边缘侧多模态大模型负责行为识别与场景理解,云端负责意图识别和任务处理。一颗摄像头背后是一整套“看—理解—响应”的链路,摄像头只是链路的起点。
OPPO开源的端侧多模态Agent也走了同一条路:先看懂摄像头里的真实物体,再理解语音意图,然后自动打开App完成操作。摄像头输入进入的是Agent的决策循环,而不是相册。
Meta在2026年嵌入式视觉峰会上给出的判断更直接:端侧运行多模态感知和智能体的最大技术瓶颈是内存带宽,需要在量化、模型架构、运行时优化、视觉感知四个方向同时突破。瓶颈落在带宽上而不是像素上,说明行业焦虑的已经不是“拍不拍得清”,是“看得懂之后传不传得动”。
这就解释了为什么无屏AI眼镜能跑出增速。Counterpoint的数据显示,2026年上半年全球AI眼镜出货量同比增长263%,其中96%是没有显示屏的品类——Ray-Ban Meta那种带摄像头、麦克风、扬声器但没有屏幕的形态,增长258%。Meta的Ray-Ban眼镜累计销量已经超过700万副,占无屏AI眼镜全球出货量的94%。
没有屏幕,摄像头就是它和世界之间最主要的信息通道。用户看到什么,手指过去,AI看到手指和物体之间的关系,指令就完成了。屏幕被省掉了,摄像头被推到了前面。
OpenAI的首款硬件也在走同一条路。多家外媒报道,其首款设备是一款无屏便携智能音箱,搭载摄像头和多种传感器,定位为“住在家中的人性化AI伴侣”,能感知用户周围环境和上下文。苹果、Meta、OpenAI、联想、腾讯,硬件形态各不相同,但都把摄像头放进了AI原生设备的核心传感器清单里。
——
硬件的分化:不是所有摄像头都在同一条赛道上
摄像头成为AI Work的入口,不意味着所有带摄像头的设备都会成为赢家。硬件形态正在沿两条线分化。
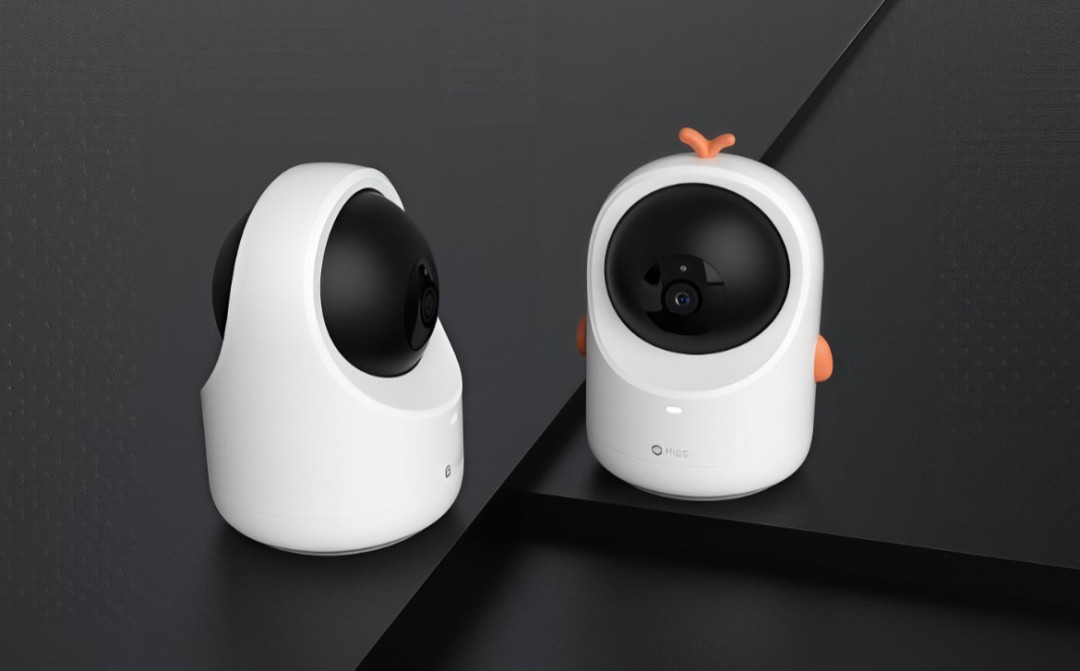
一条线是“在场型”设备:固定在桌面、房间或眼镜上,持续感知环境,随时等待指令。联想AI Workmate、小湃ClawStation、Ray-Ban Meta都属于这一类。它们的共同特征是“always-on”,摄像头的价值在于持续在场,用户不需要“打开摄像头”,它一直在看,只在需要的时候被调用。
另一条线是“调用型”设备:手机、PC上的摄像头,在用户主动发起操作时短暂介入。OPPO的端侧Agent调用手机摄像头识别物体,WorkBuddy小程序支持拍照交给AI处理板书、发票、白板。这类摄像头的价值在于降低单次交互的输入成本,但它不是持续在线的感官。
两条线都有需求,但“AI Work”这个场景天然偏向第一条。工作是一个持续的过程,不是一连串孤立的提问。用户需要在会议中比划白板上的架构图,需要在桌面上指着文件说“这一段”,需要在车间里对着设备说“就这个零件”。这些场景要求摄像头已经在场,而不是用户先掏出手机、打开App、对准、拍照、上传。
谁能让摄像头“一直在那里,且看得懂”,谁就拿到了AI Work端侧入口的第一张门票。
——
瓶颈不在像素,在带宽和功耗
摄像头作为AI感官的故事听起来顺畅,但硬件的账本并不轻松。
端侧跑视觉大模型,最大的约束是内存带宽和功耗。视觉Token会迅速膨胀KV Cache,而边缘设备的电池和散热都不富裕。Meta的判断是,需要在量化、模型架构、运行时优化和视觉感知四个层面同时推进,才能让多模态Agent在端侧跑得动。南科大在ISSCC 2026上展示的智能视觉芯片,把端到端能效做到了346 TOPS/W,方向是用“传感端计算”替代“把数据搬来搬去”。
另一个方向是动态感知。2026年6月的一项研究指出,始终在线的视觉感知对AR和辅助系统至关重要,但持续传感、推理和无线传输会快速耗尽电池;固定帧率的视觉管线不管场景是否变化都维持恒定负载,本身就是浪费。摄像头的“智能”不只是看懂画面,还包括知道什么时候该看、什么时候该省。
这些瓶颈意味着,AI Work摄像头的竞争不会停留在“像素多大、光圈多好”的参数层面。真正的分水岭在于:能不能在端侧有限的功耗预算里,把“看见—理解—响应”的闭环跑完。 跑完闭环的摄像头是感官,跑不完的摄像头只是镜头。
——
“比划着对AI下需求”这件事,听起来像一个小众的交互技巧。但它指向的是一个更大的变化:AI Work的输入正在从符号回归身体。
键盘输入的是已经被人类翻译成文字的意图,语音输入的是已经被人类组织成句子的需求。手势和视线是未被翻译的意图——手指向哪里、在什么物体上划了什么范围、视线落在哪一行字上,这些信息在传统输入方式中被丢掉了,在摄像头面前被完整保留。
端侧硬件的下一个风口,属于那些能把“未被翻译的意图”接住的设备。摄像头不是唯一的传感器,但它是最直接的那一个。当AI不再等你把需求打成字,而是看着你比划、看着你指、看着你在物理世界里移动,摄像头就从“一个功能”变成了“一个前提”。
前提的意思是:没有它,后面的故事讲不下去。,
作者声明本文无利益相关,欢迎值友理性交流,和谐讨论~