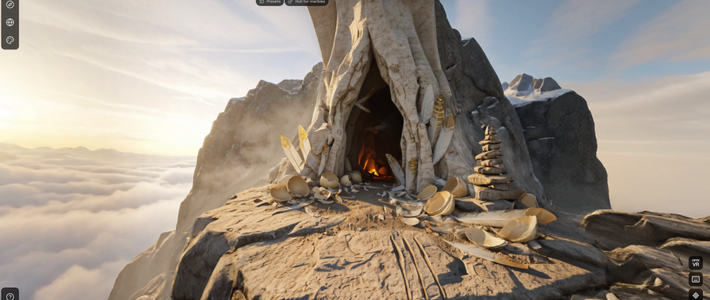
美东时间 10 月 27 日,Google DeepMind 发布 Genie 4。演示里,有人站在湖面平台上吹萨克斯,镜头可以自己游走;敲一行字,天气变了;骑龙飞过山谷时,风声和翅膀拍打声一起出现。
官方称它是“迄今最逼真、交互性最强的世界模型”,目前只向少量受信任的测试者开放研究预览。普通用户还用不上,未来数周才会先向 Google AI Ultra 订阅用户开放。
声音是这次最直观的变化。环境音、音乐和人物对话随画面一起生成,Genie 4 是 Google 首个原生生成实时音频的世界模型。机器之心
另一个变化发生在世界运行中。换天气、移镜头、加角色,都可以直接用自然语言说,不必重新生成整段场景。
Gemini 开始参与模拟。Gemini 3.8 Flash 观察画面、拆步骤,Genie 4 渲染。 实时交互跑的是它,不是 Gemini 4 Argon。Google DeepMind华尔街见闻
但所有这些,都发生在约两分钟里。单次模拟时长从 Genie 3 的约一分钟延长到两分钟。APPSO
两分钟后,世界不一定崩,但会开始“漂移”。官方承认,视觉细节和物体恒存会随时间偏移,复杂物理、实时音频准确性、画面文字和空间精度都还在研究中。Google DeepMind
一位体验者在笔记里写得更直白:虚拟人转个身,可能就把自己的脸忘了。 这不是彩蛋,是边界。小红书
所以,“游戏引擎已死”喊早了。演示里,Genie 4 能在一分钟内生成可探索的城市,能让剧组进去试镜头,也能给开发者一个不写引擎代码的原型。
但原型和产品之间,隔着稳定规则、可重复机制、精确角色控制和可长期维护的内容。
DeepMind 产品经理 Diego Rivas 说,团队还在和合作伙伴研究这项技术如何融入现有工作流程,以及能力边界在哪里。 这话很客气,意思很清楚:它先是一个创作工具,不是替代品。华尔街见闻
官方把这条路线叫“混合世界模型”。Gemini 负责规划,Genie 负责画面、声音和物理反馈。瓶颈已经不是“画面像不像”,而是“世界能不能在低延迟下保持因果”。
120 秒很短。短到只够一个镜头、一次原型、一场机器人练习。但它已经能让人看见方向:世界模型的价值,不是生成一段更漂亮的视频,而是让 AI 在行动之前,先在一个会回应它的世界里试一次。
两分钟之后,它还得学会记住自己造过什么。