DeepSeek能处理《三体》级长文本吗?1000+用户观点大PK
03-10 20:27

精选参考来源
1. DeepSeek变“官方”了

今日头条
2. DeepSeek押注长文本,为什么90%的人都看错了?
今日头条
3. DeepSeek长文本处理是突破还是噱头?1000+用户观点大PK

什么值得买
4. DeepSeek 低调更新画风突变,真正的大招剑指何方?

微信公众号
5. DeepSeek模型上下文窗口扩至百万token,支持整本小说级文本处理
什么值得买
6. 百万token时代来临,你的工作会被AI取代吗?
今日头条
7. DeepSeek模型更新
什么值得买
8. DeepSeek上线1M上下文新模型,支持百万Token长文本处理
什么值得买
9. DeepSeek 1M Token突破
今日头条
10. DeepSeek灰度上线1M上下文新模型,架构革新支持百万元级长文本处理
什么值得买
11. DeepSeek官方回应“模型变冷淡”
什么值得买
12. DeepSeek百万长文本
什么值得买
13. DeepSeek模型更新,支持处理超长上下文本
什么值得买
14. DeepSeek悄悄更新新模型,超长上下文,一手实测 #deepseek #deepseek使用教程 #ai #科技 #大模型
什么值得买
15. DeepSeek偷偷放大招!上下文暴涨8倍,能把《三体》全书塞进去
今日头条
16. 解码DeepSeek百万Token升级
今日头条
17. DeepSeek变冷淡是因要处理百万字长文本吗?
今日头条
18. DeepSeek新模型对AI行业有何积极影响
今日头条
19. DeepSeek V3.2实测

知乎
20. 震惊
知乎
21. DeepSeek 优缺点大揭秘
知乎
22. DeepSeek新模型让AI成本砍半!长文本处理效率暴增的秘密在这
微信公众号
23. DeepSeek再放价格大招!长文本处理成本最高降75%!!

哔哩哔哩
24. 中国AI杀疯了!DeepSeek三大利器掀开源革命,低价长文本碾压同类
今日头条
25. DeepSeek-V3.2-Exp
微信公众号
26. AI怕长文?DeepSeek出奇招
今日头条
27. DeepSeek这波操作,是要给大模型“长上下文”瓶颈来个大扫除?
今日头条
28. DeepSeek V3.2-Exp

小红书
29. AI怕长文?DeepSeek出奇招
今日头条
30. DeepSeek新模型上下文1M token,能帮打工人处理哪些长文本?
今日头条
31. DeepSeek OCR长文本压缩,记图而不是记文字,颠覆LLM大语言模型
今日头条
32. AI模型王炸!DeepSeek发布支持百万token超长文本新模型 最新名单
今日头条
33. Deepseek最新版深度测评
微信公众号
34. DeepSeek 刚刚发布了新模型!
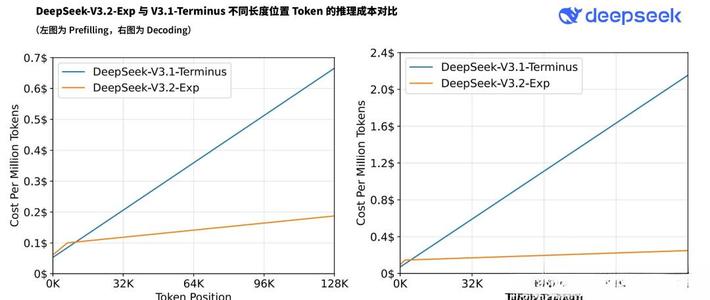
微信公众号
35. 大事件
微信公众号
36. 同一款AI,有人骂傻有人夸神!DeepSeek更新后两极分化,你站哪边
今日头条
37. 100万上下文!DeepSeek V3.2重磅更新,AIME超越GPT-5,V4蓄势待发
哔哩哔哩
38. 1个读完《三体》的长文本怪兽,DeepSeek震撼全球,我们的媒体为何还在生产空洞废话?
微信公众号
39. 来了,DeepSeek悄悄上新模型!
微信公众号
40. 各位朋友,2026年2月11日,DeepSeek静悄悄的升级了!

抖音
41. 实测DeepSeek新模型“翻车”
微信公众号
42. DeepSeek2月11日更新,一个字震撼!
微信公众号
43. DeepSeek更新了!5个问题,深度测评!内附体验方式!
今日头条
44. DeepSeek"记忆外挂"引爆AI革命!长文本处理+2025知识库解锁
今日头条
45. 实测DeepSeek-V3.2-Exp
微信公众号
46. 今日DeepSeek-V3.2-Exp重磅开源
微信公众号
47. DeepSeek 3.2来了!长文本处理要进入“闪电”时代?
微信公众号
48. DeepSeek-OCR
微信公众号
49. DeepSeek OCR重磅发布!视觉压缩技术颠覆传统文本处理
微信公众号
50. DeepSeek-OCR
微信公众号
51. 长文本处理的颠覆者?DeepSeek-OCR
微信公众号
52. DeepSeek开源的不仅仅是个新OCR模型。。。
微信公众号
53. DeepSeek-OCR深度解析
今日头条
54. 文本处理革命来临!DeepSeek再破纪录,革新OCR技术
今日头条
55. 豆包 + DeepSeek 场景选择速查表
抖音
56. 大白话了解 DeepSeek V3.2
知乎
57. DeepSeekV3.2发布!实测惊艳,便宜优势
今日头条
58. DeepSeek 发布实验性大语言模型 DeepSeek-V3.2-Exp,引入稀疏注意力机制,使得 API 成本降低了一半以上
微信公众号
59. 时事热点 | Deepseek-v3.2 发布更新
什么值得买
60. 【每周AI推荐第五期】Deepseek新模型能为我们带来什么?
微信公众号
61. V3.2逼近Gemini 3,DeepSeek硬气喊话:接下来我要堆算力了
微信公众号
62. 前有DeepSeek、后有千问灵光,杭州怎么成了老外眼里的中国硅谷?#灵光 #灵光App
抖音
63. 一篇59年前的论文当然不可能决定或改变一个时代, 但在合适的时间,被合适的人用在了合适的问题上,它就能改变一条路径。#大咖观察#红衣聊AI #deepseek #梁文峰 #人工智能
抖音
64. 从Engram看DeepSeek V4的“反内卷”野心DeepSeek在凌晨突然开源Engram架构模块,这不仅仅是一个技术动作,更像是向行业释放了一枚信号弹:大模型正在从“拼参数”的暴力美学,转向“拼脑回路”的架构创新。如果传闻中的DeepSeek V4确实搭载了这套全新的记忆架构,那么它极有可能再次引爆市场。小马从技术原理、用户感知及行业影响三个维度展开聊聊。🔻1. 核心技术揭秘:Engram是什么此次开源的Engram(记忆印痕)模块,其核心逻辑在于“记忆与计算的解耦”。核心理念: 传统的Transformer模型将所有知识都压缩在参数(权重)里,推理时需要动用大量计算资源去“回忆”。而Engram试图将一部分相对固定的事实性知识(Fixed Knowledge)从高频的计算链路中拆解出来。如果打个比方:• 传统大模型像是一个需要把整座图书馆的书都背下来的天才,每次回答问题都要在脑海里过一遍书,累且慢。• DeepSeek V4 (Engram) 则像是一个懂得查阅索引的研究员。它不需要死记硬背所有细节,而是通过更高效的“外挂记忆”或“压缩索引”来调用知识。技术上的潜在突破:• 降低KV Cache压力: 这种架构可能显著降低长上下文场景下的显存占用。• 无损压缩: 在减少计算量的同时,保证信息检索的精度不下降。🔻2. 对普通用户会有感知吗?虽然“架构”听起来很底层,但如果V4发布,普通用户在实际使用中会有非常直观的感知:• 响应速度(TTFT)起飞: 由于剥离了部分死记硬背的计算负担,推理速度可能会有显著提升,即问即答的流畅感会更强。• “降智”现象减少: 在处理超长文档(如长篇小说分析、百页财报阅读)时,传统模型容易“顾头不顾尾”,新架构可能让模型在长窗口下依然保持清醒的逻辑。• 使用成本更低: DeepSeek向来以“价格屠夫”著称。如果Engram能大幅降低推理成本(Inference Cost),V4 API的价格可能会进一步下探,甚至推动行业进入“白菜价”时代。🔻3. 期待与预测:能否实现弯道超车?目前大模型赛道正处于“边际效应递减”的阶段。单纯靠堆砌参数(从100B到1T)带来的性能提升越来越昂贵,且边际收益在变小。DeepSeek选择了一条更难但更聪明的路——算法效率优化。• 性能预测: V4不仅在代码和逻辑推理上可能继续保持优势,其在多轮对话记忆和复杂知识检索上的表现,有望对标甚至超越GPT-4 Turbo级别的模型。• 市场引爆点: 如果V4能在保持DeepSeek一贯的高性价比(甚至开源)的前提下,解决长文本推理慢、贵的痛点,它将不仅仅是“火”,而是会成为开发者手中的“默认选项”。🔻DeepSeek V4若真如Engram论文所暗示的那样,它将不再只是一个“更好用的模型”,而是代表了大模型进化的新方向——更轻、更快、更聪明。这对于受困于算力成本的开发者和企业来说,绝对是一剂强心针。#DeepSeek新模型能否再次爆火##ai创造营##科技风向标#

新浪微博
65. 梁文锋参与的DeepSeek-R1论文登上 Nature封面,这具有什么意义?
知乎
66. #DeepSeekV4要发布了吗#听说DeepSeek V4马上要来了!这次升级真的有点猛,能一口气处理百万字的长文档,整本《三体》都能轻松吃透。编程能力更是直接对标国际顶尖水平,写代码、调bug效率大幅提升。最厉害的是采用了全新架构,推理成本能降80%以上,普通显卡也能流畅运行。#过个有AI年##HOW I AI#
新浪微博
67. #Deepseek被指变冷淡了#DeepSeek升级后被吐槽“变冷淡”,本质不只是长文本和交互的冲突,而是产品方向和用户期待错位了。很多人用AI不只是算题、写代码,更需要被理解、被记住、像聊天一样舒服。突然统一叫“用户”、回答变生硬,就算能力变强,好感也会掉一大截。 厂商总觉得参数越大、能读的文字越长越厉害,但普通用户感知最强的,从来不是1M上下文有多牛,而是一句贴心话、一个记得住的昵称。技术升级没错,但直接牺牲情感体验,等于把zui loyal 的用户推走。 这场争议也给整个行业提了醒:AI不是越“工具化”越好,也不是越“粘人”越好,关键是平衡。用户要的从来不是二选一,而是既能干活、又好说话。如果只堆技术不照顾感受,再强的模型,也会让人不想用。#秒懂热点就用智搜# deepseek被指变冷淡了
新浪微博
68. 跨越人生20年,60万字日记,我制作了我的数字生命
哔哩哔哩
69. 历史性时刻,当中美决定“分道扬镳” #1602公里续航的小鹏X9超级增程来了
抖音
70. #DeepSeek新模型发布#DeepSeek新模型发布:V3.2-Exp提效降价,开源同步上线。最新发布的DeepSeek-V3.2-Exp模型,是迈向新一代架构的实验性版本,核心升级为引入DeepSeek Sparse Attention稀疏注意力机制,专门优化长文本训练与推理效率。该模型已实现多平台同步更新,包括官方App、网页端、小程序,且API调用成本降低50%以上,新价格(单位:元/百方tokens)具体如下⬇️输入:缓存命中0.2元,缓存未命中2元输出:缓存命中0.5元,缓存未命中4元(价格自2025年9月29日18:00起生效)此外,DeepSeek-V3.2-Exp已在Huggingface与魔搭平台开源,且在各领域公开评测集上,其表现与上一代V3.1-Terminus基本持平
新浪微博
71. DeepSeek新模型爆火,硅谷玩疯了 #DeepSeek团队开源新模型 DeepSeek新模型爆火,硅谷玩疯了!把文字变成图像,让AI一目十行读完一本书!这次,它真的在教AI们,怎么省算力、怎么学会“遗忘” #AI #DeepSeek
抖音
72. 这帮90后中国工程师太牛了!460万美元干翻了1.4万亿 中国AI有自己的登顶策略!只用了1%的资源逆袭美国,又一个DeepSeek时刻的背后到底是什么?#AI #kimi #OpenAI
抖音
73. #Google 发布 Gemini3.1Pro#昨天夜里,科技圈被谷歌放了个大招炸醒了。距离上一代发布才过去区区三个月,谷歌闪电推出了 Gemini 3.1 Pro。这次完全没挤牙膏,直接端上来一顿大餐。核心一句话总结:脑子变聪明了一倍,但饭量(价格)一点没涨,重新卷回了行业第一。🔻1. Gemini 3.1 Pro 有多强?到底进化了啥?用最接地气的话来说,这次升级主打一个“降维打击”:• 理科和逻辑脑直接更牛: 以前的模型做复杂的数学题、写长串的代码,或者理清弯弯绕绕的业务逻辑时,还要多“想”一会儿。现在的 3.1 Pro 就像打通了任督二脉,深度思考能力增加,在各类难度极高的综合考试榜单上,直接把第一名的王座又抢了回来。• 加量却不加价: 这才是最狠的。性能翻倍了,但调用价格和上一代一模一样。这就好比你花买一辆经济型代步车的钱,直接提走了一辆顶配超跑。• 多模态(眼耳口)更丝滑: 它的眼睛和耳朵更灵敏了。不管你是给它发图片、让它看视频,还是用类似 Gemini Live 这样的功能和它进行实时的语音对话,它的反应速度和像真人的程度都上了一个新台阶。🔻2. 这次“闪电突袭”对行业有哪些影响?• 卷生卷死,逼疯同行: 三个月就搞出一次大版本迭代,这个速度完全打破了行业原本“大半年一更新”的默契。谷歌这是在用实力告诉对手:跟不上我的节奏,就只能被淘汰。• 价格战进入白热化: “加量不加价”是最致命的商业杀招。企业和开发者都不是傻子,大家会迅速倒向性价比最高的模型。这无疑把巨大的降价压力给到了 OpenAI 和 Anthropic 等竞争对手,AI 算力正在加速变成“白菜价”的公共水电煤。• 倒逼“超级应用”诞生: 当最顶级的 AI 脑子又聪明、又便宜、反应还快的时候,创业者就再也不能拿“模型不够聪明”当借口了。2026 年,比拼的不再只是谁家的大模型跑分高,而是谁能把这些能力真正变成老百姓手机里好用的 App。🔻3. 目前海外大模型的阶梯排名是怎样的?谁是第一梯队?到了 2026 年初,海外大模型的牌桌上,已经形成了非常清晰的阶级壁垒:🔻• 第一梯队(神仙打架的“三巨头”):• Google Gemini 3.1 Pro / Ultra: 刚刚登顶的综合性能卷王,图文音视频全能王。• OpenAI GPT-5.2 (及 o 系列推理模型): 老牌霸主,深度的逻辑推理依然是天花板级别,目前正在和谷歌贴身肉搏。• Anthropic Claude 4.5 Opus: “偏科”的超级学霸,长文本处理和代码编写能力极强,是无数程序员和文字工作者的心头好。🔻• 第二梯队(虎视眈眈的实力派):• Meta Llama 4 系列: 开源界的“定海神针”,主打免费和可私有化部署,生态极度繁荣。• xAI Grok 4.1: 背靠马斯克的 X 平台,主打超长上下文和实时社交网络热点数据抓取。• DeepSeek-V3.x 等破局者: 以极致的算法效率和超高性价比闻名,是榜单上不容忽视的强劲黑马。
新浪微博
74. #科技先锋官# 英伟达拟以30亿美元收购以色列AI初创公司AI21 Labs成为AI领域年终焦点。这场收购并非简单的资本运作,而是从技术、行业、市场层面重塑大模型与生成式AI生态的关键布局。此次收购实现核心能力互补。AI21 Labs的王牌产品Jamba大模型采用Transformer与Mamba混合架构,长文本处理速度比同类模型快2.5倍,且内存占用更低,完美填补了英伟达在高效长上下文模型领域的短板。企业级平台Maestro的AI代理开发与结果验证能力,还能与英伟达现有AI软件套件深度融合,强化端到端技术服务能力。这标志着AI产业进入软硬协同整合新阶段。此前英伟达以GPU硬件主导AI算力市场,而AI21 Labs在企业级生成式AI应用场景的积累,将帮助英伟达打通“硬件-软件-应用”全产业链,推动生成式AI从技术研发加速落地到金融分析、文档处理等实际场景,引领行业从分散竞争走向生态化协同。收购将加剧全球AI生态竞争。当前Meta、AWS等巨头均在加码大模型布局,英伟达通过整合AI21 Labs的技术与客户资源,进一步巩固在生成式AI基础设施领域的领导地位,也对英特尔、AMD等竞争对手形成压力。这场收购不仅是企业间的实力整合,更是全球AI产业竞争格局重构的重要信号。#一条vlog回顾2025##AI创造营##AI创作热点# 种斌Marco的微博视频
新浪微博
75. DeepSeek-V3.2-Exp版本更新,有哪些信息值得关注?
知乎
76. 梁文锋参与的DeepSeek-R1论文登上 Nature封面,这具有什么意义?
知乎
77. #DeepSeek新架构意味着什么#DeepSeek代号Model1的全新架构曝光,标志着其从参数堆砌向架构优化的关键转型,为大模型发展撕开全新赛道。此次架构级调整并非简单版本迭代,而是融合mHC训练框架、Engram条件记忆模块的全方位重构,直指大模型训练不稳定、记忆计算混同、长上下文处理难的行业痛点。mHC架构为训练加设“智能调节阀”,大幅提升规模化训练稳定性,Engram模块通过查算分离解耦记忆与推理,再搭配稀疏稠密并行计算、FP8混合精度设计,让Model1兼具百万级tokens超长上下文处理能力与高效推理性能,还实现了对英伟达下一代GPU的深度适配。这不仅让DeepSeek V4在编程领域的工程化能力实现突破,更降低了大模型研发的算力与门槛,推动大模型从实验室走向工业化落地。其探索的架构创新路径,也为行业摆脱算力内卷提供了新范式,引领大模型向更高效、更实用的方向演进。deepseek新架构意味着什么 川北小哥的微博视频
新浪微博
78. #DeepSeek新模型会改变未来吗#我上手试了试这个3B参数的VLM(视觉语言模型),它不光是OCR工具,更是上下文压缩的黑科技。 用Hugging Face的transformers库,几行代码就能跑起来(支持Tiny/Small/Base/Large四种分辨率模式,从512x512到1280x1280像素)。我测试了份乱七八糟的PDF报告:手写笔记+表格+图表,输入一张图,它用DeepEncoder(基于SAM局部感知+CLIP全局聚合)压缩成仅64-100个视觉token,然后MoE解码器(活跃参数仅570M)吐出结构化Markdown。准确率高达97%(Fox基准),远超PaddleOCR,尤其在数学公式和多语言上(训练了100种语言的3000万PDF页)。 视觉输入高效,传统文本输入靠tokenizer切成1000+ token,容易丢布局(颜色、粗体、图表全废)。但这里像信息压缩饼干:一张图浓缩千言,token减10x,内存和延迟直降。Andrej Karpathy也说:“也许LLM输入永远该是像素,不是文本。” 我试了对比:纯文本模式下,处理长文档上下文窗口爆表;视觉模式下,轻松handle 20x压缩(准确率85%+)。不过缺点是高分辨率下GPU饿(A100单卡日产20万页数据还行,但本地跑需优化)。总的,视觉更保真,像给AI戴了副高清眼镜——高效,但得适应看图识字的新范式。 这模型不只变OCR,更在重塑AI感官,从读到看。未来?眼睛主导世界,token时代退场。你们怎么看?DeepSeek会是下一个LLaMA吗?[并不简单]#ai生活指南##ai创造营#
新浪微博
79. 「Github一周热点91期」deepseek OCR、量化交易工具、Notebook开源替代、Linux换源工具、Windows优化项目和API 客户端
哔哩哔哩
80. Gemini 3实现智能水平断层碾压。Artificial Analysis智能指数73分(行业平均42分),在Humanity's Last Exam等基准测试中刷新纪录。核心突破在于生成式UI,可创建交互式界面和微型应用,从"回答问题"跃升至"生成体验"。原生多模态能力无缝处理文本、图像、视频、音频,并集成Nano Banana图像模型;支持100万token超长上下文。智能体能力实现自主规划与多工具协同,代码生成在SWE-bench达76.2%,搭配Antigravity平台构建自动化编码代理。响应速度达128 tokens/秒,但输出成本较高。Gemini 3无疑是当前最强大脑,适合需要顶尖推理和企业保障的场景;Grok 4.1以2M上下文和超低成本称王,适合海量文本处理;ChatGPT 5.1仍是均衡的通用选择,生态最成熟;国内Kimi K2在开源和Agentic方向独具特色,适合定制化部署#Gemini3凭什么被称为最强AI#
新浪微博
81. R1一周年,DeepSeek Model 1悄然现身
微信公众号
82. 梁文锋参与的DeepSeek-R1论文登上 Nature封面,这具有什么意义?
知乎
83. 老外傻眼!明用英文提问,DeepSeek依然坚持中文思考
微信公众号
84. #DeepSeek新模型曝光#DeepSeek V4呼之欲出,大模型竞争迈入架构创新新阶段!DeepSeek新一代旗舰模型V4的技术线索接连曝光,标志着国内大模型竞争已从参数竞赛转向架构创新的深水区。GitHub代码中的“MODEL1”标识符,印证着这款即将在春节发布的新模型,并非简单版本迭代,而是一次底层架构的重构。从KV缓存布局调整到FP8解码支持,再到稀疏性处理优化,新模型在内存与计算效率上的针对性设计,切中了大模型落地的核心痛点。而Engram记忆模块与mHC训练方法的潜在整合,更让模型实现了记忆与推理的协同升级,为长文本处理、高效代码生成提供了技术支撑。此次DeepSeek的技术突破,打破了大模型“唯参数论”的发展路径,让架构优化、软硬协同成为新的竞争焦点。这不仅是其自身技术的迭代,更将推动国内大模型产业向更高效、更实用的方向迈进,为AI规模化落地注入新动力。#用智搜高效玩转AI##HOW I AI# deepseek新模型曝光 川北小哥的微博视频
新浪微博
85. DeepSeek 新论文或「泄密」V4 杀手锏:一招突破瓶颈,居然把 CPU 当 GPU 用?
微信公众号
86. DeepSeek连发两篇论文背后,原来藏着一场学术接力
微信公众号
87. 如何评价消息称 DeepSeek V4 打破常规优先适配华为,冷落英伟达 AMD?会带来什么影响?
知乎
88. #为什么有的人出图像呼吸一样简单#看到天玑9500这一次通过升级NPU算力,实现4K高画质文生图端侧直出,我真觉得方向对了!无论是AI长文本处理还是AI文生图创作,相比云端处理,端侧AI必然是更方便,隐私更安全。哪一台手机能够让我们最先用上,好难猜啊
新浪微博
89. 如何看待DeepSeek发布的新模型DeepSeek-Math-V2?
知乎
90. #DeepSeek新模型有多猛# DeepSeek V3.1发布,6850亿参数量仅激活370亿,计算成本降90%。性能超GPT-4o,中文问答准度89.3%。岚图汽车、江苏银行已应用,未来将突破多模态,推理成本再降50%。#微博声浪计划##听见微博# 凯文思考的微博音频
新浪微博
91. #DeepSeekV4要发布了吗#DeepSeek V4 最新爆出的消息来看,主要的变化就是上下文窗口扩至100 万 token,编程基准 SWE-Bench 达83.7%,原生多模态、创新架构降低显存占用,延续高性价比,API 定价仅为海外竞品的 15%-30%,预计 2 月底至 3 月初正式发布。现在市场比较关注DeepSeek V4 编程与长文本处理能力是否真的跻身全球第一梯队?是否真的能够实现以算法创新打破算力内卷,普惠企业与开发者?DeepSeek作为一款专业大模型覆盖能力是否能够解决开发工具与行业解决方案的生态体系问题。DeepSeek V4会成为2026年的第一炸吗?
新浪微博
92. #DeepSeek新模型为何被夸爆# DeepSeek新模型炸圈了!刚推出的OCR模型直接火到海外,GitHub狂揽3.7K星,HuggingFace热榜冲到第二,连硅谷同行都忍不住点赞:“这思路太惊艳了!”传统AI读长文档有多头疼?烧钱又慢吞吞,算力消耗像无底洞。但DeepSeek这次直接打破常规——把文字转成图像,让AI像人类一样“看图识字”。处理长内容时算力大幅下降,效率却直线上升。这波操作被疯狂夸爆,不只是技术碾压,更是思维层面的降维打击。用图像思路解决文本难题,堪称今年AI圈最亮眼的创新之一。不得不说,当别人都在优化算法时,DeepSeek直接重新定义了赛道!
新浪微博
93. 盘点一周AI大事(1月11日)|最强人形机器人 OpenAI公布2026研发路线图 DeepSeek被爆2月发布DeepSeek V4 Google推出Veo3驱动的数字人Vids 字节开源换脸视频模型DreamID-V 阿里开源数字人框架HRM2Avatar Lightricks开源顶级视频模型LTX-2 ElevenLabs推出最强语音转录模型Scribe v2 斯坦福开源睡眠分析模型SleepFM 港大发布开源版NotebookLM DeepTutor Razer推出全息AI老婆Project AVA 波士顿动力推出下一代Atlas #抖音知识年终大赏 #前沿科技趋势发布月 #AI新星计划 #AI #机器人
抖音
94. #DeepSeek新模型发布#DeepSeek-V3.2-Exp虽为实验版本,却亮出关键技术突破——DeepSeek Sparse Attention(稀疏注意力机制)。其核心价值在于针对性优化长文本处理:传统注意力机制计算复杂度随文本长度呈平方级增长,而稀疏设计通过动态筛选关键信息关联,大幅降低运算量,实现训练与推理效率双提升。尽管评测表现与V3.1持平,却在长文本场景释放了潜力。应用层面,该模型天然适配法律文书分析、学术论文精读、多轮对话历史理解等长文本需求场景。API降价50%与开源举措,更降低开发者试错成本,加速长文本AI落地。作为新一代架构过渡,它不仅验证了稀疏注意力的可行性,更以“效率不降、成本腰斩”的姿态,为行业探索大模型轻量化提供了可复制的中间路径。#秒懂热点就用智搜# 分析:【#DeepSeek新模型发布#】 DeepSeek发布Deep
新浪微博
95. 一次快速响应的开源协作,让 DeepSeek-V3.2-Exp 性能满血回归
知乎
96. DeepSeek 3.2部署有bug??还好修复了!
小红书
97. 10倍压缩近乎无损?DeepSeek-OCR用“看图”颠覆AI长文本处理的五个惊人真相
知乎
98. 当文本太长处理不了?DeepSeek给出了答案!
微信公众号
99. 光学压缩:DeepSeek-OCR 的长上下文处理新探索
微信公众号
100. DeepSeek更新上下文达百万级token:可一次性处理超长文本
什么值得买
101. 甩出新王炸,DeepSeek长文本模型春节再掀波澜
微信公众号
102. DeepSeek稀疏注意力机制解析
小红书
103. DeepSeekV3.2正式发布,实测20秒输出一篇文献综述
微信公众号
104. DeepSeek开源新模型DeepSeek-OCR,提升长文本处理
今日头条
105. DeepSeek春节再扔王炸?联手北大破解百万级长文本,AI圈炸了
什么值得买
106. 写给所有人的 DeepSeek V3.2:一文带你读懂 DSA
微信公众号
107. DeepSeek新模型来了!官网模型更新为最新版,实测显示非此前的DeepSeek V3.2,最高支持100万tokens输入,以及知识截止日期为2025年5月
什么值得买
108. DeepSeek-V3.2-Exp发布:AI普惠的工程路径
知乎
109. 终于不用再跟长文本 “死磕”!DeepSeek 新模型把 AI 变成 “长文本管家”,普通人也能轻松搞定 10 万字
知乎
110. 外媒:DeepSeek出乎意料新突破能否打破大模型“长上下文”瓶颈?
今日头条
111. DeepSeek-V3.2解读:稀疏注意力技术大幅提升长文本处理效率
微信公众号
112. AI怕长文?DeepSeek出奇招:把文档变图片,速度翻倍
今日头条
113. DeepSeek运行成本是真降还是噱头?2000+用户观点大PK
什么值得买
114. DeepSeek上新!处理长文本更高性价比,国产技术协同加强
今日头条
115. DeepSeek开源新模型,提出长文本处理新思路
今日头条
116. DeepSeek 可一次性处理《三体》三部曲
哔哩哔哩
117. DeepSeek 节前突袭发布 V3.2-Exp:长文本推理成本直降75%!
知乎
118. 全新DeepSeek发布!上下文扩展至1M
微信公众号
119. DeepSeek开源新成果!把长文档压缩成图片,降低大模型处理成本
今日头条
120. DeepSeek模型更新!上下文提升至百万Token 可处理三体小说全集
什么值得买
121. DeepSeek-V3.2实战指南:长文本处理+工具调用全解析,一步API进阶接
哔哩哔哩
122. DeepSeek-OCR发布,仅3B文档解析小模型
小红书
123. DeepSeek V3.2是效率神器还是徒有其表?全网用户观点大PK
什么值得买
124. 我欠梁文锋一个道歉 长文本记忆,这个AI的终极瓶颈硅谷在追,但DeepSeek先发论文了,这波,真的有点东西… 本周DeepSeek V4将正式发布,这次是时隔一年多的重大更新,帮你先划个重点: · 原生多模态:真正能同时理解图片、视频和文本的全能选手,不再是纯文本模型。 · 超长上下文:窗口预计高达 100万tokens,可以一口气处理《三体》三部曲这种体量的超长文本。 这让我看到了中国AI领先的可能性。一个“记忆模块”,正在改写游戏规则。🚀 #deepseek #大模型 #人工智能 #科技 #openai
抖音
125. 重磅|DeepSeek-V3.2-Exp来了!🚀
小红书
126. DeepSeek-V3.2-Exp:用稀疏注意力机制,开启长文本处理的“加速引擎”
微信公众号
127. 刚刚,DeepSeek 官方发布公告:DeepSeek 正在测试新模型
微信公众号
128. DeepSeek 3.2性能全面回归的技术揭秘!
小红书
129. DeepSeek V3.2 发布:长文本能力新突破,API 价格砍半
今日头条
130. DeepSeek V3.2 双模型发布:线性复杂度长文本 + 无惩罚深度思考,开源阵营再冲第一梯队
微信公众号
131. DeepSeek-V3.2-Exp 正式发布:稀疏注意力机制实现长文本处理突破,API 价格大幅下调 50% 以上!
微信公众号
132. 外媒曝,DeepSeek意外新突破,能否击破大模型长上下文瓶颈
今日头条
133. DeepSeek V3.2 双模型:线性复杂度,无惩罚深度思考,开源界的新里程碑!
知乎
134. 颠覆传统:DeepSeek用“视觉压缩”重塑AI文本处理范式!
今日头条
135. DeepSeek重磅发布:长文档处理效率数量级提升,领先业界表现
今日头条
136. DeepSeek-OCR重新定义文字识别,用“视觉压缩”破解长文本难题
今日头条







已收藏
去我的收藏夹
张大妈
校验提示文案
张大妈
校验提示文案