







24
34
做一年检索评测花了 9.4 万,省回 31 万
2026-11-17 11:20:24
0点赞
0收藏
0评论
这是我今年做过最不像「技术项目」的一个项目:它没有上线新功能,没有新增一个用户能看见的页面,账单上却实打实花掉了 9.4 万。
做的事情说简单也简单:建一份检索评测的黄金集,先量出 recall@5——也就是五个问题里,正确的那一段有几条被检索到。它没有上线任何东西,只是把「答得好不好」变成了一个能算的数。
但它是这一年里投入产出最清楚的一笔。
一、先说结论
一次性投入 232 人时,按 280 元一人时算 64,960 元。年维护 104 人时,29,120 元。合计 94,080 元。
换回来:答对率从 71.4% 到 86.2%,一年少错 64,824 条,其中 24% 会转人工,一单 20 元,省 311,160 元。
首年净 217,080 元,投入产出 3.3 倍,按净额算 2.8 个月回本。
下面逐笔拆。
二、这 9.4 万花在哪
第一笔,黄金集建设,134 人时 = 37,520 元。
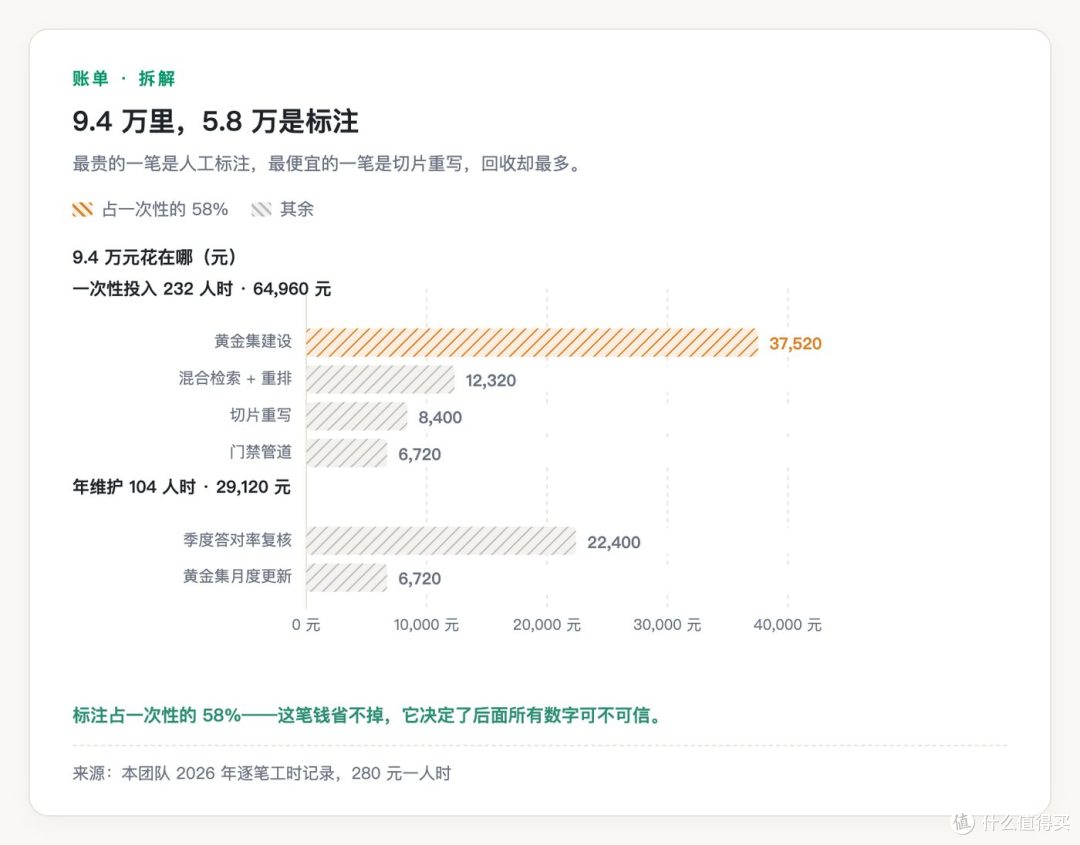 图 1 9.4 万花在哪:标注占一次性的 58%
这是最贵的一笔,占了一次性投入的 58%。为什么贵:1,500 条问题,每条要标到「哪一段」,双人独立标注,分歧还要第三人裁决。
具体拆开是:抽题和整理 22 人时,第一轮标注 48 人时,第二轮标注 40 人时,分歧裁决与复核 24 人时。
有一点容易被低估:题整理占的 22 人时。历史工单里的问题大多是残缺的、带上下文的、一句话说一半的。要不要补全、补到什么程度,这里每一个决定都会影响后面的标注一致性。
第二笔,混合检索加重排,44 人时 = 12,320 元。
向量检索 + 字面检索两路跑,结果融合,再过一遍重排模型。工程上不难,难的是调参和回归——每次改融合权重都得跑一遍全量,所以这笔里有一部分其实是等结果的时间。
第三笔,切片重写,30 人时 = 8,400 元。
这一笔最便宜、回收最多。原来按固定 500 字切,改成按段落边界切。30 人时里,改逻辑 8 人时,剩下 22 人时是在看「这样切会不会把表格切断」「标题链怎么跟」。
第四笔,门禁管道,24 人时 = 6,720 元。
把评测接进发布流程:合并前自动跑 1,467 条,8 分 40 秒,11 块钱,结果写进 PR 评论。这笔是纯工程,没有算法。
三、年维护 104 人时
黄金集月度更新,24 人时 = 6,720 元。 每月从新工单里补 20 条,两个人各标一遍,2 人时一个月。
季度答对率复核,80 人时 = 22,400 元。 每季度抽 300 条人工看,20 人时一次,四次 80 人时。
这一笔很多人会省,我不建议省。因为端到端答对率和召回率不是一回事——recall 高但答对率掉了,说明是生成环节在退化,只看召回率发现不了。
四、钱省在哪
省的不是「模型调用费」,是人工。
答对率从 71.4% 到 86.2%,涨 14.8 个点。一年 438,000 次提问,少错 64,824 条。
这 64,824 条里,约 24% 会被客户追问、最后转人工,也就是 15,558 次。一单人工处理按 20 元算(含人工时间与工单系统摊销),311,160 元。
另外还有一块不在账上但很实在的:客户续费。这个我们没法归因到具体某个改动,所以不算进上面的数。今年流失率从 11% 降到 6%,我没法说全是评测的功劳,但它肯定是一个原因。
五、反直觉的一笔
改造前我们每年在「模型调用」上花约 20 万。做完评测之后,这笔钱没降反升了 3%。
原因是我们发现 top_k 从 5 调到 8 对答对率没有提升,但很多人以为有。改回去之后 token 降了 40%。同时因为检索质量提升,平均上下文长度反而变短——以前要把 8 片都塞进去碰运气,现在 5 片就够了。
两个方向一抵消,年调用费从 20 万到 20.6 万,微涨。有人会问那这不是白干了?不是——人工省了 31 万。
这个例子说明一件很具体的事:在 RAG 里,最贵的从来不是 token。
六、和别的投入比
我们这一年还试过两件事。
一是换模型,换了两次,前后花了大约 15 人时加半年观察。答对率变化在正负 1 个点以内。
二是重写提示词,做了一版结构化提示,花 22 人时,答对率涨了 2.1 个点。
这两件事的内容都是改调用的写法,但不管用哪家的大模型 API,结论都一样——换了两次模型,1 个点以内。
评测体系 232 人时,涨 14.8 个点。单位人时的收益是提示词优化的 6 倍左右,是换模型的十几倍。
这不是说换模型和改提示词没用——它俩是必要的基础。但它俩的前提是「你知道现在坏在哪」,而这个前提只有评测能给。
七、如果你是决策者,怎么判断该不该投
三个问题,能答上两个就值得投。
第一,你们现在能不能说出「上月答对率是多少」?如果答案是「大概七八成」,那这笔钱该花。
第二,客户答错的时候,你们能不能在三十分钟内说清是「没找到」还是「找到了答错」?如果说不清,那这笔钱该花。
第三,你们过去半年做的优化,有没有一次能拿出前后对比数据的?如果一次都没有,那这笔钱该花。
反过来,如果你们已经有稳定的评测集和固定指标,那这笔钱不该花在重建上,该花在扩样本和加门禁上。
八、一年之后的变化
现在最直接的差别是开会。
以前讨论「要不要换个 embedding 模型」,靠的是感觉和别人的案例,一个人说好一个人说不好,最后拍脑袋。现在跑一遍,1,467 条,八分四十秒,11 块钱,谁对谁错十一点前就知道。
这 11 块钱是我今年花得最值的钱。
参考:评测里那批判定调用我们走的是统一地址,词元云,换别家也一样。https://tokenfreeai.com