微博评论区前阵子看到一幕:有人赌气放话"不玩了,刚把16G显卡卖了4400"。另一头,折腾本地推理的人正翻箱倒柜找旧卡——让他们意见分叉的,是最近爆火的开源推理引擎 Strata,它把"老显卡跑百亿参数大模型"从段子变成了实测截图。微博
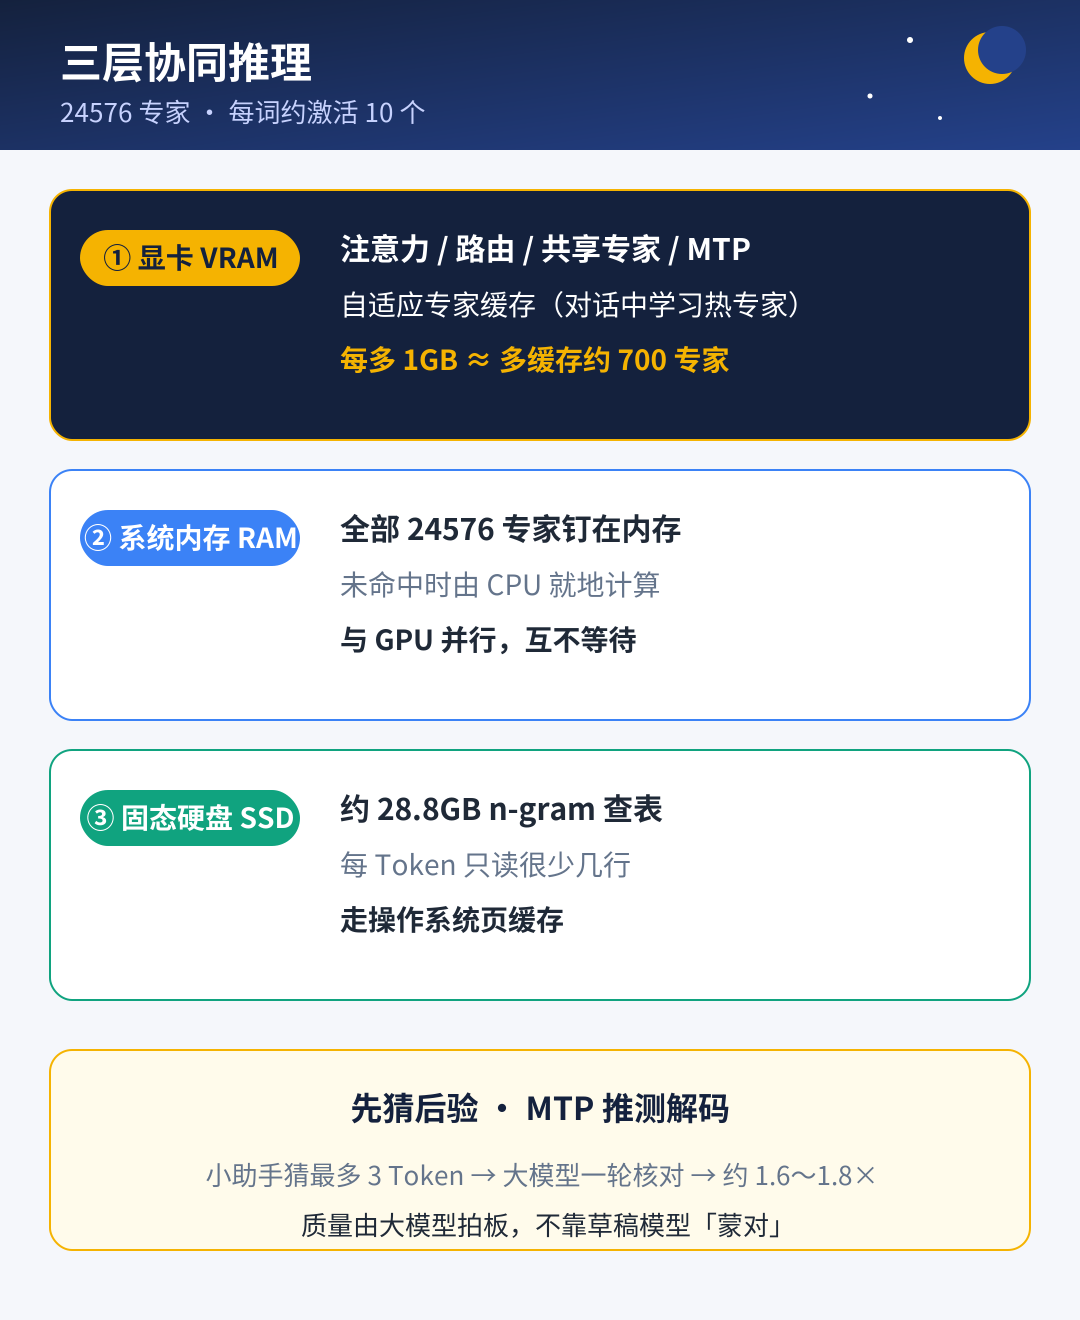
Strata是什么:MoE大模型像一间上千人的仓库,每一步其实只调动十几个"专家"。Strata把模型权重按热度拆到显存、内存、SSD三层——常用的摊在台面上,冷门的存在储藏室,再配上投机解码,于是12GB显存的游戏卡也能跑起千亿参数级的Qwen3.8-Flash-Next。知乎微博
9月底科技博主tombkeeper实测安利。到11月初打开仓库时,Niko1221/Strata已经有约4.0万star。桌面版随后上线,过去要靠命令行和配置环境完成的操作,现在有了更直观的可视化入口。编程客户端也能直连:Claude Code、Codex同一个端口都能直接接,不需要任何中间转换层。知乎知乎知乎
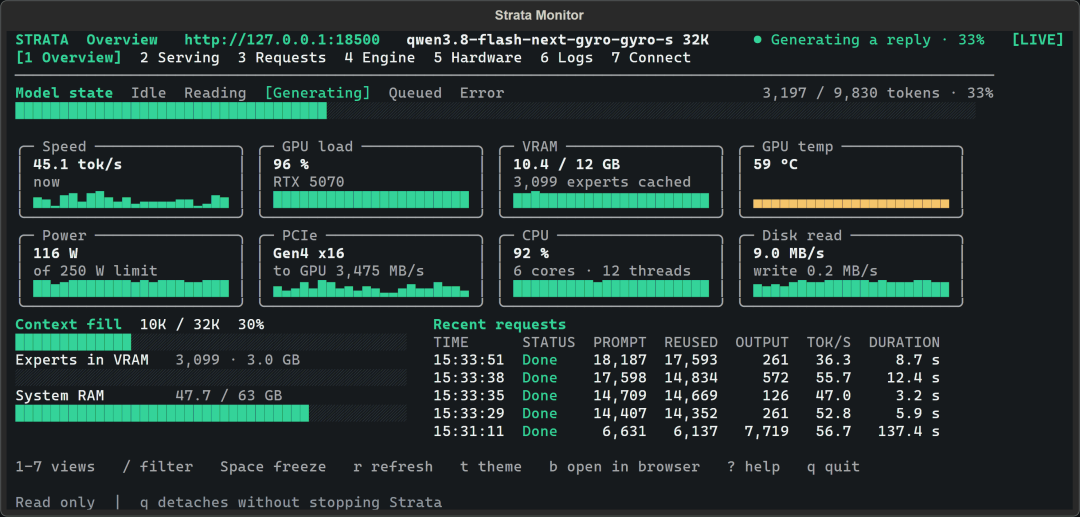
速度是真是假(均为社区实测,跟整机配置强相关):
同是一张RTX 3090、同一个IQ3_S量化模型,llama.cpp约20 tok/s,Strata短问答能到67 tok/s。微博
5060 Ti 16G + 64GB内存,IQ3_XXS量化输出45–50 tok/s。知乎
洋垃圾X99平台 + 3060 12G + 128GB DDR3,整套两千出头,预填充最高700、输出平均55–65 tok/s。知乎
AMD R9700跑35B MoE,Strata 0.1.45把解码速度推到117.8 tok/s。知乎
再算一笔钱:有玩家用4张二手P100攒了台整机,5000元上下跑起Qwen3.8、128k上下文、40t/s。也有人按小时算过账,125B的模型本地跑"每小时不到2块钱就能随便用"。但别忘了tombkeeper年初的另一句清醒:对大部分人来说,本地运行大模型从经济上讲都是不划算的,自己跑模型的真正意义,一是用不受限的模型,二是数据完全在本地,“简单地说,自由”。小红书那条"本地部署大模型的第一需求是安全,不是省钱"能拿435个赞,就是这个道理。小红书知乎微博小红书
三个坑,没想好先别装:
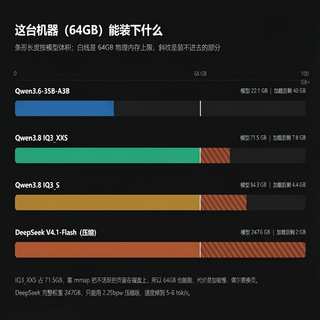
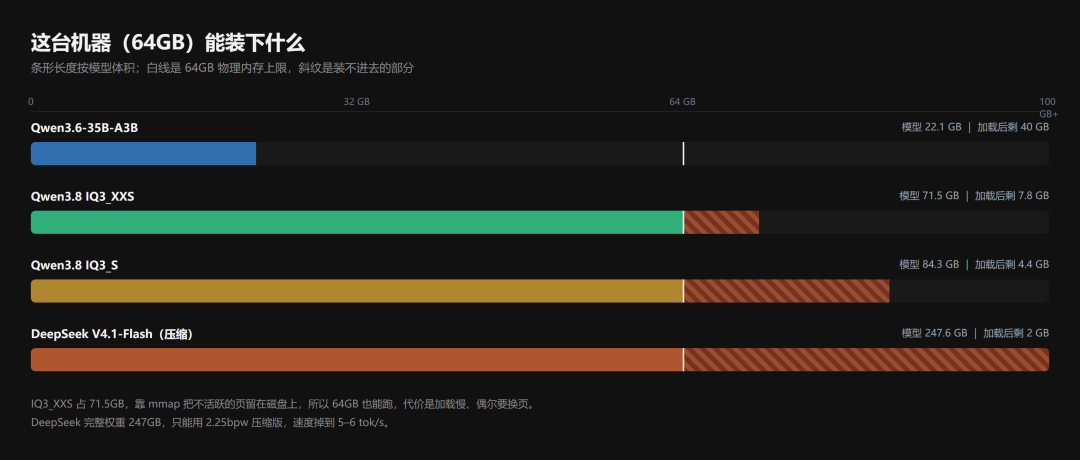
卡脖子的不是显卡,是内存。64GB机器加载84.3GB的模型文件后只剩4.4GB余量,浏览器多开几个标签页就开始换页,速度从40 tok/s掉到个位数。经验公式很直白:64GB内存、128K上下文、想留6GB给系统,能跑的模型大概在80GB以内。知乎
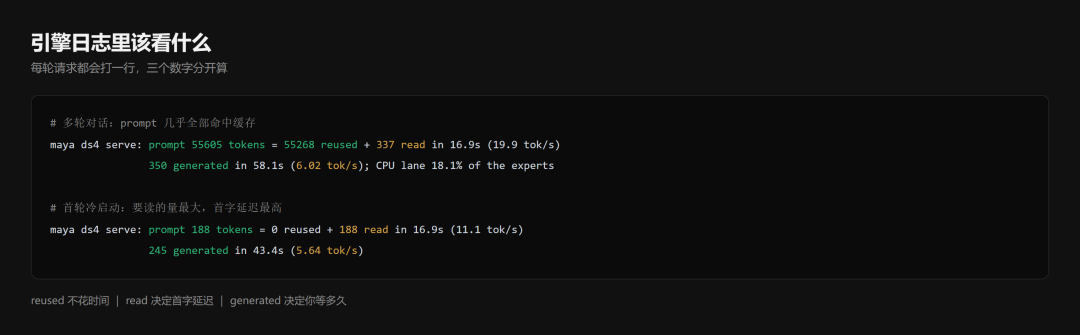
prefill慢,长输出更慢。喂长文档给编程Agent时,最真实的抱怨是"用claude code还是感觉读取prompt太慢了,生成速度是够用"。更狠的是输出长度:实测写一段1794 token的回答,花了317秒。"一次要做对"的复杂活,还是交给云端。知乎知乎
SSD寿命悬而未决。有热文断言:32G及以下内存低配硬跑,“高强度运行仅3-6个月,就会批量出现硬盘坏块、读写报错、掉盘蓝屏”。这个说法目前还没见大规模复测,但定期看一眼硬盘健康度总没错。知乎
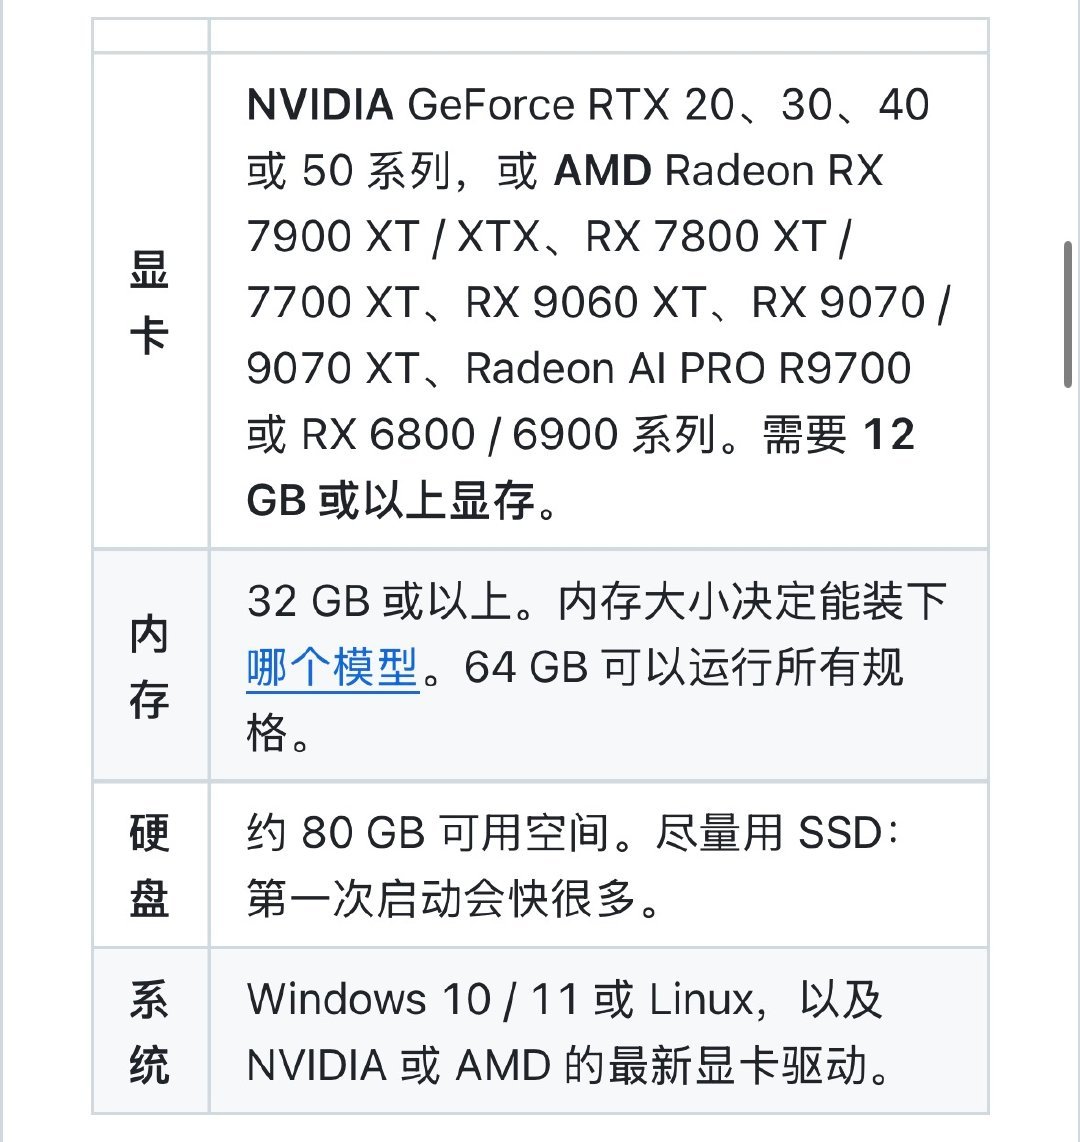
到底谁适合装:闲置机器、12G以上显存、64G以上内存、想要一个数据全私有的代码助手——先跑一句 `strata launch --plan`,看引擎判断自己的机器到底适不适合,再决定下不下载模型。只想躺平聊天、机器只有32GB内存的,别凑热闹:"模型文件≠运行内存"这六个字,是评论区用真金白银换来的教训。知乎