

11月10日晚,阿里巴巴公告分拆平头哥上市,港交所确认可以推进,而申请早在9月11日就已向港交所保密递交。这场分拆把聚光重新打回产品本身:真武系列AI芯片累计交付已超56万片,外部客户超过650家。用户最想知道的其实是两件事:这颗芯片现在到底能训多大的模型,离大规模用还差什么。先给结论:推理端已经跨过万亿门槛,训练端的"万亿级训练"承诺押在明年一季度量产的真武V900上;而规模商用本身,已经开始。知乎知乎知乎
三代芯片的"训练尺度"阶梯:在售款管千卡训练,万亿级等量产
先看在售的810E。这颗芯片今年1月29日上线官网,96G显存、700GB/s片间互联带宽,整体规格与英伟达H20相当、部分参数超过A800。它已在阿里云实现多个万卡集群部署,可应用于AI训练、AI推理和自动驾驶,服务了国家电网、中科院、小鹏汽车等400多家客户。以这个算力档位推断,百亿到千亿参数模型的商用训练是当前能确认的范围;万亿级训练,官方从未在810E上承诺过。今日头条
5月发布的真武M890把能力抬了一档。7月18日世界人工智能大会上,阿里云发布灵骏真武M890超节点实例,以超节点形态提供高速互联、开箱即用的64卡算力单元,这是阿里云首次通过公共云对外提供超节点形态的AI算力服务。钛媒体
官方的说法是,在智能驾驶、具身智能等训练场景中,M890相比上一代810E训练性能提升三倍。8月财报沟通中,吴泳铭进一步表示,基于M890的超节点实例已在阿里云规模化销售,能高效运行超2万亿参数的大模型推理,Kimi K3和Qwen3.8 Max都通过这套实例对外提供服务。注意口径:这里兑现的是超2万亿参数模型的推理,不是万亿级预训练。钛媒体知乎
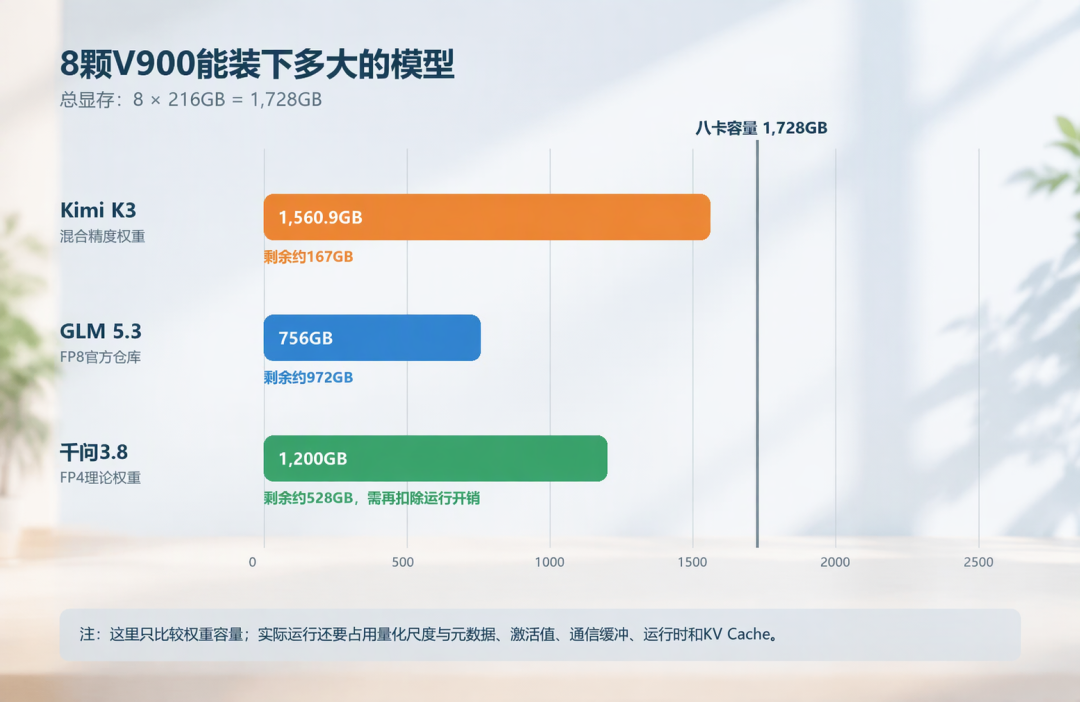
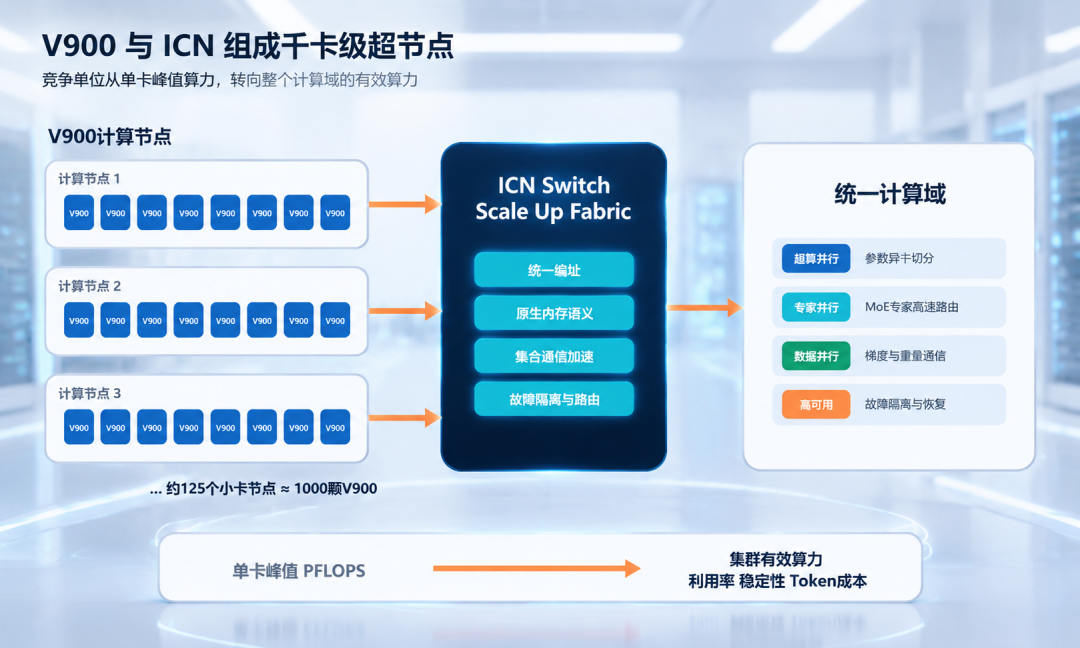
真正的训练门票是9月22日云栖大会发布的真武V900:算力为M890的3倍、支持216GB显存和1200GB/s片间互联、采用FP8/FP4精度,官方明确称其可满足万亿级参数大模型的训练和推理需求。它可以借助自研ICN Switch互联构建50万卡的单一集群,被吴泳铭称为"目前中国算力性能最强"的AI芯片。今日头条知乎
也就是说,"能训万亿"目前还是一项宣布的能力:V900确认明年一季度量产售卖,比原计划提前了约半年。知乎
10万亿的野心,与尚未官宣的下一代Qwen
国内厂商此前已尝试用国产算力训练万亿参数模型,而前沿模型的门槛已抬高到3万亿左右;阿里则第一个公开喊出要训练自己的10万亿参数模型。知乎
按照披露的节奏,阿里正在训练Qwen4,后续版本指向5万亿乃至10万亿参数规模。但下一代Qwen的预训练是否会落在平头哥芯片上,阿里没有官宣。谷歌TPU支撑Gemini训练的先例摆在旁边,所有国产算力供应商都在等同一个答案。知乎
推理侧的芯模协同倒是已经验证:近3万亿参数的Kimi-K3发布后,M890超节点随即宣布Day 0适配。平头哥还于7月开源了真武芯片的底层软件栈T-Head SAIL,官方称其可最大程度释放芯片算力。不过开源只解决迁移门槛,从推理协同走到前沿预训练,还需要算子覆盖、并行策略和长期集群稳定性的持续补课。知乎财联社
"大规模用"已经开始,剩下三道门槛
按行业口径,替代已经在发生。IDC统计显示,2026年上半年中国数据中心AI加速器总出货200.8万颗,其中非GPU专用加速器出货101.6万颗,第一次反超GPU的99.1万颗。知乎
份额格局同样变了:英伟达仍以34%位居第一,但出货同比下滑约44%;华为昇腾以28%紧随其后,平头哥约占7%、位列国产第三。知乎
商业侧的成绩也在摊开:截至今年4月,真武系列累计出货超56万片、服务20多个行业的数百家企业客户,财报会披露平头哥已实现商业化、年化营收达百亿元级别。知乎
把这些放在一起,"离大规模用还有多远"的答案是分层的:推理、行业训练和云上租用已经大规模发生;前沿预训练的大规模使用还差三道门槛。第一道是V900的量产爬坡。灵骏超节点实例已在乌兰察布地域开放邀测。但V900量产芯片的交付节奏没有公开。第二道是前沿训练的实测——50万卡是设计上限,能否长时间稳定训出万亿模型,还没有任何一项可核验的公开数据。第三道是财务口径。平头哥短期内最大的客户仍是阿里云,外部销售是第二条腿。目前公开的都是累计出货数字,收入结构、毛利和关联交易要等招股书版本才见分晓。钛媒体知乎
把标题的问题收拢成一句话:平头哥现在能真实承载的,是百亿到千亿参数模型的训练与超2万亿参数模型的推理;万亿级预训练的答卷,要到明年一季度V900量产后才开始批改。接下来最值得盯的三个信号——V900的交付节奏、下一代Qwen是否点名平头哥跑预训练、招股书里的外部收入占比。
当前文章无评论,是时候发表评论了