10月23日,vllm-xpu-kernels 仓库合入第22个PR。做推理的人会盯这种更新:模型没发,矩阵形状先到了。知乎
隐藏维度5120,FFN宽度14336,四路残差各5120、合计20480。按64层、三层GDN配一层全注意力推,主参数约27.24B。
这个尺寸正好对上传闻中的Qwen4-27B;它已经出现在英特尔的推理代码里。微博知乎
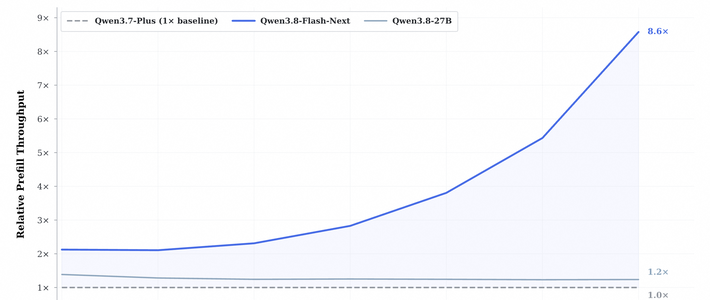
官方没否认。云栖大会上,Qwen负责人刘大一恒说Qwen4已进入训练,开源先排27B;8月的Qwen3.8-Flash-Next,被称为Qwen4架构预览版。36氪微博
值得看的不是27B,而是参数怎么摆。前代Qwen3.8-27B的FFN宽度是17408,新代码里变成14336,缩了17.6%。
按SwiGLU三组投影算,64层省下约30.2亿参数;腾出的预算大体挪到Gated Residual:四路残差流,每层两套,64层约33.7亿。
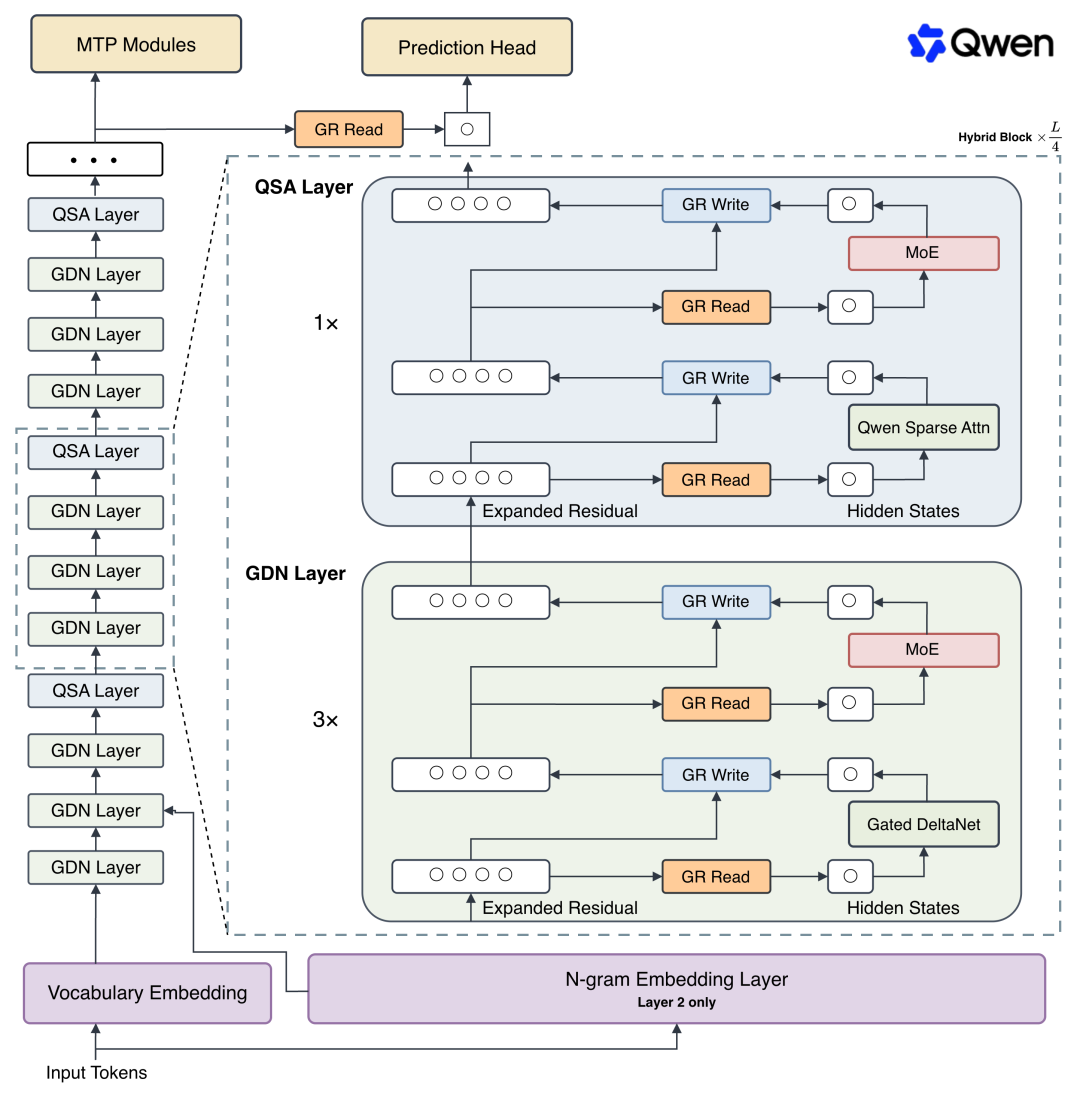
一进一出,27B的盘子基本没变,钱从“每个token怎么加工”挪到了“不同层之间怎么传话”。
它像一份不断被覆盖的草稿。传统残差只留一份;GR保留四份5120维状态,进子层前门控合成输入,算完按四个强度写回。
四路不是四个模型,是一次计算、四种读写。对改旧接口、多步推理这类活,早期约束更容易一路带到深层。
注意力延续了分工:四层里三层用GDN把历史压成“笔记”,剩下一层用全注意力加QSA做精确查找,官方概括为“GDN负责记住,QSA负责找到”,冲的就是长上下文和仓库级代码。千问大模型知乎
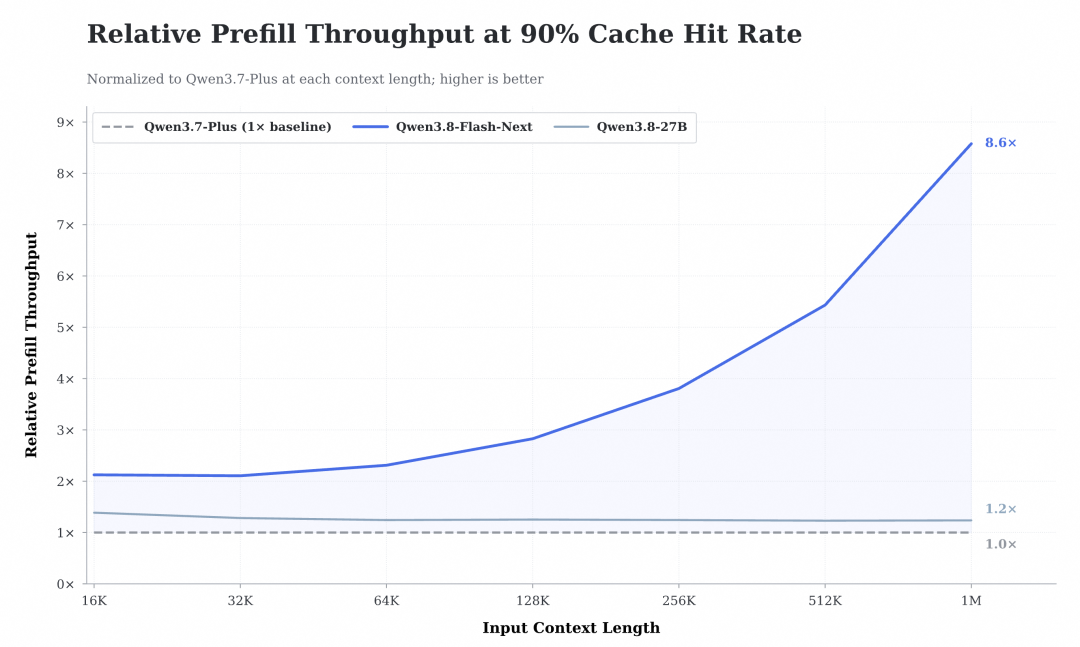
但PR只能证明形状,证明不了训练学会用这些通道;10月29日这个发布日,也只是社区从信号里猜的。知乎
架构给的是自由度,不是分数。Qwen3.8-27B的底子不差:SWE-bench Pro 61.7、Terminal-Bench 2.1 73.0。知乎
LiveCodeBench v6 90.3、OSWorld-Verified 84.3。社区把新27B的中位分往45推,那是预测,不是成绩单。
怎么等:做本地部署的,27B稠密模型按参数量粗算,FP8权重约27GB、INT4约14GB,24GB卡跑量化版是现实路径,真正该等的是量化适配。
只做日常问答和写作的,Qwen3.8-Flash更便宜,没必要空等;做代码和Agent的,值得等实测。
发布会只决定它何时来。PR里的那几个数字,已经说明它想怎么赢。