这轮双11的DIY市场,最魔幻的价签不是新卡——是"十年老卡"。一边是10月28日《显卡日报》报道50系连涨11个回合后大面积回调:5080一天降1410元、5060跌回4000以下。另一边,2017年的Tesla V100成了二手平台最抢手的"AI入门卡":有人用华南双路X99加两张千元级16G V100,整机实付3879元,把Qwen3.8-Flash-Next 125B的256K上下文完整跑满,实测生成81.4 tok/s。哔哩哔哩哔哩哔哩
知乎上那个144万阅读的问题正好问在这个点上:很多人觉得本地部署一个大模型,就实现"token自由"、就可以干活了,真的吗?知乎
评论区至今吵成三派:认真算了电费、发现本地比API便宜十几倍的;拿415个赞回怼"本地跑LLM从来不是为了便宜,是为了隐私、合规、无审查"的。还有一种最诚实——“前面认真算电费和等待成本,结尾还是买了两张V100”,省钱是一笔账,装机的乐趣是另一笔。我把近两周B站、知乎上真实跑出来的数据拢成了三本账,你该算哪本,取决于你是哪种人。哔哩哔哩
第一本:门槛账——墙已经从显存挪到了内存
今年最容易被转发的,是各种"小显存跑大模型"实测:开源引擎Strata让12G显卡跑Qwen3.8 Flash Next报到93 t/s,播放24万、收藏2.1万。零度解说实测8G显存也能让125B进家门,N卡A卡通吃。更早出圈的AirLLM号称4GB显存跑70B;还有人把测试复制到笔记本,16G显存硬跑也到了36 t/s——对比之下,两张PRO 6000 96G跑同一个模型要24万。哔哩哔哩哔哩哔哩哔哩哔哩
这些数字都真实,但都省略了同一件事:小显存的代价是把模型层卸载进内存,体验上限从此由内存容量和带宽决定。3879元那台"神机"的瓶颈写得明明白白:当前每路单通道内存带宽只有24.65GB/s,UP主自己标注升级8条RE ECC四通道后理论带宽翻3倍。想靠内存补显存的,还得先过容量关——知乎上"3050Ti无法部署32B模型、内存需升32G+"是高频答案。而这恰恰踩在本轮涨价最疼的地方:10月28日的内存日报里,DDR5还在日涨0.50%,金士顿FURY 16G已回升到2199元。去年"大内存白菜价、捡张破卡凑合跑"的老方案,今年的价签已经反过来咬人。门槛没消失,只是从显卡挪到了一个更贵的位置。哔哩哔哩哔哩哔哩
第二本:价位账——四档入场券,但"大显存"不等于"大而强"
把社区最近两周的真实成交价和实测速度排开,今年想上桌"AI盒子"大概四档:
千元档(垃圾佬路线):V100 16G杀到千元级,X99-D3老平台"一千块捡垃圾"就能搭起来。有玩家用精粤X99-Ti D3 Plus加32核E5-2698B v3、64G DDR3直通V100,在PVE虚拟机里跑通了Strata加256K上下文。哔哩哔哩哔哩哔哩
32G版更微妙:改水冷的UP主说这张卡市场周期已接近十年,现在反而成了入门玩家性价比最高的选择,二手闲鱼量大管饱。但同一批买家也有声音:“现在V100 32G太贵了,价格一点也不美丽”,想要蹬回成本得很久很久。洋垃圾里也出现了AI溢价,两种说法同时存在,说明行情正在这档打架。哔哩哔哩哔哩哔哩
八千档(成色保守路线):二手3090 24G,10月9日硬件日报口径一年涨63%、同期3060 12G涨52%。直播切片里观众已经在报"3090都8000-9000了?5090都5万8了"。24G是跑32B量级的常规门票,保修、生态、游戏三不误。哔哩哔哩哔哩哔哩
三万档(魔改路线):48G魔改4090。10月20日的实测把口径拆得很干净:跑27B吃满46.9G显存、180K上下文,单请求92.2 t/s、滚动60秒平均253.1、最高342.7、4路并发聚合瞬时426.7。四个数对应四种场景,抄参数前先看口径,别拿聚合数当单机体验。哔哩哔哩
二十四万档:双PRO 6000 96G顶配,个人玩家看看就好,它存在的意义是让你明白千元档方案的相对便宜。
真正反常识的对比这个周末刚出炉:15项同题实测里,5090D跑27B对4090 48G跑125B,6并发一题是0.90秒对6.91秒的8倍差距,三体物理模拟一题27B完美运行、125B直接黑屏崩溃。换句话说:你不知道自己要跑什么任务,"大显存大模型"就是这轮里最新的一种智商税。哔哩哔哩
第三本:隐性账——电费是小钱,噪音、热、无保和代际才是大账
“便宜17倍"那位UP主用计量插座实测完P100/P40/V100的电费、按Qwen官方API价格逐笔对账之后,标题后半句是"为什么我还劝你别入坑”。评论区替他把隐性成本列全了:Tesla卡没有PC可用的风扇,不用暴力风扇温度压不太住,用的时候得戴隔音耳机。双SXM2卡上Windows要过TCC模式加NVLink的兼容性墙,LMStudio约30 tok/s、unsloth约45、Coder390约70,作者结论是都不够快。48G魔改4090热点最高97℃、原机高负载约75dB,已经有客户把刚买的卡从北京寄到深圳改浸没式液冷。哔哩哔哩哔哩哔哩哔哩哔哩
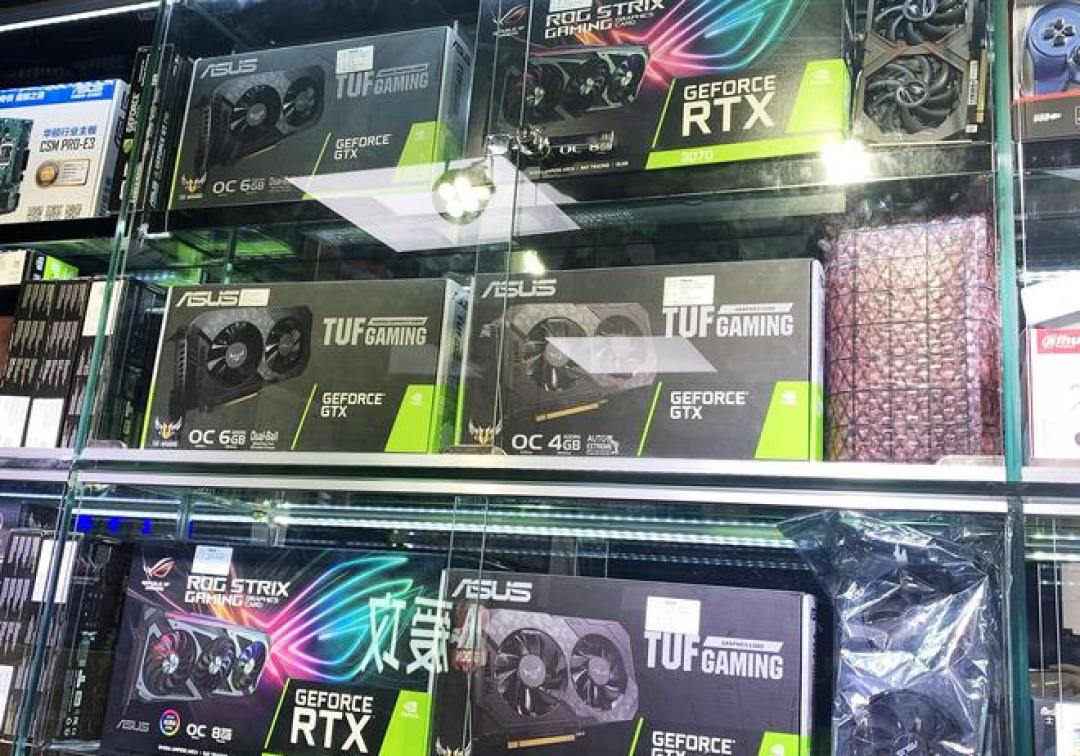
魔改卡没有官方保修,而10月连5090都爆出"同一位置集体烧毁"的新闻,41.9万播放、3814条评论盯着原因猜,你敢给三万的魔改卡裸奔吗。哔哩哔哩
对账本身也有坑:评论区已经点破"量化版API要折价的,哪能这么比"——拿IQ3_XXS量化本地跑的消耗去对全精度API标价,省出来的17倍里有相当一部分是口径差。还有最钝但最真实的一刀:“到时候可能模型代际差距就非常大了”。计算卡的折旧对手不是时间,是下一版开源模型。哔哩哔哩
哪种人算哪本账
轻度尝鲜、量小的:别入。你的需求免费额度和API全都能接,现在的V100行情已经包含AI溢价,入场即接盘。
资料必须保密、要无审查、跑本地Agent的:入,但钱要先划给内存和带宽,显卡是最后一笔。你的账本第一页不是"省多少钱",是那句415赞的"为了合规、隐私"。
又写作图又跑Agent的双槽玩家:评论区现成作业——V100给Agent跑27B和embedding,4070跑ComfyUI,24G级二手单卡加一张入门游戏卡的组合,比一步到位的48G灵活。哔哩哔哩
要并发产能、算"几个频道"的:只有48G+档有资格上桌,回本模型请按并发聚合口径算,别按单请求峰值自欺。
继续盯什么
三个信号没落地前,别急着把购物车变成订单。SK海力士口径DRAM和HBM的2029年前产能已经售罄、供不应求可能持续到2030。黄仁勋也放话内存在2029年之前不会供应过剩——“靠大内存补显存"这条路的成本线大概率只上不下。50系回调只走完第一个回合,72小时内的报价还在一天一变;Strata这类引擎一周一个版本,4090 48G的Windows跑Qwen3.8 Flash Next的prefill 2000问题,10月28日刚被社区解决——“今天跑得动"不等于"明天跑得顺”。盯两个价格锚点就够:二手3090、V100 32G——哪个先停止"AI溢价式上涨”,哪个就是你该出手的时刻。哔哩哔哩哔哩哔哩哔哩哔哩
至于"token自由"到底是不是真的,看完这三本账你会发现,它和"装机自由"是同一个答案的两面:每一代垃圾佬最后都会发现,省下来的钱,都变成了快乐本身——而这句话说出来,恰好就是415个赞之外,评论区那条被顶上去的自我和解。