同一对48小时,英伟达向全世界演示了两件完全不同的事。
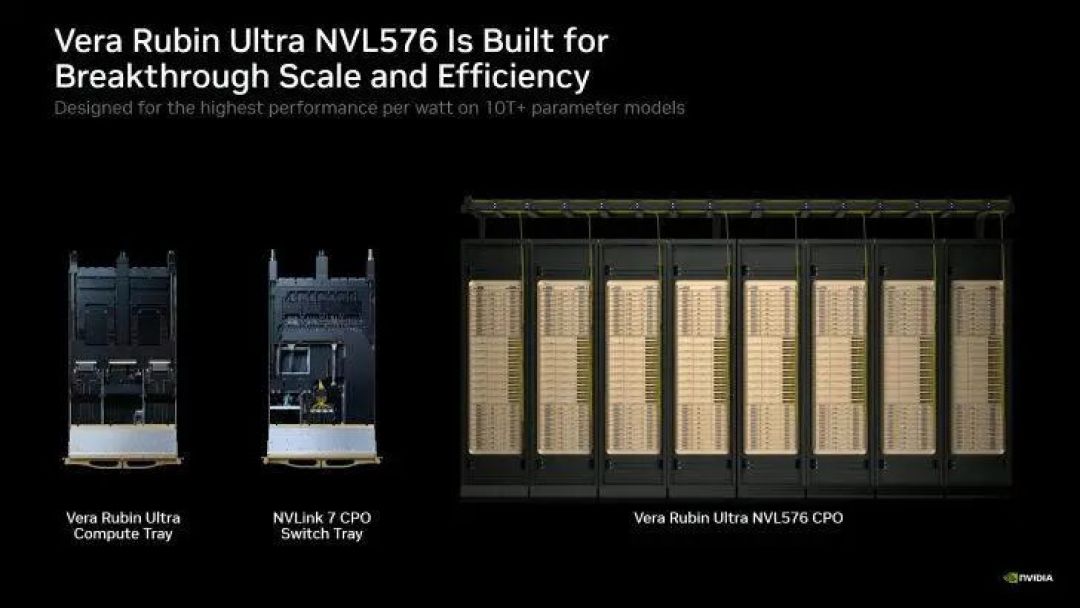
10月28日的OCP大会,英伟达官方预告Vera Rubin Ultra NVL576:Kyber机架塞进576颗GPU、全液冷,每颗GPU配1TB HBM4E(是Blackwell的8倍),整架HBM合计365TB、内存带宽4.6PB/s,FP4推理算力15EF、FP8训练5EF——对比GB300 NVL72,一口气翻14倍。知乎
10月27日,华尔街见闻转引多家外媒曝料:英伟达已经悄悄修订了Rubin的官方规格页——每GPU HBM4带宽从22TB/s降到19.2TB/s,砍了13%;NVLink互连从3.6TB/s降到3TB/s,砍了17%;系统层面最高降26%。知乎微信公众号
一边是并行计算的天花板,一边是地板。有意思的是:这两件事不矛盾,它们是同一件事。
砍掉的13%,是用良率换纸面。 曝料里砍的是"速度"不是"容量"(288GB没动):按原来的22TB/s目标,内存颗粒每pin要跑到约10.7Gbps;降到19.2TB/s,只要9.4Gbps——速率降下来,能过认证的颗粒多了,卡才造得出来。曝料的另一半:Rubin Ultra弃12层HBM4E堆叠、转用8层方案,原因是12层压不住热、良率撑不起量产。知乎
所以英伟达早就想明白了:并行计算的对手不再是同行,而是灶台、电网和良率。数吉瓦级的超级集群抵得上一座中型电站——这就是NVL576从出生就标配全液冷和CPO光互连交换机托盘(光纤替代铜缆)的原因,甲骨文的Rubin超级集群也已经扩进吉瓦门槛。时间表同样在讲物理的故事:NVL576预计要等到2028年,2027年先出过渡款NVL144。知乎知乎
顺带较个真:官方预告里"每颗1TB、共576颗"与"365TB总量"两个数字对不上账(576×1TB=576TB),大概率有笔误,以规格页为准。同样,降规曝料来自媒体对规格页存档的比对,英伟达从未公开承认。在它承认之前,纸面数字都该打折看。微信公众号
给GPU并行计算兴趣者的三个参照点:
别看峰值FLOPS了。 576卡"真并行"的瓶颈是内存带宽、互连带宽、供电、散热这四个比纸面数字小、也比纸面数字难算的账。
互连开始光化了。 NVLink7上CPO光引擎,说明铜缆在机架内的电气瓶颈到了——并行计算的下一程,是"用光把卡绑在一起"。
管好预期。 2028年的NVL576是"物理完成版",2027年的NVL144才是买得到的版本;若降规坐实,这一代Rubin的真实带宽墙比发布会叙事矮一截。
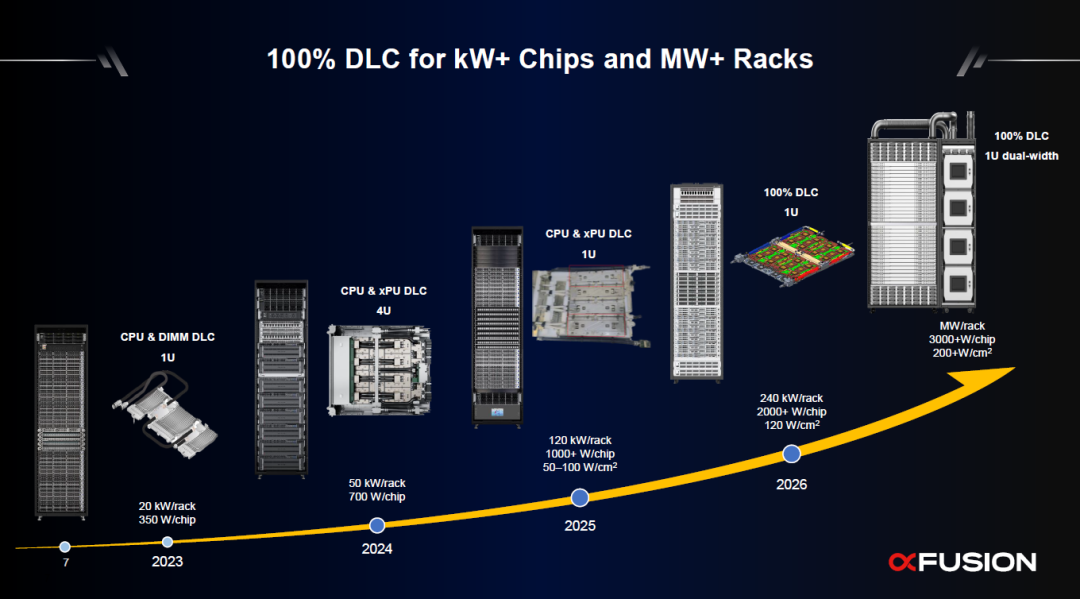
从"塞更多卡"到"伺候好已经塞进去的卡",并行计算进入了工程吃掉营销的年代。下一场算力飞跃,看起来不会像一场芯片发布会——它会像一缸冷却液、一捆光纤,和一张被悄悄改掉的规格表。