最近两周,"把微信读书笔记喂给AI"突然成了第二大脑圈子里最热门的动作。先是微信读书官方Skill被讨论起来——AI可以直接读你的书架、阅读记录、笔记和章节目录。 接着有人演示用ima绑定微信读书数据,让AI基于自己几年的划线生成读书总结。 再往前,还有一批自制的笔记导出工具和浏览器插件在各个帖子里被蹲版本。折腾AI第二大脑折腾了大半年的人突然发现:软件装好了,同步配好了,真正缺的是"喂料"这一步——而自己手里最大的存量资产,居然是微信读书里几千条划线。知乎小红书
这个方向值得认真算一笔账。因为大多数人的第一反应(把全部笔记导出、一股脑扔进AI)恰好是最容易白干活、也最容易被AI"一本正经胡说"坑到的一条路。
"摄入窗口"确实是最近才打开的
先看时间线。2026年4月,小红书就有人贴出自己做浏览器插件一键导出微信读书笔记数据的尝试。 更早的2025年5月,“把每条划线转成独立卡片"的工具帖拿到一千四百多赞、一千四百多收藏。 2026年8月开始,风向变了——讨论的主角从"导出整理"换成了"喂给AI”:微信读书Skill被当成"AI能读到你的书架"的入口在传播,有回答直接指出官方把"个人阅读资产"封装成了标准化接口。 8月17日已有博主演示用Skill让ima绑定微信读书数据、按具体书目生成笔记;9月20日前后,知乎和小红书集中出现"不写代码,给你的资料建个AI大脑""每天让AI推一章,而不是推一本书"这类实操帖。小红书小红书知乎
也就是说,“存量笔记进AI"这件事,工具层面从"要自己写插件"到"官方接口+一键绑定”,前后也就四五个月。这是这波晒笔记、补旧账潮水的真实背景。
但仔细看这些帖子,会发现一个被忽略的分层:官方Skill和ima这类路径,强项是"让AI现在就读到你的阅读数据",做推荐、做总结、做问答很顺;而想把几年的笔记变成自己知识库的长期语料(比如接进Obsidian或本地RAG),走的还是导出工具那条线——评论区里最真实的声音恰好卡在这里:“只有macOS版本吗”“软件打开就闪退”“十年前的MacBook装不上,好想用这个软件”“Windows电脑版也行”。 导出工具链的可用性,仍然是普通读者面前的第一道坎。小红书
划线恰恰是AI最难用的语料
这是本篇最想泼的一盆冷水:你以为的"知识资产",对AI来说很可能是最差的语料之一。
原因不在微信读书,在大模型的底层逻辑。最近一篇被反复转述的企业案例把问题讲得很直白:有公司花十几万搭知识库,各部门资料往里塞,结果生成内容照样"牛头不对马嘴"——因为LLM本质是概率接龙,RAG只是回答前先把你的文档切成小块检索喂给它,切块会切断上下文,资料本身不够干净,AI就会拿着驴唇不对马嘴的片段强行编。 这篇实操分析给出的铁律只有一句话:垃圾进,垃圾出,最高效的做法不是买更贵的AI,而是先把数据"洗"干净。知乎
对照一下大多数人的微信读书划线,你会发现它们几乎是"垃圾进"的标准样本:
碎片化:一条金句一行,没有主语没有语境。“答案是做出选择,然后承担它”——单拎出来,AI不知道这是你从哪本书、带着什么问题划的。
无个人判断:知乎那篇被引用很多的答案提醒过,“第二大脑不是外接硬盘,而是认知伙伴”。 纯摘抄只完成了存储,没有完成"你想过"这一步。知乎
密度极低:社区里早就有共识帖戳破过这层窗户纸——“划线很多,收藏很多,陷入一种’读了很多’的幻觉,但过几天其实什么都记不住”。 五千条划线里,有真实思考痕迹(写想法、批注)的可能不到十分之一。小红书
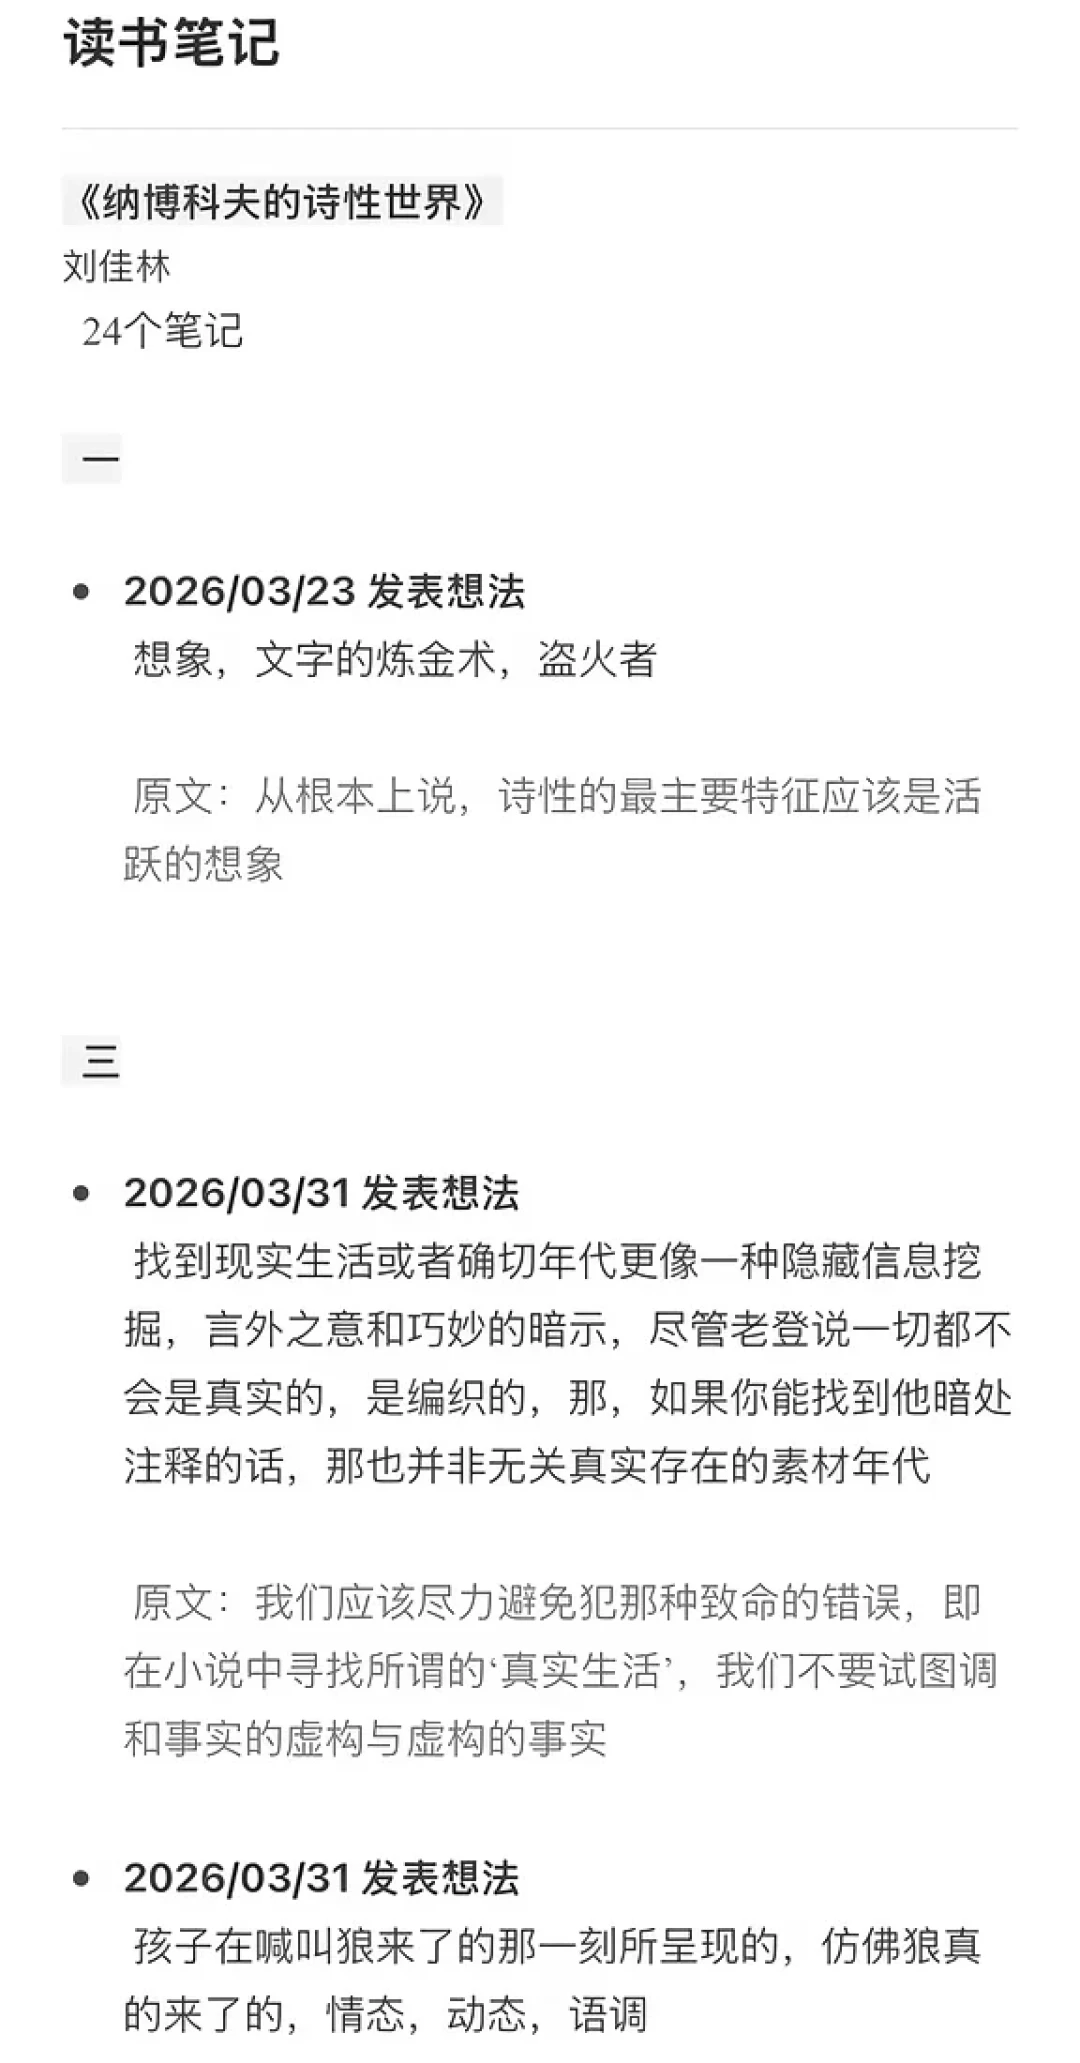
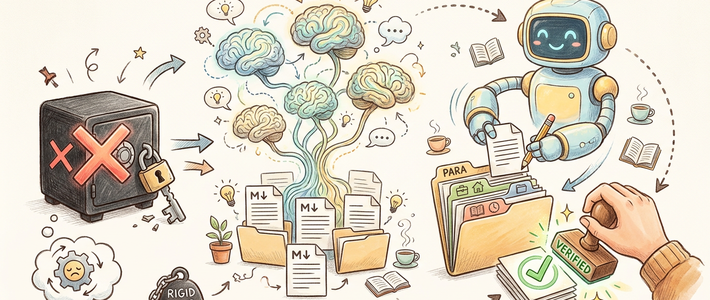
所以同一套"喂AI"动作,喂进去的东西不同,结果天差地别:把纯金句划线整包倒进去,AI检索到的永远是漂亮话,回答依然空;而把自己的想法、批注、和当下问题相关的那部分喂进去,它才第一次有机会像"认知伙伴"而不是复读机。8月知乎上那篇讲AI幻觉的回答给的路径也是这个顺序:自己先过滤一次,给AI提供正确素材,再让它出菜。知乎
摄入前先算账:哪些划线值得搬家
参照社区里"拆书"和"一本书只保留两页纸精华"这些高赞整理帖的思路,可以给微信读书笔记做一次三档分拣:
带想法的划线(最高优先级)。你写过批注、算过"这条和我的工作/写作/决策有什么关系"的。这部分才是你认知的一部分,导出后补上书名和章节上下文再入库,AI才用得上。
和当前在做的项目/反复在想的问题相关的书摘。判断标准很具体:这本书如果你现在不会重读、这个主题三个月内不会再碰,就不急着入库。第二大脑圈子里正在试验的新玩法也印证这个思路——与其喂全书架,不如结合"今天正在想的事"让AI推章节、调笔记。知乎
纯情绪性收藏的金句。这类恰恰建议放弃迁移。它们的价值在划下去那一秒已经完成(让你爽了一下),强行入库只会成为污染检索结果的噪音。"收藏夹搬家"的教训在网盘和Notion时代已经反复上演过一轮。
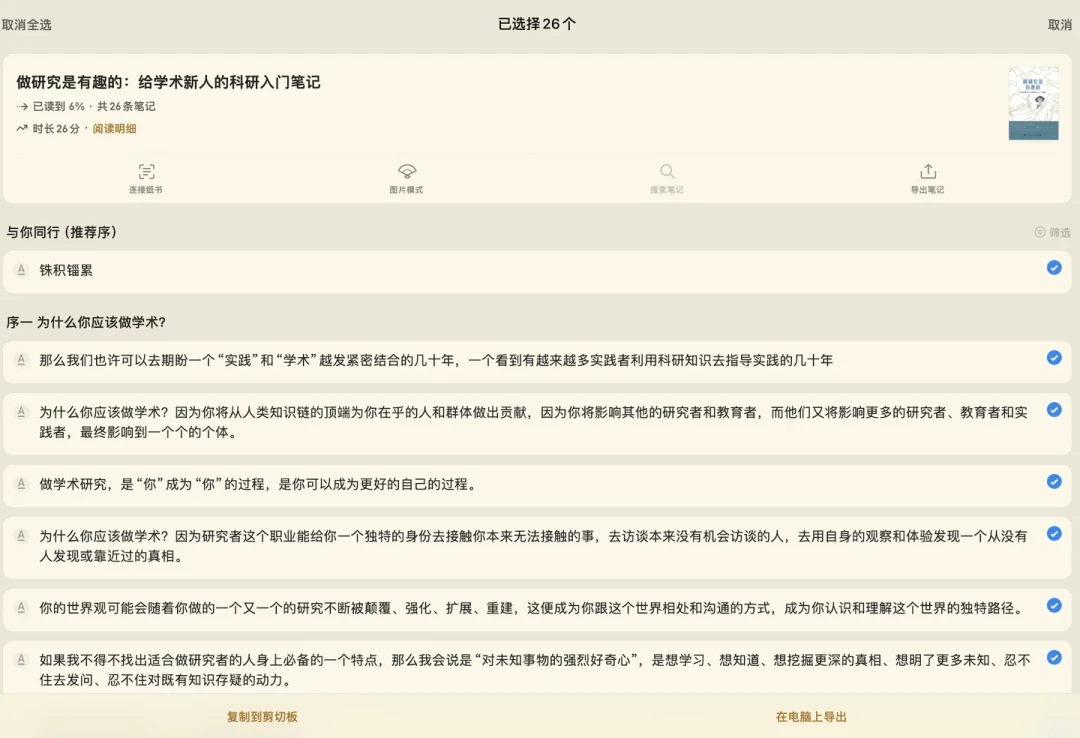
这个账的隐藏收益是省时间:全量导出+清洗+索引五千条划线,按社区晒出来的实操进度,一个非技术用户周末两天未必搞得定;而只处理前两类(通常不到总量两成),半天就能入库跑通。先跑通一条窄闭环,比建一个"什么都还没喂进去的大库"更接近第二大脑的正确起点——这也是前面那篇"一半人建的仓库"讨论里,交作业的人踩得最多的坑。
三条摄入路线:成本、卡点、隐私红线
按投入从轻到重,目前社区里真实在用的路线大致三条:
路线一:不搬家,直接用官方接口。通过微信读书Skill/ima这类能力,让AI在线读你的书架和笔记,做推荐、按书做总结。零导出成本,适合轻度使用;局限是数据留在平台侧,且它更像"AI替你翻笔记",不是你自己的长期知识库。
路线二:选择性导出到Markdown,接本地RAG。导出工具(浏览器插件或开源Mac应用)→ 清洗补上下文 → 丢进AnythingLLM这类本地工具。9月那篇零代码实操帖给的成本参照:Ollama拉一个7B模型+嵌入模型,16GB内存能跑,50页PDF三十到六十秒建完索引,回答带出处。 这条路线数据不出门,是"想认真建库"和"不想折腾代码"之间的现实交点。卡点也很实际:导出工具大多Mac-only、依赖Swift、老系统装不上,Windows用户目前还得回到官方"羽毛图标复制粘贴"这条最原始的路。知乎
路线三:云端大库。把全部笔记传给云端AI工具建库。提醒一句那篇本地知识库帖里的原话级别的红线:合同、方案、客户资料、薪酬表这类文件,别往别人服务器上放——阅读笔记没这么敏感,但如果你的"想法"里经常涉及工作中看到的东西,云端路线就需要多掂量一下。
最后:先分拣,再搬家,别倒仓库
第二大脑这波从"装软件"卷到"喂数据",本来就是个正常周期——工具红利三个月就饱和,真正的差异化在谁的语料干净。对微信读书重度用户来说,此刻最值得做的动作不是再装一个新工具,而是花一个晚上给几年划线做一次三档分拣:能用的搬进去,不用的承认它只是纪念品。
后续值得盯的信号有三个:官方Skill能开放的数据范围会不会继续扩大(目前晒出来的能力还停留在书架/笔记/目录这一层)、Windows版导出工具什么时候补上、以及第一批"笔记喂AI"跑通的人会不会开始晒检索质量翻车帖——那会告诉你这条路的真实上限在哪里。