Qwen3.8-27B发布三周,社区的讨论风向变了一个很明显的拐点:前两周问的还是"我的卡装不装得下",这两周刷到的全是"怎么榨干"。9月16日一天,B站挂出四五条27B实测视频,知乎连着三篇万字实践帖,评论区里最热的不是模型本身,而是一堆你官方README里根本看不到的名词:MTP投机解码、RCO/GSQ量化、k6v4、IQ3_S、kvmem分支。哔哩哔哩
一句话概括这波分歧:同一个27B,有人说" coding场景死得最彻底",有人说"这才是24G显卡用户的甜点"。把两周的实测帖和评论区攒到一起看,会发现吵起来的不是模型,是前提——本地这个模型其实有两条"能用线",一条聊天,一条干活,过线的方法完全不一样。
两条"能用线",先对号再谈配置
聊天/文档线,官方4bit就能过。文件17.74G,塞进24G卡还有富余。有做敏感度分析的玩家给过结论:量化的伤主要集中在output层和full-attention上,Q5以上基本无损——追求极限才需要Q6/Q8,但那个体积24G卡就别想了。知乎
编码/agent线,4bit直接翻车。算法工程师小桥在知乎连写三篇复盘:第一版把Qwen3.8-27B接Claude Code,结论"不太能用";换成q8量化接QwenCode,“可以正常干活”;最后用Unsloth Desktop挂专用编译的llama.cpp,才把Claude Code调教到能自己修bug——一道修复题跑了4分钟,解法人工核对是对的。 他自己的解释很直白:聊天4bit损失不大,但agent调工具、跨文件改代码,精度一掉就开始"忘规矩"。知乎
而另一位去年花2800元买了5060Ti 16G的博主,测完三个用途给出"编码、视频行不通,只有出图真能打"的结论——注意他测的还是qwen2.5-coder那个世代,32B溢到内存里每秒几个词。 这条差评放在今天看要打折:模型换代了,但他那句"每月几十块的API钱,比折腾硬件便宜太多",对纯编码需求的人依然成立。知乎
社区现在最有共识的一句话是:想拿本地27B跑一整天无人值守的长程agent,别做梦,几轮下来注意力漂移严重;要么拿它当planner拆任务、执行丢给小模型,要么上125B的Flash,要么继续用API。 单轮深度问答、代码生成、文档处理,才是它这个尺寸最能打的地方。知乎
三个杠杆,按性价比排序全是参数层的
第一杠杆:MTP投机解码,一行参数接近翻倍。3090Ti跑了三周的玩家的数字最有代表性:4bit标准解码56-62 token/s,开MTP=3峰值到87,质量无损。 他反直觉地发现:decode速度对上下文长度几乎不敏感,10K上下文只比裸测慢10%;真正没用的是batch、ubatch、KV量化这些常规调参。再狠一点的路子有两条:DFlash2投机解码官方基准平均3.2倍,但要配draft模型、部署复杂度上台阶;嫌还不够就直接换MoE的30B-A3B,4090实测196 t/s,代价是智力比27B略弱。知乎
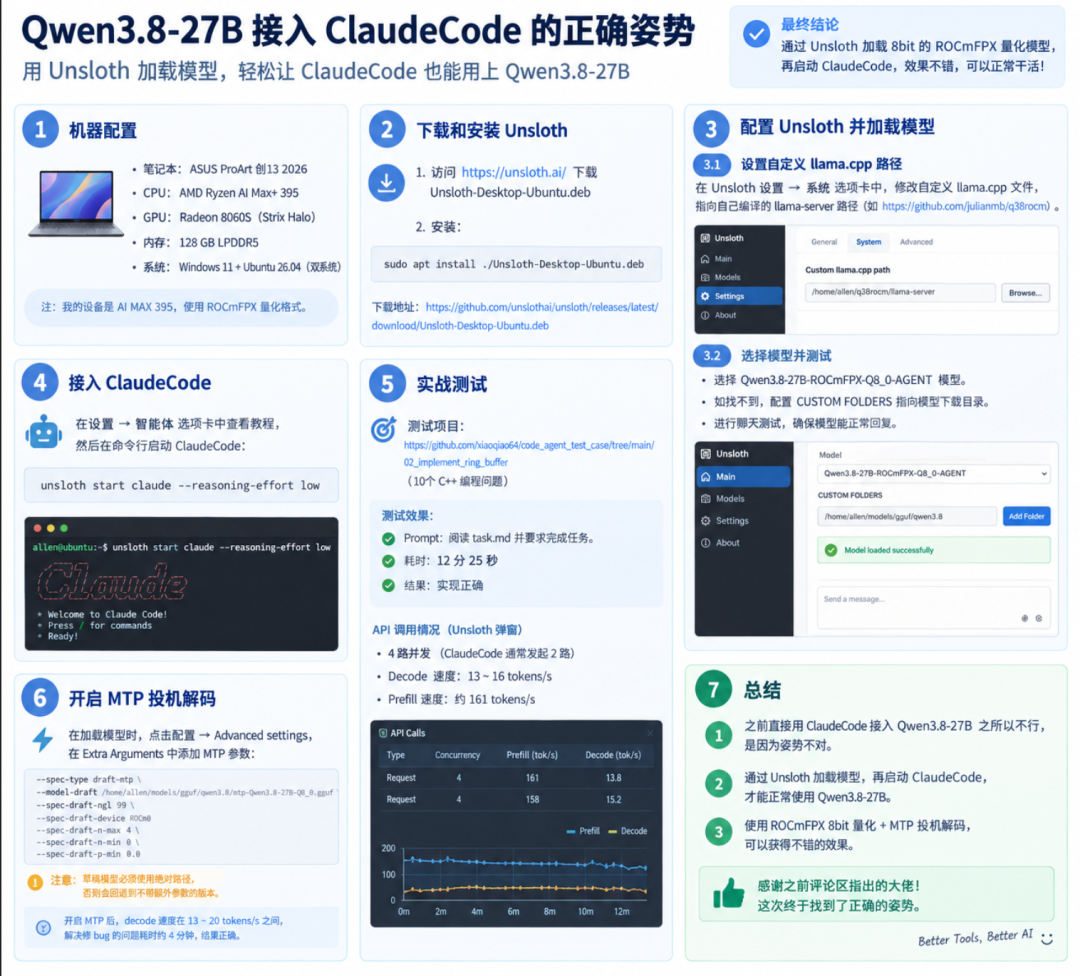
坑在这:小桥用Unsloth开MTP时,draft模型传了相对路径,它不报错,而是静默回退到不带加速的版本再加载一遍——他是拿ps命令对比llama-server进程才发现的。 这类"不报错的白折腾"是这个阶段最贵的时间成本。知乎
第二杠杆:思考档,默认值在烧你的卡。这模型默认xhigh思考档,官方为了跑分好看,代价是"想太多"被社区骂了半个月:固定prompt实测312个输出token里286个是思考token,92%的算力花在自言自语上,一个Hello World它能给你设计成"高扩展模块化"版本。 降到medium甚至low,日常任务效果几乎不打折。两个细节:reasoning_effort只认xhigh/medium/low三个值,传high直接500;而且只能启动时设,不支持请求级切换。知乎
第三杠杆:KV缓存量化,决定16G卡的上下文天花板。每token的KV大约22KB,256K满载5.5G显存,128K只要2.8G——所以官方模型卡自己写着"至少128K以维持思考能力"。 真正的变数是这两周冒出来的KV量化分支:有4080S 16G用户在评论区晒了配置——RCO/GSQ的IQ3权重加k6v4的KV量化,MTP开2,110K上下文全程50-70 t/s、预填充1700左右。 同一条评论区里,5060Ti 16G的用户却在80K上下文只有7 token/s。两拨人卡都是16G,差距不在容量在带宽——样本还少,当线索别当判决书,但"高带宽16G吃红利、入门16G看戏"已经成了这轮最明显的分层。知乎哔哩哔哩
做测评的up主补了最后一块拼图:KVcache量化是"我见过模型差距最大的一环",IQ3_S速度快得离谱,FP16质量稳但吃不下长上下文,k6v4质量接近q8_0——不过V100这类老卡上预填充和解码直接对半砍。哔哩哔哩
攒了一份单卡实测速度表(全部是社区单样本,口径看括号)
硬件 | 方案 | 输出速度 |
|---|---|---|
3090Ti 24G | 官方4bit + MTP=3 | 56-62,峰值87 t/s(知乎三周实践帖) |
32G显存 | nvfp4 + 新框架 | 近百t/s,预填充2000+(知乎回答,单样本) |
4070TiS 16G | 新KV方案 + 128K上下文 | ~70 t/s(B站评论区) |
4080S 16G | IQ3权重 + k6v4 + MTP2 + 110K | 50-70 t/s(B站评论区) |
5060Ti 16G | 旧KV池方案 + 80K | ~7 t/s(B站评论区) |
AMD AI Max 395 | ROCmFPX Q8 + Unsloth + Claude Code | decode 13-20 t/s(知乎实践帖) |
双RX7900XTX 48G | Qwen3.8-Flash 125B + 48K | 日常38-40 t/s(B站双机实测) |
对照组也放一个:想一步到位本地跑DeepSeek V4.1 Flash的,完整权重约510GB,Kai的账算得很清楚——普通硬件慢到23秒一个token,四台DGX Spark对比API非高峰价回本要按年算,只有数据驻留、合规、审计逼着你的时候才值得。哔哩哔哩
上车前,把这几个零碎坑先记着
都是真金白银时间换的:mmproj视觉投影文件必须和主干同前缀版本,按字母序拿第一个直接启动挂;对话模板要求system消息必须在第0位,opencode这类发多条system的客户端会报错,换Anthropic协议可绕;Windows长上下文是TDR重灾区,262K满载迟早给你一个0xC0000409,先改注册表TdrDelay(Linux改RmWatchDogTimeout);中文输出没法服务端强制,最靠谱的就是用中文提问;LM Studio底层是另一套llama.cpp,这轮的分支方案它一个都先用不上。
社区为此已经分成两派:抢跑派把kvmem、buun分支、radiance-vllm这些实验方案挨个试,“256K写满只掉一点速度”;等等党只有一句话——“等他合入主干再用”,理由是turbo至今没并入主线本身就说明问题。 两派都对,取决于你折腾的是生产力还是兴趣。哔哩哔哩
谁该动,谁别动
24G卡+主要聊天写文档:现在就动。官方4bit、MTP=3、思考档降medium,三件事做完就是甜点,别碰分支。
高带宽16G(4080S/4070TiS):可以抢跑,但只拿一个分支试,别全家桶都上。
5060Ti这类带宽受限16G:128K的红利与你无关,长上下文保持低预期。
纯编码刚需:桥的结论摆在那,8bit+Unsloth+专用分支能跑通Claude Code,但13-20 t/s、一题4分钟,值不值那电费之外的折腾,先问自己数据到底能不能上云。
想跑长程agent/125B级Flash:27B不够,预算在双卡N卡或395/7900XTX这条线上再找,别为难单卡。
接下来盯两个信号就够:kvmem、turbo这几个分支什么时候并入llama.cpp主干,官方什么时候把MTP和agent级量化打包成开箱即用——这两件事任何一件落地,今天这份民间作业就作废一半。在那之前,27B的"token自由"确实是24G一代显卡的甜点,但这道甜点,配方写在评论区里,不写在README里。