9月18日这一天,两件事撞在了一起。
一件是技术博主ferstar放出对智谱ZCode的逆向分析:只要登录这款AI编程工具,它就会在后台把你的整个工作项目连同完整修改历史打包、加密、上传云端,解密的钥匙只在智谱一侧,而且有两个关不掉的开关。当天多名用户跟进爆料,环球时报报道,智谱致歉,称这是"代码库索引"功能、“上传数据不会被保存”,并承诺开源——但直到9月20日晚间,承诺开源超过一天,代码还没放出来,还有企业发函称仍检测到上传行为。知乎知乎
另一件,是B站UP主Jupit3r发布了一条测试视频:两台E人E本EBOX G95迷你主机,都搭载AMD锐龙AI Max+395、板载128GB统一内存,用一根雷电线级联,组成240GB的显存池,把DeepSeek V4-Flash的284B模型整个装了进去——这个规格的模型,以前至少要4张RTX 4090才装得下。实测生成速度超过10 tokens/s。两台机器的总成本,UP主在评论区自己报的数:4万多。哔哩哔哩
G95视频下面,点赞最高的一条相关评论(32赞)说得很直白——智谱zcode再次给大家上了一课,本地部署对于注重隐私性的人来说有多重要。哔哩哔哩
隐私风波把"本地跑模型"的焦虑重新点燃,而迷你主机圈恰好在这同一周,把"本地大模型"从单机玩具推进到了集群时代。这篇文章把本周全网(B站、知乎、微博)散落的实测数据、价格行情和争论收拢成几本账,帮正准备下单的人算清楚:现在买、等10月、还是继续用API。
先看清楚:这一周"迷你主机跑AI"到底有多热闹
不是单个视频火了,是一整簇内容同时冒出来:
9月11日,10万粉的MagicBear发布8台华硕GX10(与DGX Spark同平台的GB10芯片)集群实测:1024GB分布式统一内存,跑起DeepSeek V4.1-Flash——552B主干加196B Engram、合计约748B参数的MoE模型,还顺手对比了四卡RTX PRO 6000。播放1.3万,58条评论,部署手册直接开源在GitHub上。哔哩哔哩
9月18日,Jupit3r的G95双机级联测试,5900多播放、53条评论——对一台售价2万级的国产迷你主机来说,这是很高的互动密度。
9月16日,"燃尽了!AI MAX+395竟然有这个性能"发布,社区自制的halogen-flash-server跑Qwen3.8-Flash-Next量化版,4600多播放、75条评论。
9月20日,知乎作者发文介绍刚上市的天钡NEX395,12999元,标题直接点明用途:“做AI集群用”。知乎
英伟达确认RTX Spark系列(N1X芯片)10月全球开卖,最高128GB统一内存,联想、华硕、戴尔、惠普、微星都有机型。知乎

有意思的是时间线:7月19日,B站还有一条3.7万播放、243条评论的讨论视频,标题是《现在怎么没有人提用AMD MAX395去跑本地大模型了?》——两个月后,答案是"提的人回来了,而且开始玩集群了"。触发这次回潮的,一半是MoE新模型(Qwen3.8-Flash-Next、DeepSeek V4系列)让大内存机器终于物有所用,另一半,就是ZCode这类事件不断提醒:你的代码和数据,在云端工具面前没有秘密。
第一本账:性能账——多少钱,能跑多大的模型
把本周和近两个月的公开实测拼成一张表(速度均为生成速度token/s,越高越好;20t/s约等于正常阅读速度):
方案 | 内存 | 整机成本(约) | 实测能跑什么 | 实测速度 |
|---|---|---|---|---|
普通核显办公小主机(Geekom A9 Max级) | 24-32GB | 2000-4000元 | 36B级MoE量化模型 | 可用但慢,Qwen3.8出JSON稳 |
天钡NEX395(64GB版) | 64GB板载 | 12999元 | Qwen3 Next 80B Q4_K_M(体积48.49GB) | 官方定位入门AI集群节点 |
395系128GB单机(EVO/G95/OneXStation/无牌) | 128GB板载 | 9800-21000元 | Qwen3.6 27B稠密 / 35B-A3B Q8 / Qwen3.8-Flash-Next 176B MoE(Q4约90GB) | 27B约20(dflash版40+);35B-A3B Q8约40-50;176B MoE并发4约40保底 |
双395集群(G95×2,雷电线级联) | 240GB显存池 | 4万+ | DeepSeek V4-Flash 284B | >10 |
8台GX10集群(1024GB分布式) | 128GB×8 | 28万级 | DeepSeek V4.1-Flash 748B | 计数108 / 代码83 / 正文37.5(vLLM单流中位数) |
对照组:4卡RTX PRO 6000 | 96GB×4 | 40万+(单卡10万+) | 同上748B | 计数238 / 代码192 / 正文87;8并发计数聚合944 |
这张表能读出三个不容易被单条视频说清的规律:
1. MoE模型是统一内存的救星,稠密模型是重灾区。 AI Max+395的内存带宽是四通道256GB/s,只有RTX 4090的三分之一不到,跑稠密模型时被带宽卡死——27B稠密只有20t/s上下。但MoE模型(如Qwen3.8-Flash-Next,总参176B、每token只激活6B)对带宽的需求骤降,对内存容量的需求暴涨,正好把395"内存大、带宽弱、没矩阵加速单元"的特点反着用。知乎上有用户总结得很到位:Qwen3.8-Flash-Next的Q4_K_M量化约90GB,装进128GB统一内存"正正好",并发4能保底40t/s。买这类机器前先想清楚:你的主力模型是MoE还是稠密,决定了这台机器是真香还是吃灰。哔哩哔哩知乎
2. “能跑”“能用”"能生产"是三档完全不同的体验。 装得下叫能跑;20t/s跟得上阅读叫能用;80t/s以上、能开多路并发才叫能生产。748B集群正文37.5t/s,单流勉强够一个人用,代价是28万和一台高速交换机;而四卡RTX PRO 6000同模型正文87t/s、8并发聚合944t/s——专业卡的钱,买的就是这两三倍的速度差和并发能力。微博上有博主晒出SGLang对Qwen3.8-27B的Day-0实测:RTX 5090跑到206 t/s,DGX Spark只有38 t/s——同一个模型,速度差出5倍,这就是"大内存"和"高带宽"两条路线最直白的差距。哔哩哔哩微博

3. 集群的门槛在降,但隐形配件不便宜。 G95双机只要一根雷电线,是目前最便宜的集群入口;GX10多机互联需要配置不错的高速交换机(MagicBear自己用了812交换机,评论区有人4机+812跑Hermes单流约60t/s,还在找瓶颈)。另外一条实测经验:接HDMI欺骗器保持视频输出,性能会损失15-20%——集群节点建议无头运行。哔哩哔哩
第二本账:价格账——三条路线,三本完全不同的账
路线A:AMD 395系——“最廉价的大内存方案”,但已经是理财产品的价
395系迷你主机(128GB板载统一内存)今年的行情堪称魔幻。评论区179赞的高赞留言:无牌128G+1T最低卖过9800元,有牌的14999元;有人11000元买入,上个月15000元卖出二手,“白用一年还赚钱,妥妥的理财产品”。背后是9月内存暴涨——零售DDR5翻着涨,反而把板载LPDDR5X的整机衬成了"买内存送主机"。哔哩哔哩
现价方面,壹号本OneXStation 128GB+1TB的首发价是20999元。天钡NEX395 64GB版12999元(128GB版更贵),E人E本G95单台约2万。优点除了便宜(比英伟达阵营同内存便宜一万多),还有省电(拷机稳定120W级)和小体积。坑也要说全:ROCm 7在Windows下问题多(评论区有受害者现身说法)、RDNA3.5核显没有正经的矩阵加速单元、社区工具链以Linux为主。保值率曾经不如Mac Studio,但今年被内存涨价硬生生逆转了。而且这个平台的阵营还在扩大——搭载AMD新一代锐龙AI Max+ PRO 495的首批迷你AI工作站9月底就要上市,机型阵容已经按"屏"计算,买之前值得横向比一比。哔哩哔哩知乎

路线B:英伟达DGX Spark/GX10——为CUDA生态花钱,行情坐过过山车
单台GB10机器(128GB统一内存、1 PFLOP FP4、15cm见方)的价格史很精彩:刚发布时全网骂,二手跌倒过不到1.7万一台;如今生态起来了(vLLM/SGLang适配、黑客松、部署手册满天飞),价格涨回3.5万+。微博上有人8月底抱怨,昨天给小小鹅买的两台DGX Spark,今天上午才收到,这会儿一看每台涨了五百五。哔哩哔哩微博
性能确实能打,但双机集群6万起步,还要配200G高速互联,8机就是28万级。GX10视频下12赞的一条把账算得很冷静——RTX PRO 6000现在一张10万+,DGX Spark也要3.5万+,多机互联还需要台配置不错的高速交换机,不是本地数据安全有严苛要求,其实线上API更划算。哔哩哔哩

一个新变量:已经有人在评论区挂出"本地机房DGX Spark 8节点高速互联对外出租"的广告。买不起集群的,现在可以先租着玩——这条路线值得观望党留意。
路线C:等10月的RTX Spark——生态最诱人,变数也最多
英伟达确认RTX Spark(N1X芯片)10月全球开卖,两个版本要分清:20核CPU+6144个CUDA核心(核显规格约等于桌面RTX 5070)、最高128GB统一内存的版本,笔记本和台式机都有;另有一个18核+5120核、内存上限32GB的版本,仅供笔记本。已公布的机型包括联想Yoga Pro 9n(128GB LPDDRX-9400+4TB)、华硕ProArt P14/P16、戴尔XPS 16、惠普Omnibook系列、微星Prestige N16,宏碁表示计划推出RTX Spark小型主机但没给时间。知乎
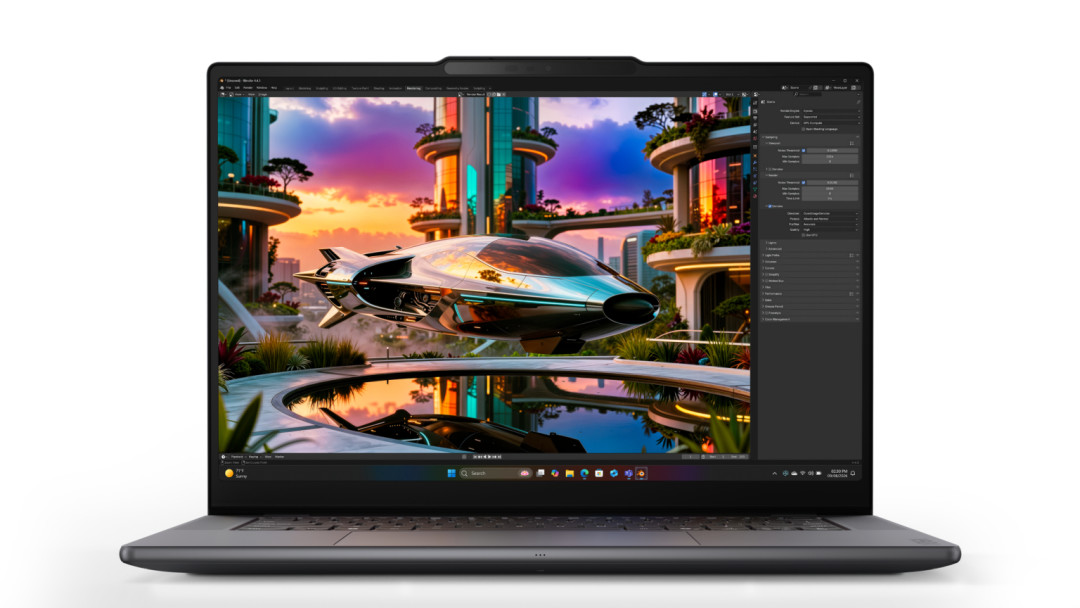
变数有三个。一是至今没有价格,CNET的评论员说得很直接——小型轻薄的工作站性能不错,但价格高到没人买得起,英伟达给自己挖了个爬不出来的坑。二是10月登场正撞上DRAM供给最紧的窗口,128GB大内存版首发有没有货、会不会被溢价,都是未知数。三是宣传的"1 PFLOP"是NVFP4低精度口径,看着吓人,落地要打折。另外划个重点:32GB上限的那个版本,CPU和GPU共享内存,跑本地大模型基本没戏,别买错。知乎知乎
顺带说Mac:统一内存带宽高、保值好,本来是本地AI的稳妥选项,但社区评论很损——“买395的人都在后悔没上M3 Ultra”,紧接着9赞回复"M3 Ultra只会更后悔,多花了钱没有本质提升"。MoE当道的今天,两边都讨不到便宜,钱包说了算。哔哩哔哩
第三本账:电费与隐形成本
硬件价之外,运行成本这次终于有人认真测了。MagicBear的数据:GX10八机集群GPU侧约245W,四卡RTX PRO 6000约821W(均为推理窗口遥测,非整机插座功率);按每天在线8小时、每度电0.8元估算,年电费分别约1168元和3738元,差2570元。395系单机拷机120W级,7×24小时当家用AI服务器,年电费也就三四百元——这是迷你主机做本地AI相对台式机显卡方案最实在的优势之一。哔哩哔哩
隐形成本清单:高速交换机(多机集群必需)、部署调试时间(评论区有人熬一整晚把昇腾910B×8调到180t/s,也有人4机跑了一年还说不清瓶颈在哪)、量化模型选型(同一个27B,普通版20t/s、dflash版40+t/s,差一倍)、以及无头运行的运维习惯。好消息是开源部署手册越来越多,MagicBear的Spark-Agents、vLLM/SGLang的DGX Spark部署仓库都可以直接抄作业。
反证:这三类人,现在别买
判断型内容不能只顺着热度说,本周同样有扎实的反方证据:
想拿本地模型替代API做日常干活的。 知乎9月16日一篇《我测了本地大模型的三个用途,两个行不通》说得很实在:单轮对话本地模型能应付,但云端那套Agent工作流——读整个工程、跨文件改代码、跑测试再自我修正——本地模型接不住,上下文长度和推理速度都撑不起多轮来回。GX10视频下5赞的评论也是同一立场——现在用API,等AI泡沫破了后再买高性价比硬件。知乎哔哩哔哩
以为买了本地部署就等于隐私无忧的。 ZCode事件的真正教训是:工具"关不掉的开关"比模型在哪跑更致命。本地部署同样要审计客户端上传行为,G95评论区就有人泼冷水——本地不本地没关系,客户端要上传的,你接本地API照样偷。隐私是工程问题,不是买硬件就自动解决的。哔哩哔哩
执着于稠密大模型的。 395系的256GB/s带宽是物理天花板,70B级稠密模型在这类机器上只有个位数速度——能跑和跑得快是两码事,395只解决了能跑,解决不了跑得快。真要稠密模型高速推理,加钱上专业卡没有捷径。哔哩哔哩
对号入座:四类人,四种打法
隐私刚需党(代码、合同、病历不能出内网):现在就买,别等。128GB的395系单机跑Qwen3.8-Flash-Next级MoE模型,是当前每GB显存成本最低的方案;预算紧可从天钡NEX395 64GB版(12999元)起步,但记住50GB模型体积红线——主力模型超过它就直接上128GB。RTX Spark对你不是选项:价格未知、供货未知、首发以笔记本为主。知乎
折腾性能党(要速度、要CUDA生态):等10月RTX Spark的128GB版报价和首测出来再动,避开32GB版;等不及就盯DGX Spark/GX10的行情,历史低点1.7万出现过一次,回到2万以内都值得出手;或者先租8节点集群验证自己的模型和工作流,再决定买不买。
日常AI用户(聊天、写文案、改代码为主):继续API,本地不值得专项投入。手里已有的办公小主机(板载24-32G)装个Ollama跑7B-9B做离线备胎就够了,这轮完全不用花新钱。
已持有395的人:别急着高位套现,先把模型换成MoE、量化用上新方案(27B从20t/s优化到40+是本周社区验证过的),这台机器的价值在"最廉价大显存",不在二手溢价那一两千。

最后留五个观察信号,决定这条线接下来三个月的走向:①10月RTX Spark的实际价格与128GB版供货;②智谱ZCode承诺的开源是否兑现、能否通过第三方审计;③DRAM行情——它同时决定395整机和DGX Spark的下一步涨跌;④DeepSeek V4.x、Qwen3.8系列的量化生态更新,直接改写"128GB能干什么"的答案;⑤DGX Spark租赁服务的定价,会不会成为体验集群的第三条路。
本地大模型这场戏,迷你主机已经从观众席挤上了舞台。只是舞台票很贵,先算账,再入场。