9月中旬开始,B站本地大模型分区出现了一波很密集的DeepSeek Harness(圈内简称DSH)教程:从8月16日的"五分钟速通",到9月14日"无需API免费用DSH写代码",再到9月19日桌面版仓库公开、9月21日还有人在发本地构建部署实录——半个月里至少7条。把这条线推到最热的是UP主"我是阿众"9月16日那条保姆级教程:58万粉账号,播放28.8万、点赞9758、收藏7934。视频里,主Agent带着四个子Agent跑完一次跨专业资料审查,报出来的数字是:单次任务消耗334.6万Token,换DeepSeek V4 Pro云端API约15.7元;按每天40次、每月22天算约1.38万元,一年半就能把这台机器的成本赚回来。哔哩哔哩
同一时间线上,云端那边也不太平:9月11日那条冲到336万播放的"为什么GPT要暂停200美元Pro订阅"回答把话说得更狠——任何API折扣比例超过15倍的coding plan,只要被用满,毛利率都是负的。更早的8月,"OpenCode创始人说DeepSeek涨价不是为了亏钱,而是为了劝退用户"这个话题也跑出了192万播放。涨价焦虑叠上教程狂欢,"把Agent搬回本地"看起来像下一站。知乎知乎
但这条视频评论区点赞最高的一层楼(684赞、90条回复)只有一句话:“本地部署纯纯伪需求,除非你涉密”。哔哩哔哩
两边谁对?对一遍账。
这笔回本账里藏着一个没写出来的数字
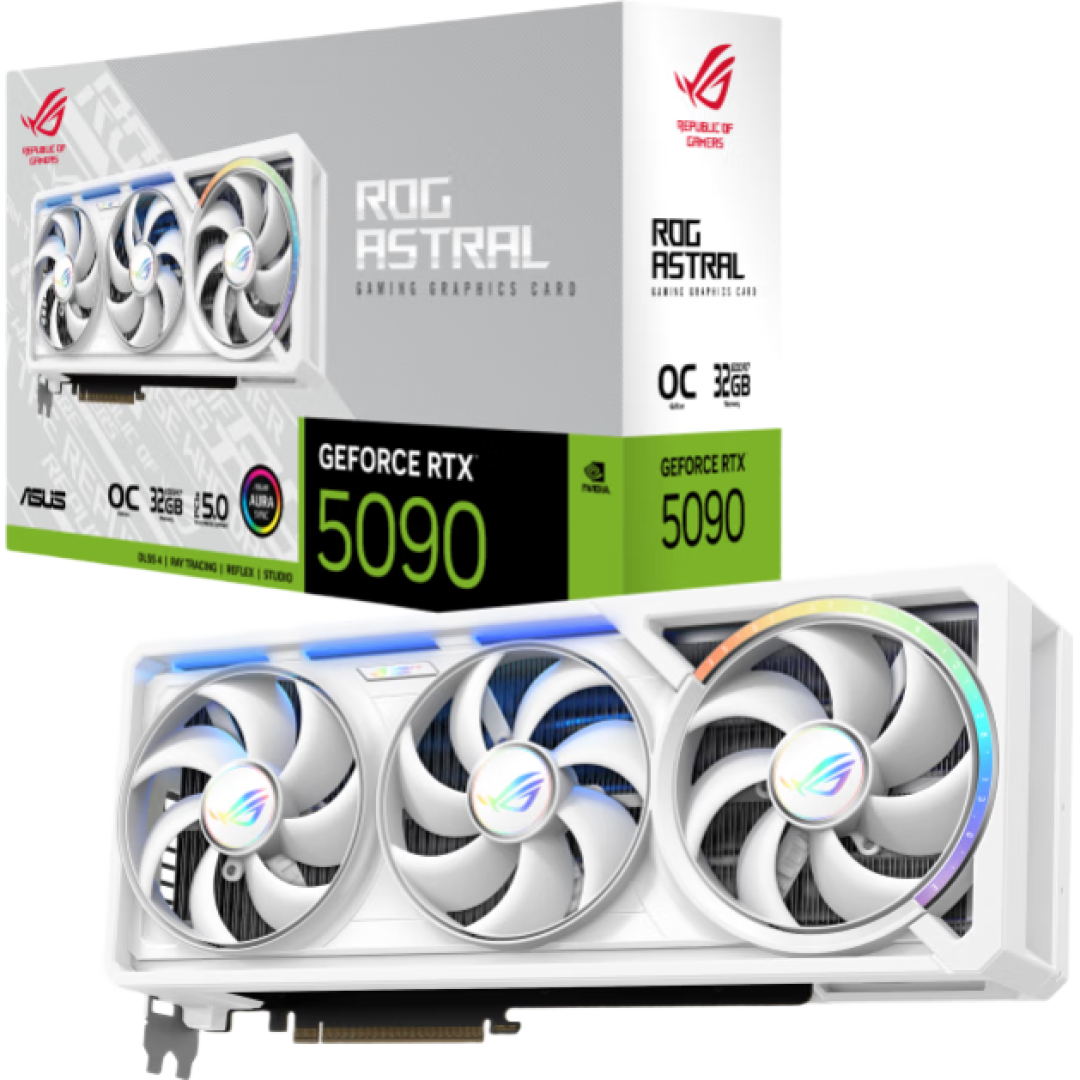
教程原文给了三个数:15.7元/任务、每天40次、一年半回本。这三个数相乘,反推出来的机器投入大约在25万元档位——这不是整机店配单,是工作站级别。同赛道9月19日那条被疯转的选卡视频给过对应档位:24G是7900XTX/3090、32G是4080 Super魔改、48G是4090魔改、96G要上RTX PRO 6000。评论区也有人接"Pro5000一张我记得是10万吧"。消费级这边同样不便宜:站内商品库9月21日的在售数据,RTX 5090档位到手价从2.6万元(ROG天猫25999元)一路排到4.4万元(华硕京东43999元)。UP主自己在9月18日的置顶补充评论里其实已经把前提说全了:“这种级别的工作站配置,一般用于多人的专业团队,而且是有极高隐私安全需求的,而且用的时间越频繁回本周期越短”。哔哩哔哩哔哩哔哩
也就是说,"一年半回本"成立与否,唯一的自变量是使用频率。同口径把任务量往下带:每天40次,15.7元×40×22≈1.38万/月,25万上下的机器确实约一年半抹平;每天只跑5次,月省约1700元,回本周期拉到十四五年;每天1次,约六十年。电费和折腾的时间都还没算。
所以那条684赞的"伪需求"和"一年半回本"这对看似互斥的观点,其实同时对——它们只是在给不同使用强度的人说话。
本地跑Agent,眼下卡在哪三处
一是token燃烧速度和出字速度的错配。多Agent是出了名的token黑洞,一篇任务334.6万Token起步,本地这边输出速度直接决定你一天能迭代几轮。16G阵营最近把下限又拱了一格:9月18日的KVMem方案视频(播放3.3万、收藏3042)给出了5060Ti 16G跑Qwen 27B、30~40 tok/s、256k上下文的实测,GitHub上的kvmem-llama.cpp已经更新到v0.16.0-rc3。但注意这条视频944条评论对比1663个点赞,以及9月19日那条只有38个赞、却堆出95条评论的小红书笔记"显卡16G,本地部署大模型干不了活"。16G到底"够不够干活",社区现在仍在吵,没有共识。哔哩哔哩小红书
二是能力及格线刚刚踩上。知乎"token自由"问题下9月8日的热门回答(263赞)给了一套判断:消费级本地部署"刚刚跨过及格线",qwen3.8 flash next的Q8量化约为国产模型五名左右的水平,电费已经低于token plan,但门槛是接近十万——两台DGX Spark或Mac M5 Ultra 256G才能舒服跑。换句话说,能用的门槛降到了"大几万",还没降到"一张显卡"。知乎
三是工程成本没人替你出。同一个UP主在补充评论里提到,他做了20人的并发对比测试,发现vLLM部署比LM Studio方式速度快了近2倍。工具链的选择本身就是一个坑位。想抄作业的人会发现:装完DSH只是开始,量化版本、KV配置、多卡并发,每一项都是学习成本。哔哩哔哩
谁该进,谁再等等
把账摊开之后,切片就很清楚了:
多人团队、数据涉密、日调用几十单起步:这笔账成立,而且云端涨价预期让它的边界还在变好。方案上直接按UP主实测走vLLM,别从LM Studio起步。
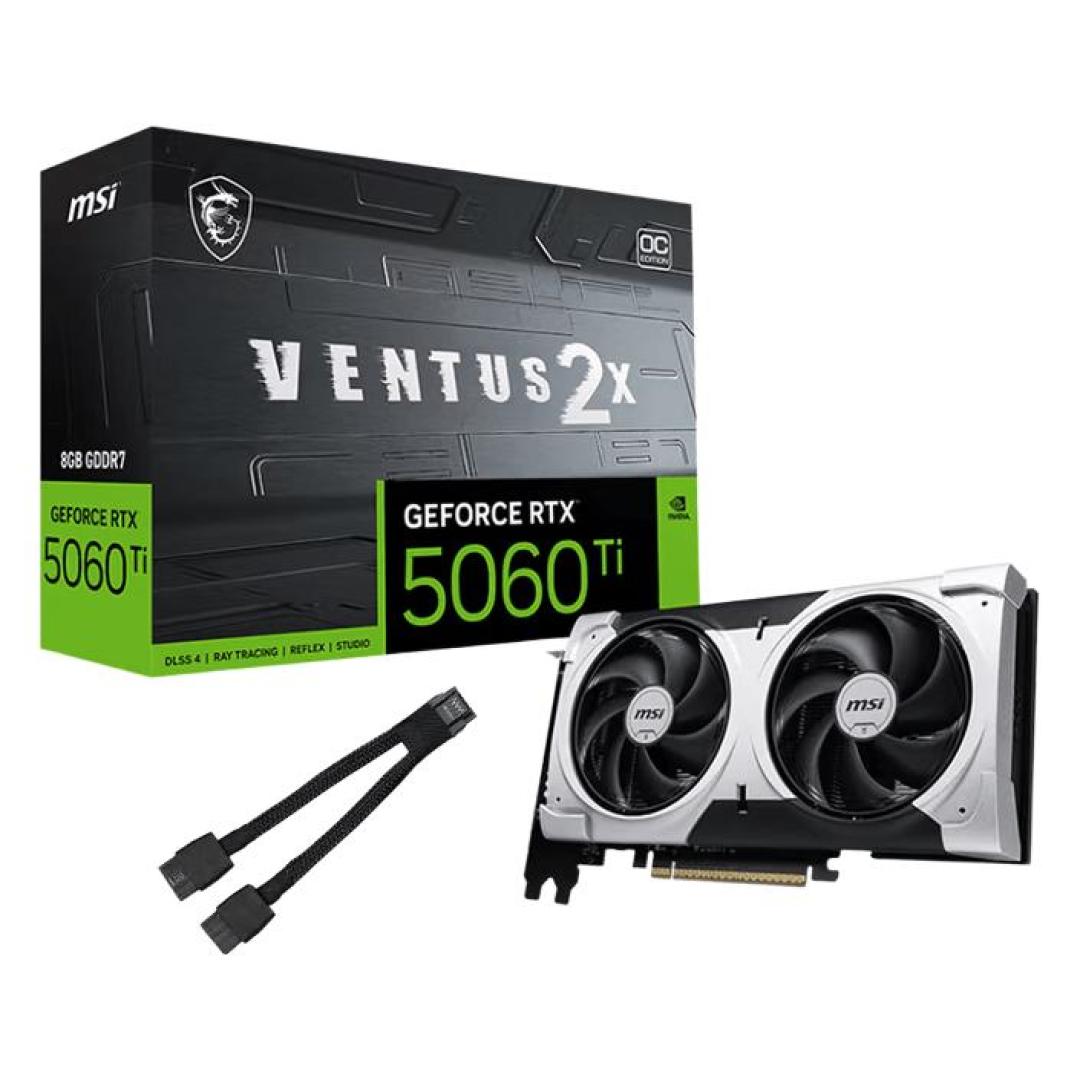
个人开发者、一天跑不满5单:先别上硬件。云端低价窗口实际还在——8月那波讨论里就有人提到,ollamacloud的20刀套餐里有差不多240刀的GLM5.2额度,这类套利型方案目前仍可选。而且此刻正撞硬件高价周期,站内商品库当前RTX 5060 Ti档位(微星京东3899元、华硕星辰OC京东4289元)的到手价还在往上走,现在上车等于给涨价周期接盘。知乎
手里已有16G卡的:KVMem这类方案拿来玩、跑轻任务可以,别指望它撑多Agent重度迭代,"30~40 tok/s"和"云端一来一回几秒钟"的差距是体感级的。
接下来值得盯的信号:DeepSeek V4.1 Flash开源后的本地部署成本——9月11日已有测试用EPYC双路+1T DDR4+两张3090做出CPU+GPU混合推理、30 t/s+,“没有高端显卡能不能跑"的问题正在被重提;DSH桌面版仓库的迭代节奏;以及云端各家订阅是否跟进GPT那波"收紧”。
这轮DSH刷屏最有意思的地方,不是"本地赢了还是云端赢了",而是社区第一次把一个问题问准了:本地部署从来不是立场,是使用频率的函数。账算到第几单回本,你就该在第几单之前留在云端。