现在写代码最爽的一步,已经不是写了,是写完不敢合。
AI 一晚上给你交三千行,早上打开 PR,第一反应不是「真快」,是「这里面藏了几个雷」。Anthropic 自己给过一组数:6 到 9 月合并进 Claude Code 代码库的 PR 翻了一倍多,回滚比例反而降了四成,办法是把大部分「读代码」的活交给机器。而 Claude Code 自己的代码大约九成由 Claude 写,人早就审不过来了。全行业都在补同一块短板:审。知乎
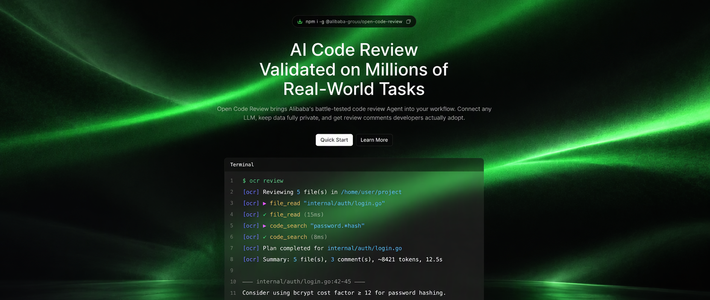
阿里把内部用了两年的代码审查工具开源了,叫 Open Code Review,命令行就一个词:ocr。开源半年,GitHub 已经攒到五万一千多星,11 月中旬单日还涨了近九百。知乎哔哩哔哩哔哩哔哩哔哩哔哩
它治的是三种病
把 diff 贴进通用 Agent 说一句「帮我 review」,大概率撞上三件事:改动一过两百行它就开始偷懒,只挑几个看着重要的文件审;报的行号经常对不上,说第 47 行有空指针,翻过去是条注释,真隐患在 152 行;同一个 PR 今天审和明天审不一样,提示词改几个字质量就飘。根子是纯语言驱动,对评审流程没有硬约束。知乎知乎知乎
该确定的事,别交给模型
ocr 把审查劈成两半。不能出错的交给代码:git diff 精确算变更范围,规则引擎决定审哪些文件,关联文件打包成一个评审单元——message_en.properties 和 message_zh.properties 必须一起看,每个单元再跑一个上下文隔离的子 Agent 并行审。规则按文件类型配,MyBatis 的 mapper XML 重点查 SQL 注入和参数绑定,Controller 重点查参数校验和权限。知乎
流程外还挂了两个模块:定位模块把意见钉回正确行号,反思模块在评论发出前自检一遍,滤掉上下文误解产生的垃圾建议。需要动脑的才给 Agent:读完整文件、搜代码库、翻其他改动文件补上下文,提示词和工具集都是从阿里线上真实调用轨迹里蒸馏的,不是通用大而全那套。知乎
省钱的数字,和没被转发的那半句
官方基准 AACR-Bench 是自己建的:50 个热门开源仓库、200 个真实 PR、10 种编程语言,80 多位资深工程师标出 1505 个真实问题,数据集公开在 Hugging Face。知乎知乎
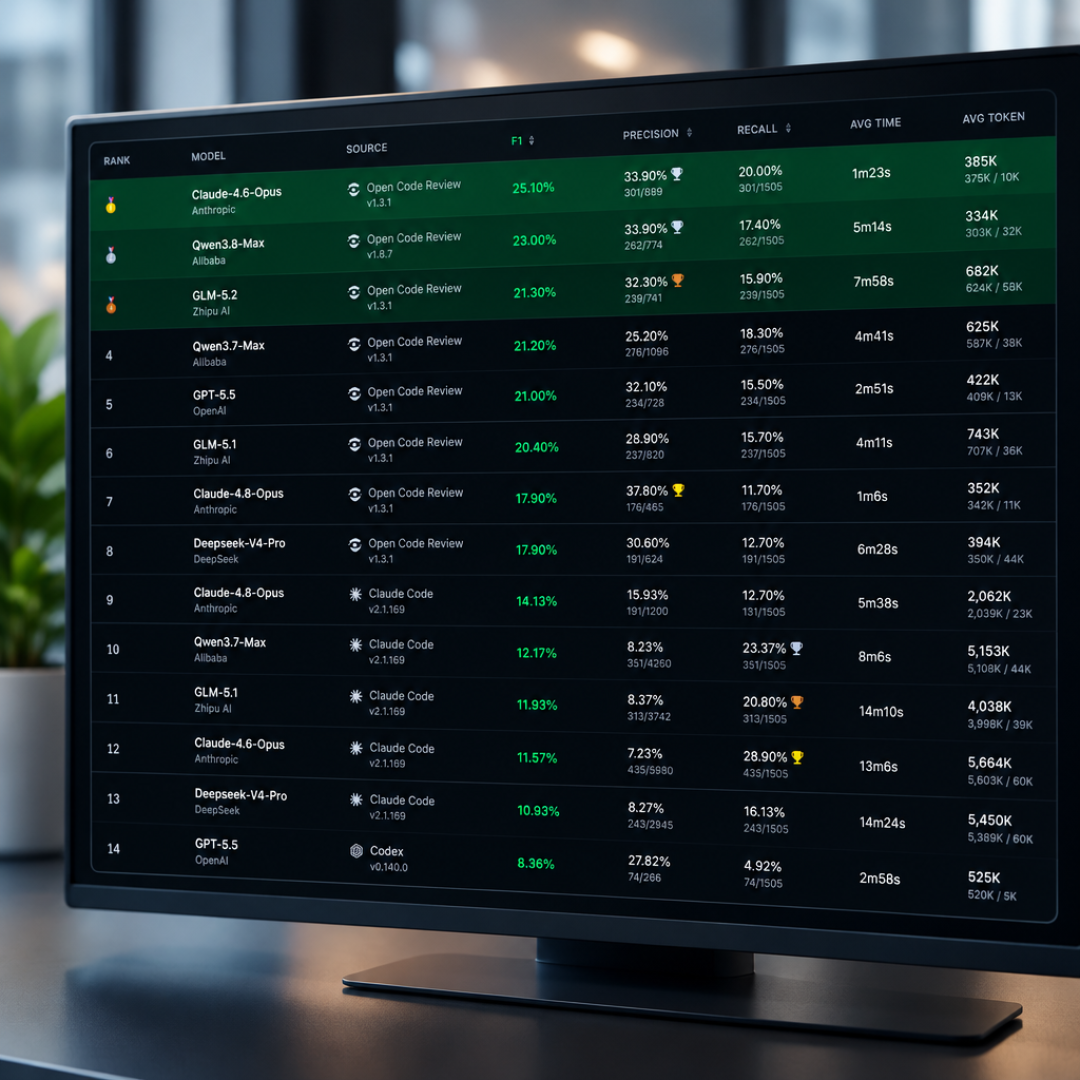
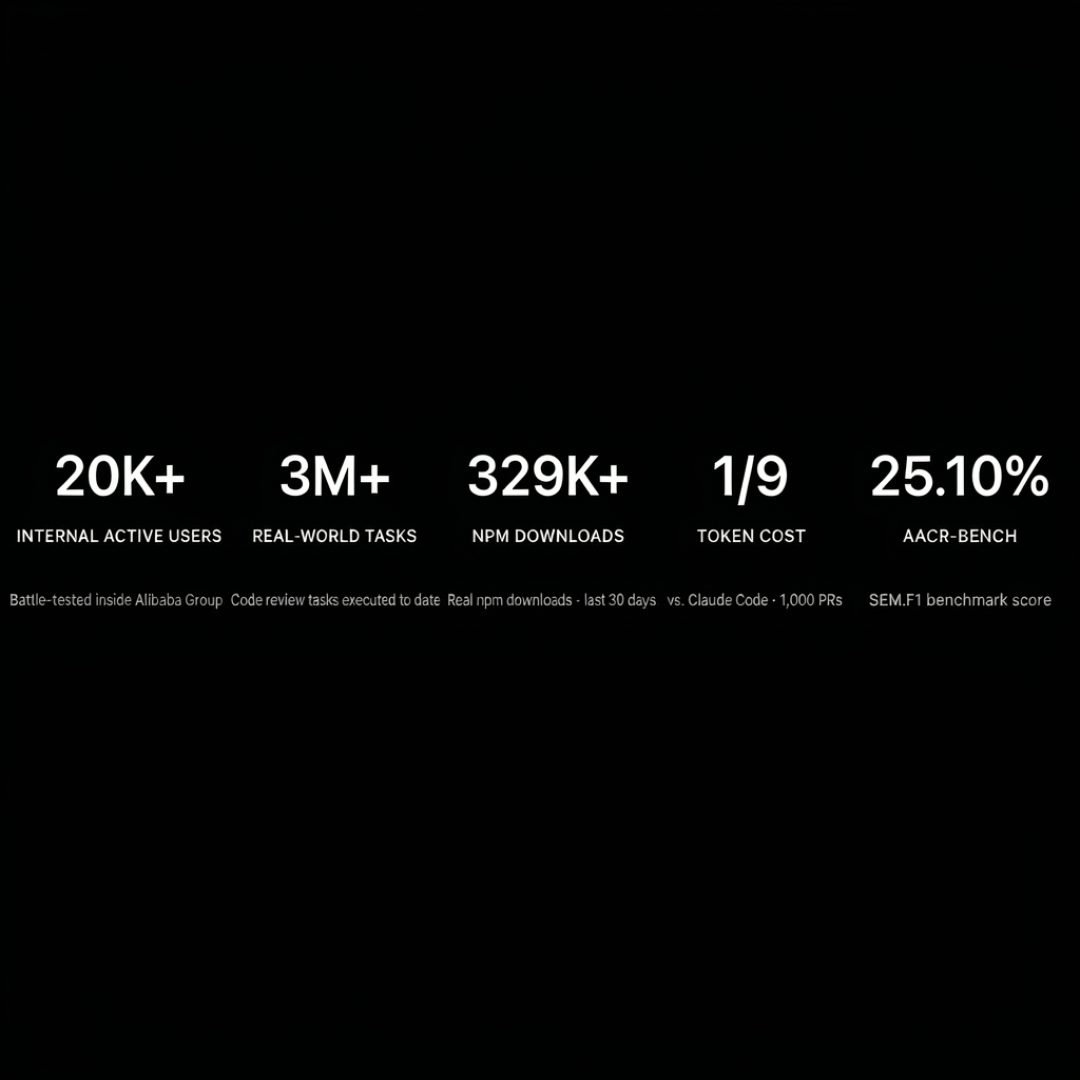
结论是同一个底层模型下,精确率和 F1 明显高于通用 Agent,token 只花约九分之一,速度还更快。同一段话还有半句,很多转发没带:召回率更低,而且是刻意的——宁可少报,也别天天打扰你。官方给的 F1 绝对值只有 25.10%。这数字本身也说明 AI 审代码整体还很早期。知乎哔哩哔哩知乎哔哩哔哩知乎
还有两句提醒。第一,基准是项目自建自评、口径自定义,别当第三方独立评测引用。第二,说 token 只要九分之一,实测大 PR 消耗却不低,Agent 要读完整文件、多轮搜库。省是相对通用 Agent 省,绝对值照样花钱。知乎知乎
怎么试,谁别用
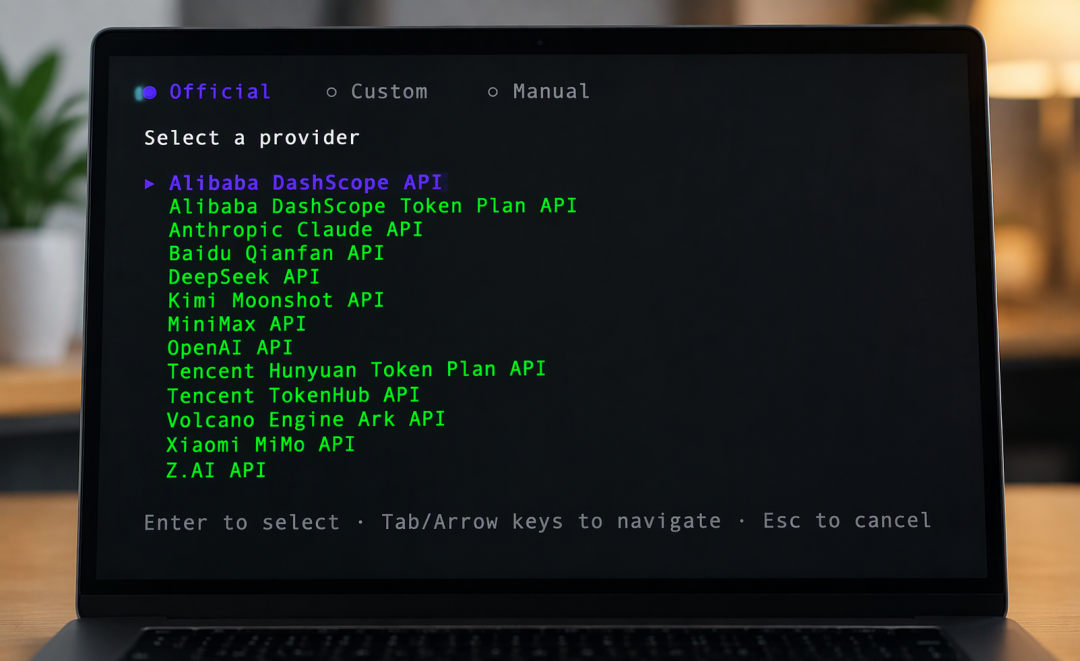
前置只有 Git 2.41+,一行装完:npm install -g @alibaba-group/open-code-review。ocr config 配模型,内置 13 个服务商,DashScope、Kimi、DeepSeek、火山方舟、Z.AI 都在,兼容任何 OpenAI / Anthropic 格式接口。第一遍建议先在一两个不重要的仓库上跑,把它的输出和你自己的人工评审对一遍,再决定要不要接主仓。知乎知乎
最省事的是委托模式:让宿主助手自己去跑评审,ocr 只管选文件和定规则,连 Key 都不用单独配。知乎哔哩哔哩
三种跑法:ocr review 审未提交改动,–from/–to 审分支差异,ocr scan 不看 diff 整份扫——接手陌生仓库先用它。ocr viewer 起本地 WebUI(5483 端口)看历史,进 CI 加 --format json。也能当 Skill 或插件装进 Claude Code、Codex、Cursor、Kimi Code。哔哩哔哩
别把它当唯一防线,它是第一道筛子,不是最后一道。大改动会拆成并行子 Agent 分块审,跨块问题——A 文件改了接口、B 文件没跟上——容易漏,这类情况 scan 比 review 靠得住。关键改动合并前,人还是得再看一眼。哔哩哔哩知乎
还有一条实操提醒:10 月底仓库就挂着 358 个未关闭的 issue 和 PR,社区提问题比维护者清得快,挑稳定版本用,别追 HEAD。知乎
阿里内部的说法是:引入之后人工评审量略有下降,有效风险发现量同比翻倍。它没让 AI 变得更会审代码,做的事更朴素:把不该由模型判断的那部分,从模型手里拿走了。知乎