















22
28
数据拼接接口:拼接成本的根因与可复用的估算方法
2026-11-16 11:35:56
0点赞
0收藏
0评论
问题复现
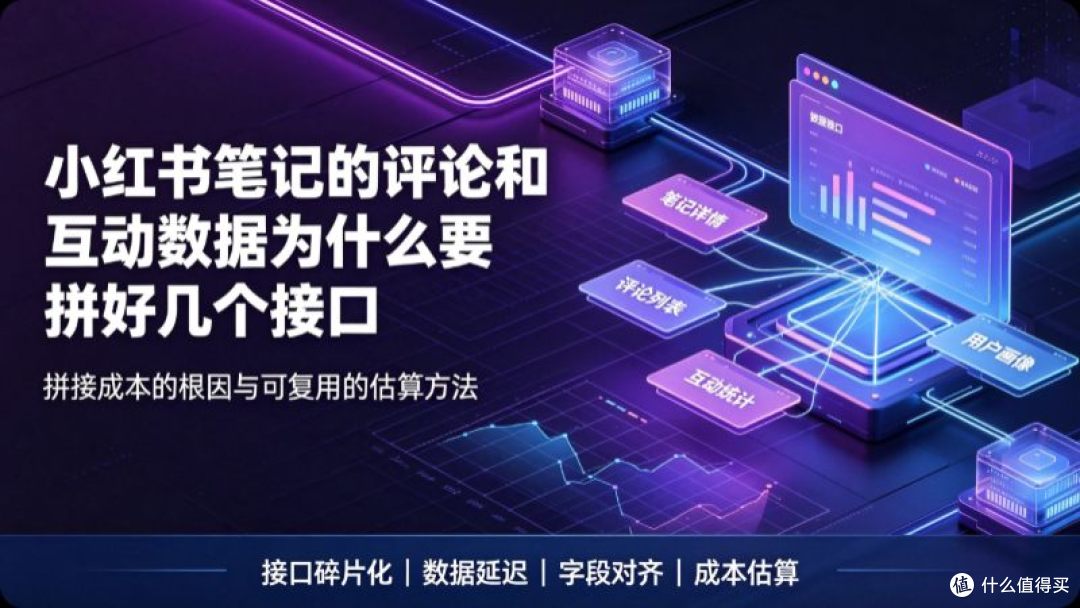
一个接入小红书数据的典型报错场景:你拿到了笔记详情的API返回,里面有note_id、标题、正文和基础的点赞/收藏数。然后你需要回答“这条笔记的评论区在讨论什么、二级回复的走向如何”。打开文档发现,评论列表是另一个端点,二级子评论和楼中楼回复还需要在一级评论的基础上“接力拉取”。GitHub上的小红书API项目直接印证了这个结构:笔记详情、一级评论、二级评论被设计为独立的读取入口,支持App V2、Web V2、Web V3多个版本的口径,评论分页还需要按热度或时间排序参数分别请求。如果你只按“一个笔记一个接口”来估算工作量,拼接层会在联调阶段直接吃掉进度。
根因拆解
这不是文档没写清楚的问题,而是数据模型的分层方式决定的。笔记本体、一级评论、二级评论在源系统中就是不同层级的实体,它们的读取路径天然分离。更隐蔽的成本在于:互动数据(点赞、收藏、评论数)可能在笔记详情端点中返回,但评论的增量变化需要轮询评论端点才能发现;不同端(App V2 / Web V2 / Web V3)的同名字段可能存在口径差异,直接拼接会导致同一个指标在不同批次之间对不上。Apify上的小红书API将“笔记搜索与评论、回复”列为不同的能力模块,也侧面说明“一次调用拿全”不是这个生态的默认交付方式。
可复用的拼接成本估算方法
不要按“接口数量”估算,按关联深度估算。第一层:笔记详情本身(1次调用)。第二层:该笔记的一级评论(至少1次分页调用,分页数取决于评论量)。第三层:一级评论下的二级回复(每条需要回复的一级评论至少触发1次调用,这是成本非线性增长的来源)。如果还需要互动指标的变化而非截面,需要在时间维度上重复上述链路。一个可落地的粗略公式:单篇笔记的单次完整讨论结构拉取成本 ≈ 1 + 一级评论分页数 + 有回复的一级评论条数。边界条件:如果业务只需要“评论总数”而不需要评论内容,拼接成本大幅下降,不应套用这个公式。
下一步
如果你的场景需要的是单接口同时覆盖详情与互动维度,可以查看本站关于小红书数据接入的案例记录,其中包含多接口拼接与单接口覆盖的成本对照。如果你的场景只需要评论内容做语义分析、不需要分钟级增量,按上述公式估算后,可能多接口拼接的总成本仍然低于切换供应商的迁移成本——这个判断需要按你的实际评论量级来做,而不是一概而论。