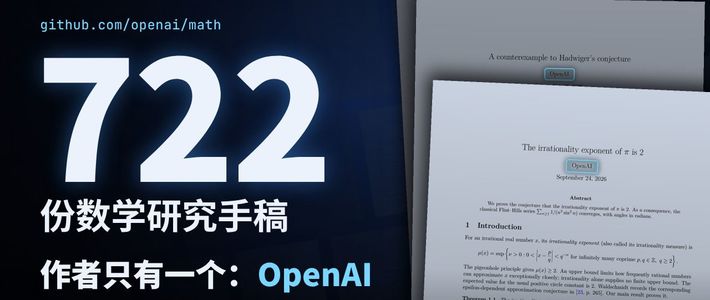
北京时间10月7日(美国时间10月6日),OpenAI把一个内部未发布模型的数学成果整体推上了GitHub:一次放出722篇数学手稿,按结果相关性归为372个“结果族”,涵盖理论计算机科学、数论、几何等17个领域。 OpenAI一方的说法是,这批成果解决了300多道人类此前没攻克的数学难题。 而OpenAI仓库README里能对上的口径是:模型在评测中被喂了约4000道开放问题,平均每项成果用掉三小时ChatGPT Pro级别的思考算力。新浪科技知乎GitHub
发布第二天,一处符号错误导致3篇手稿被撤回、14篇修订。 把这些口径摆在一起,标题里的问题就有了一个初步答案:AI批量压价的,是“给出一个答案”这一环;被批量抬价的,是验证、理解、提出问题、传递理解——这四件事,眼下几乎全部落在人这边。GitHub
声称的成绩单,和能对上的数字
先分清三个数:722是手稿数,372是结果组数,“题”又是另一回事——README写得明白,一个结果组里可能装着主定理、配套论证、推论和不同证明方案,哪个数都不能直接读成“解决了多少道难题”。GitHub
宣称里最重的几项,确实都戳在现代数学的地标上。数论方向,手稿声称证明了“准黎曼猜想”,即ζ函数及相关L函数在某个固定半平面内不存在非平凡零点。 几何方向,一篇175页的手稿声称推进四维挂谷猜想——今年夏天,王虹刚因为挂谷猜想的三维版本拿了菲尔兹奖。 但据数学学者卢健龙逐项核对,这份079号手稿声称证明的只是三维欧氏空间半波方程在严格参数范围与维数限制下的特定估计,并非所有版本的局部平滑猜想,更不能不加限定地说“AI解决了挂谷猜想”。DeepTech深科技果壳知乎
机器检查过,不等于人类看懂了
发布次日的撤回,是理解整场风波最好的入口。仓库更新记录写明:一篇关于分裂阿贝尔八叠簇上Weil类代数性的手稿里,一个符号错误让一步关键的迹抵消不再成立,连带依赖同一构造的两篇一起倒下——其中包括那篇“K3曲面乘积上的有理霍奇猜想”。 仓库目录随之从722变回719,372个结果组一个没少——被撤掉的是三篇稿子,不是一个结论。GitHubGitHub
OpenAI给出的补救是Lean形式化,把命题和证明写成机器可逐行核查的代码。README承认,未完成形式化的结果可能存在问题。 果壳核到的时点口径是,截至10月10日约42%的结果通过了这种机器检查。 一个符号能塌掉一条依赖链,这恰恰是模型自己兜不住的部分。GitHub果壳
机器核查本身也有盲区。其一是命题对齐:程序只能证明它拿到的那句话,这句话与论文宣称的原题是否一回事,得有人读代码核对——负责Lean数学库的科梅林就怀疑,有些形式化版本证明的其实是更弱的命题。果壳
可读性是另一道坎。长期深耕唯一博弈猜想的莫什科维茨拿到OpenAI的同题论文后发现,全篇充斥着难解的构造和含糊的步骤,晦涩到必须借助AI工具才能勉强读下去。 口径之乱也有注脚:媒体把准黎曼那条线报道为“实部大于7/8的区域无零点”,而README里经人工编辑的那份write-up对应的却是Re(s)>11/12——连精确表述都要人工来钉。 数学界普遍的估计是,把这批手稿真正弄明白要花好几年。 于是出现了颇具反讽意味的一幕:按OpenAI自己的算力口径,生产平均三小时一项;检验它们的劳动,才刚刚开始向全人类分配。DeepTech深科技GitHub果壳
数学界在抵制什么:不是能力,是“批发”
10月7日,陶哲轩在博客全文转载“人类数学协会”(AHM)的声明,后者认为数学家并没有要求做这些工作,并敦促同行停止与OpenAI合作。 更早的9月11日,28位菲尔兹奖得主(含陶哲轩、Scholze、June Huh与2026年新一届得主邓煜)联署发表宣言,指出批量生产真值判断可能毁掉新思想赖以生长的土壤。 陶哲轩自己的概括是:当下这个“过度强调用AI自动解决开放问题”的状态,正是需要走向“Math 2.0”的原因——让AI工具既服务数学共同体内部,也服务数学理解在真实世界的落地。人类数学协会Math and AI陶哲轩博客
但数学界并非铁板一块。宣言联署者之一的海雷尔认为,数学家拒绝与AI公司接触,也就很难影响这些公司的行为。 多伦多的利特转述合作者的感受是“我爬了一辈子,现在能飞了”,自称对AI最乐观一档的阿姆斯特朗,对策则是趁OpenAI还没抢在前面,先把手头研究做完。 OpenAI方面则承诺出资赞助研讨会与学术会议,帮数学界消化这批成果。所以争议的真正焦点从来不是“机器能不能证出定理”,而是:哪道题先做、什么时候发、成堆的证明由谁来读——议程和消化成本的分配权,正在从学术共同体滑向一家商业实验室。陶哲轩把这比作露天开矿,把未解问题的矿脉成片挖光;而难题被攻克后证明者做报告、同行开研讨班、新方法被简化进教科书的传递链,几乎不再发生。DeepTech深科技果壳
冲击最先落到年轻一代头上:发布之后,身边一批同行的经费申请一夜之间作废,也有人开始把有前途的方向藏起来,生怕被模型抢先。果壳
剩下的四件活,恰好都不是“给答案”
第一,判定对错。符号错误的复核、从约42%向更高比例爬升的形式化工作、验证命题与原题是否同一回事,只能由领域专家一篇一篇做。菲尔兹奖得主迪米尼-科潘说他正在研究AI声称已解决的16个问题,因为涉及海量理论和数据,验证工作量巨大。 答案变便宜之后,验证不但没有消失,反而因答案变多而变贵。知乎
第二,把“真”变成“懂”。数学家洛扎诺-罗夫列多替整个行业的年轻人问出了那个最直接的问题。 他自身的状态是反证之一:大模型接入后,他的研究项目在几个月里翻了三倍,正招募比以往更多的学生——忙的方向从“产出答案”移向了“消化答案、开辟新问题”。陶哲轩博客
第三,提供凸包之外的想法。这是目前分歧最大、也最有分量的一条假说:吉伦(Nestor Guillen)提出的“想法凸包”模型认为,LLM在人类已有文献的概念集合内做连接组合——埃尔德什单位距离猜想的反证足够巧妙,但被伍德评价为换一批同等专长的人提前一个月也能找到,它没有越出人类知识的多面体;而像黎曼猜想本体这样的目标,可能需要先由人引入凸包之外的新顶点,模型才填得出新的部分。 必须说清楚:这是假说,不是已证实的边界。这次发布里出现的熵方法跨尺度证明架构,至少让一部分研究者承认,AI在组织新证明,而不只是检索旧证明。陶哲轩博客
第四,决定“下一个做什么”。一个常被忽略的注脚发生在发布之后:OpenAI仓库里的#109号手稿(整数乘法复杂度)很快被人类研究者开成公开的社区仓库,由人维护、以“OpenAI第109号框架”为前提推进;几十个Codex与Claude智能体做暴力试错,24小时里把核心参数从近乎为零的起点一路拉升,而真正带来量级跃升的,是人类引入的E8格点几何构造。 AI蜂群不睡觉,但给蜂群指方向的是人。新智元
接下来看什么
这722篇手稿没有一篇经过同行评审,也没有人类作者署名。果壳
OpenAI没有停下来的意思:它表示会继续拿数学问题测试内部模型,数学圈里已在传下一批手稿。 所以“人类脑力劳动还剩多少价值”没有终局答案,只有三条可观察的线:形式化比例能不能爬上去,撤回记录会不会再变厚,下一批发出来时学界接到的是“讲得清”的结果、还是又一次核爆式倾倒。果壳
真正被“攻克”击中的从来不是脑力劳动本身,而是其中“人肉搜索与证明打字机”的那部分。剩下的活——判断答案可不可信、把答案变成能传递的理解、决定下一个问题值不值得提——不但没有贬值,正在批量涨价,只是不再按产出计价,而按理解计价。至于学生现在该怎么办,那篇被陶哲轩转载、写给学生看的长文,开头一句话就给了结论——保持冷静,继续学数学。陶哲轩博客