今天早上,36氪转发了开智学堂的一篇文章,介绍《自然·人类行为》(Nature Human Behaviour)新刊发的一项实测研究:团队前后分析了88万多篇文本,结论一句话能说清——越多人把稿子交给AI润色,所有人的文章就越像同一个人写的。36氪
几乎同一时间,知乎上"怎么看待现在知乎小说多了许多AI味道浓重的小说"这个问题下,一天之内又多了好几条新回答。小红书上,"如何让自己看起来像AI生成的"这条反向玩梗的笔记拿下了15万赞。一个用语言学方法"量化AI味"的GitHub"去AI味"skill仓库,最近在微博被反复转发。知乎小红书微博
"AI味"已经从创作者圈子里的黑话,变成了全网议题。对天天用AI起稿、润色的人来说,这不是看热闹的事,而是三个很实际的问题:我的稿子会不会被读者和平台嫌弃?网上疯传的"去AI味提示词"到底管不管用?论文的AIGC检测会不会把我拦下来?这篇文章把研究、平台规则和社区里吵出来的经验放在一起说清楚。
一、88万篇的研究到底说了什么:AI没有把文章变差,而是把文章变"平均"了
先说这项研究做了什么。南加州大学"道德与语言实验室"德加尼(Morteza Dehghani)团队追踪了三个英语平台2018年以来的文本:arXiv的8万篇论文、美国地方新闻网Patch的38万篇报道、Reddit写作接龙版块的31.8万个故事帖,合计约78万篇。他们统计的不是"写得好不好",而是语言多样性——词汇有多丰富、罕用词有多少、句子铺得有多开,然后看人与人之间的差异(方差)怎么变。36氪
以ChatGPT发布的2022年11月为断点做统计检验,三个平台的方差在断点之后都持续下降。通俗点说:不是平均水平垮了,是"大家写得不一样"这件事本身在萎缩。其中地方新闻网Patch在发布当月就显著下落,arXiv和Reddit是此后逐月缓慢收窄;在arXiv和Reddit上,前几个月AI参与比例越高,后几个月方差收缩越明显——当然,这只是时间上的前后相随,谈不上谁造成谁。开智学堂
相关不等于因果,所以团队又做了受控实验:从ChatGPT面世前的人写文本里,Reddit和arXiv各抽1000篇,交给GPT-3.5、Llama3 70B、Gemini Pro三款模型,用12种常见提示词各改一遍。结果有三层:36氪
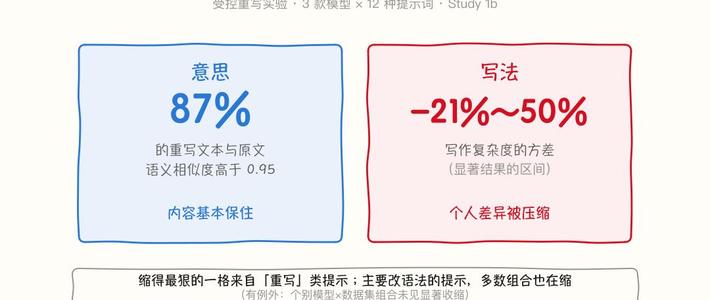
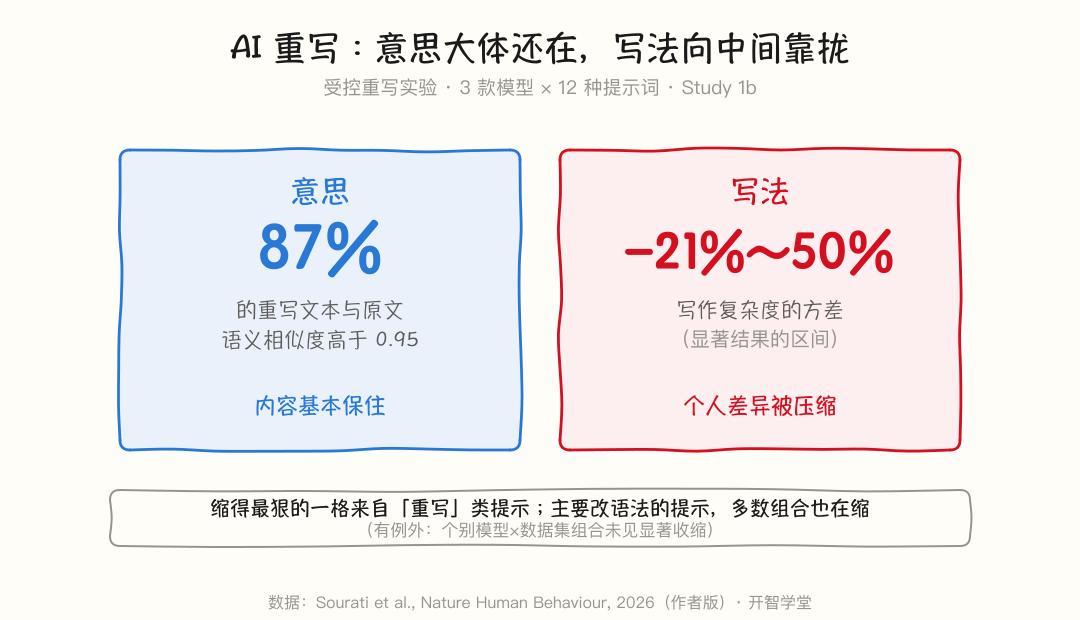
第一层,意思基本没动。87%的文本语义相似度高于0.95,四位作者人工盲评平均2.97分(满分3分,3分是只有细微差别)。AI确实没改你想表达的东西。开智学堂
第二层,写法显著趋同。写作复杂度方差缩小了约21%到50%,缩得最狠的一格,来自"换个说法"类提示。更需要注意的是:哪怕提示词明写了"只改语法、不许改变原意",多数模型与数据集组合的方差仍在收缩。你以为只是让它挑错别字,它顺手把你的措辞习惯也抹平了一点。36氪
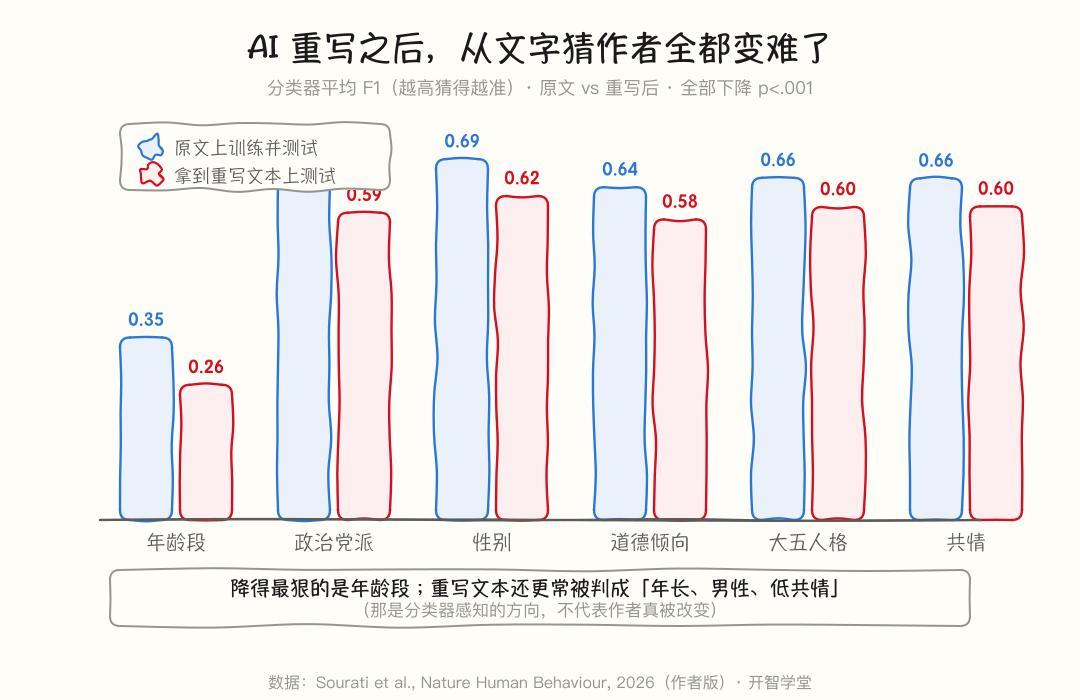
第三层,"你"的痕迹变淡了。团队用在先人写文本上训好的分类器去猜作者属性——年龄、性别、政治党派、大五人格、共情水平、道德倾向,六类标签在AI重写后的文本上预测成绩全面下滑,且都大到不可能由抽样误差造成(p<.001)。猜年龄的F1从0.351掉到0.260,猜性别从0.694掉到0.623,猜党派从0.664掉到0.591。而且误判不是乱偏,是集中往一个方向偏:改过的文章更容易被判成出自"年长、男性、道德关切更高、共情更低、更不外向"的人。开智学堂
一句话总结:按下"润色"键时,模型改掉的可能不只是病句,还有那些用来辨认"这是你写的"的统计线索。
这项研究的边界也要说清楚:语料以英语为主,中文互联网是否同样、程度如何,论文没有检验;平台时间序列只能证关联,排除不了同期平台规则、作者构成变化;批量重写模拟的是润色场景,不是真实用户那种"拒绝建议、改完再改"的编辑过程。结论的强度,只能说到这里。36氪
二、全网已经在为"AI味"打架:读者反胃、平台判"数据死刑"、检测红线误伤
读者端的嫌弃已经摆到台面上了。知乎本周那个"AI味小说"问题下,有条回答的比喻是这么说的——十分钟看了三篇,感觉像连喝三杯代糖奶茶:甜是甜的,但舌头知道不对。微博上有读者吐槽热度很高的长文ai味浓重,起手就是"不是……而是……",还有一堆奇怪的比喻以及很伪人的断句习惯。lof(老福特)同人文圈甚至出现了"AI恐惧症"的说法——看过一篇AI味重的,后面连着几篇都疑心。知乎微博
还有一类沉默的裁判:小红书上一位老师发帖"AI味很浓又不敢问学生",拿了近4000赞、1000多条评论。AI味正在变成一种信任成本——读者不确定你是不是糊弄他。小红书
平台端,一位公众号运营者的复盘值得细看。他上个月自己敲了三遍的稿子被留言"这篇是AI写的吧",反而用工具生成、十分钟顺完的那篇没人提。他查完的结论是:公众号目前没有"使用AI写作"本身的处罚规则,机器初筛和人工复核盯的是洗稿、搬运、虚假信息这些行为违规;真正让AI味稿子死在半路的是第三步——推荐系统看完读率、跳出位置、互动率:AI味的稿子,读者通常撑不过第二屏,这时候不是被检测出来了,是被数据判了。他还补了一刀:纯人工写的模板文,流量一样差,逻辑相同。也就是说,平台惩罚的不是"你用了AI",是"你的内容里没有一手信息"。知乎
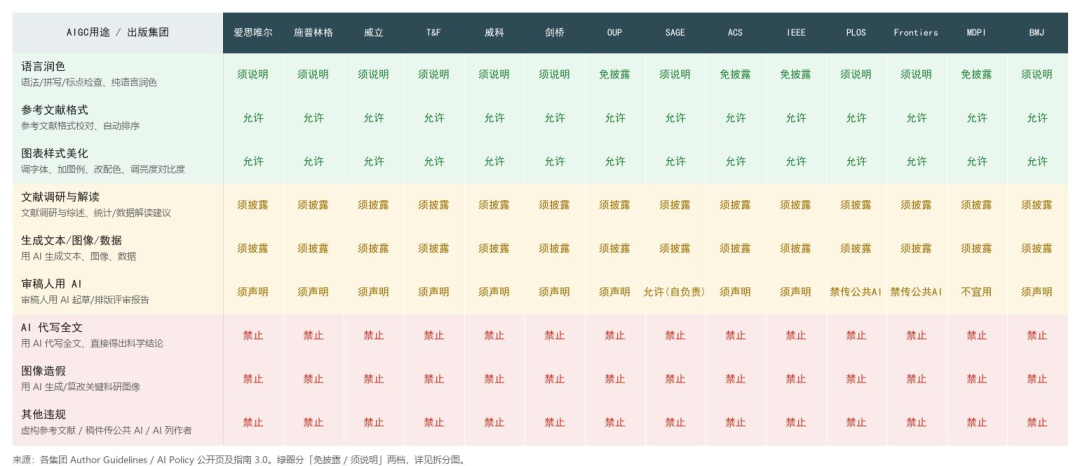
检测端的情况更拧巴。高校和学术期刊普遍把"AIGC检测占比20%"设为稿件自动拦截红线,但有实证讨论指出一个悖论:行文严谨、表述规范的科研作者,反而极易被算法判成AI;而AI写作真正的隐患——虚构文献、伪造数据——却能顺利通过统计检测。国际上,Frontiers、Elsevier、Nature/Springer Nature、Wiley、Taylor & Francis等出版集团2026年密集更新AI披露规则,方向趋同:主动披露AI用在哪,合规;隐瞒,才是问题。知乎知乎
三、反常识:你抄的"AI味常识",一多半没有区分度
创作者端是另一个战场,也是智商税最密集的地方。小红书上"GPT5.2去ai味:从92%到0%"这类提示词笔记收藏量近8000,"300+文章去AI味指令"满天飞。微博上有博主教,只要跟AI说用70年代的人写文章的语调,AI味就淡很多(992赞、195转)。最硬核的是那个刷屏的"去AI味"skill——作者用629篇文章、282.7万汉字、9.5万句构建对照语料,把公共讨论中26项"公认AI味特征"逐项算了生成侧与人类侧的频率比。小红书微博小红书
结果给两边都泼了冷水:
26项特征里,只有11项有明显区分度。区分力最强的是"段首零回指评论"(4.4倍)——就是不接上文、凭空来一句"这不是X,而是Y"式的开场评论,正是微博读者吐槽的那个"起手式"。小红书
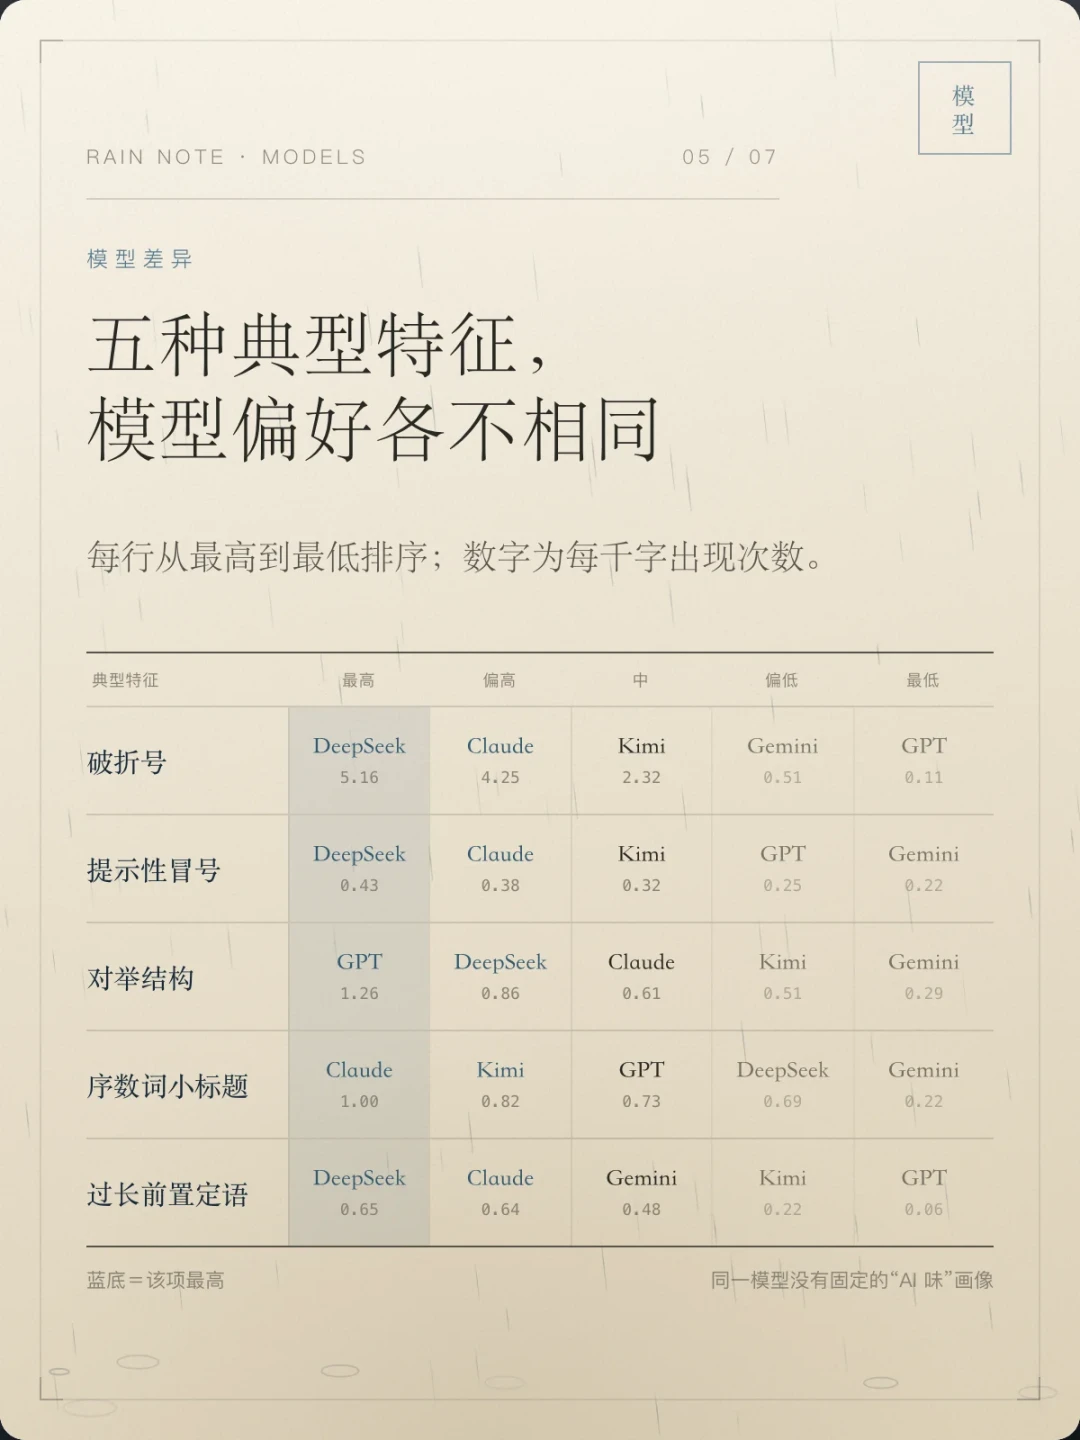
剩下15项没有区分力,部分方向还和流行认知相反:人类使用比喻的频率是生成文本的2.4倍,正文设问句是17倍,句内排比也高于生成文本。换句话说,"比喻多、爱反问=AI味"这条广为流传的常识,是错的。小红书
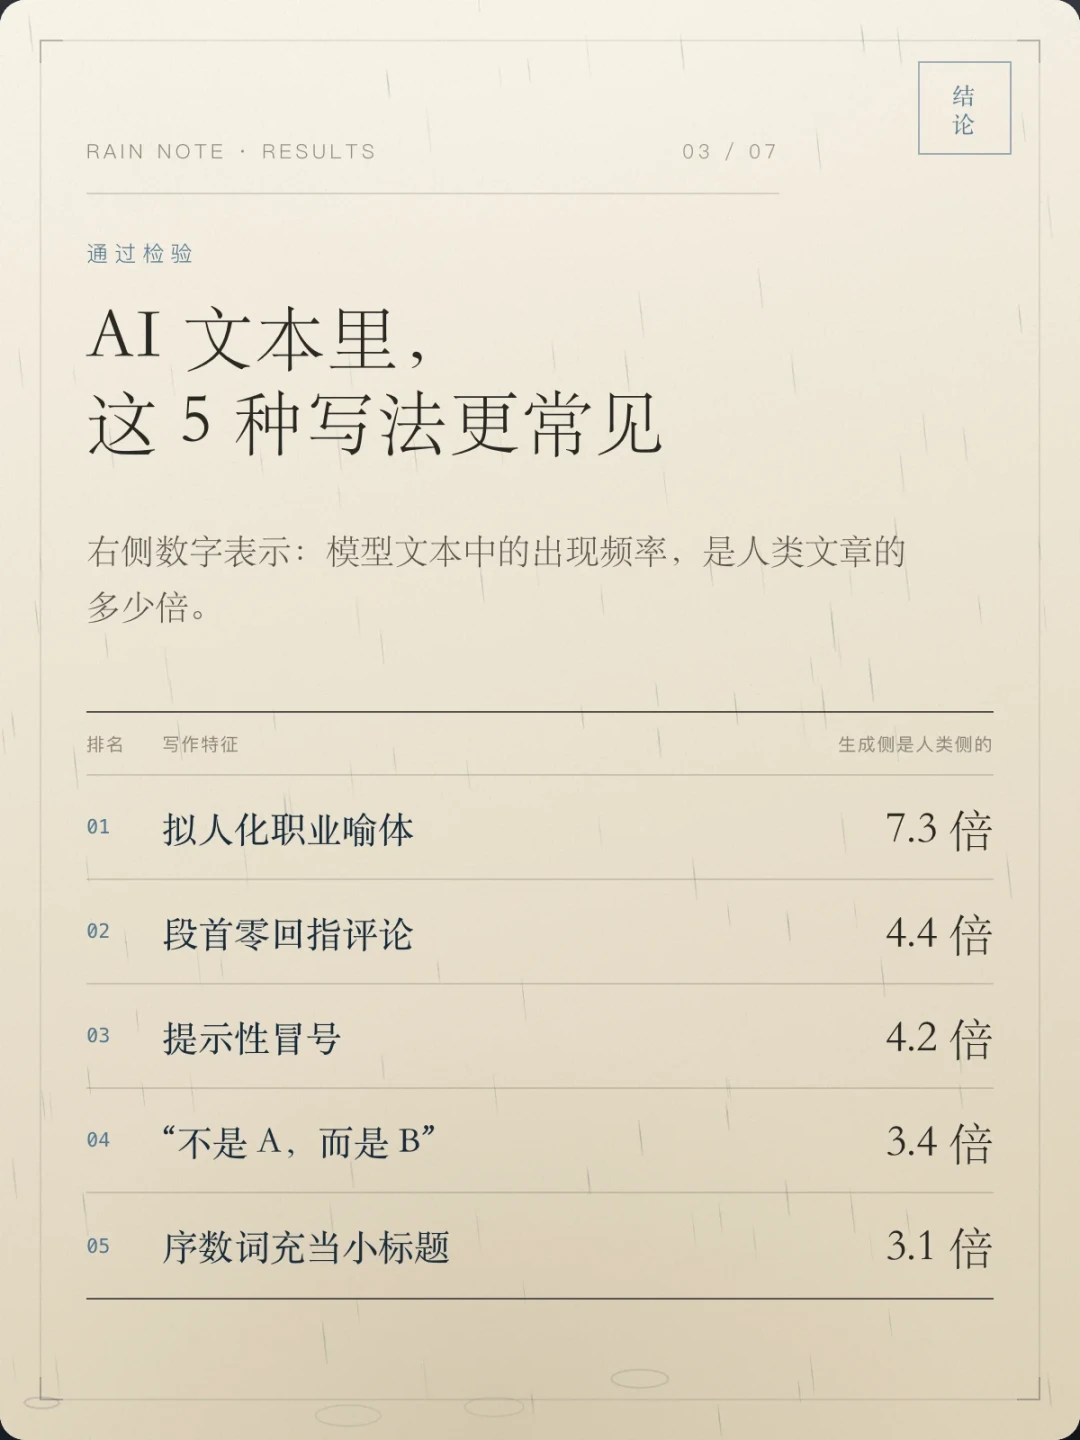
破折号也不能一刀切:DeepSeek每千字5.16次、Claude 4.25次,GPT只有0.11次,极差四十倍;提示性冒号最重的是DeepSeek与Claude,问句小标题最重的是Gemini。所谓"AI文风"不是一个味道,是各家模型的"家味"混合——你去掉了破折号,可能只是从"DeepSeek味"调成了"GPT味"。
把这些和《自然》那项研究拼起来,能看到一个真正的悖论:研究显示方差收缩最厉害的正是"换个说法"类提示,而网上大多数"去AI味指令"(比如"替换所有连接词"“重写以下段落使其更自然”)本质上就是再让AI换一遍说法——用一层新的标准化,去盖旧的标准化。有小红书博主说得很直白:利用ai去ai味是个悖论,但是跟ai反着来很有效。小红书
四、真正管用的是三件事,不同人权重不一样
第一件:把AI拿不到的一手细节写回去。那位公众号运营者的对照实验结论最狠:他AI味最重的几篇稿子有个共同点——全篇没有一句只有写作者本人才能写出来的话,这比任何词汇特征都致命。他试过的所有方法里,对完读率提升最直接的一步,是塞入不可替代的具体细节:时间、数字、对话、失败过程。这和研究发现互为印证:AI磨掉的是你的统计习惯,但它造不出只有你有的信息。前者无解,后者是你手里唯一的护城河。知乎
第二件:提示词按风险分三档,别把"换个说法"交给AI。从低到高排:最低风险是让AI做格式和检索类工作(整理材料、列结构、查资料);中间档是明确、具体的修改指令(“第三段压缩三分之一”“把这两句合并”),改动范围你说了算;最高危的是"润色一下"“换个说法”"让它更通顺自然"这类开放式指令——研究里方差收缩最大的就是这一类。就算只想让它改语法,也建议看一眼改动清单再接受——研究显示,哪怕提示主要要求改善语法,方差仍在收缩。原则一句话:AI被允许改动的范围越大,你的习惯被冲掉的越多。36氪
第三件:黑名单要人工删,别指望提示词一键解决。经过运营者反复验证的是四类词,判断标准就一条——“正确、漂亮、但你平时根本不会说”:小红书
开头腔:“在这个快节奏的时代”“随着科技的发展”“众所周知”——一句信息都没有,直接删;
商务黑话:"赋能"改成帮/让,"抓手、闭环"改成方法/做完整,"底层逻辑"改成道理/原因;
升华句:“愿你我都能……”“遇见更好的自己”“唯有如此方能……”——不是每段都要金句收尾;
收尾句:"综上所述"改成所以,“总而言之”"让我们拭目以待"删掉,说完就停。
注意这一步要自己动手。让AI执行"删除所有过渡词"这类去AI味指令,等于又叠了一层新的模板。另外,故意加错别字、写病句去"骗"检测也没用——检测误伤的是模板腔,不是完美度,而病句只会让真人读者跑得更快。知乎
不同人,三件事的权重不一样:
学生(论文党):先别碰"降AI率"工具。知乎上扎堆的"降ai率神器测评"多为软文,那是和检测模型的军备竞赛,赢了检测输了质量。更稳的路径是跟着披露规则走——越来越多高校和出版集团要求说明AI用在哪些环节——数据、文献、论证过程保留一手,20%红线自然不是问题。知乎
自媒体/公众号作者:你的裁判不是检测模型,是完读率和读者信任。把AI省下的时间投进采访、查资料、补细节,让它干结构、排版、素材整理的活。只把AI稿洗一遍再发,读者第三篇就不点开了。知乎
职场写材料的人:材料越被"润色/升华",越像全网通用模板。让AI改语法、压长度没问题,但保留你自己的口语习惯、具体数字和办事细节——研究说的"统计线索",落在职场语境里恰恰是"这人真干过这事"的证据。
五、值得继续盯的三个信号
一是中文语料的复现研究。这项88万篇的研究以英语为主,中文没有词形变化、有成语和公文腔传统,"AI味"的形态和程度可能完全不同——目前那个282.7万字的民间skill算是最早的中文量化尝试,但样本还撑不起定论。二是平台规则的下一步:短视频平台已经给AI生成内容强制打标,图文平台(公众号、知乎、小红书)会不会跟进"AI内容限流"或强制标注,直接决定"AI味"是审美问题还是流量问题。三是那篇发表在《认知科学趋势》(Trends in Cognitive Sciences)上的观点文章提出的更远的问题:被压平的会不会不只是写法,还包括看问题的方式——训练过程天然让"高频、放哪儿都说得通"的表达胜出,少数派说法被淹没。这只是理论综合,还没有实证,但未来一两年如果出了验证数据,这场讨论的性质会变。小红书知乎开智学堂
最后问一句:你的稿子被怀疑过"是AI写的"吗?你是去自证清白,还是默默少用AI润色了?评论区聊聊你踩过的坑或者自证的办法——样本够多的话,下次我们专门拆一期"检测工具到底怎么判你的稿"。