9月初,B站UP主"探索未至之境"发了条视频,标题是反问句:《最适合国内订阅的token plan–Ollama Cloud?》。两周下来,108个赞,190条评论——评论比点赞还多,这个比例在本地AI圈基本等于"吵起来了"。
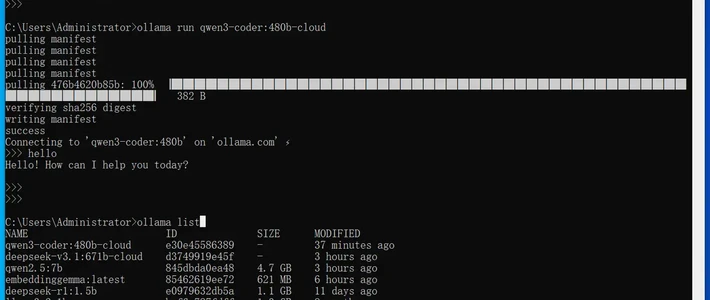
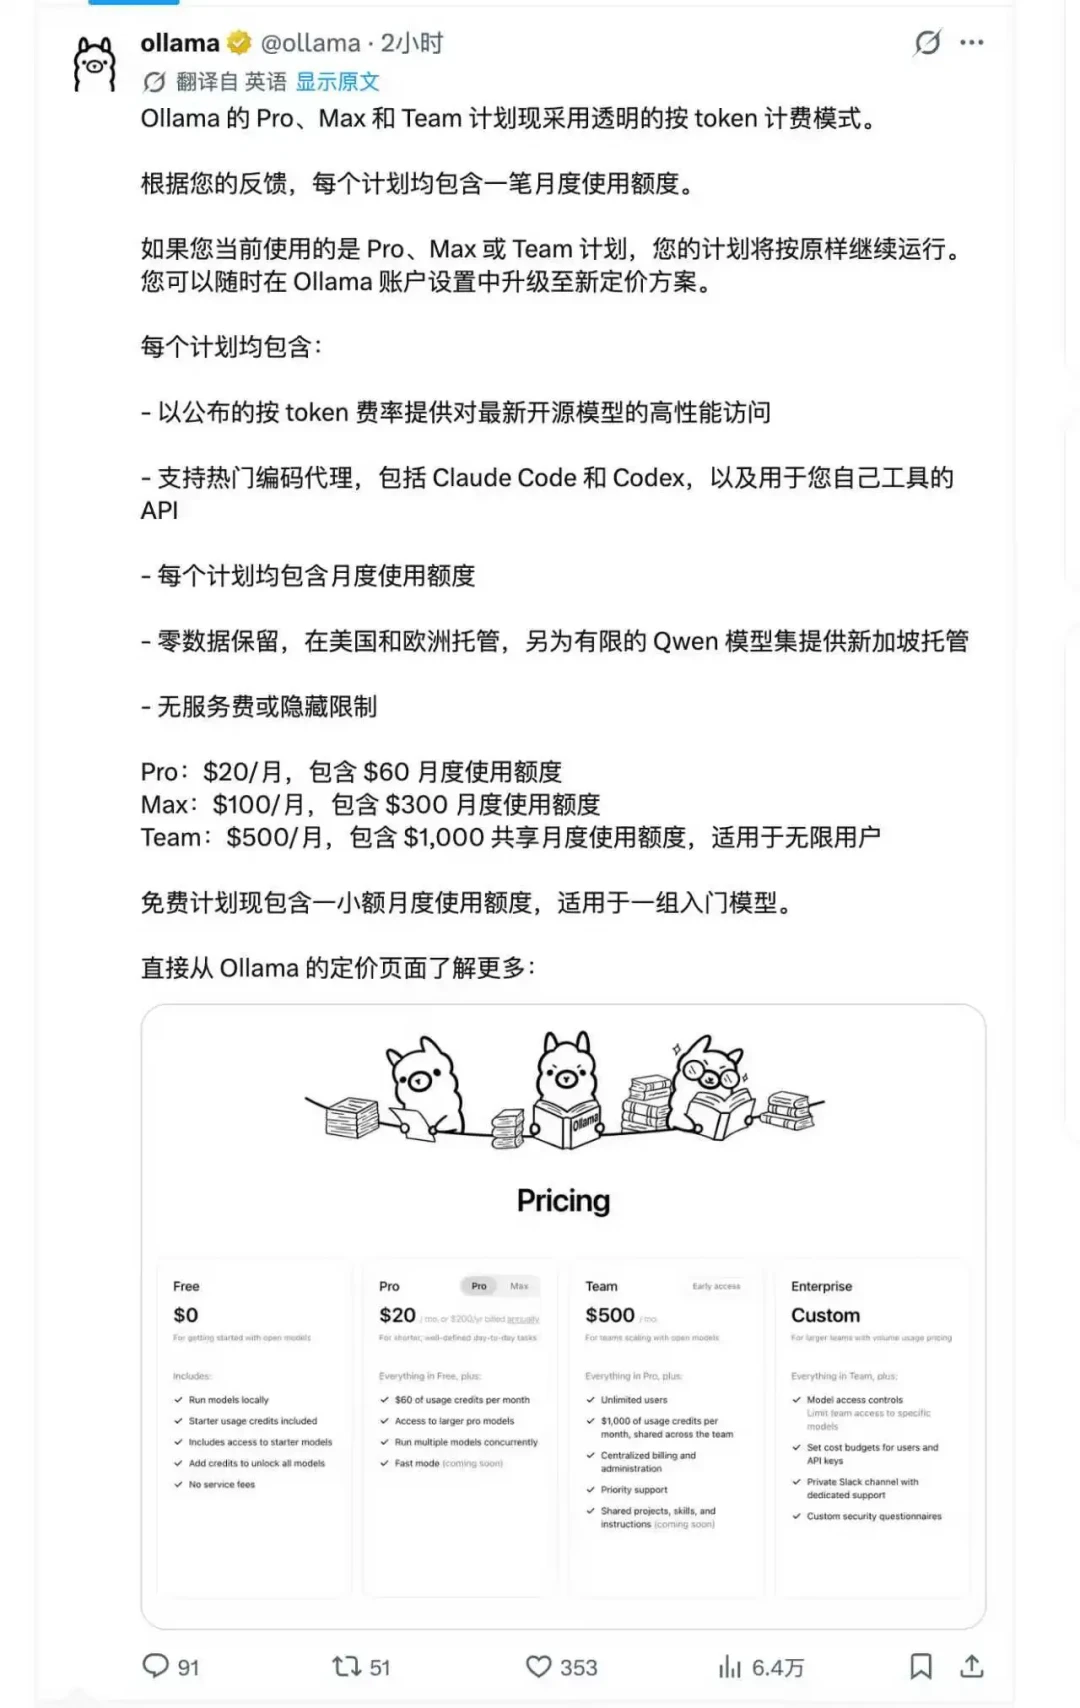
UP主账本的前半页不难看:8月31日Ollama把云服务彻底改版,透明按token计价、无服务费、无隐藏限制;20美元/月的Pro订阅含60美元用量额度,能调DeepSeek V4 Flash/Pro、GLM-5.3、Kimi K3、Qwen3.5 397B这些20多款开源模型,全部支持工具调用;用法和本地一模一样,一条`ollama run`加兼容OpenAI的API,Claude Code、Codex直接接入。哔哩哔哩
账本的后半页在评论区:“他给了你多少钱?,这比之前老套餐量少了70%……避雷”(13赞);“老套餐只蹬dsv4f一周可以25到30亿token,新套餐砍了快十倍”。官方页面上写着"透明",评论区却把同一份订阅算出了从"少70%"到"砍十倍"的口径差。
这篇不是写给刚入坑的新手的。它服务的是那批特定的人:电脑上装着Ollama、早晚会敲一次`ollama launch`把本地模型喂给coding agent、各家token plan都薅过一圈、此刻正对着60美元额度详情页犹豫的中度玩家。你们已经知道pull模型和量化是什么,下面只算你们没时间凑齐的三本账。
第一本账:额度账——"透明计价"为什么反而算不清了
先摆官方公告的原始数字(8月31日):Pro每月20美元自带60美元用量,Max每月100美元自带300美元,Team每月500美元是1000美元共享池、不按人头收费;无服务费、无5小时或每周限制、额度用完后继续按相同token单价走;老用户原方案不变,新注册直接落新方案。小红书
然后摆玩家手里的账单。小红书9月1日一条打了"退坑"标签的帖子(评论22条,比点赞多)把机制变化讲得很直白:“原本的ollama cloud每五个小时刷新额度,每五天也刷新一次(还是七天?),现在直接给你一个月额度usd60,你今天用完就没了”。——从滚动刷新变成月度一次性池子,"砍量"的体感就是这么来的。B站评论区那位42赞的玩家更狠:“新版本按token计费以后相当于v4flash比老版本降了6倍额度,现在周额度只能跑2500次请求,没绷住”。小红书哔哩哔哩
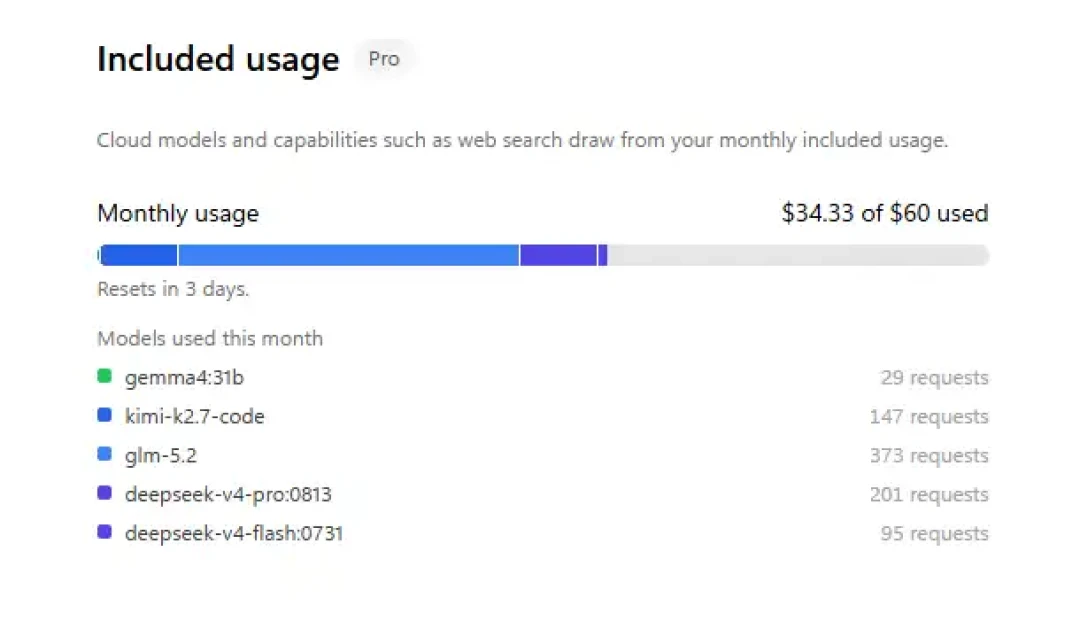
更诡异的是量级本身。8月31日改版当晚就有人晒实测:“之前看到说 Ollama Pro 周额度 10亿Tokens+ 下手订阅,实测发现也就5亿左右,主要使用deepseek和GLM,特别是DSV4Pro很不禁用”。9月11日又有人拿用量面板反算:“3亿token占 一周的10.4%,反算下来一个月大概115亿token。可以爽蹬了”——不过那算的是老套餐。同一周之内,社区口径从新套餐每周5亿到老套餐每月115亿,差了二十倍——这不是谁在撒谎,而是新旧套餐并行、各人用的模型不同、计费规则又没有公开的单价表可以对账,"透明"最后只剩额度池是透明的,兑换率仍然是黑盒。小红书小红书
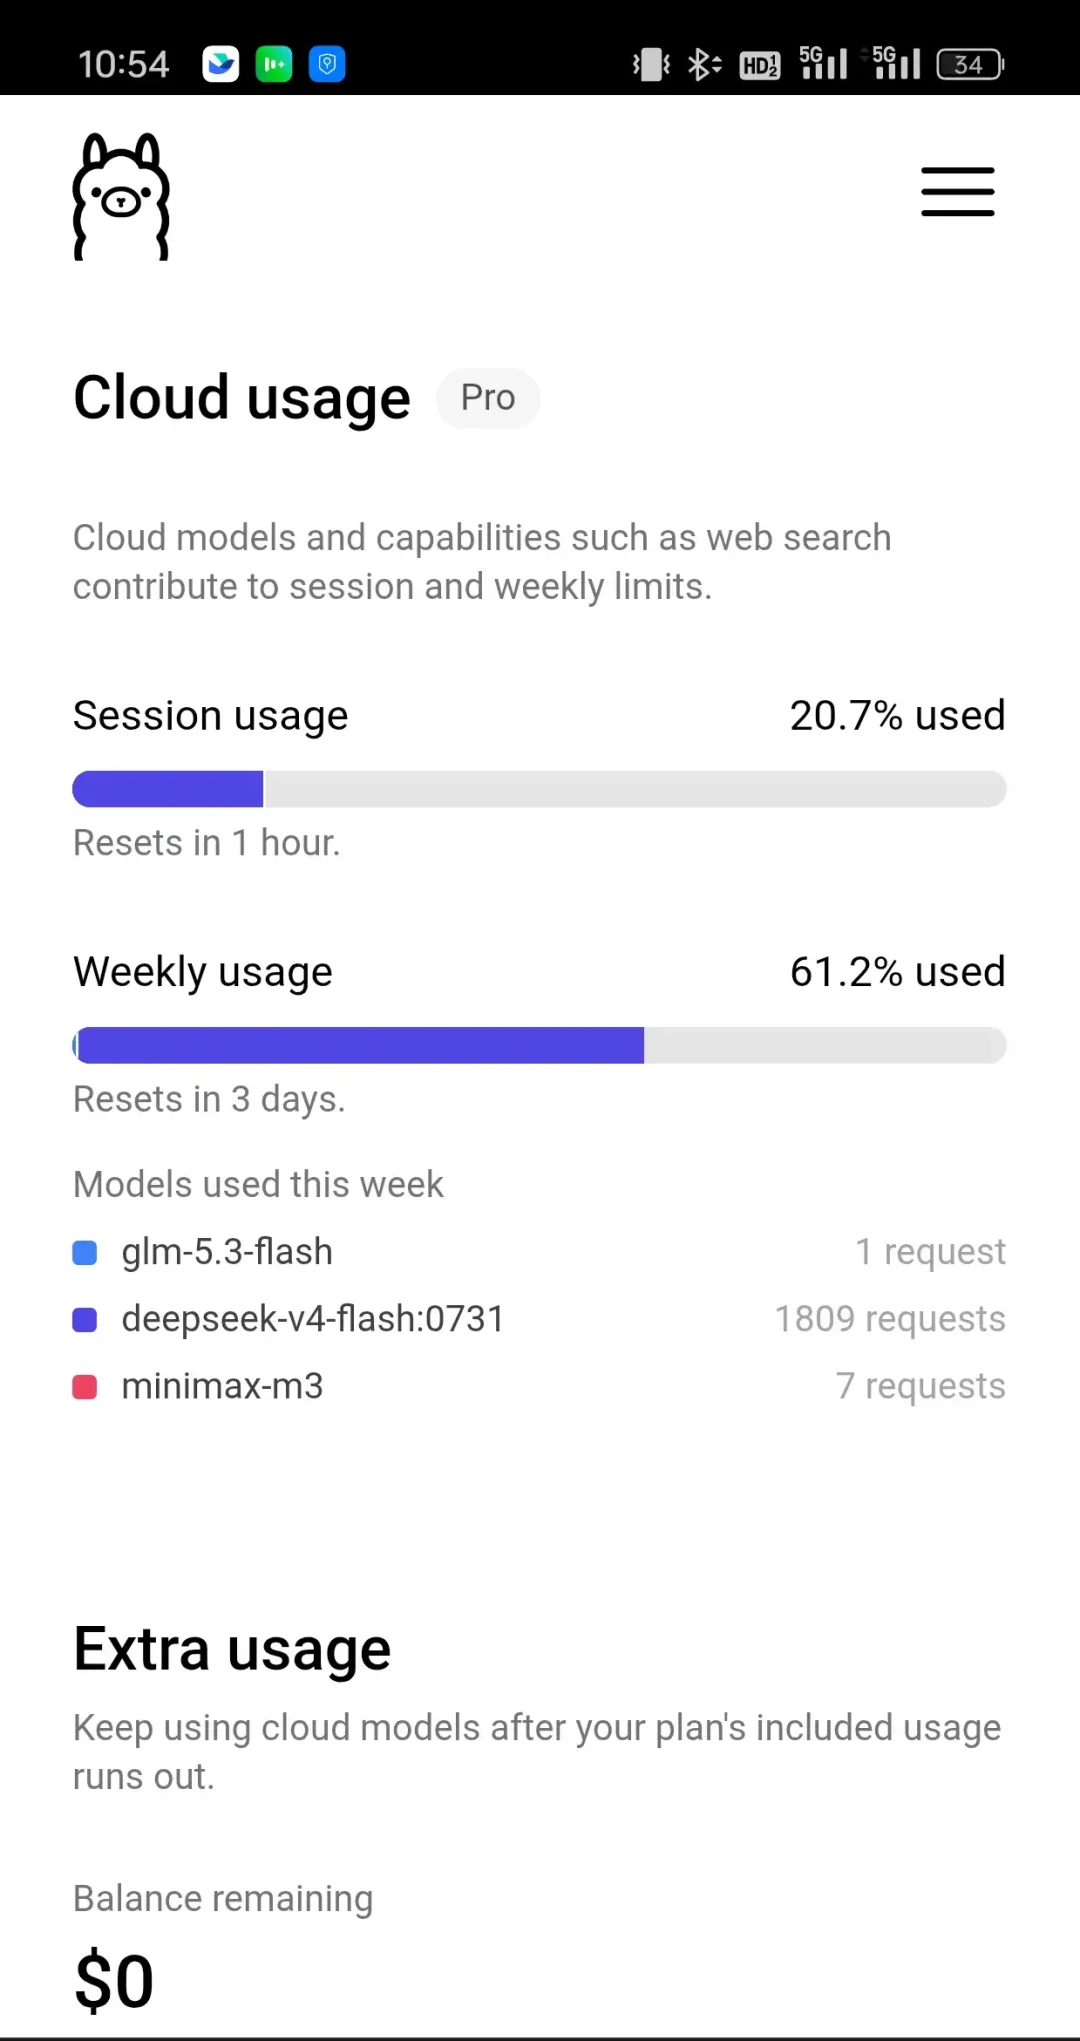
黑盒也不只针对新套餐。9月3日一条37条评论的帖子晒出老Pro的用量面板:“之前这个用量也就估计40%现在已经61了,真就不经用啊”——分母悄悄变小,老用户躲过了改版也没躲过暗削。小红书
汇率还要放到同行堆里比。有玩家把各家订阅横向摆过:“ollama已经废了,才3倍额度,command code 7倍,opencode 6倍,gpt plus 20倍”;《财经》杂志真金白银买过主流Coding Plan做1亿Token均价横评,被社区转述的结论里最扎心的一句是:在Coding Plan的角度看,国内模型其实反而会更贵一些。这些是单人口径,经不起审计,但方向一致:“三家分晋”(ollama、opencode、commandcode)的格局下,20刀的购买力能拉开好几倍,而Ollama被社区放在了汇率偏低的那一头。小红书
更早退场的用户已经用行动投过票:8月17日就有人"取消了ollama的订阅,deepseek官方涨价之后,它也跟着涨,所以基本不可用了"。这波改版,某种程度上就是那次涨价风波的续集。微博
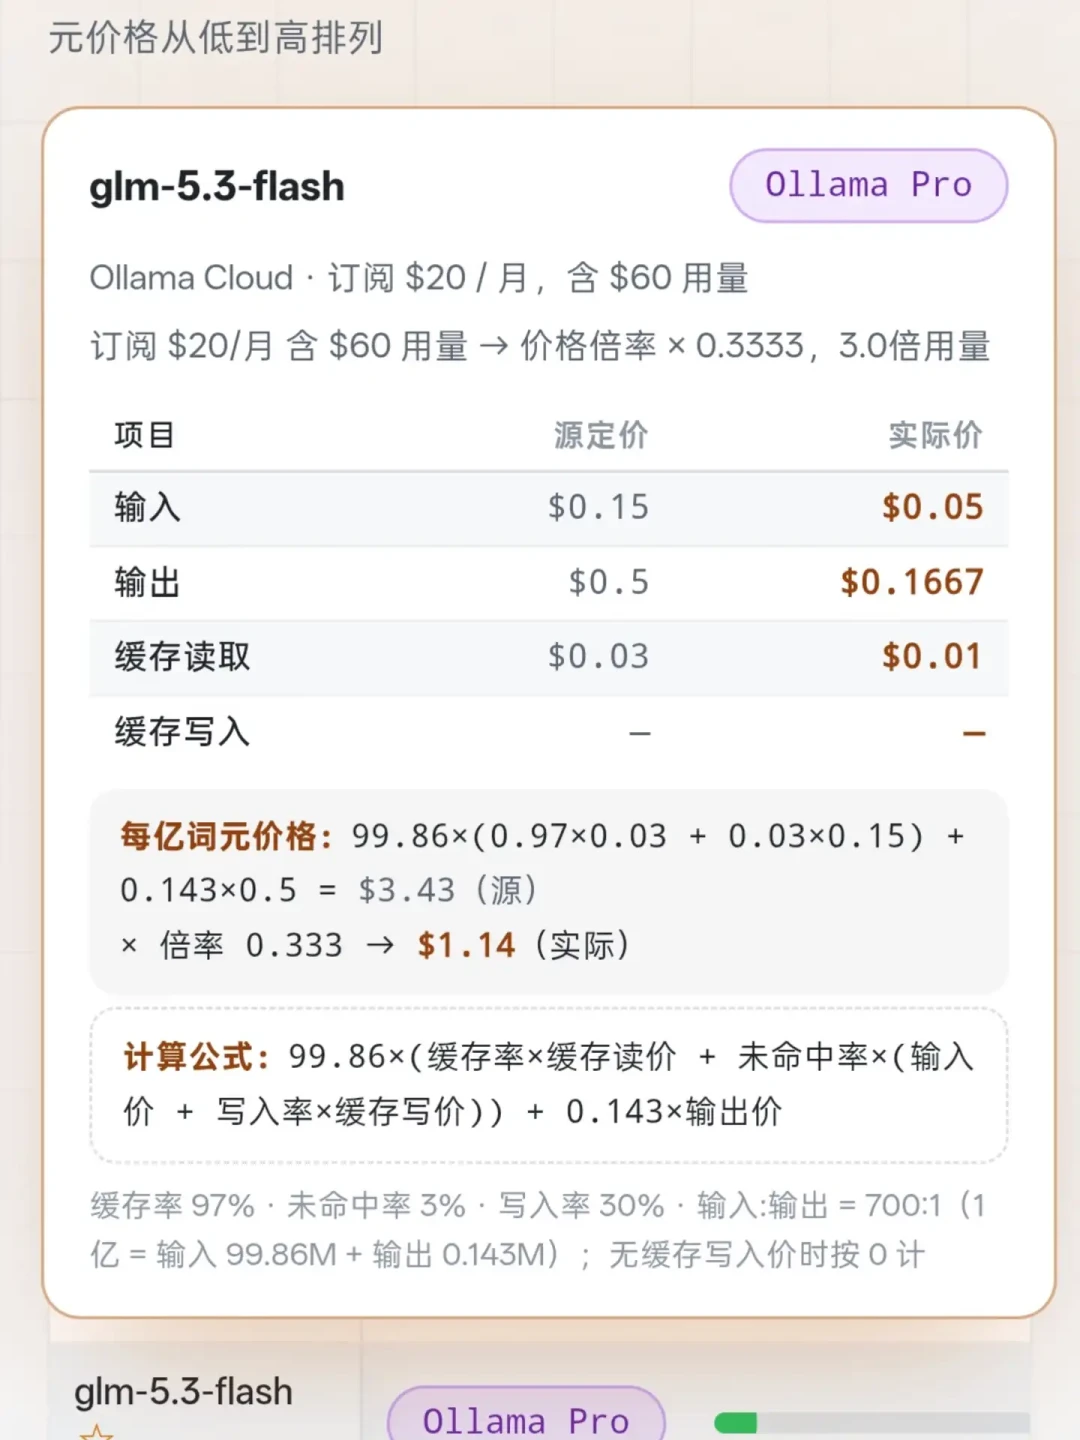
至于这波订阅到底值不值,9月1日那条"背刺老用户"的帖子(28条评论)里,有人把"统一提供3倍用量"逐模型折算成了每亿token的美元单价:dsv4-flash走Ollama约0.95美元,比官方高峰价便宜三分之二、比低峰价也便宜三成;但GLM-5.3-flash的1.14美元,遇上官方低峰0.71美元就反贵六成——帖子自己的结论很直白:ollama订阅只适合高峰使用,闲时用其他计划更划算。小红书
第二本账:满血账——跑得快是真的,规格缩水也是真的
给Ollama Cloud说句公道话:速度实测是真能打。“速度极快:v4f能跑到230t左右 100t的glm5.3”,这条68赞的评论先扬后抑,后面的全是缺点。9月9日甚至有小红书用户因为它"ollama的提供的GLM的速度大概能在200tok/s左右",宣布不再续约智谱和Kimi的官方plan。 对一张16G显存卡、本地23-40 t/s的机子来说,这个速度确实像白捡的。哔哩哔哩小红书
但同一位玩家的"后抑"才是重点:官渠v4f输出长度384k,ollama渠道的v4f是65535处就会截断。 对聊天党这是无感的,对agent干活党这是致命的——一次大重构的输出、一份长报告的草稿,就是这么在64k处被腰斩的。UP主简介里"上下文最长1M token"的说法,也被博主"智昊今天玩什么"提前打过预防针:不过两者都没有1M上下文,如果非要1M上下文的话,还是走官网。哔哩哔哩微博
模型纯度上的坏消息是接二连三的。有玩家8月底就在评论区点名"老版本还行,虽然是输出64k+阉割版ds4f,但至少用量多",新套餐则是"计费价格高,套餐给的额度也不高,模型还不是满血的",ds4v和qwen3.8新模型迟迟不上。9月4日还有老订阅用户发帖:“老订阅询问模型回答的竟然是kimi”,自己的原话是"我用的明明是glm5.3 flash"——路由错位没有官方解释,只能当孤证听。更早有用户反馈调v4flash时"部分场景碰到过思考循环或者调用工具+思考循环,fork对话试了几次都循环,换成官方就没问题",同一位玩家对渠道价的总结还留了句大实话:虽然deepseek比官方全面便宜但是我怀疑其为量化模型。
这个圈子里的人买二手卡都懂:核心编号对不上,跑得再快也是矿卡。Ollama Cloud现在在本地党眼里的位置,就是一张"跑得飞快、但规格表待核"的魔改卡。
第三本账:可见性账——两笔互相打架的实测,答案在工具链里
缓存命中率决定按token计价的真实成本,而这一项上,评论区给出了两组完全相反的实测:一组说"缓存命中奇低,好像和原价也没区别了"。另一组说"我用新的dsh接ollama的API,可以看到dsv4.1flash的缓存命中,基本都有99%"。哔哩哔哩
巧的是,那位UP主自己也回答过:ollama cloud看不到这个信息——官方面板不提供缓存观测,所有命中率数字都来自第三方工具。这就是这笔账的正确算法:不是信谁的问题,而是你愿不愿意在订阅前,先用DSH这类能出数的客户端白嫖测一轮。本地党的老手艺了:烤机报告永远比商品详情页可信。哔哩哔哩
反证:不是"别订",是别拿它当主力
把三本账合起来看,会得出一个和"避雷党"不一样、也和"安利党"不一样的结论。
厂商也有厂商的算盘:按照联合创始人Jeffrey Morgan在Y Combinator访谈中的说法,从年初到现在,平台上的Token使用量增长了150倍,推手正是"交代一次任务、后台连续跑几十分钟"的编码Agent。被砍的,恰恰是老套餐时代"往死里蹬也蹬不完"的那部分薅羊毛红利——平台在把超额消费者请出去,留下愿意为确定性付费的人。小红书
它不是没有受益人群:纯轻度使用(偶尔问答、输出短、不碰agent长任务)的人,透明计价+无服务费+20多模型随便换,60美元额度可能压根用不完——被砍的额度对他们不构成成本。
但对拿它喂agent的人,微博用户"玩家老C"已经示范了这个订阅的真实用法:“ollama周额度就剩一点的时候,我就切换到DSV4-FLASH,家里最听话最能干活的孩子,默默承担了最多、最省的活”。看到了吗,一个本地部署工具的云服务,在社区里的正确打开方式是给本地机当溢出阀:云端额度蹬穿了、新模型试完了,落地的活交给自家那台跑着27B的机器。它甚至不是"云替代本地",而是"云补足本地",和"英伟达和AMD大模型平台白嫖,用完了再考虑付费"是同一个姿势。微博
所以这份订阅该不该订,跟去年"要不要本地部署"其实是同一个问题的镜像:不看它宣传了什么,看你手里有没有它替代不了的东西。
三个继续观察的信号:①Qwen3.8系列(尤其3.8-27B的云端版)何时上架、给不给满血输出;②周额度重置规则和缓存命中观测,官方面板会不会在骂声中开放;③"思考循环"、64k截断和"kimi自称"这类规格问题,会不会出现在第二、第三个人的独立实测里——目前它们还只是"一人一测"的孤证,证据到哪,结论就该停到哪。
最后说句圈内的话:4月那个"Ollama官号被逼的用中文写回复"的名场面,很多人当乐子看。但乐子背后是同一个事实——这个靠"本地、开源、零门槛"六个字起家的工具,正在被它最忠诚的一批用户用验矿卡的方式验货。信任这个驱动,装错一次就回滚不了了。微博
你入的是新套餐还是老套餐?60美元池子几天蹬穿的?评论区把烤机报告交一下。