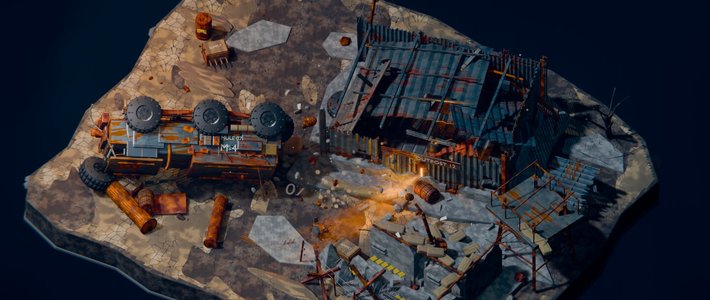
这几天,微博上不少人转同一条视频:自动化产线在屏幕里跑起来,是网友用 DeepSeek V4.1 Flash 的新版 3D 能力生成的。还有人拿它做 3D 建模,总装车间的汽车和爆炸图直接渲染出来,效果惊艳。小红书上则有人让它建了一座「废土前哨站」,锈蚀的运输车、铁皮棚屋、检查点路障,全部出自几句提示词。微博微博小红书
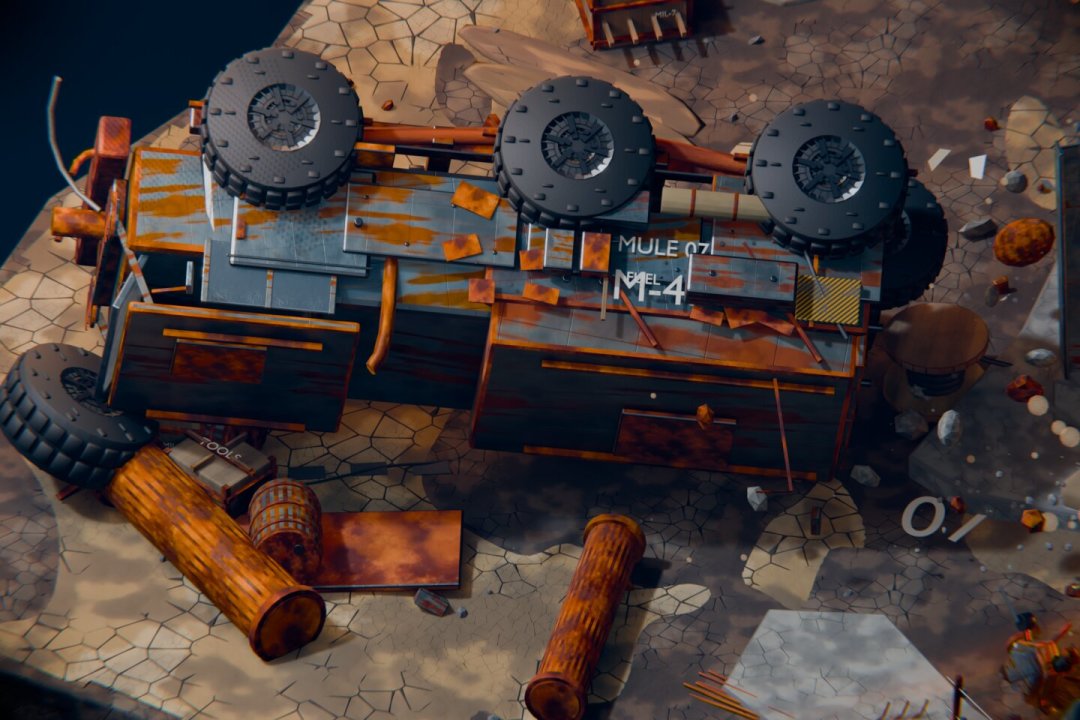
官方给这个能力起的名字叫「许愿式编程」:你用自然语言描述想要什么,AI 自己把它从零造出来。10月17日,DeepSeek 把模型更新到 V4.1-Flash-1017,网页端、App、API 同步切换。一更新就登上了两大排行榜榜首,其中就有开源模型榜第一。知乎知乎知乎知乎
但评论区的画风不太一样。有老用户说它比老版 V4 Flash「差不少」,还专门发问为什么大家对此毫无反应。也有人形容它「变抠门了」。登顶和退步,怎么会同时成立?知乎知乎
先看跑分:代码是真强了
官方模型卡摆出的成绩很直接:DeepSWE v1.1 拿了 77.0 分,高过 Opus 5 的 74.0 和 GPT-5.6 Sol 的 73.0。Terminal-Bench 4.0 从 31.2 跳到 42.3,Automation-Bench 从 54.8 升到 60.5,全面超过上一版。第三方口径也不差:LiveBench 2.0 的 Coding 分项,它拿了 96.0,和顶级付费模型 Sol 打平。Hugging Face知乎知乎
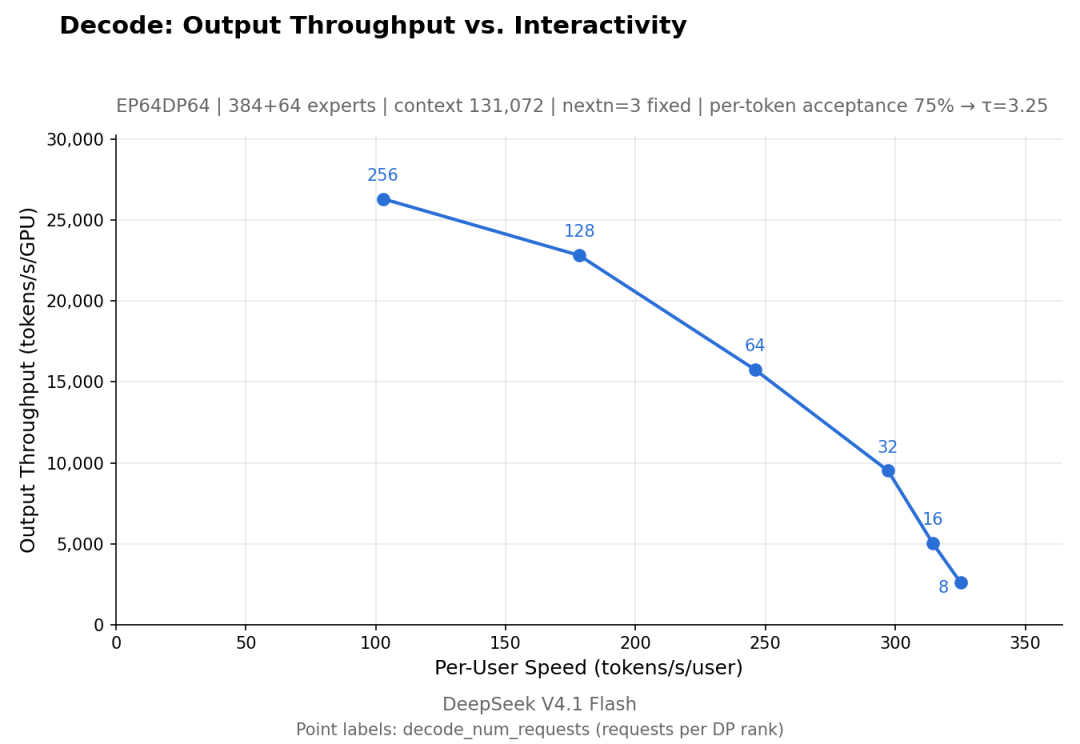
官方的说法是,这版用自反馈强化学习专门练了从零构建完整项目的能力,游戏开发和 3D 建模就是主打卖点。同时官方强调,任务执行时间和输出长度反而降了,推进「性能-成本的帕累托前沿」。下面这张官方发布的解码性能曲线,横轴是每个用户的生成速度,纵轴是整卡输出吞吐,官方想说的就是:又快又省,可以兼得。知乎Hugging Face
那批刷屏的产线模拟视频,就是这些卖点的具象化。
「退步」的感受又是哪来的?
答案同样写在跑分里,只是藏得更深。据官方技术报告整理的数据,相比 V4 Pro,SimpleQA 从 55.2 掉到 42.3,LongBench-V2 从 51.5 掉到 45.2,知识面和长文本理解被牺牲了。技术报告的标题就写得很直白:《Pushing the Limits of KV Cache Compression》。知乎Hugging Face
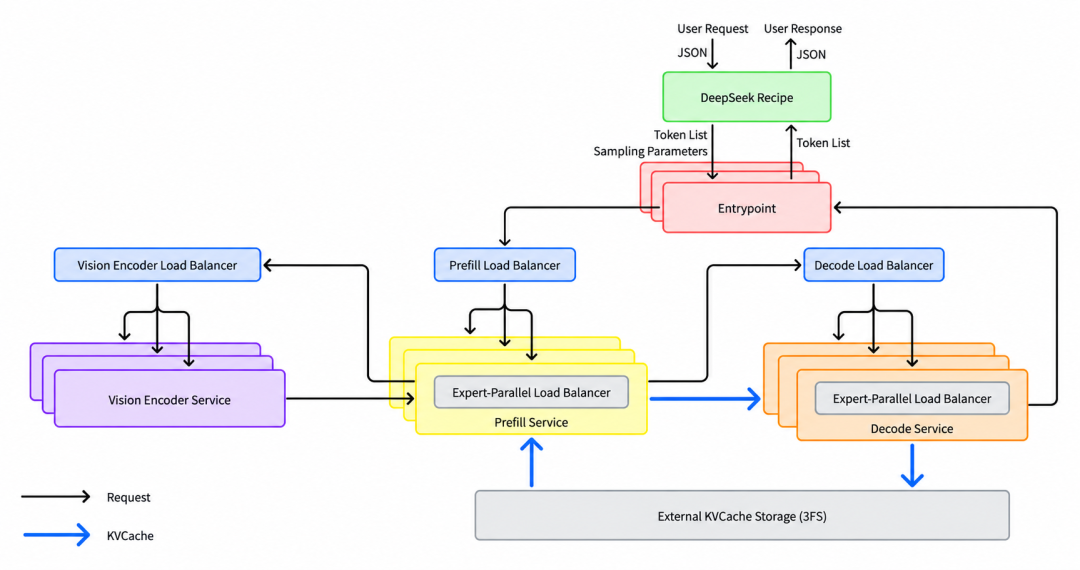
压得有多狠?KV 缓存压到原来的约四分之一,预填充计算量接近减半。配套的还有系统级省钱:模型更新三天后,DeepSeek 开源了自研推理框架 DeepInfer。这套框架里,Prefill 和 Decode 拆到不同的服务簇上,KV 缓存交由专门的外部存储承担。知乎知乎GitHub
代价是压缩会漏信息。字节 Seed 团队的长文本检索实验发现:同一条信息放在上下文的不同位置,效果会有明显差异;V4.1 Flash 比老版修好了不少,但仍留有 6.1 分的差距。这正是用户抱怨「一万字以后开始不听指令」的直接原因。知乎
还有个更扎眼的数字:幻觉率高达 96.5%——知识面答对率其实不低,但不会的题它几乎从不承认,而是硬猜。知乎
三个实际使用中的坑
一是「抠门」。有实测博主发现,新版 Agent 做事只要有点代价就倾向于不做,性格和上一代完全不同。如果你把它接进自己的 Agent 框架,记得单独适配,否则大概率翻车。微博
二是长程任务别硬上。LiveBench 的 Agentic 分项它只有 50.9 分,Sol 是 73.0,需要模型自主维护多轮状态、需求还一直变的长活,交给 Opus、Astra 这类长程更强的模型更稳。知乎
三是第三方订阅平台要留心。有用户爆料,某订阅服务里的 V4.1 Flash 是量化版,效果和官方 API 对不上。这个说法暂无官方证实,但掏钱之前,值得先拿个小任务验一验成色。微博
写在最后
V4.1 Flash 不是退步,而是变成了偏科生:边界清楚、可验收的代码修改和项目脚手架,它的性价比是市面顶级;但要百科全书式的知识和长文稳定性,短板同样明显。
想用好它,记住六个字:短任务,多验收。关键事实自己再核一遍——这一步,模型替不了你。