上车说一句"打开空调",助手愣了三五秒才接话——车机慢,是算力不行吗?知乎上有工程师拿旗舰座舱芯片高通8295做了次实测,答案比想象中有意思。知乎
模型跑得动,吐字也不慢
他把一个0.5B的通义千问(对,名字里的"超大"规模其实就几亿参数、Q4量化后不到500MB)塞进一台8295,不用GPU、不用NPU,只用CPU。结果是绑四个大核跑,每秒能生成54个token。一条车控指令的回复也就几十个token,一秒钟就说完。知乎
真正的问题出在"开口之前"。座舱助手每次回答前,都得先把说明书和功能列表(提示词)读一遍,512个token要读约5秒。这就是你感觉它"愣一下才说话"的原因。知乎
解法也不复杂——功能列表每次都一样,读过一遍缓存下来就不用重读。偏偏是这种工程细节,决定了"能演示"和"能交付"的差距。
七个核全开,反而慢两成
一个反直觉数据:只用四个大核,生成54 token/秒;七个核全开,生成反而慢两成。他推测,生成文字是一个字一个字往外蹦的,每蹦一个字所有线程都得对齐再走下一步,三个慢核一进来,四个快核只能干等。他也坦承这还只是猜测、没做实验验证——但数字本身跑了三遍,差距在3%以内,是稳的。知乎
再拆一个营销里很少讲的点:一颗8295要同时管仪表和中控。仪表不能死机,所以跑在QNX上,安卓只是QNX上起的一个虚拟机,车机端能支配的算力,只是虚拟机里剩的那份。知乎
大模型上车≠助手上车
这一年行业很热闹:特斯拉车机接入豆包,比亚迪把座舱宣传进"智能体时代",东风日产N7早早预告要上DeepSeek。但特斯拉首批用户的真实反馈是,豆包只是个独立App:“豆包,播放音乐”“对不起,暂时无法操作,请使用车机语音操作”——能聊不能控,聊天搭子和管家是两码事。知乎微博小红书微博知乎
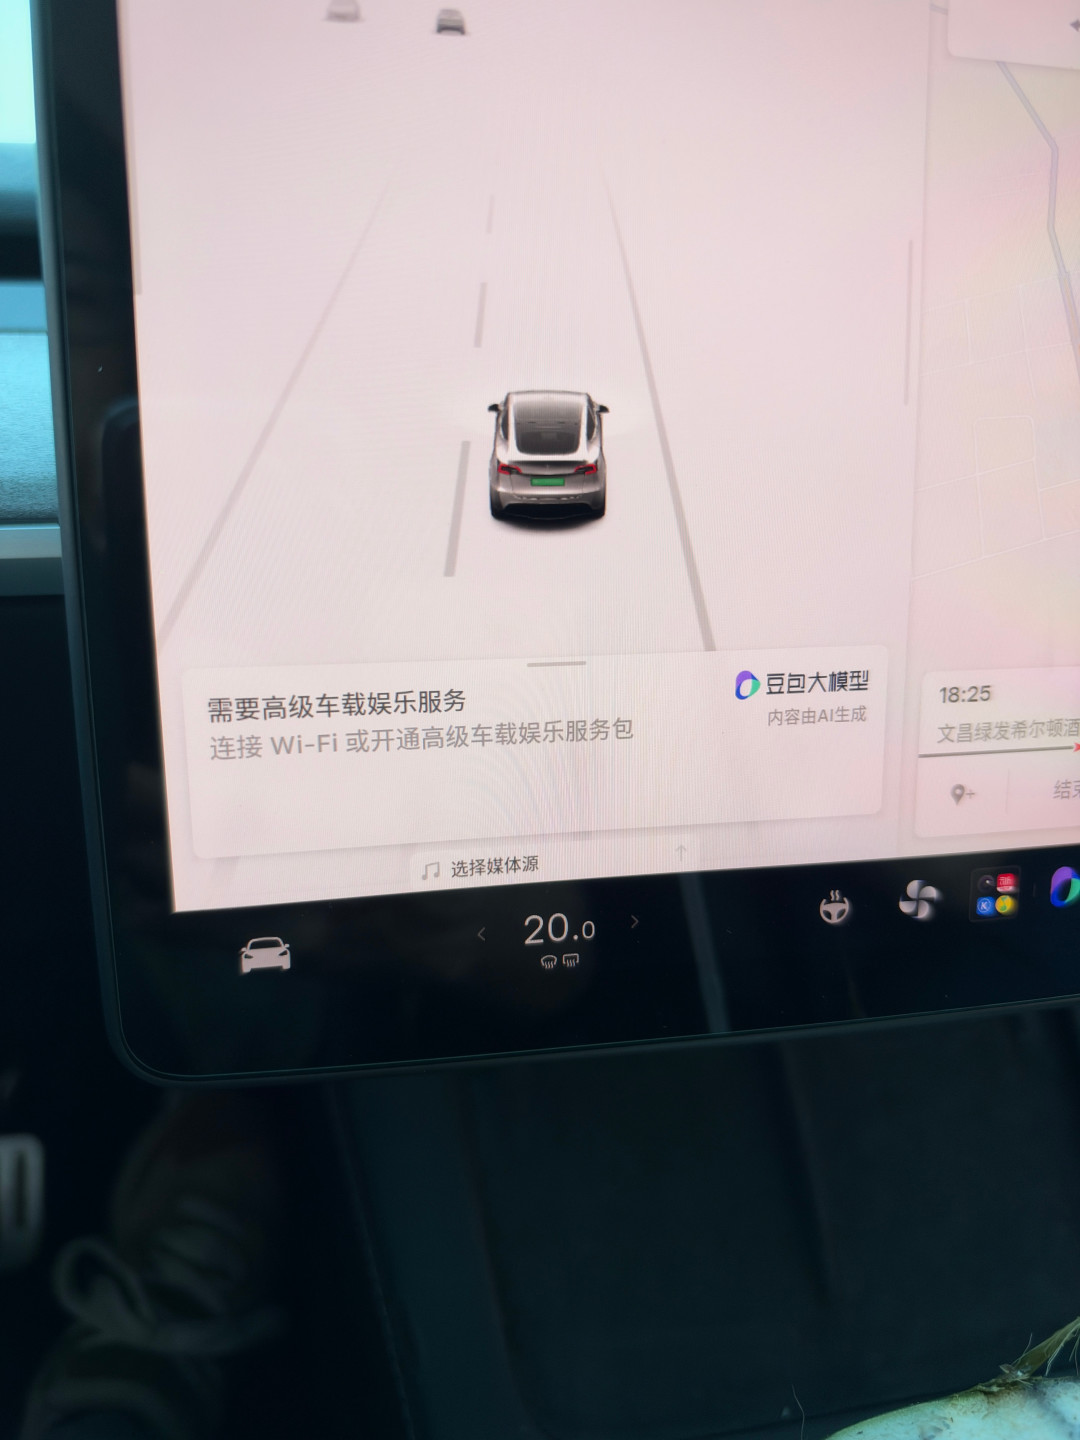
正如一位知乎答主总结:硬件只是入场券,本土化才是淘汰赛。算力分配、响应延迟、行车安全限制,都在给模型套笼头。知乎
普通车主该看什么
先交代证据边界:这只是一位爱好者一台设备的实测,作者自己声明——编译时没开两个指令集,数字多半偏低;发热降速没测;那个"5秒"是算出来的,不是掐表。
但足够给几条实在参考:
现场测响应:去4S店说一句"打开空调调到24度",掐秒表看它愣几秒;
问它能不能控车:大模型是融进了语音链路,还是只是车机上装了个App;
盯OTA节奏:有车主吐槽"同样硬件,功能还分三六九等",更新覆盖比发布会PPT重要。知乎
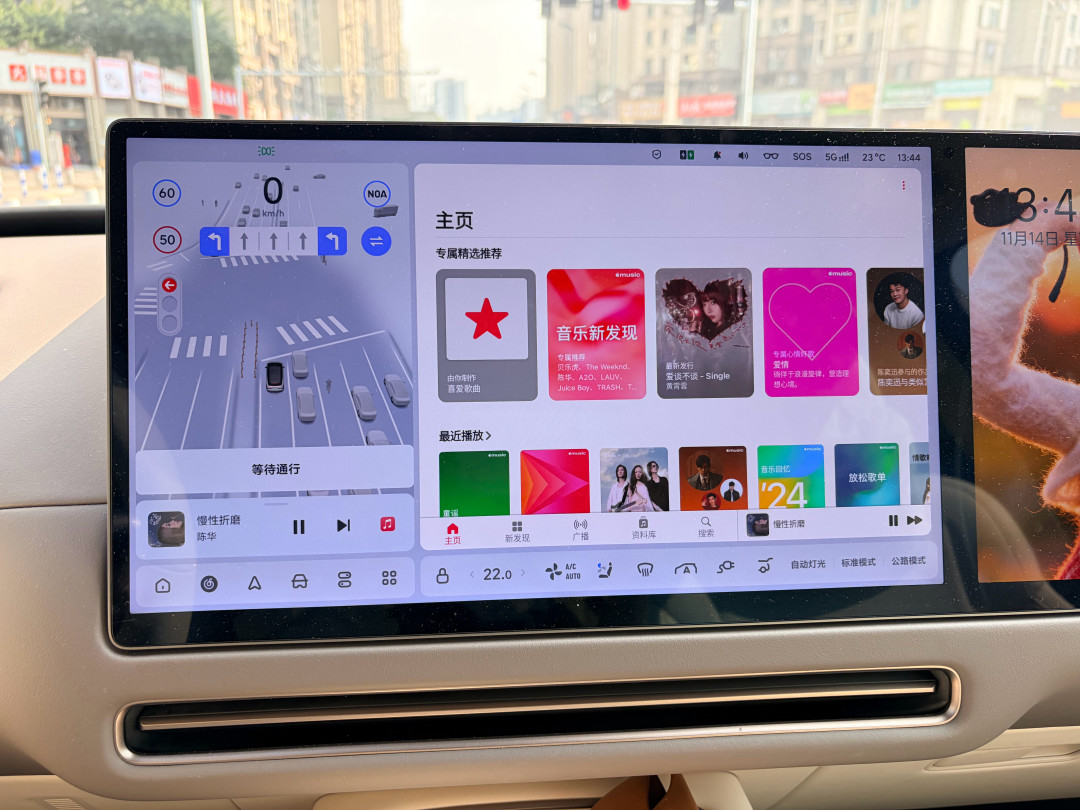
车机AI的竞争才刚开始,愣那几秒不用恐慌,但也别为贴着"大模型"标签的营销单买单。