小红书上有个帖子最近被顶得挺高。楼主说,一开始 AI 只写 50% 的代码,自己还能补一补,心里有数;现在 99% 的功能都是 AI 写的,每次提交代码心里都没底,“让一行一行去看,根本不现实”。评论区里最扎心的一条是:新人入职三天没看懂代码,十几万行,看的想哭。小红书
问题从来不是 AI 写得慢,是它写得比人审得快。知乎上一个 346 赞的回答说得更冷静:AI 时代的 Code Review,本质是注意力的重新分配。知乎
这周,阿里又把站在这个位置上的开源项目推回了视野。
11 月 15 日,阿里的 OpenCodeReview 攒到 51.5k star,一天涨 893,Go 写的,一行 npm 命令装完,命令叫 `ocr`。哔哩哔哩
它不是新面孔。8 月初开源满两个月时就已经是 19k star。这一波是又热了一轮。哔哩哔哩
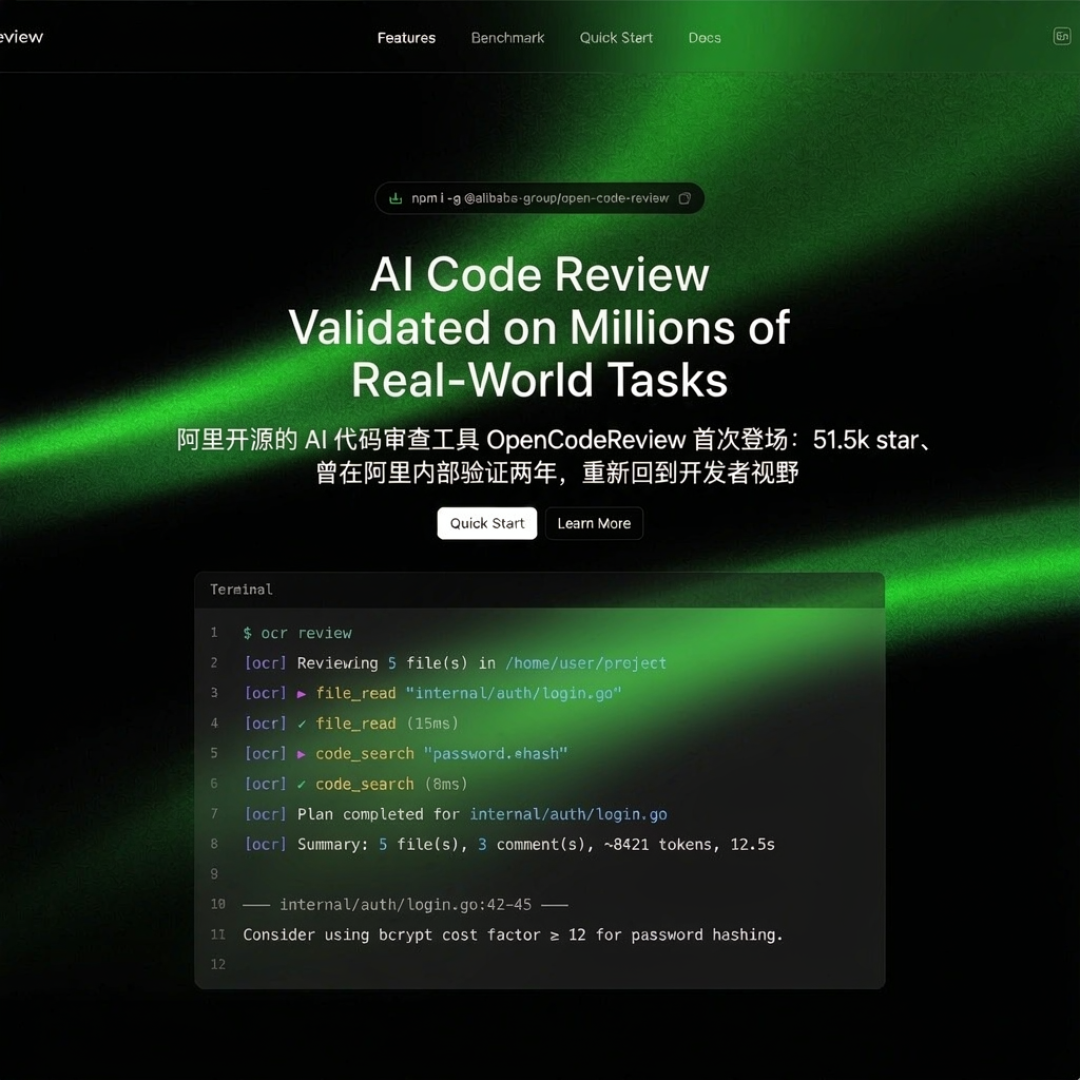
干的活也不复杂:`ocr review` 针对改动,读 git diff;`ocr scan` 不依赖 diff,直接审整份源码。它能以插件或 Skill 形式挂进 Claude Code、Codex、Cursor、Kimi Code、OpenCode,也能接 GitHub Actions、GitLab CI 当门禁。知乎知乎
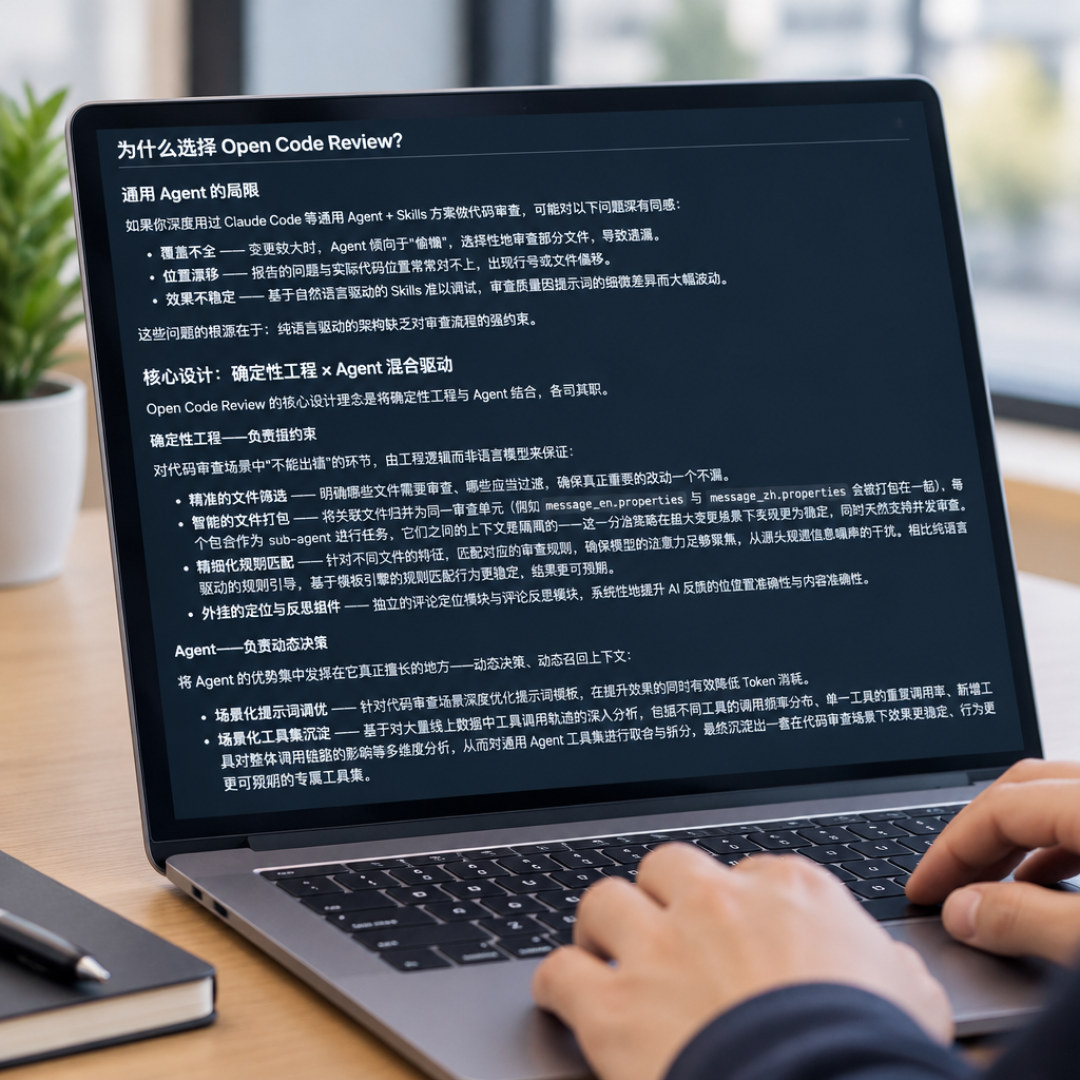
数字是官方自己给的。它同步开源了一个评测集 AACR-Bench:50 个仓库、200 个真实 PR、10 种编程语言,80 多位资深工程师交叉标注出 1505 个真实缺陷。同一个 Claude-4.6-Opus 模型下,它的精确率 33.90%,让 Claude Code 直接审同一个 PR 只有 7.23%;token 花 385K,对面 5664K;通用 agent 一轮能提 4351 到 5980 条意见,它只提 728 到 889 条。哔哩哔哩知乎知乎
翻成一句人话:它不求说得多,求说得准。
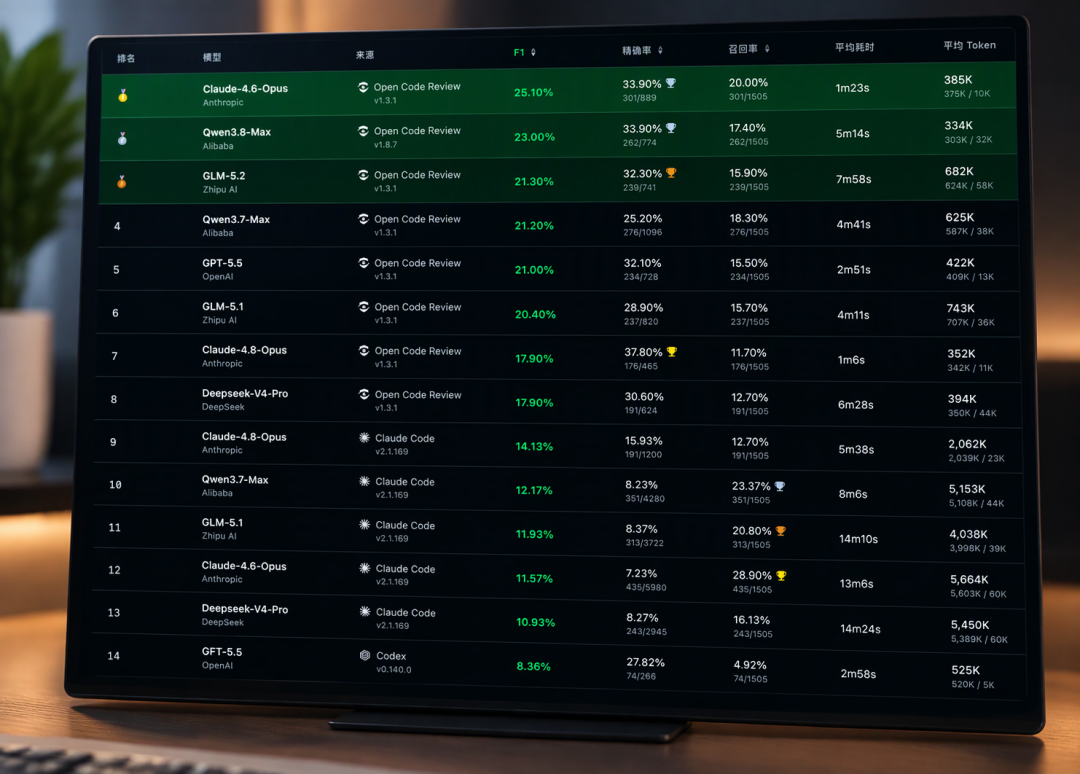
短板是明牌:召回率比通用 agent 低,会多漏掉一些问题,但报出来的尽量都是真问题。官方自己也说明过,这是偏重精确率、减少噪声的取舍。哔哩哔哩知乎
还有一句得说在前面:这套 benchmark 是项目自己建、自己跑、指标口径也由它定义,别把它当成第三方独立评测来引用。有位 UP 主把结论直接写进了标题:它可以帮你审,但暂时还不能替你审。知乎哔哩哔哩
那为什么这道关还是省不掉?
11 月 12 日,南京大学刘佳恒团队放出测试生成基准 TestPrism,核心指标要求一条测试同时做到三件事:在原始代码上失败、接受所有正确实现、拒绝所有错误实现。36氪
他们评了 14 种 Coding Agent 配置,最强的 Claude Fable 5.1 在传统单一参考评测下成功率 59.67%,换成上面那套严口径只剩 28.00%。36氪知乎
失败原因也标注过了:占比最大的一类叫“错误检查”,整整一半——检查过弱、判断标准错,或者过拟合,把参考实现的偶然细节当成了需求本身。这些分数都是论文作者自报,暂时没有第三方复现。36氪知乎
vLLM 团队自己披露过一个案例:编译器把激活读取挪到了同步等待之前,这类错误“能通过简单的功能测试,需要针对性的调查才能发现”。钛媒体
所以测试全绿,很多时候只是让同一个 Agent 左手写 Bug、右手给自己发合格证。知乎
想让 mock 不作弊只有一条:返回值要抄自真实的接口文档或抓包结果,不能抄自你以为的语义。没有来源的 mock,等于给代码发假通行证。知乎
还有一句更狠的:AI 写错不可怕,改错看不出来才可怕。小红书
真要在自己项目里落地,三件事就够:
写代码的模型和做审查的模型,别用同一个。知乎
按风险分级投人。文案变更、内部工具可以免审;碰计费、权限这类,多人交叉审。知乎
用变异测试验测试本身:把被测代码故意改错,看它会不会变红,不会变红的直接删。知乎
工具能做的是把你的注意力挪到该看的地方。签字的,还是人。