10月22日,微软AI团队在《科学》上发表了论文《Sequential diagnosis with language models》。在304个来自《新英格兰医学杂志》的疑难病例里,他们开发的MAI-DxO诊断准确率是83.2%;对照组的全科和内科医生,允许查资料时是36.1%。换成325份急诊入院记录,数字是80.3%对46.8%。Science
消息传开后,标题大多写成“AI诊断赢了全科医生”。但这项测试里,没有一位真正的病人。
研究团队把每个病例改写成一道分步题。AI开局只拿到一段简短介绍:年龄、性别、主要症状。它要自己决定问什么、查什么、安排哪些检查;回答问题的是一个握着完整病历的AI,不是病人本人。等它觉得够了,提交诊断,再对照病例档案里的标准答案。换句话说,它赢的,是在一份已经写好的病历上,把病名猜对。
这套系统有意思的地方,是它不靠一个“神模型”单打独斗。同一个大模型分饰五个角色:一个提诊断假设,一个挑检查,一个专门唱反调,一个盯成本,一个做复核。那个“杠医生”的任务,是在其他人过早认定某种病时,把矛盾的证据摆上桌。钛媒体
这五个角色,恰恰是现实门诊里最奢侈的东西。一个全科医生很难为一例病人反复追问半小时,更难随时拉一个同事来抬杠。AI赢的,不只是知识,还有时间、流程和一支不用排班的会诊团队。
论文作者自己写得很清楚:这些比较并不能证明它优于专科医生、多学科团队或真实临床实践;SDBench测的是理想化信息条件下的诊断推理,不是床边表现,也不是患者结局。 对照组的医生也不是“装备齐全的医生”:他们是一个个独立答题的全科或内科医生,不许查资料时准确率只有22%,允许查资料也只有36%。 现实里的病人,通常不会只遇到一个孤零零的医生。知乎财经网
诊室比试卷多出来的,首先是病人的身体。真实病史是残缺、矛盾、会变的;病人会漏说,会记错,会紧张;医生要看他怎么走进来、怎么呼吸、哪里按下去会疼。测试里的“病人”不会骗人,也不会突然恶化,它只是一份完整的文本。这不是假设。2025年3月,一名家长按AI问诊的判断,把反复咳嗽发热的孩子当成普通呼吸道感染居家用药,后来确诊为病毒感染肺炎——AI没有看到孩子,也没有听诊。新华网
然后是诊断之后的全部工作。拿到病名只是开始:这个人的肝肾功能受不受得了这种药,他有没有别的病,他愿不愿意接受这个方案,他付不付得起,下一步谁来随访。诊断准确率是中间指标,不是医疗的全部。
最后,是签字的人。中国的《互联网诊疗监管细则(试行)》明确,人工智能不得替代医师本人提供诊疗服务;处方必须由医师本人开具。 国家药监局器审中心2026年6月的征求意见稿也写明,AI软件只能辅助医师诊断,医师对临床诊断结果负责。 这不是简单的官僚程序。医疗事故总要有人承担,有人被追责,有人去改进;AI承担不了,最后还是由医生承担责任。新华网钛媒体
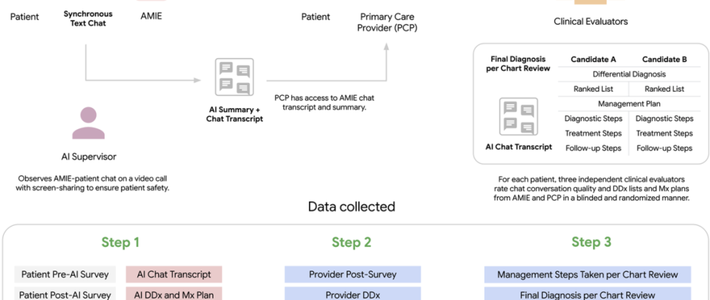
微软的下一步,也不是让AI直接开诊。他们宣布与波士顿贝斯以色列女执事医疗中心合作,让真实患者与系统互动,再由医生独立评估;目前还没有临床结果。 谷歌此前的AMIE试验,让98名患者与AI对话,但全程有医生实时监督。连开发这些系统的人,也没有把“直接看病”当作下一站。钛媒体
所以,这项研究真正戳中的,可能不是“AI会不会取代医生”,而是“一个医生在现实里被剥夺了多少支持”。AI的五个角色——提假设、挑检查、唱反调、算成本、做复核——本来应该是一个医疗团队里的人和流程。只是在不少门诊里,这些角色被压缩进了一个人、几分钟。
AI可以赢下诊断,但在有人为这个诊断负责之前,它还不能是那个医生。它赢了一场没有病人的考试;而看病,考的是有病人之后的事。