

概述
EVO-X3私人 AI 工作站三周实地报告·完整配置与基准测试
设备:极摩客EVO-X3²·AMDRyzen AI Max+395(StrixHalo)
主力AI:Qwen3.8-Flash-Next(1250亿参数)·Halogen引擎
记录周期:2026年10月22日至 11月12日
原则:一切本地运行,不依赖云端
实地报告·三周100%本地AI
极摩客(GMKtec)EVO-X3上的完整私人AI工作站
模型、引擎、编排器、工具、图像/视频/音频创作、Pilote与持续训练:完整配置与基准测试
统一内存·Fedora 44
主力AI:Qwen3.8-Flash-Next(1250亿参数),由Halogen引擎提供服务
原则:一切均在本地运行,不上云端,即使没有网络连接也能工作
记录周期:2026年10月22日至11月12日,共三周
1. 项目简介
这个项目始于一个简单的想法:在家里拥有一套堪比前沿 AI 助手的系统,不向任何外部服务器发送哪怕一条数据,并且能连续数天自主处理真实项目——应用、游戏、图像、视频、音乐、配音、3D 模型。
三周时间里,从2026年10月 22日到11月12日,一台设备——极摩客EVO-X3——变成了一座完整的私人AI工作站。家中的任何浏览器或经私有网络远程都能访问它,多个账户共享,并日夜受到监控。
完全私密:对话、文件、创作成果和语音都留在设备本地。
离线可用:只有在主动请求时才联网(网页搜索、模型下载)。
自主运行:主力AIQwen使用约三十个为它亲手打造的工具服务器,Pilote则让它能够执行数百步的项目。
完整创作:图像、本地编辑、带声音的视频、音乐、配音、3D物体、自动剪辑的动画电影。
7×24可靠:断电后自行重启,自动恢复工作,硬件监控,手机告警。
可量化的进步:Qwen在打分测试台上持续训练,覆盖60多种编程语言,而无需重新训练模型本身。除非另有注明并给出来源,本文所有测量均在这台设备上、以其真实设置完成。演示图片专为本文、在演示账户上生成。
1.1 各自分工:用户、Qwen与Claude
整套系统由三方共建。用户设定目标并做出每一个决定。本地AIQwen3.8-Flash-Next负责执行工作:构建应用、生成图像、安装、发送、测试。Claude Opus 5.5(Anthropic 的 claude-opus-5-5 模型,Claude5家族中能力最强的型号,通过Claude Code在终端中使用)担任架构师与教练:它搭建了编排器、工具、测试台和监控系统,并时刻照看着Qwen。需要说清楚的是:这不是Claude Sonnet这类中端模型,而是Anthropic 的顶级旗舰模型。
自11月10日起,规则变得严格:所有事都由Qwen来做。Claude不再代替它执行任务;当Qwen卡住时,Claude会补齐缺失的工具、修正它的方法与护栏、衡量它的进展,并通过通知汇报。Claude从不触碰Qwen项目的代码。
2.设备:极摩客EVO-X3
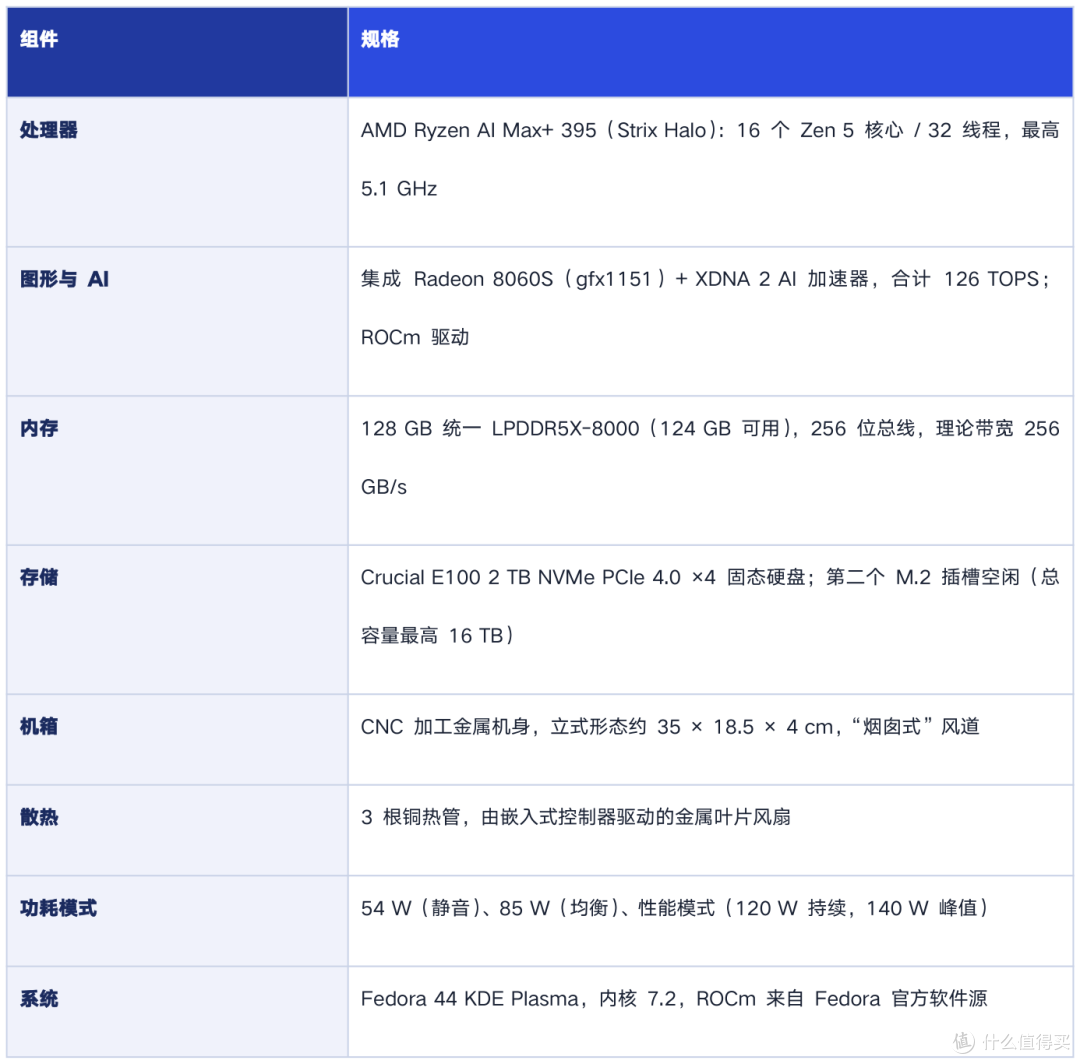
2.1 一颗“StrixHalo”芯片
“Strix Halo”是 AMD Ryzen AI Max 系列的代号,于 2025 年发布。其旗舰型号 Ryzen AI Max+395在单颗芯片上集成了16核Zen5处理器、集成式Radeon8060S图形处理器(40个计算单元,RDNA 3.5 架构,标识 gfx1151)以及一颗 AI加速器(XDNA 2 NPU)。最重要的是,它支持在 256位总线上使用高达128GB的LPDDR5X内存,由处理器与显卡共享。正因为如此,人们常谈起“AMD这对本地AI意味着根本性的变化:消费级显卡的显存上限通常为24或32GB,而这里GPU几乎可以使用整台机器的内存。因此,一个1250亿参数的模型(占用内存63GB)可以装进一台安静的桌面小机箱,无需独立显卡。代价是内存带宽(理论上256GB/s)低于大型显卡,所以经过专门优化的引擎才显得尤为关键(见第5章)。
2.2 为什么选Fedora
内核足够新:Halogen引擎需要包含AMD针对gfx1151修复的内核(Linux6.18.4或更高)以及驱动的共享虚拟内存(CONFIG_HSA_AMD_SVM)。Fedora在这些内核发布后第一时间随发行版提供(此处为 7.2)。
ROCm在官方软件源中:AMD的计算技术栈可随系统其余部分一起安装和更新。
Halogen的参考环境:Halogen的文档描述了它自己的Fedora测试主机(包括容器所需的SELinux设置)。
无根容器:Halogen、OpenWebUI和 SearXNG都在 Podman 中以非管理员权限运行。
2.3 数月如一日地承受负载
这台机器被当作服务器使用:它从不休眠(在StrixHalo芯片特有的挂起故障导致死机后,系统级关闭了休眠),并运行长达数天的任务。在实际使用中,处理器传感器峰值约为79至82C,上限为100C,没有出现降频。
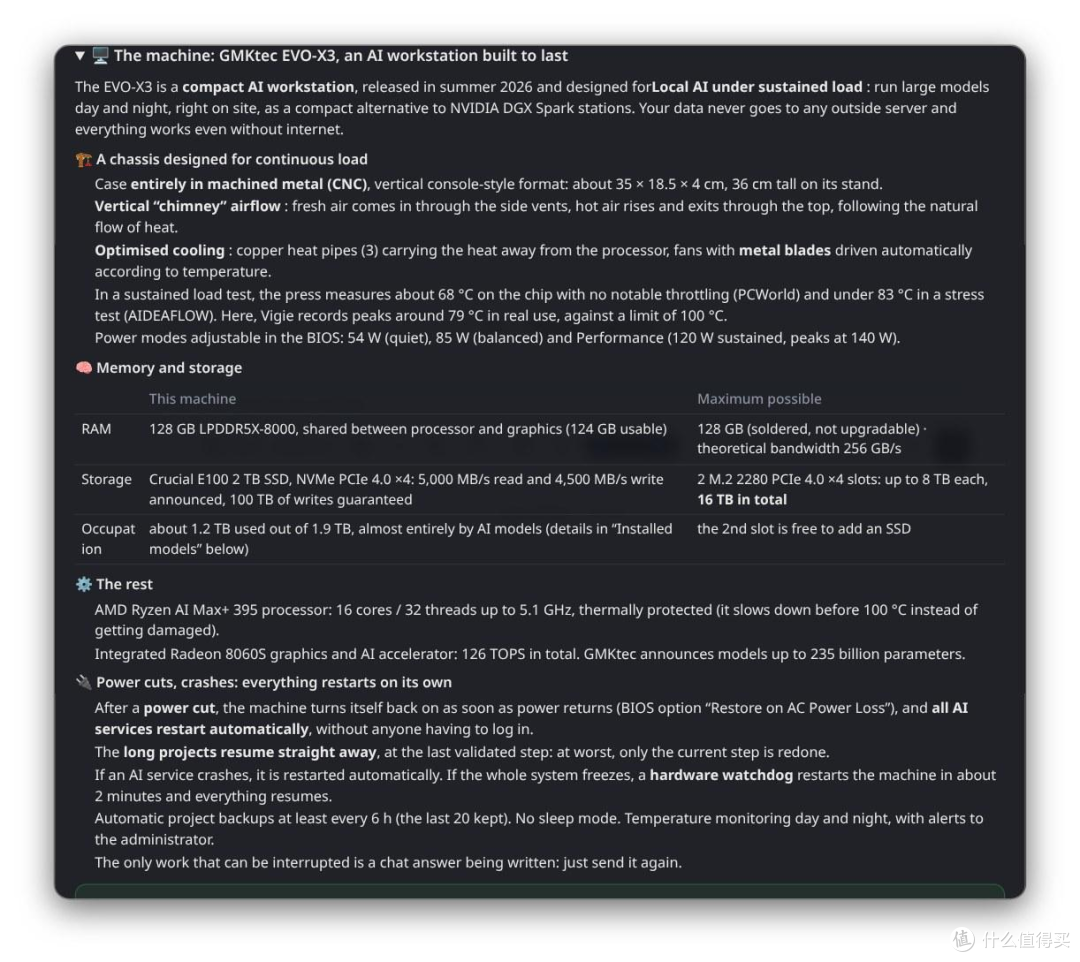
图1一在Vigie 中查看机器概览:机箱、内存、存储与韧性。
3.软件架构
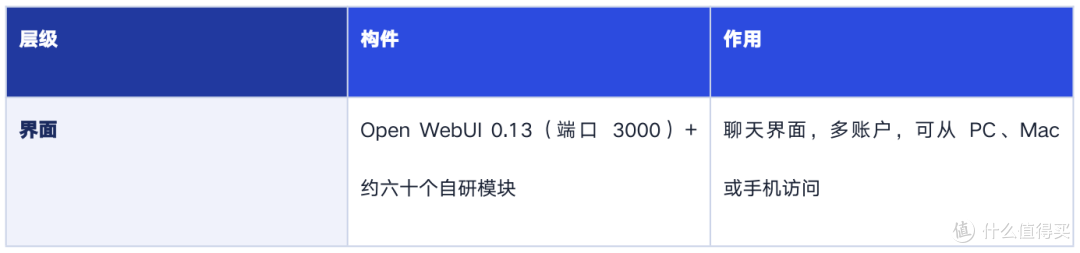
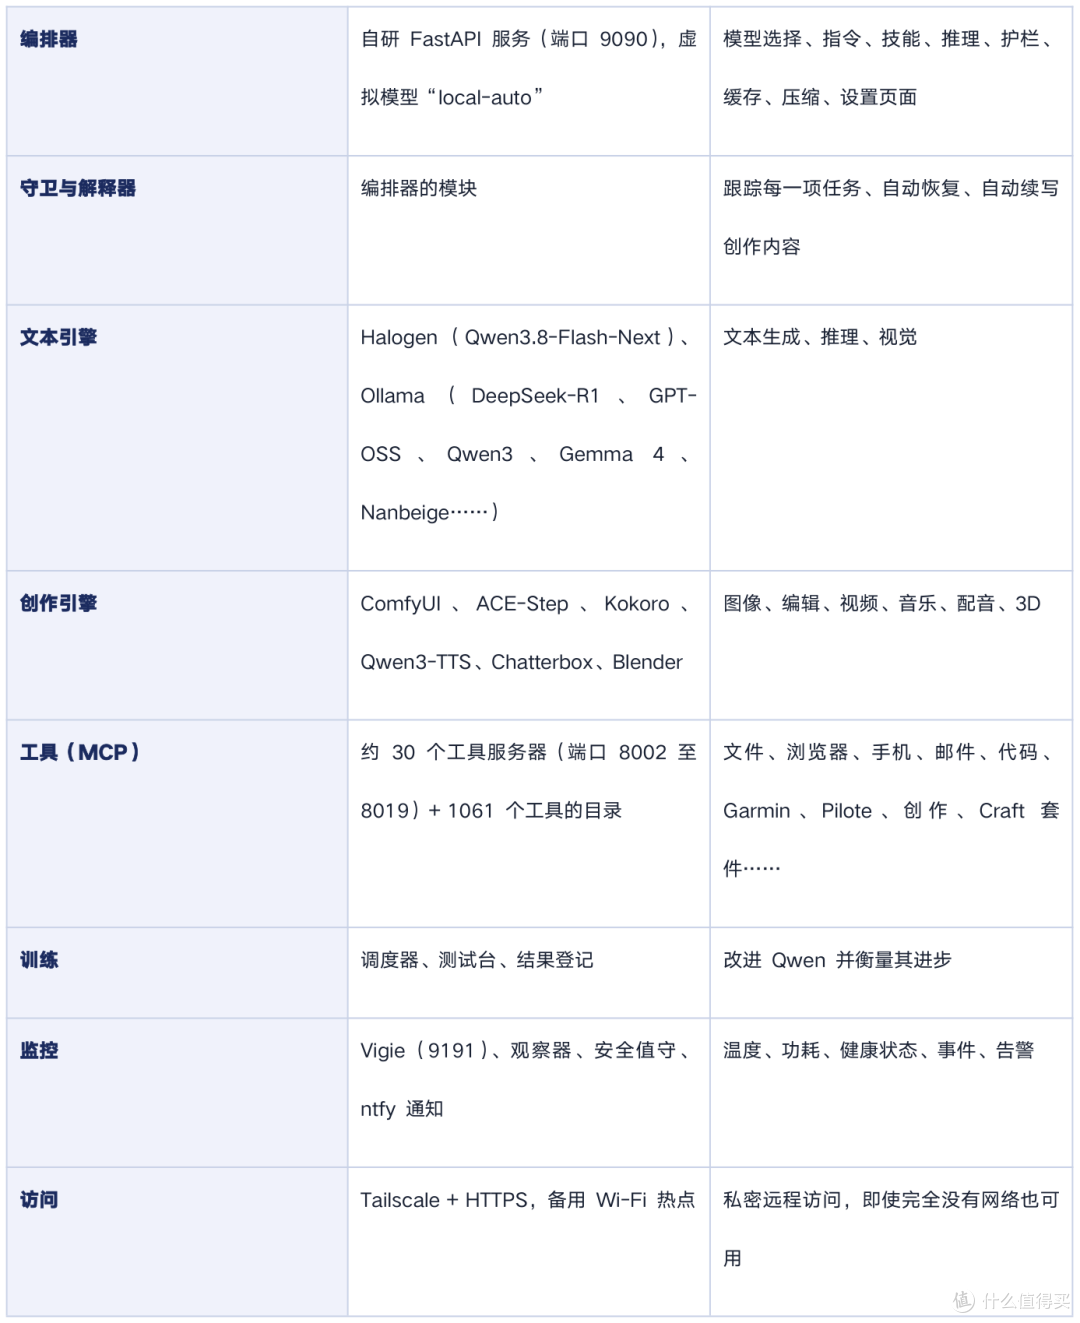
整套系统按层级组织。每个构件都是独立的服务,开机即启动、无需任何人登录,一旦出错便自行重启。
3.1 一个请求的流转路径
用户在Open WebUI中写入内容。默认模型是local-auto,这是编排器对外暴露的一个虚拟模型。编排器读取请求、工具栏按钮(技能、语言、推理强度、强制指定模型)以及用户账户,然后加上它的系统指令。
请求被发送给 Qwen3.8-Flash-Next。如果问题很难,或者带有 !!deep,编排器会切换到 DeepSeek-R170B;若DeepSeek仍找不到答案,再切换到GPT-OSS12OB。
Qwen调用它需要的工具;创作成果会直接出现在它的消息下方。
守卫跟踪每一个动作,在中断后恢复工作,并在Qwen需要用户时通过手机通知用户。
4.已安装的AI模型
共安装了约1.2TB的模型。它们按家族在界面中分组,每个模型都标出体积、所需内存以及能够运行它的机型。
4.1 语言模型
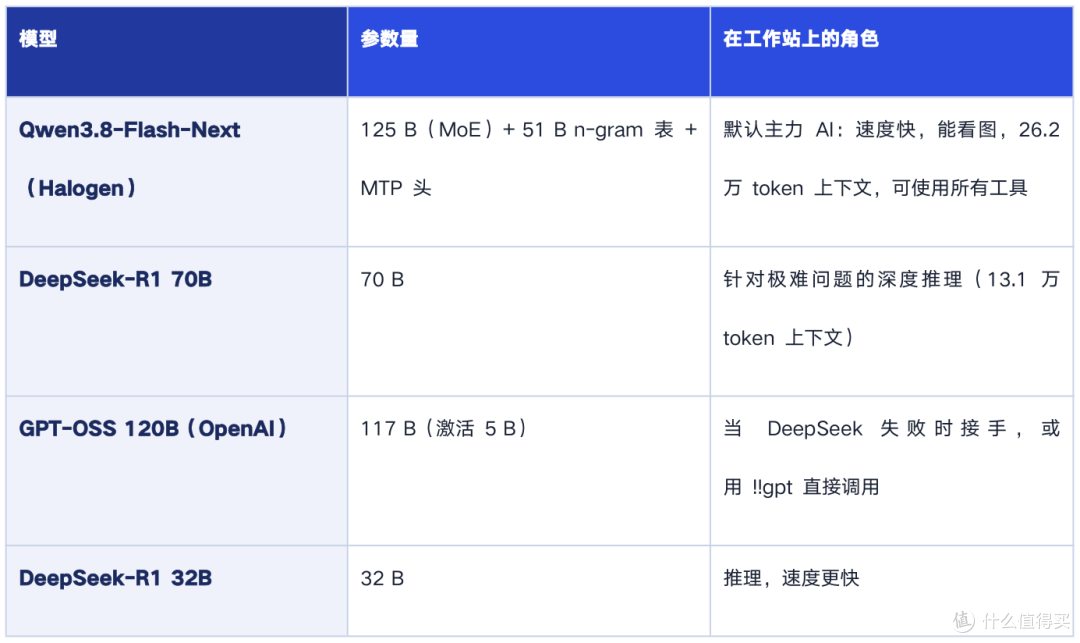
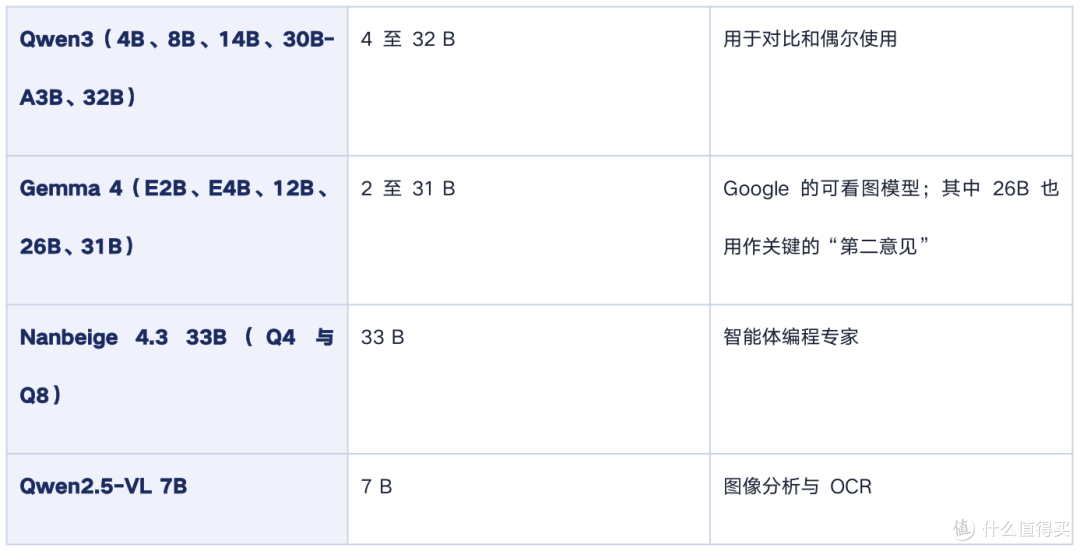
4.2 用于挑选下一台设备的沙盒
为什么要安装这么多模型,还分不同规模和不同量化等级(Q4、Q8、fp8、bf16...·)?因为这座工作站同时也是给尚未拥有自己AI工作站的用户准备的测试台。一个Q4的80亿参数模型能在较新的笔记本上运行,一个Q4的32B需要24GB显卡或32GB的MaC,而70B则需要像这样的统一内存机器。任何人都可以用“模型”按钮强制指定某个模型,在完全相同的环境(相同工具、相同指令、相同请求)中看到该模型在他们正考虑购买的设备上的表现。这足以判断:是立即投资某台电脑更划算,还是等到买得起能运行更好模型的配置时再说。
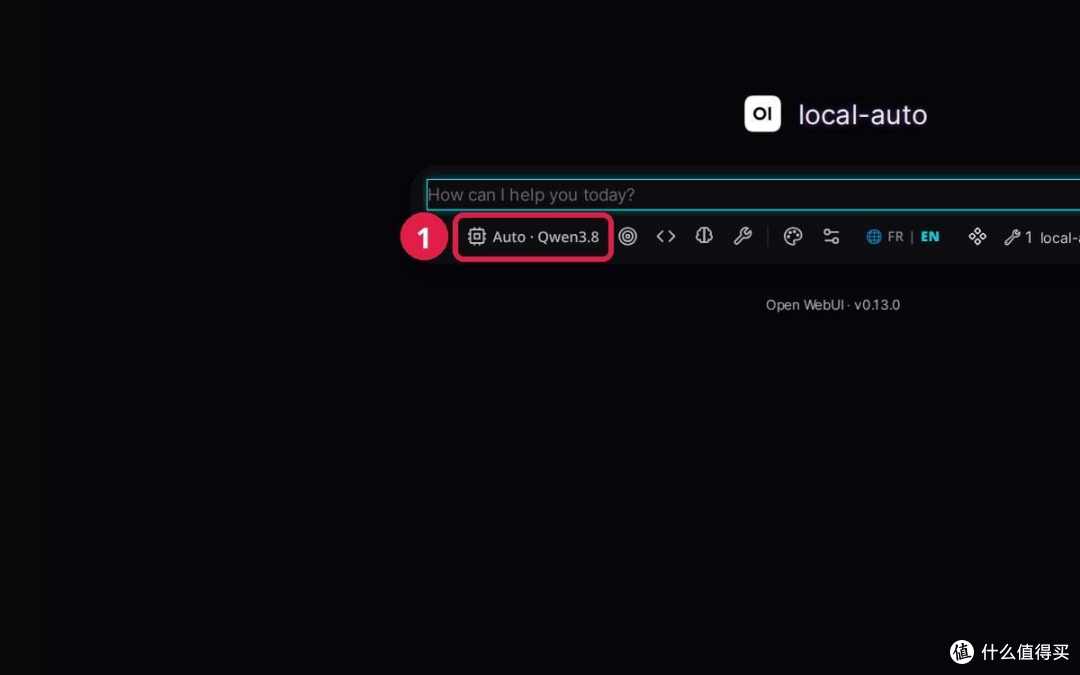
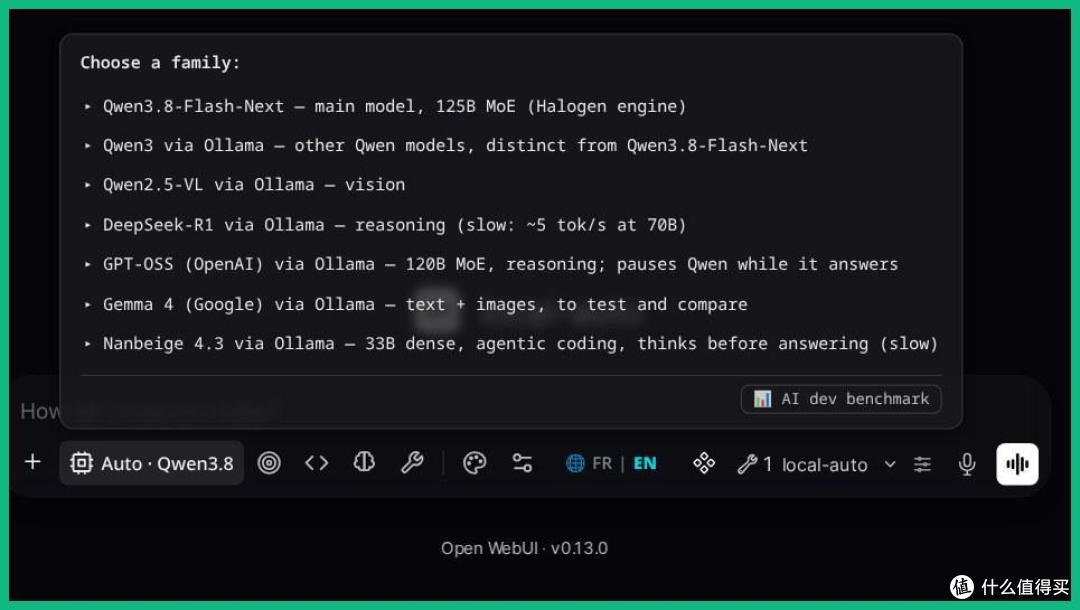
图2一访问路径:①工具栏中的“模型”按钮,然后选择家族和规模。
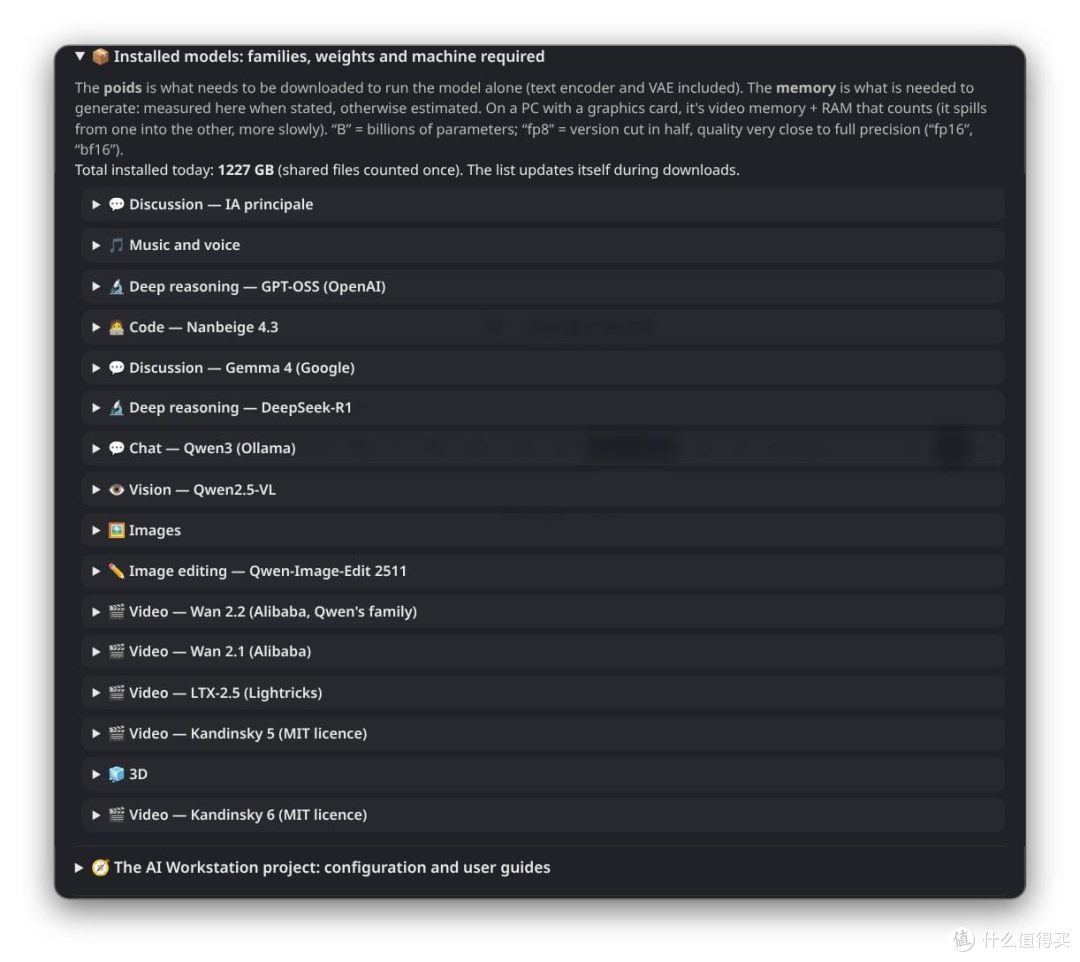
图3一Vigie 中的模型清单:家族、规模、所需内存与推荐机型。
4.3 创作类模型
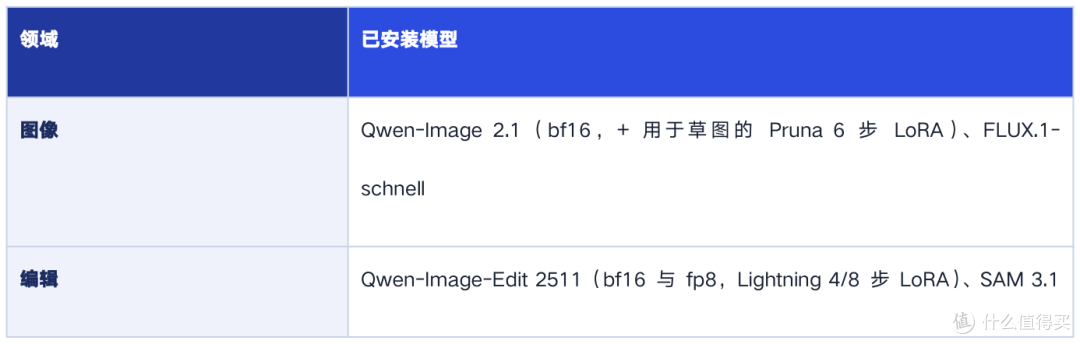
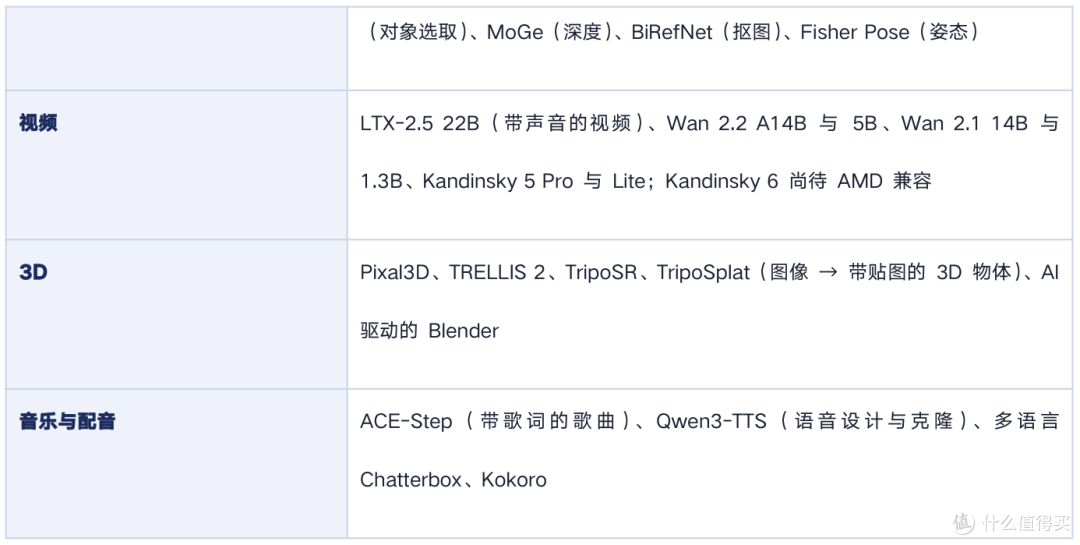
模型选择也考虑了许可协议:MiniMax H3和 Hunyuan3D因许可排除欧盟而被弃用;保留的模型均采用开放许可(Apache2.0、MIT....)或明确兼容的许可。
5.引擎
5.1 Halogen:Qwen3.8-Flash-Next背后的引擎
Halogen(halogen-flash-server,由发行方 Peonist 提供)是一款为单一模型、单一芯片编写的推理引擎:即 StrixHalo上的Qwen3.8-Flash-Next。它的所有计算内核都是为 gfx1151GPU手写,没有可移植层。这既让它比通用引擎更快,也使它无法在任何其他芯片上运行。它诞生的原因是:通用引擎(Ilama.cpp、vLLM..)无法充分利用这种统一内存和这颗仍较新的GPU——这种规模的模型在它们上面跑得太慢,无法满足智能体使用。
自研.hgn格式:权重平均每个参数4.16位(内存中约63GB);那个 51GB 的大 n-gram 表(FP8)直接从SSD读取,而不占用内存。
投机解码:模型的MTP头预先提出多个token再做验证;输出与逐字生成完全一致。此处实测:速度+27%。262,144token上下文,内置视觉能力,OpenAI兼容API。
受保护的启动:每次启动前,脚本会释放内存(ComfyUI、内核压缩),确保Halogen能获得足够的连续内存。
一个持续进化的引擎
Halogen由作者非常频繁地更新,每一批版本发布都带来可观的速度提升。本文所有速度测量、以及所描述的全部Pilote项目,都是用项目开始时安装的0.18.14版本完成的。机器在11月12日14:18升级到0.20.3。根据官方更新日志,这两个版本之间的提升如下:
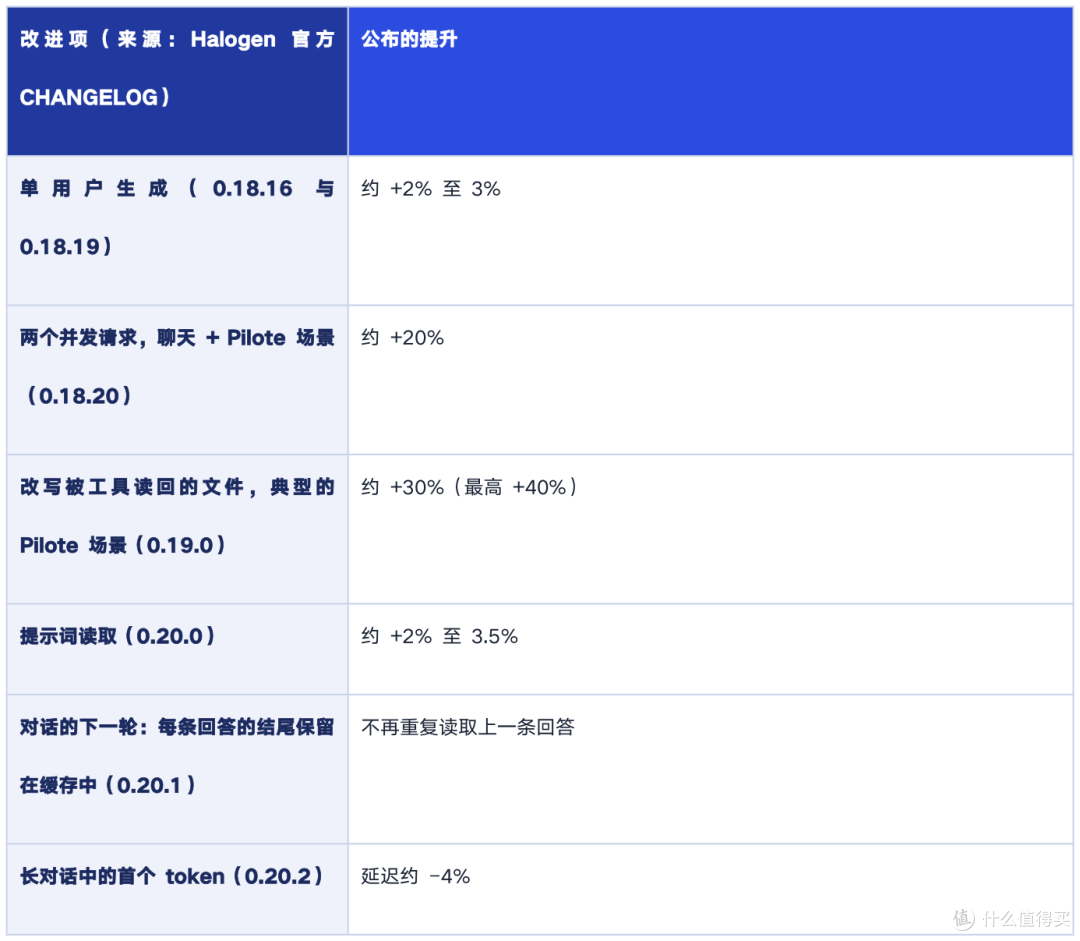
在更新前后各跑了一次小型固定测试(同机、同提示词、回答逐字一致)。它印证了所公布的“简单”提升;而大幅度的提升(+20%和+30%)涉及的场景,这种短测试无法复现:两个并发请求、被工具读取后又改写的文件。
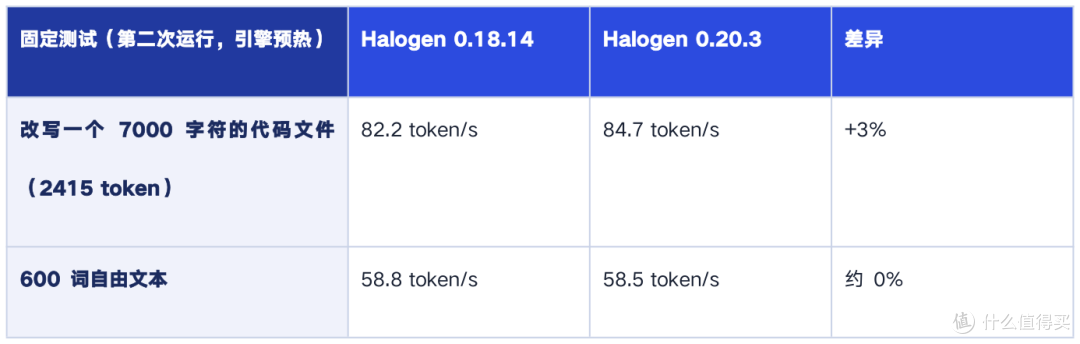
估计:在真实的Pilote工作中(聊天与项目并行、文件读取后又改写、长对话),本文测量所用版本比当前版本慢约10%至25%。这个区间是根据更新日志和上述测试推算的估计值,并非对完整项目的实测。
5.2 Ollama:模型库
Ollama承载其他文本模型。由于内存共享,在深度推理期间编排器会暂停Qwen:它停止Halogen,加载 DeepSeek-R1 或GPT-OsS,收集分析结果,释放内存,重启 Halogen,然后由 Qwen 写出最终答案。一把锁确保同一时刻只发生一次切换。期间发送的请求(例如在Pilote 项目由DeepSeek 加持时)会显示等待提示,并在Qwen返回后自动处理。
5.3 ComfyUI、ACE-Step、Kokoro:面向专家的界面
ComfyUI 运行图像、编辑、视频和 3D 的生成图。它的界面是为专业人士打造的:每张图都是一块画布,上面有几十个相互连接的节点和几十项设置。这些界面仍向专家开放,但没人需要打开它们:Qwen通过工具访问它们,选择图、设置参数,替我们启动生成。
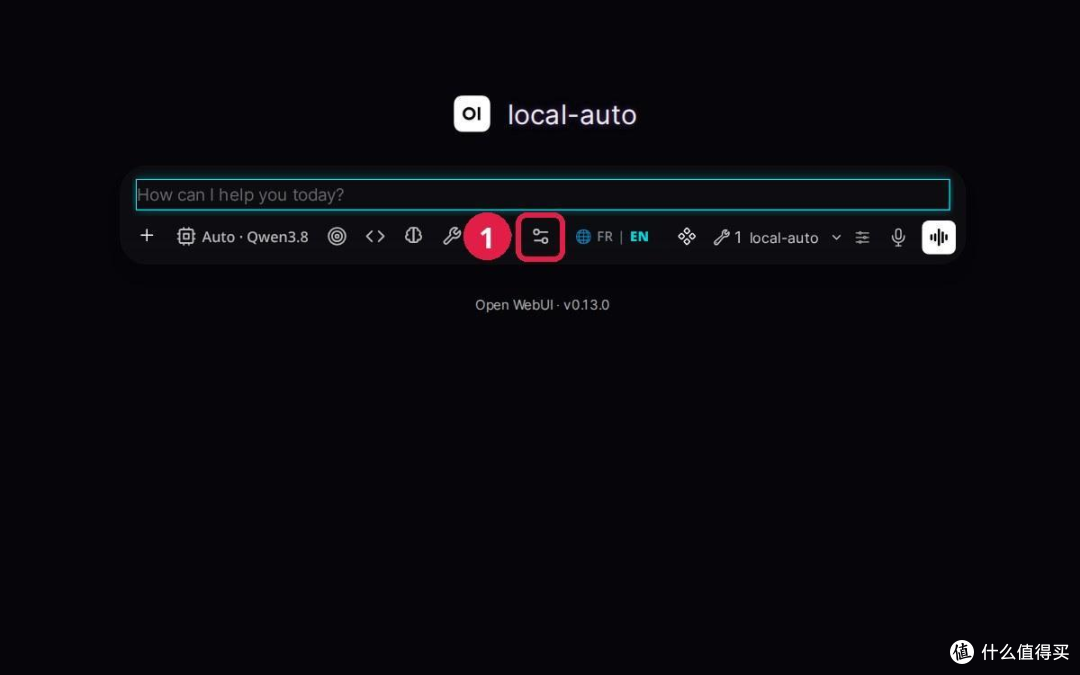
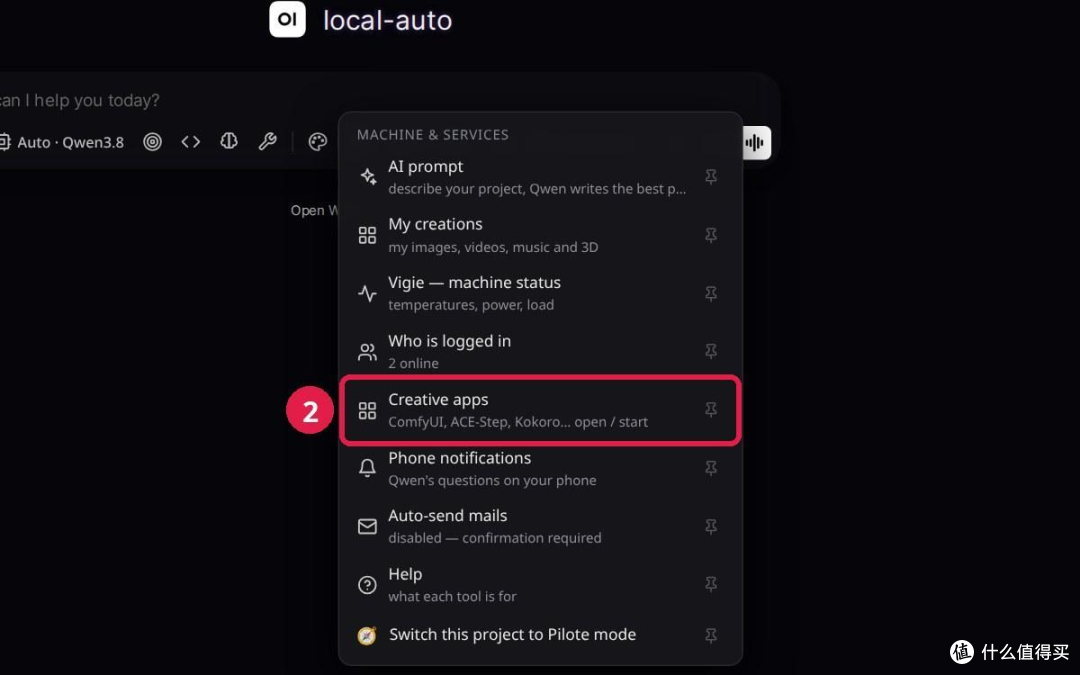
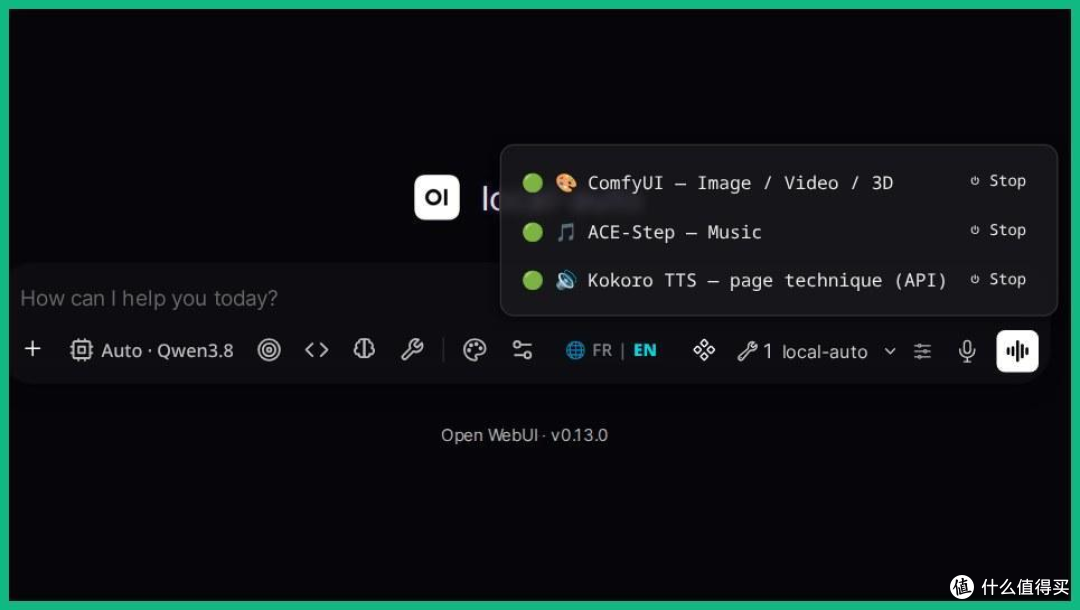
图4一访问路径:①“机器与服务”菜单,②“创作应用”:每个引擎都可一键打开、启动或停止。
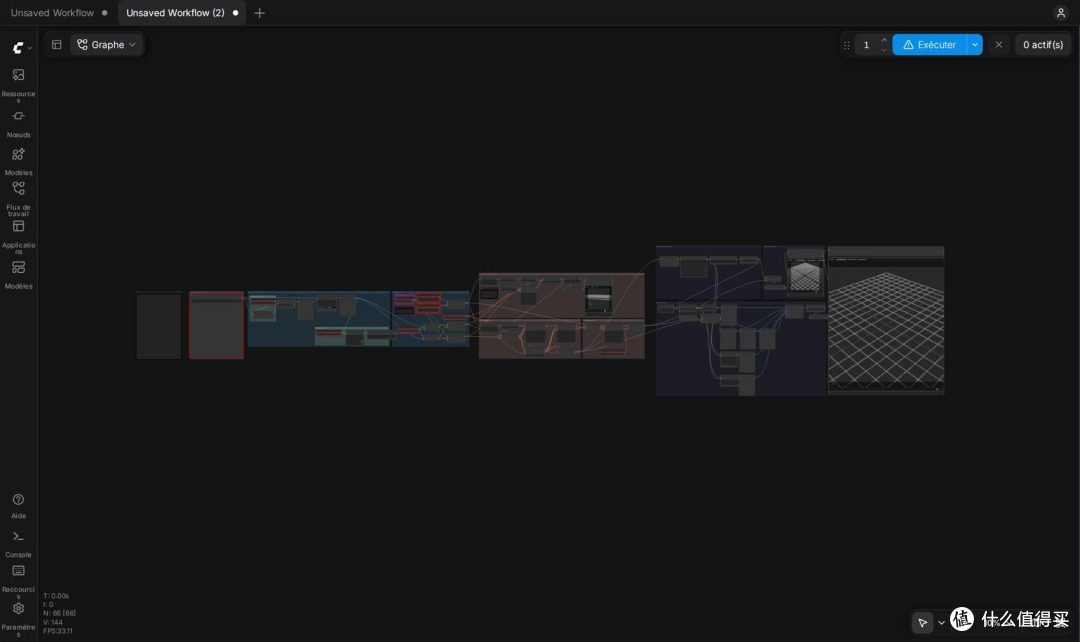
线织成的蜘蛛网。
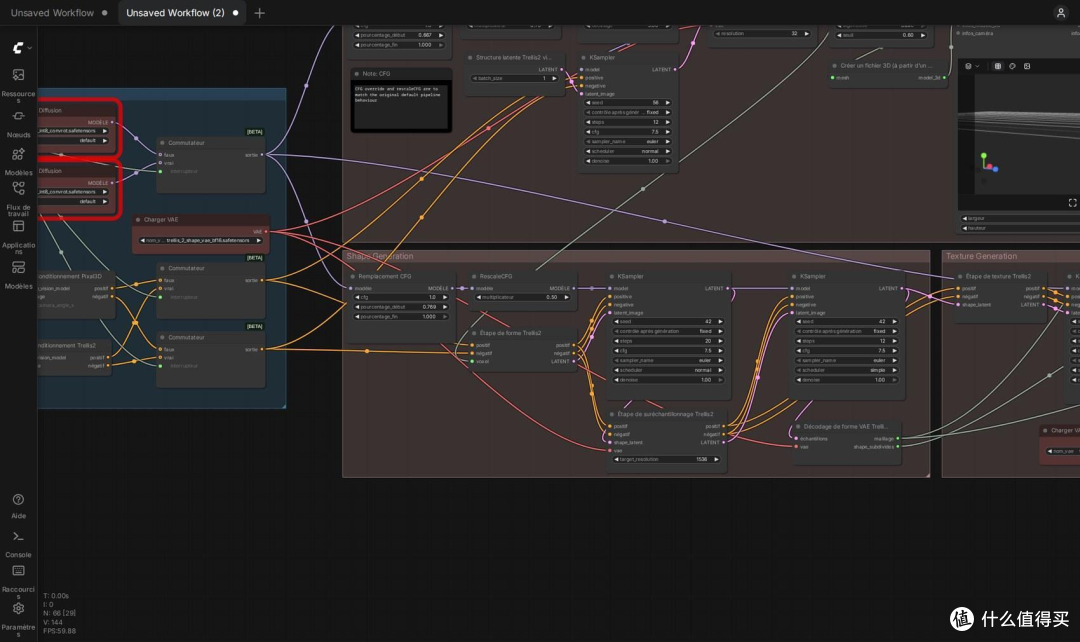
图6一同一张图的局部放大:模型、采样器、设置...这正是Qwen替我们配置的内容。红色框标出官方模板中需要调整的模型,Qwen会自动完成。
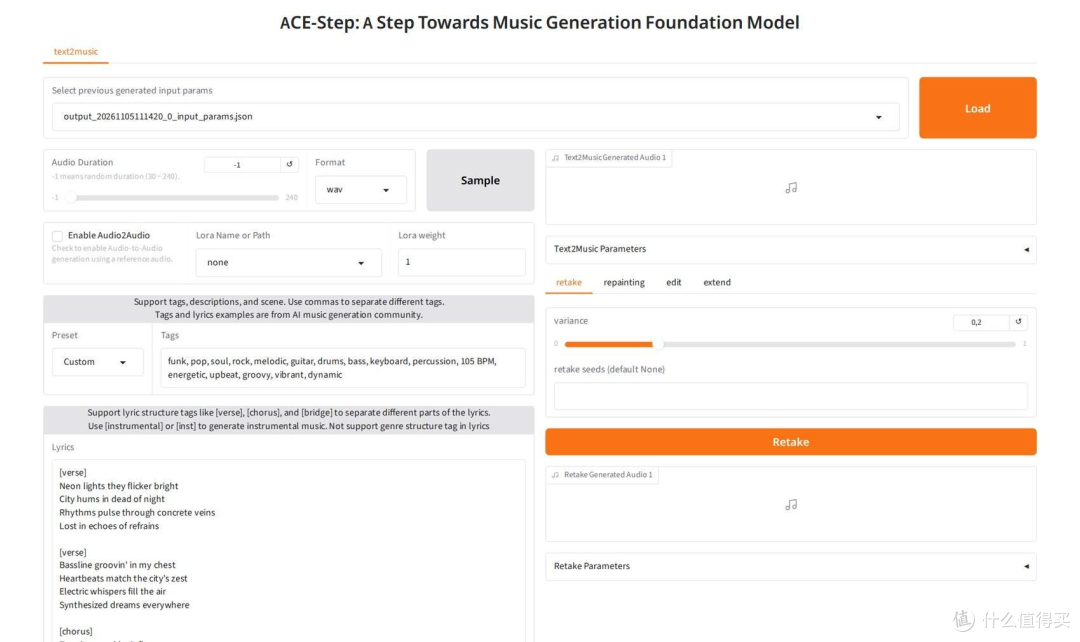
图7一ACE-Step,音乐创作界面:风格、歌词、时长、变体。
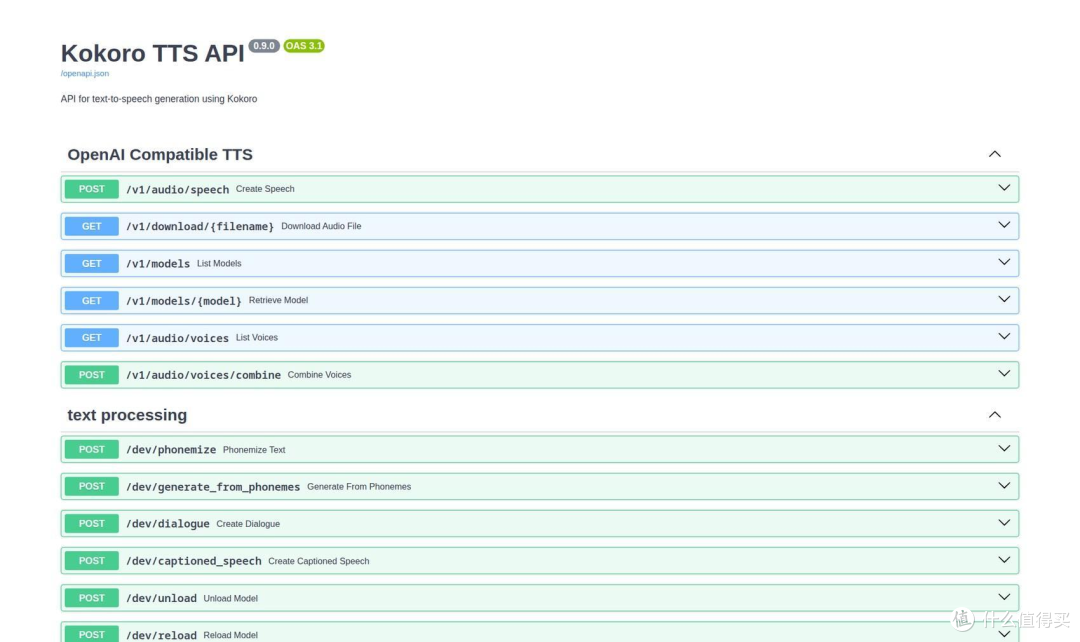
图8一Kokoro:语音合成,以技术服务(OpenAI兼容API)形式提供,聊天界面用它朗读回答。
5.4 共享内存:最主要的技术挑战
在重型生成(视频、Qwen-lmage、图像→3D)期间暂停Qwen:停止Halogen,全新重启ComfyUI,执行生成,然后把一切都重启回来。同时请求的生成任务会在同一次暂停中依次进行。
为每个用户显示暂停窗口,附带预计恢复时间和“Qwen已回来”的通知。
内存监视:每30秒检查一次,若ComfyUI空闲却占用过多内存,就释放并重启它。
单一入口:连OpenWebUI内置的图像工具也经过“创作”工具,因此暂停永远不会被绕过。
较新的 AMD PyTorch(ROCm 7.13 for gfx1151)配合 flash attention:视频生成快了4.7 倍
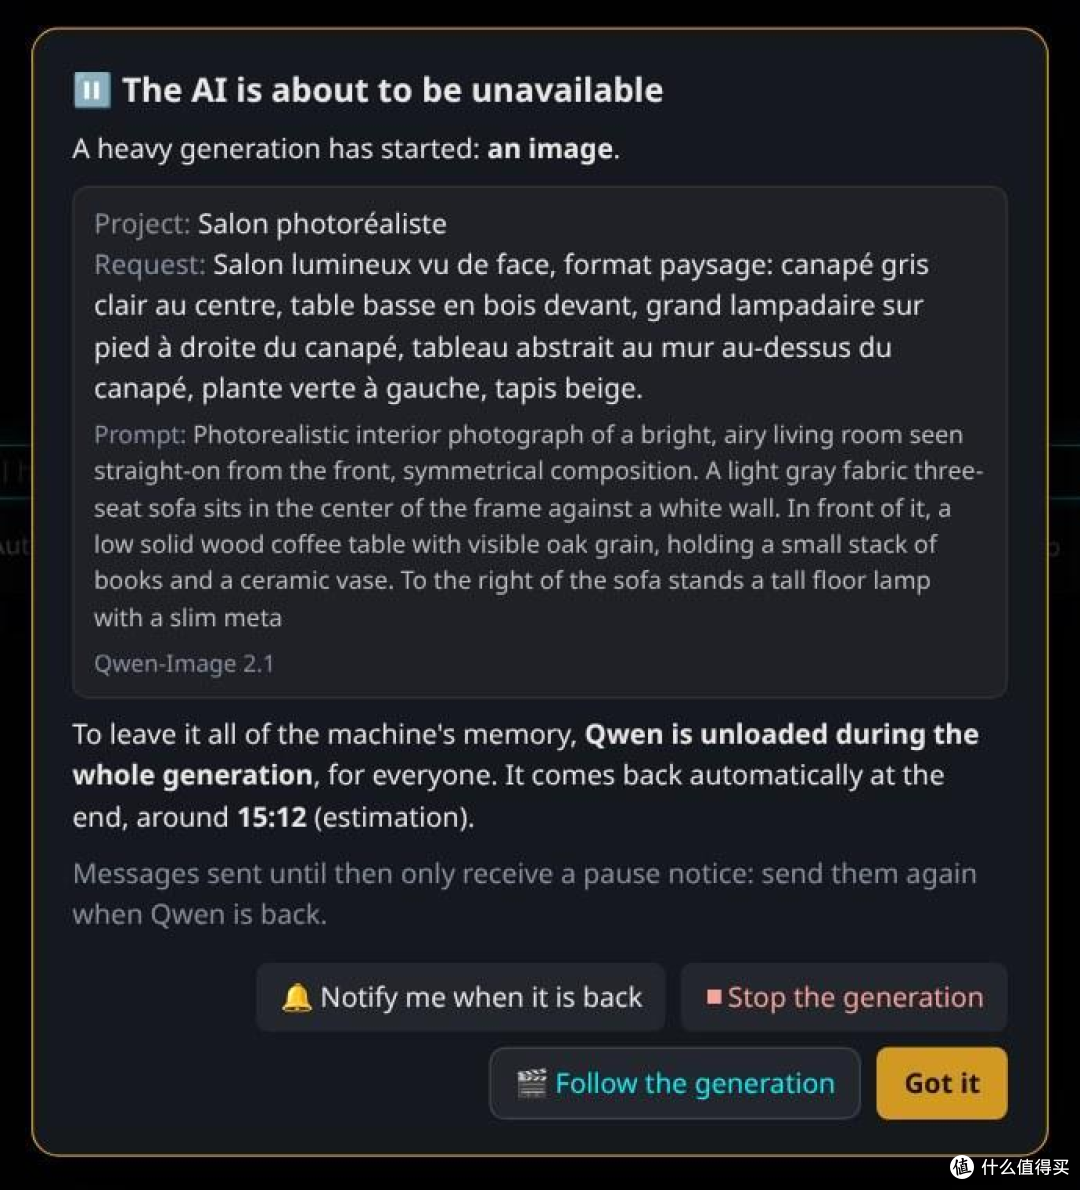
图9一暂停窗口,重型生成期间向每位用户显示。
5.5 编排器的设置
一个仅限管理员的设置页面(地址http://<机器>:9090/settings)控制DeepSeek与Qwen的上下文、内存安全模式和投机解码。更改Qwen 的上下文会重启Halogen(约4o秒)。
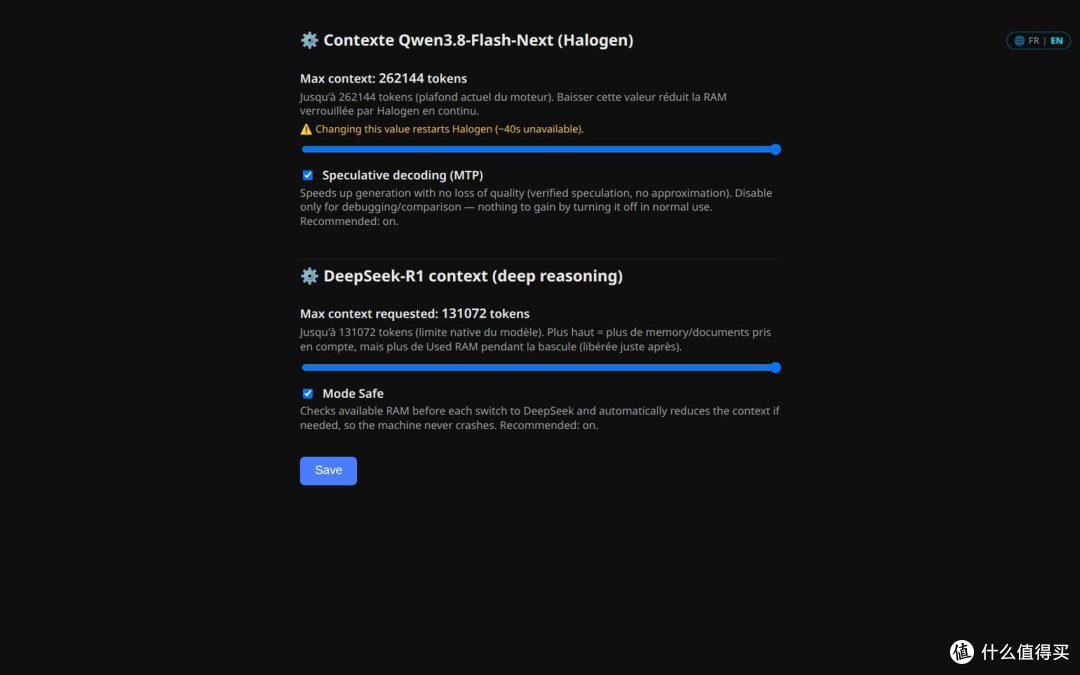
图10一编排器的设置页面。6.编排器:整套系统的指挥
编排器是一套约一万行的自研服务,位于Open WebUI与各引擎之间。对 Open WebUI而言它只是一个模型“local-auto”;在幕后,它决定一切。
路由与推理链6.11
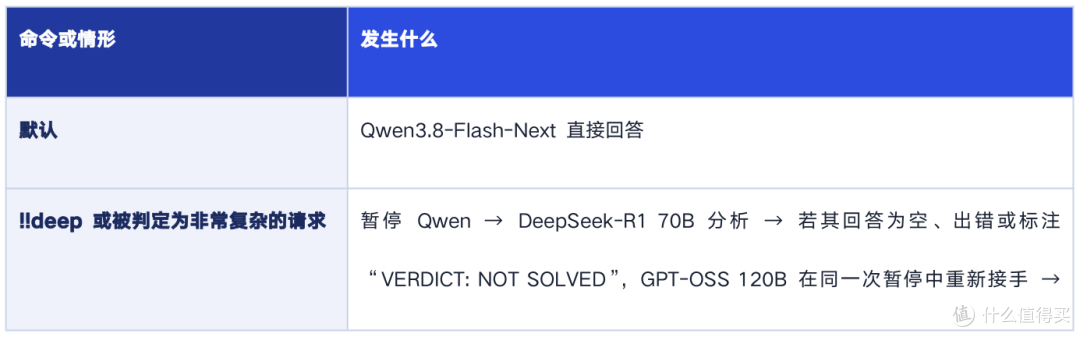
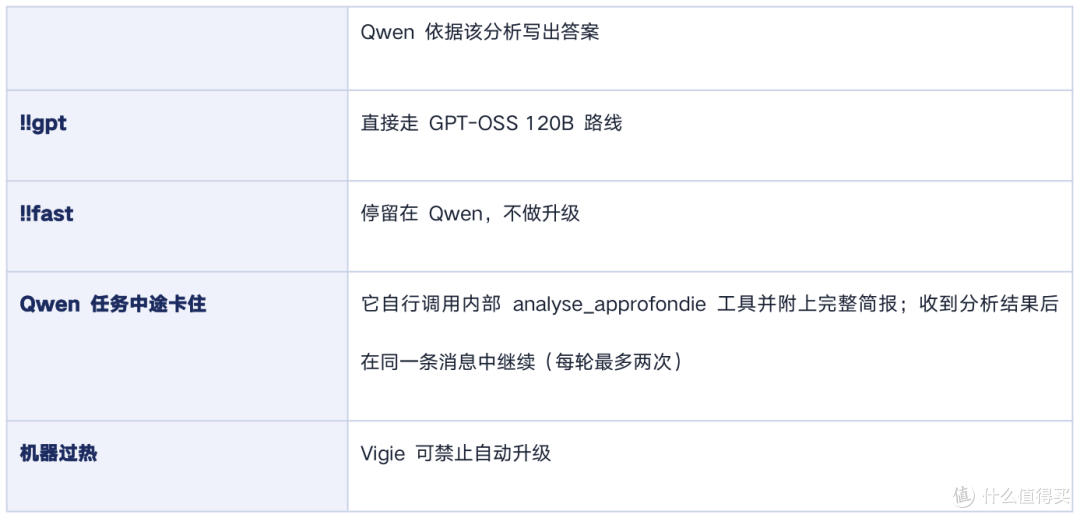
6.2 系统指令
每次请求时,编排器都会加上一段固定的指令块,逐轮完全一致,以利用缓存:模型的确切身份、拒绝无理由的推脱、对自身局限保持诚实(“我没有手段”不等于“我拒绝”)、选择题、项目记忆、发送邮件、创作工具、编码严谨性(先测试再声称可用)、自我检查以及等待远程设备。可变元素(本轮的技能、语言、推理强度、英文模式)则在最后一条消息之前插入。
6.3 缓存:在本地硬件上的速度
在本地机器上,重读一段长对话代价很高。一切都经过安排,使请求的开头在逐轮之间保持完全一致:更改某项技能或推理强度只会重新计算结尾部分(实测:1万token上从4.9秒降到0.3秒)。一项自研测试“CacheHunter”会核查这些特性(6/6通过)。
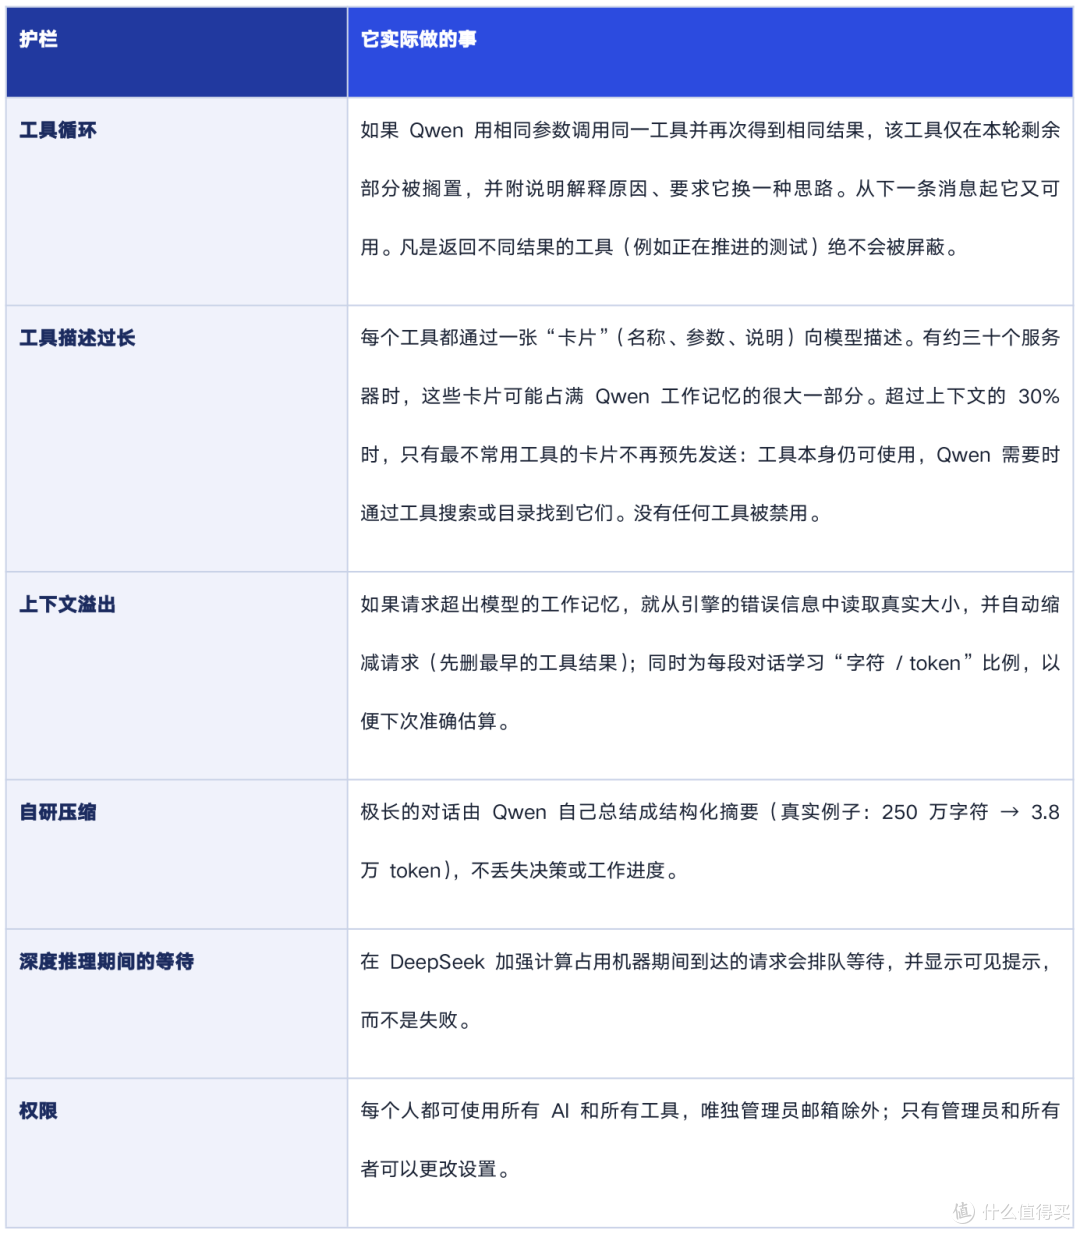
6.4 安全护栏
这些护栏不会拿走用户任何功能:它们防止Qwen原地打转、耗尽工作记忆或无声地失败。
7.Qwen的推理能力
Qwen3.8-Flash-Next可以先思考再回答。思考越多越可靠,但越慢:所有工作都围绕让它“想得刚好够”展开。
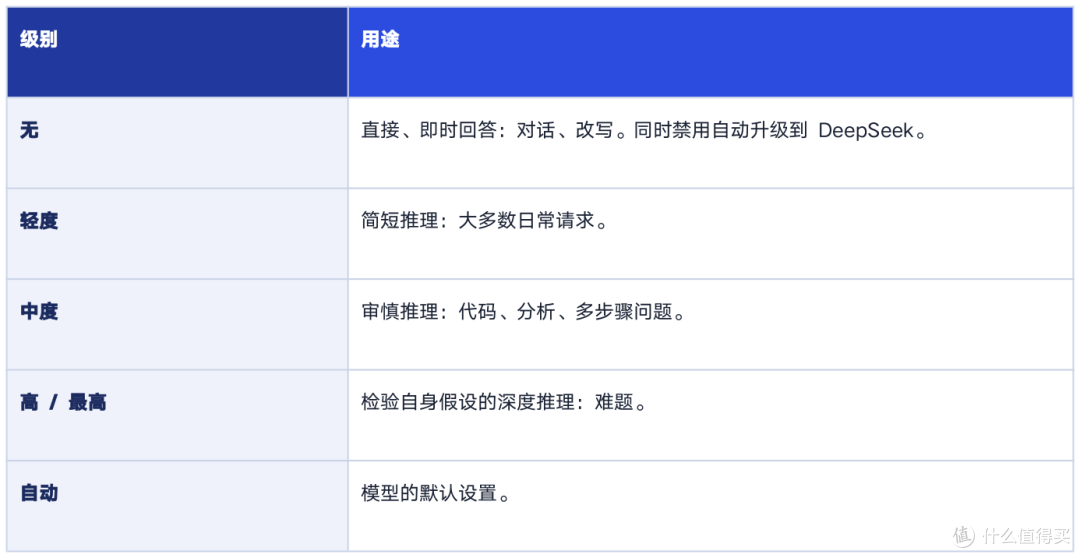
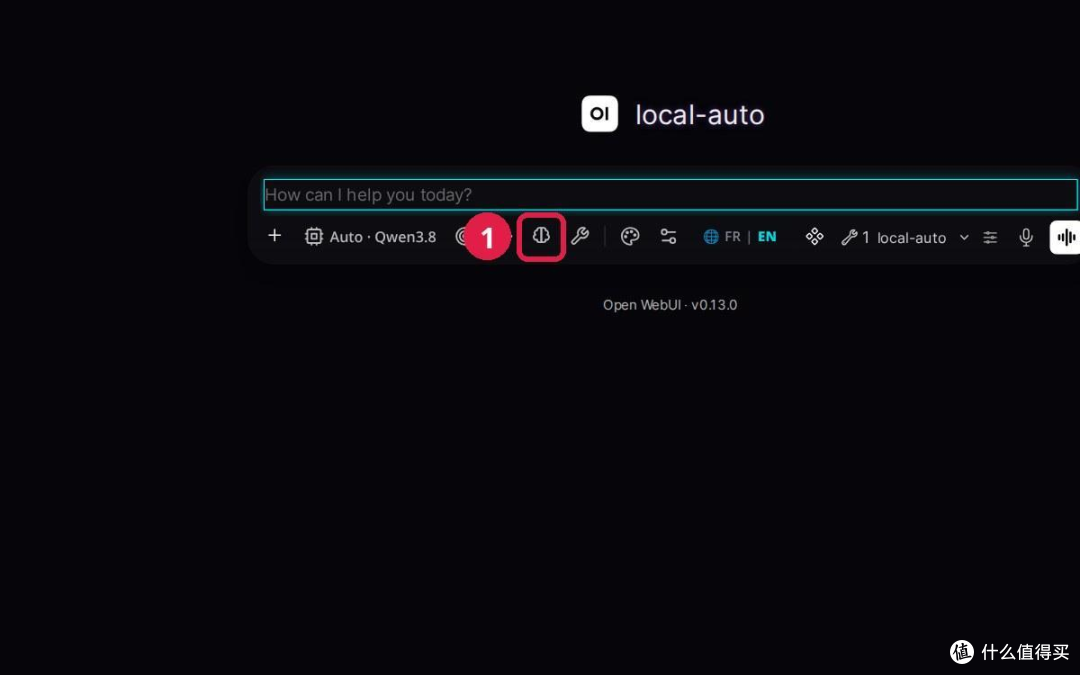
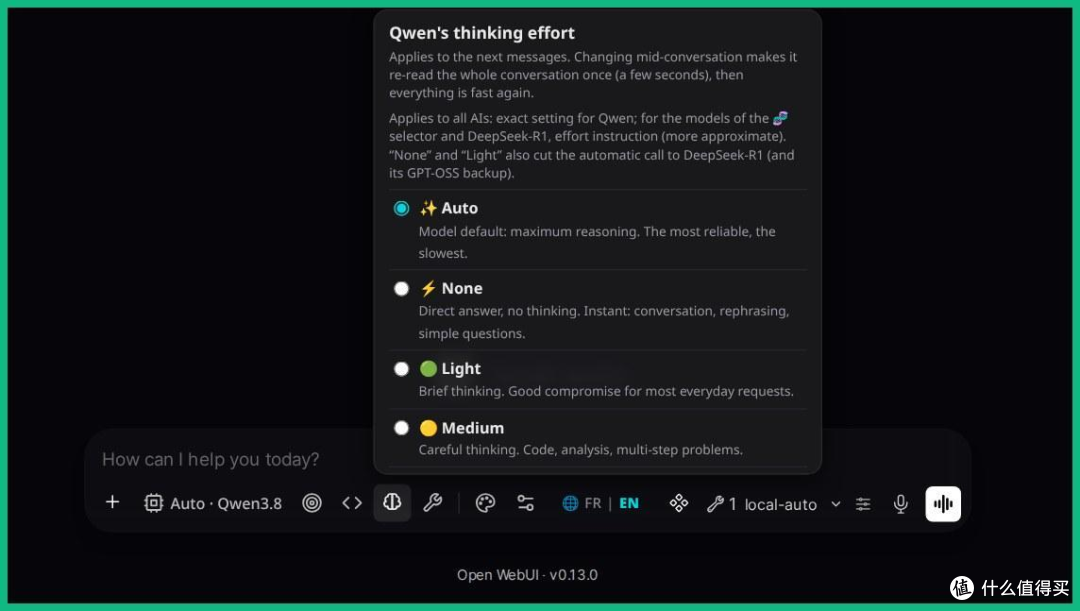
图11一访问路径:①工具栏中的“推理强度”按钮。
在Pilote和测试台上,规则与通常的直觉相反:Qwen以最低推理强度起步,由引擎在Qwen吃力时提高它(“级别升级”):每次失败上调一级,当推理已达最高级时则以DeepSeek-R1作为增援。Pilote还会记住一个项目的难度:三步中有两步较难就提高基准级别,连续三步容易则降低。自11月12日起,每一级的推理长度也设有上限(700至3000token),让Qwen写得比想得多。
8.守卫程序与解释器
8.1 守卫:任务绝不能被中断
守卫监视Qwen使用工具工作的每一段对话。它每15秒检查一次工作是否在推进,否则就介入:
卡住的轮次、错误或重启:它自行重启Qwen(“自动恢复”),延迟逐级增加;若仍卡住则通知手机。
设备掉线:若Qwen正在操作的MacBook或手机断开连接,Qwen会等它回来再继续。
只说不做:若Qwen最后只说“我来处理”却没行动,守卫会提示它“现在就做”。虚构链接:若Qwen给出某个并无工具生成的创作链接,会被纠正。
步骤跟踪器:一个徽章“Qwen 正在工作·6 分钟·12 步”实时显示每一个动作,手机端同样可见。
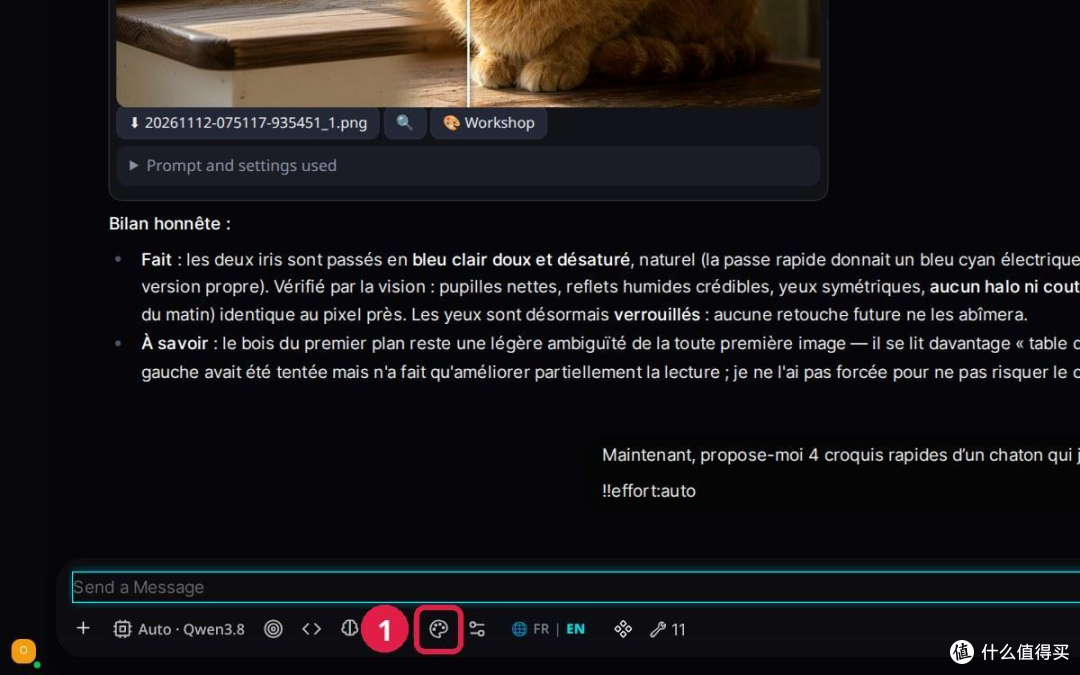
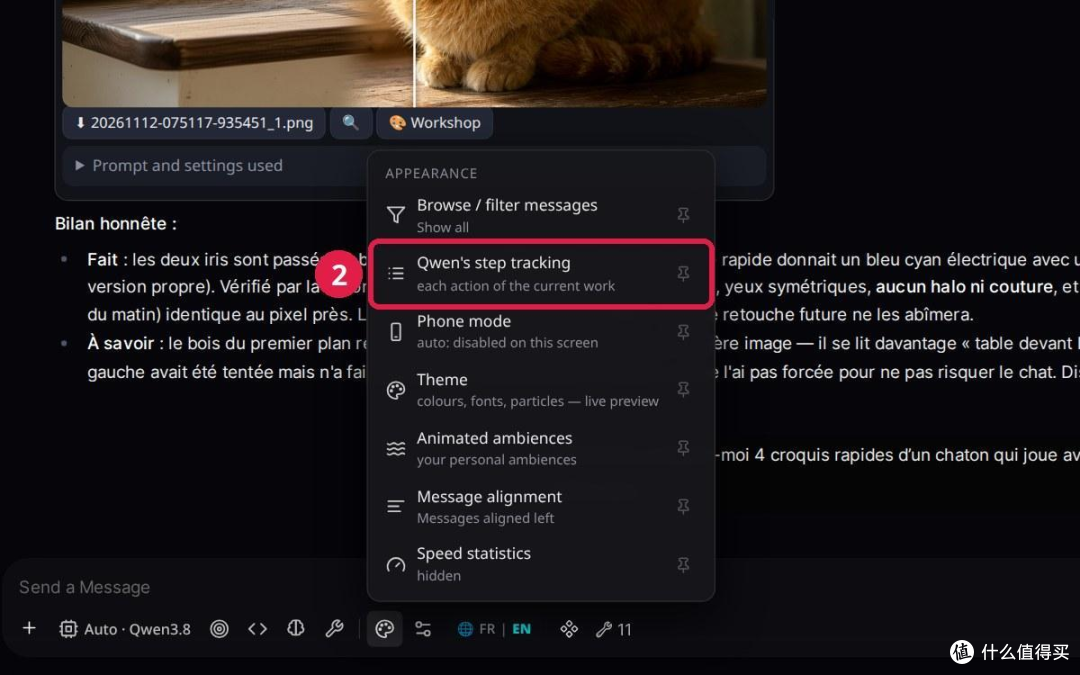
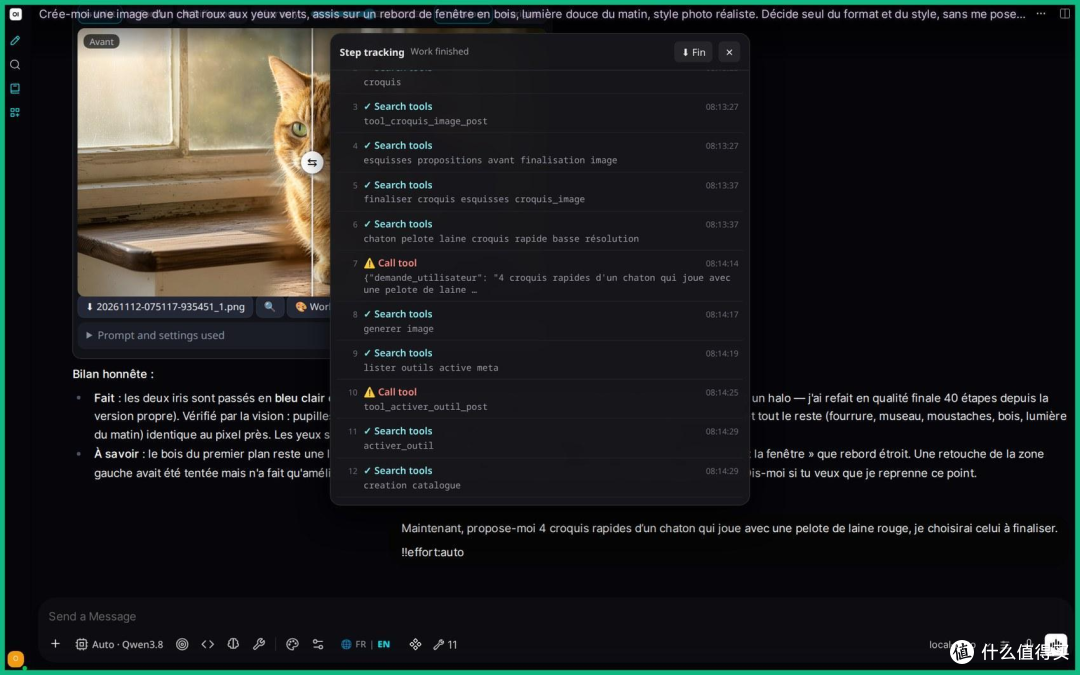
图12一访问路径:①“外观”菜单,②“步骤跟踪器”:Qwen的每一次搜索、选取、编辑和检查,均带时间戳。
8.2 创作解释器
一次图像或视频生成要几分钟,期间Qwen处于暂停状态。解释器填补这段空档:当创作完成、Qwen重新加载后,它会把带图像的通知发到手机,然后自己在对话中发布一条“自动续写”:结果、原始请求和计划。接着Qwen用视觉检查成果,必要时修正,再进入下一步,最多连续12次,用户无需守在屏幕前。第13章的演示展示了它在真实场景中的表现。
通过通知,用户可以批准、重做或编辑。手机端的编辑页面可点选对象、用手指圈出区域、保护某块区域或回到上一版本;生成期间发出的指令会被排队,在自动续写时传给Qwen。
9.界面:量身定制的OpenWebUI
基础界面是OpenWebUI,并叠加了约六十个自研模块。为保持屏幕清爽,它们被归到输入框下方的一条工具栏里:五个直接按钮(模型、技能、语言、强度、工具)和两个菜单(外观、机器与服务)。每个菜单项都可以固定到工具栏。
如何阅读“访问路径”图示:每个带编号的缩略图①、②、③指示屏幕上要点击的区域,按钮以红圈标出;最后一个缩略图带绿色边框,显示打开后的界面。
9.1 主题:六个截然不同的范例
每个账户都能完全自定义界面:颜色、字体(约80种可选)、按钮形状和立体感、背景图案或图片、动态粒子,并在真实聊天中实时预览;有53个预设、随机抽取、历史记录和通过代码分享主题。全部80种
(正文至少4.5:1);一项“按钮图标”设置让OpenWebUI的小灰色图标变得清晰可读。以下是同一段对话在六种主题下的样子:
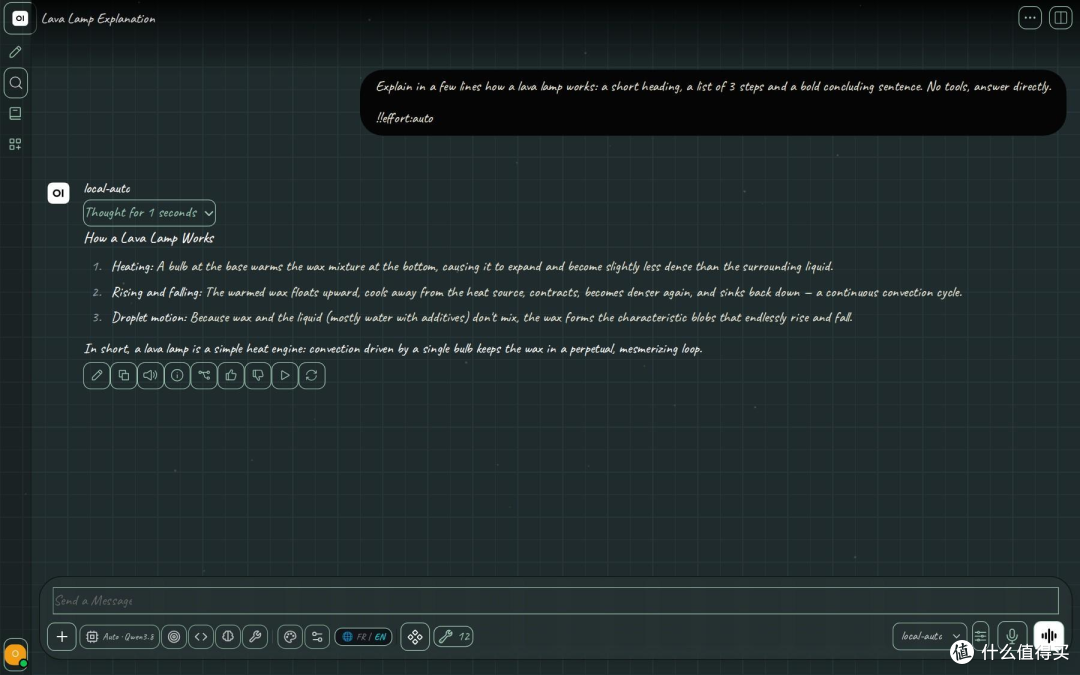
图13一“Slate(石板)”主题:手写字体(Caveat),粉笔配石板,克制的描边按钮。页面实测对比度:正文至少9:1,按钮和图标至少7:1,高于设计章程4.5:1的下限。
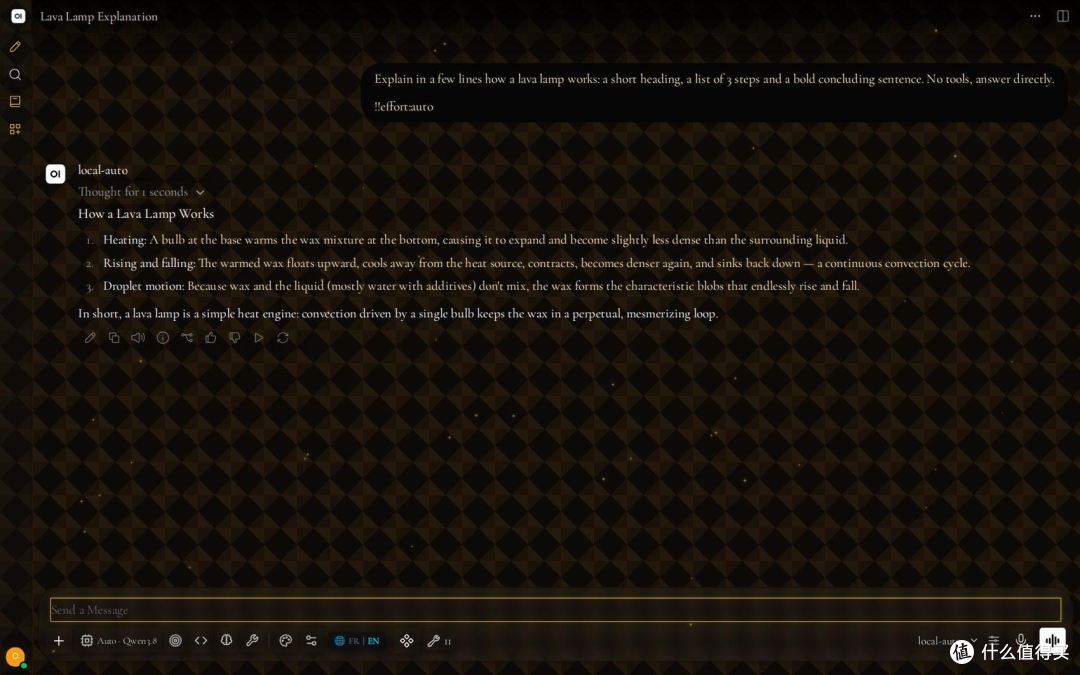
图14一“Golden Grimoire(金色魔法书)”主题:Cormorant字体,菱形花纹,金色闪光缓缓上升。
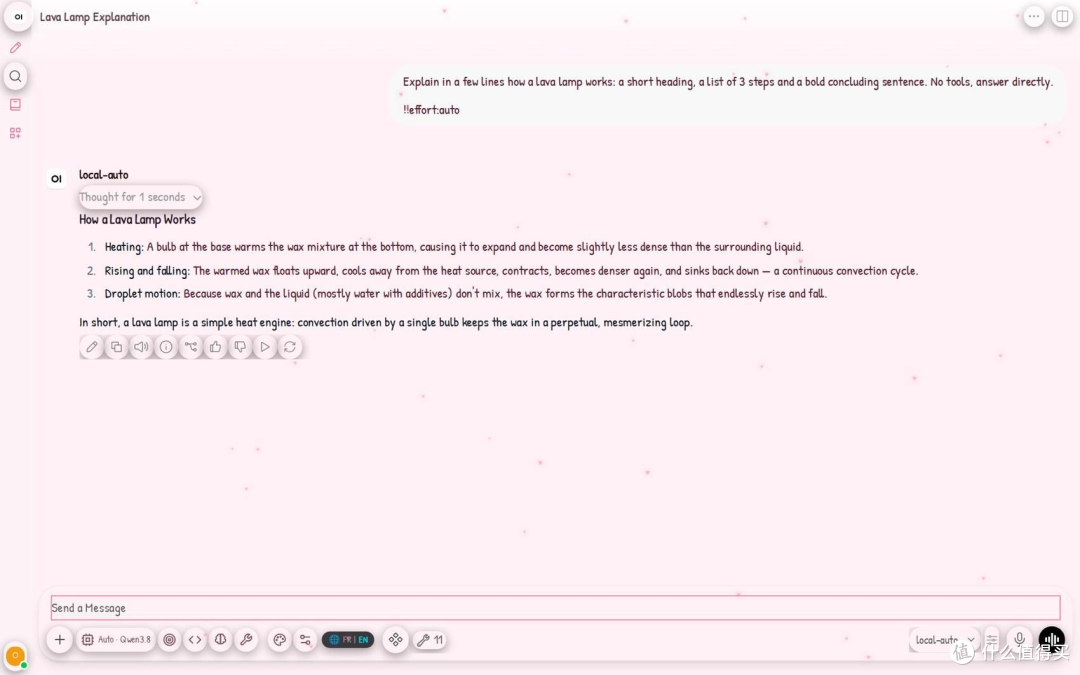
图15一“Sakura(樱花)”主题:浅粉色主题,手写 Patrick Hand 字体,飘落的心形,药丸形按钮。
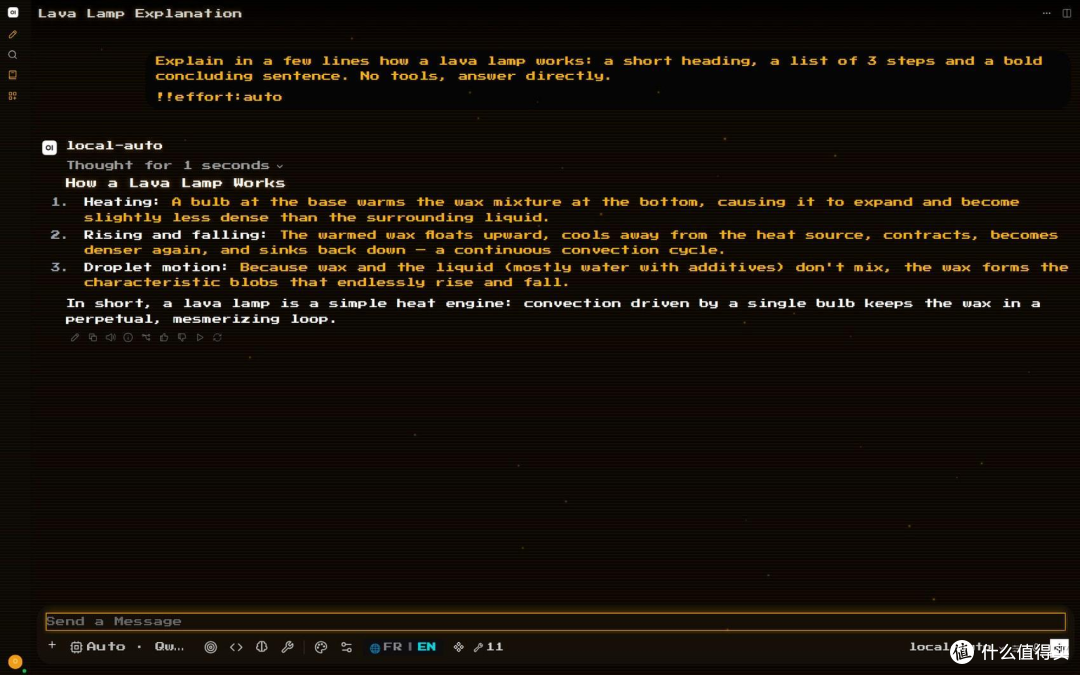
图16一“AmberTerminal(琥珀终端)”主题:Press Start 像素字体,扫描线,琥珀色像素。
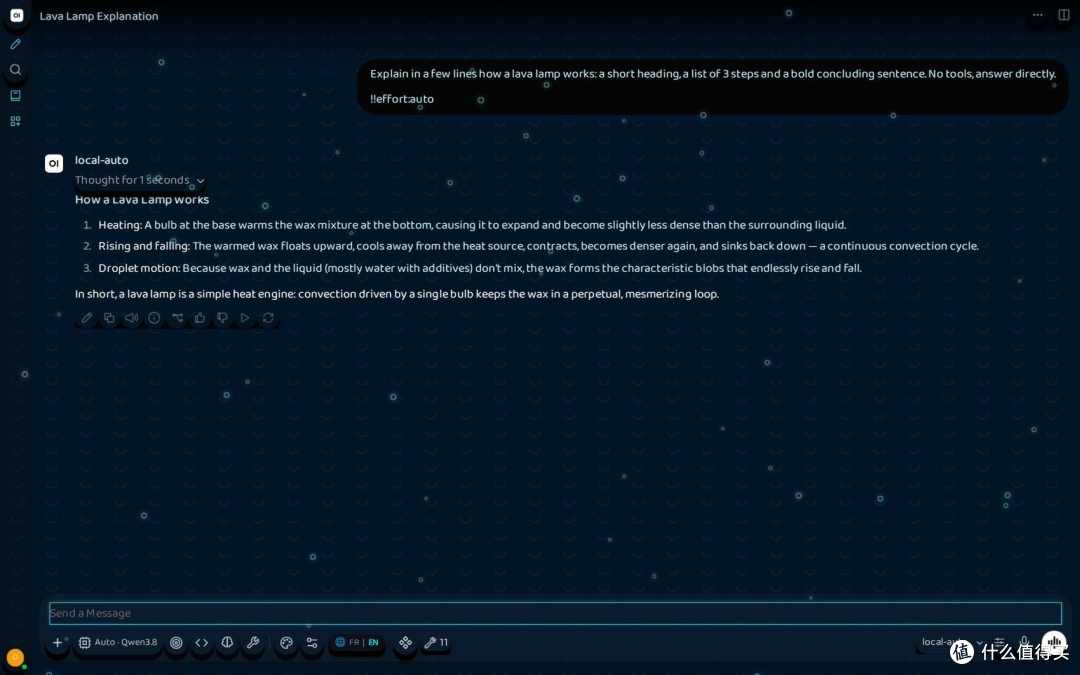
图17一“Ocean(海洋)”主题:Baloo2字体,背景波浪,上升的气泡,3D立体按钮。
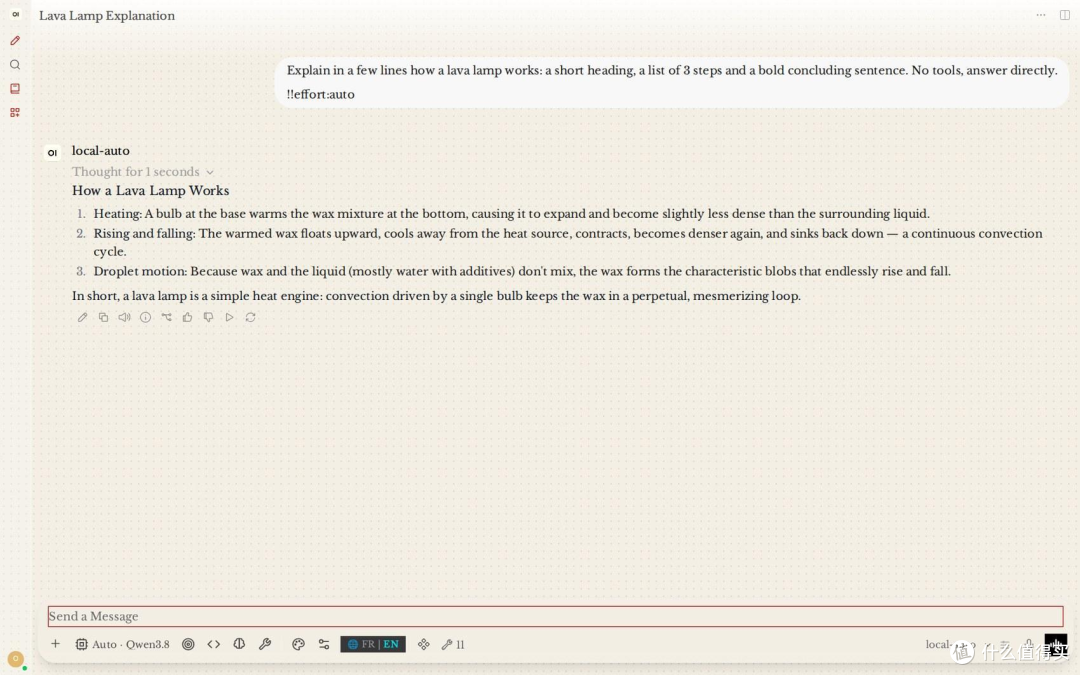
图18一“Newspaper(报纸)”主题:米色纸张,Libre Baskerville 字体,网点印刷,棕褐色图片。
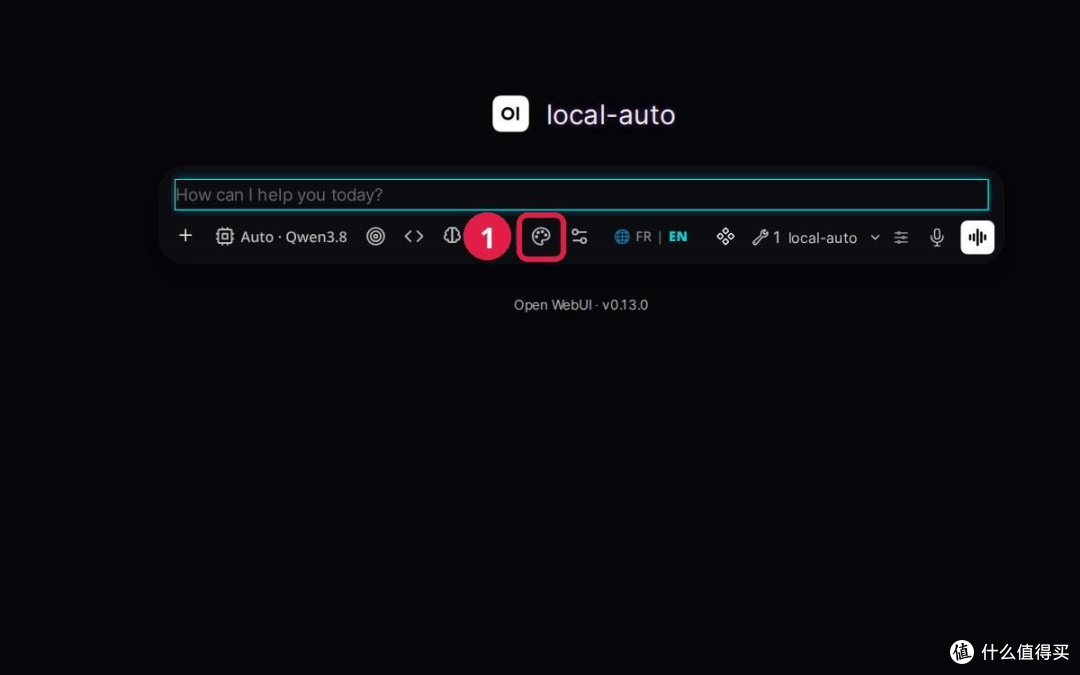
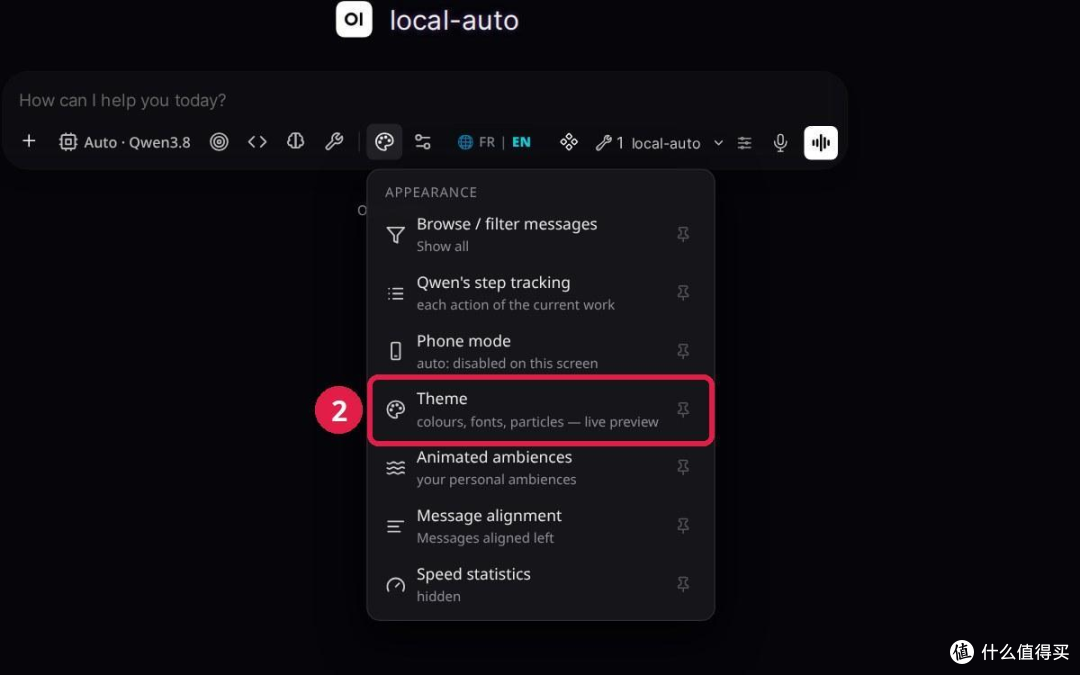
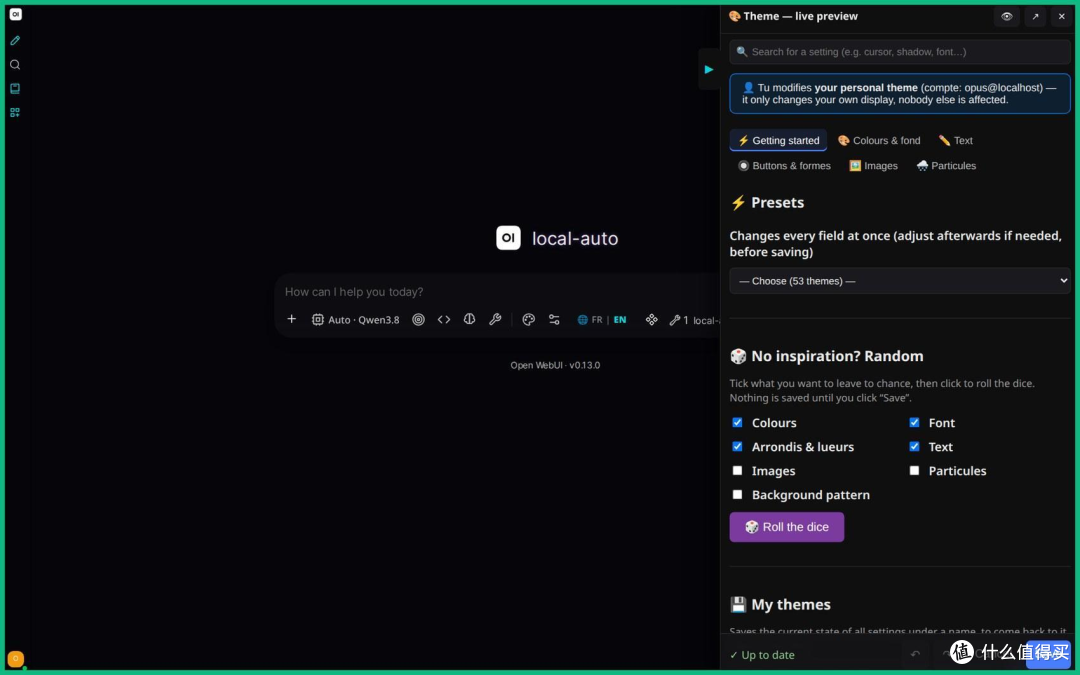
图19一访问路径:①“外观”菜单,②“主题”:编辑器在侧边打开,每项设置实时生效。
9.2 动态氛围场景
氛围工作室提供97种动态效果(WebGL与canvas)、42种配色,最多可叠加4层,支持自动轮换、惊喜模式或与一天中时段相匹配的氛围。
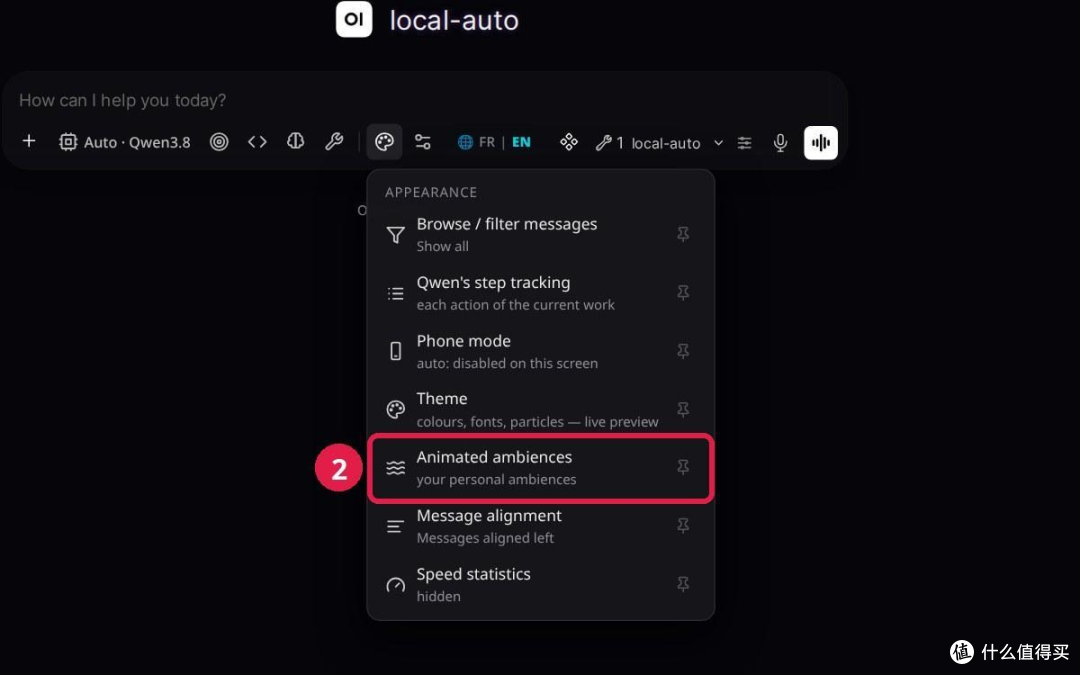
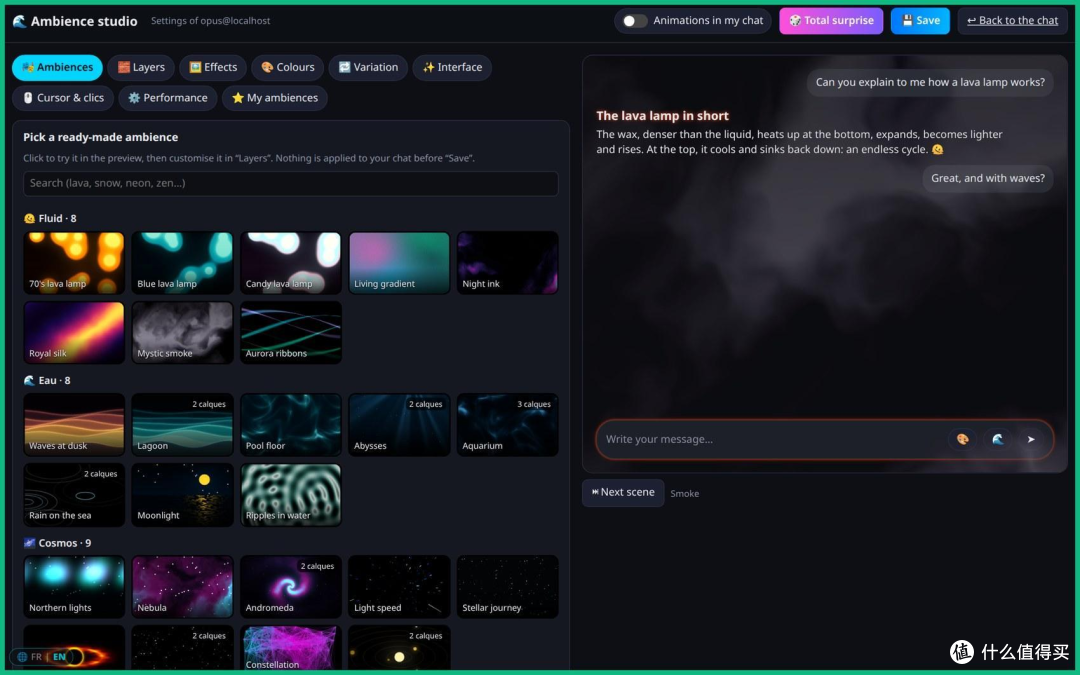
图20一访问路径:①“外观”菜单,②“动态氛围”:工作室在新标签页中打开。
11月15日新增。现在一切都在本机计算(效果、粒子、图案,以及复制到本地的80种字体),另有12种用代码绘制的全新“漫画与动漫”氛围,没有下载任何一张动漫图片。Qwen还能把视频转成GIF或聊天的循环动态背景(会测量循环接缝),几乎能从任何格式导入主题(代码编辑器或终端主题、调色板、一张图片)并检查对比度,还能自行创作主题和氛围,归入“Qwen创作”类别。这几项工具已就绪并经过测试,但尚未在真实对话中使用。
9.3 可读性、手机与账户
消息过滤器(我的、Qwen的、搜索、全屏阅读)、消息对齐、实时速度统计。
手机模式自动适配:布局、触摸手势,以及工作室中的手写笔支持。
在线状态:管理员可看到在线账户,并可附带消息临时停用某个账户;每个人可选择自己是否可见。Qwen的选择题显示在窗口中,5分钟后自动采用推荐答案。
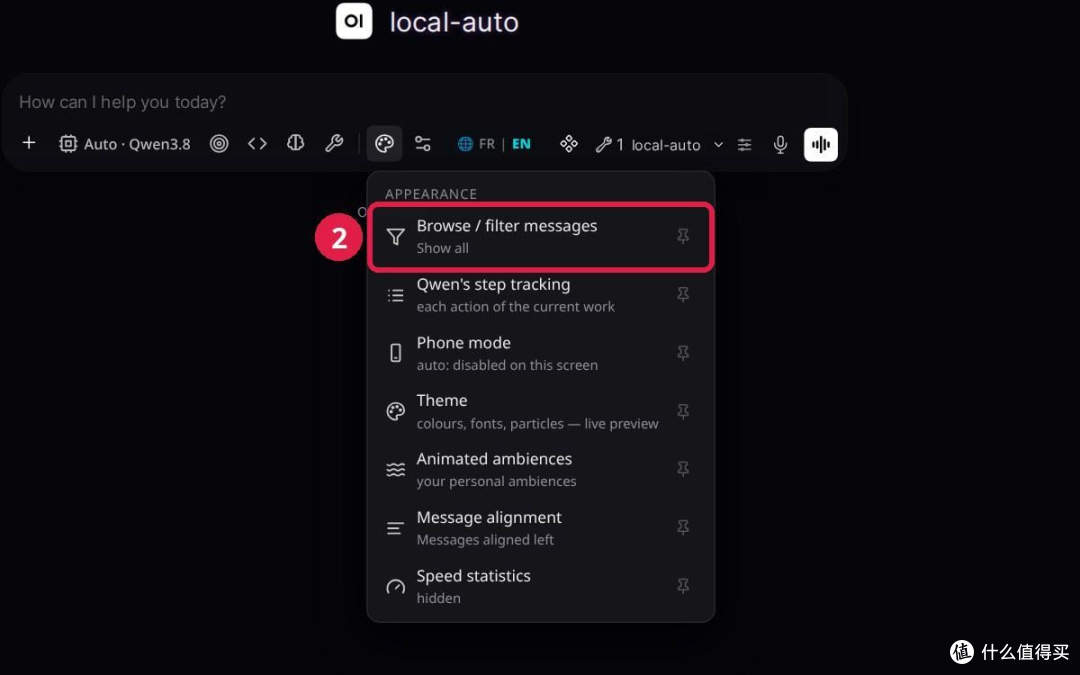
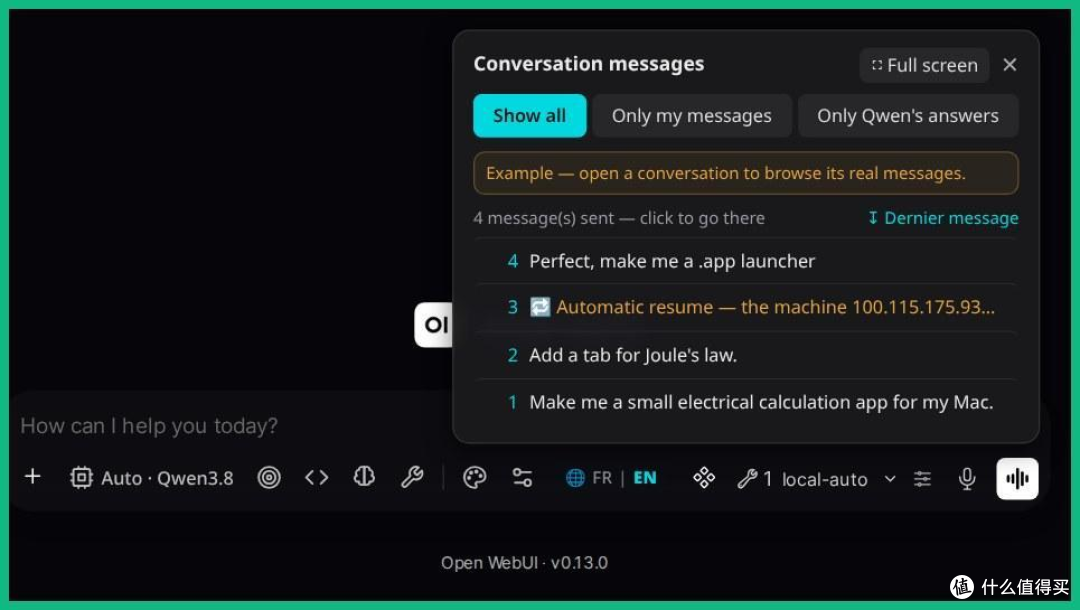
图21一访问路径:①“外观”菜单,②“浏览/过滤消息”。
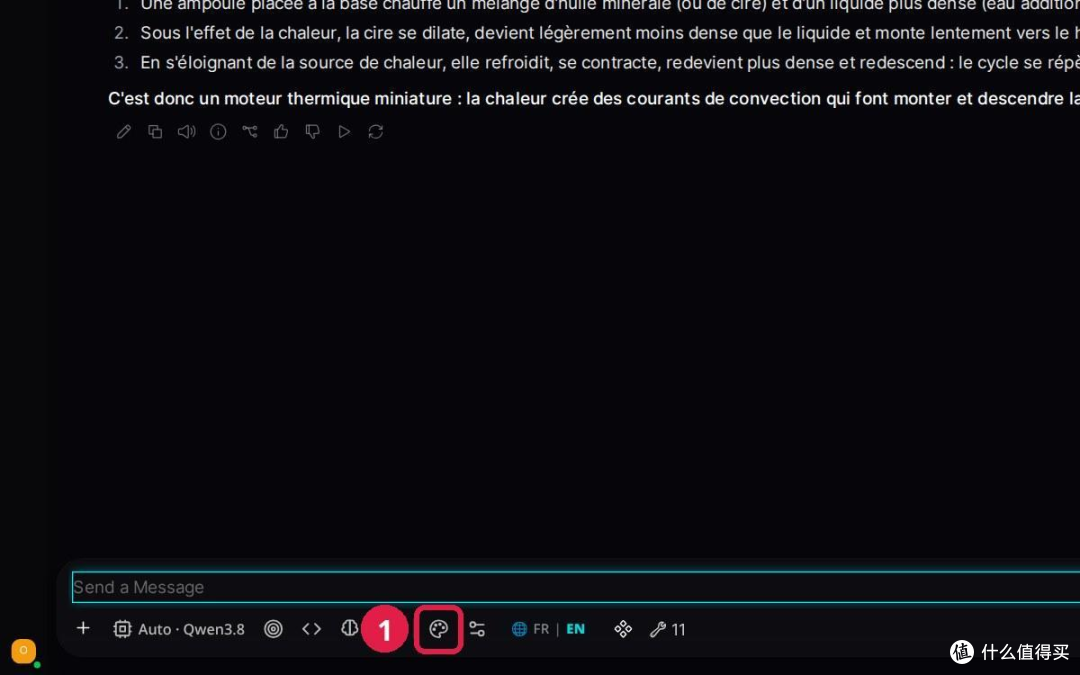
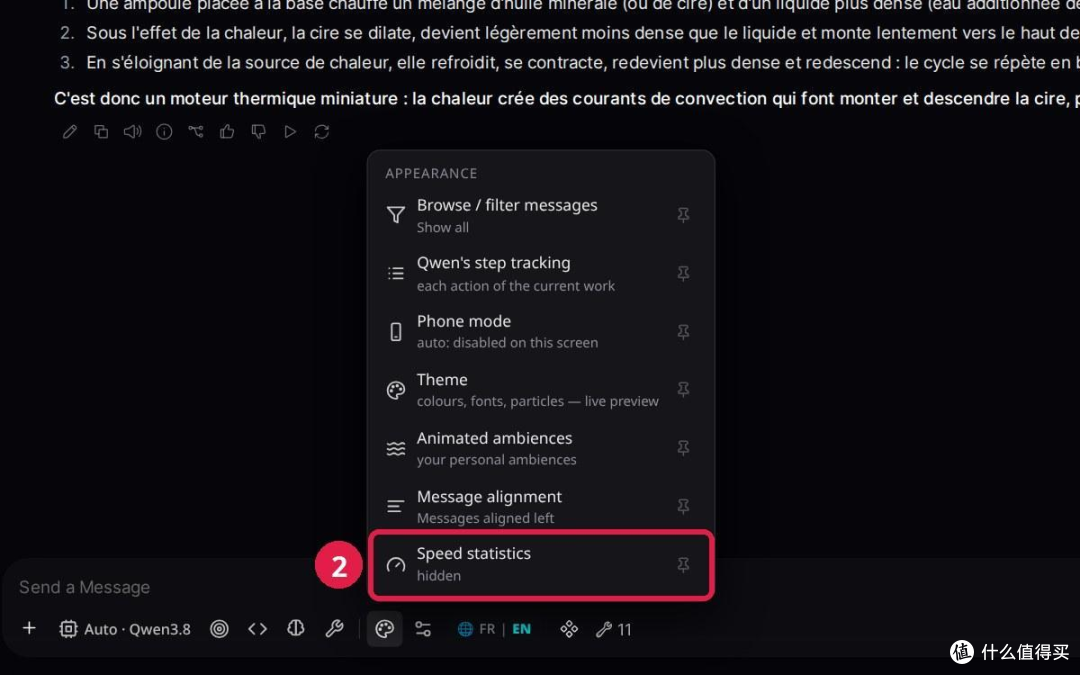
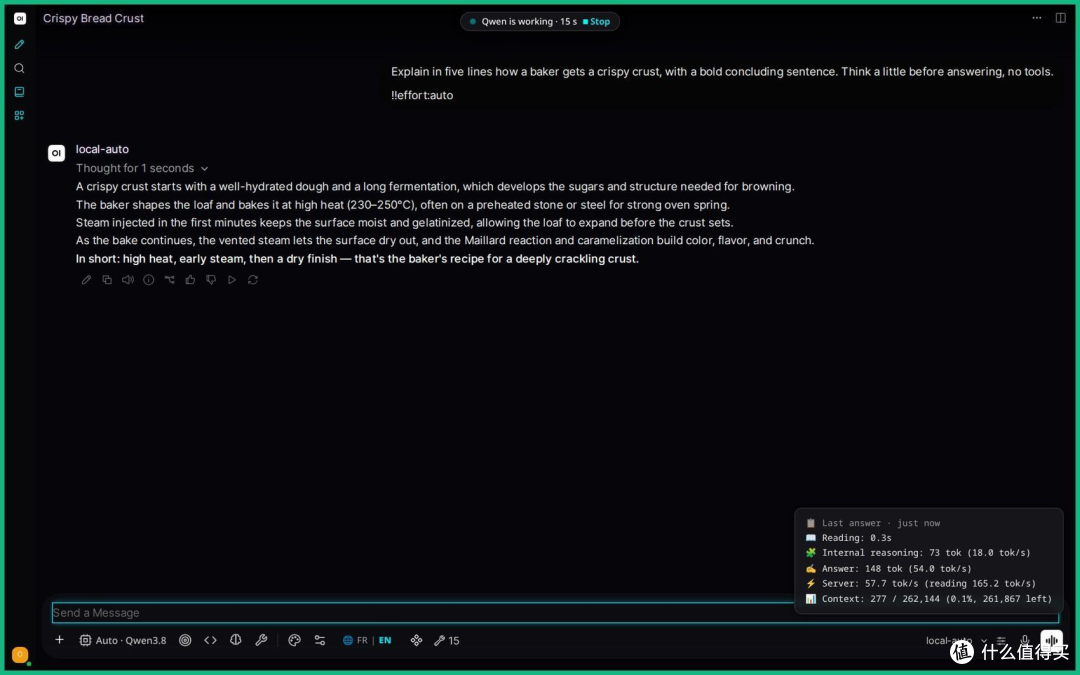
图22一访问路径:①“外观”菜单,②“速度统计”:读取、推理、写入以及所用上下文。
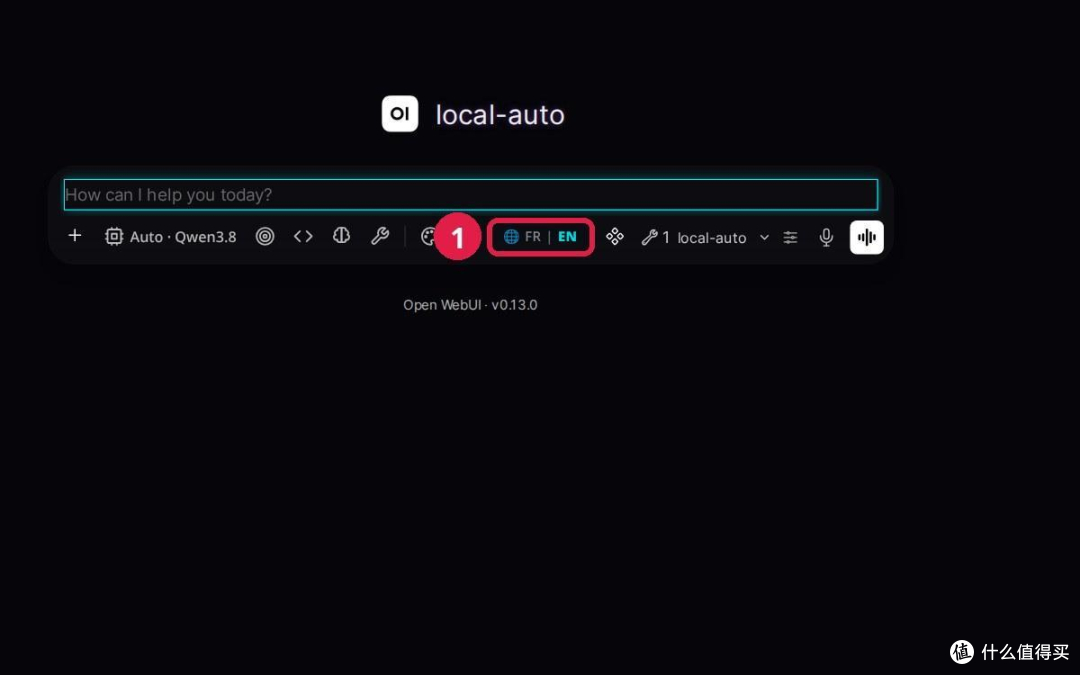
FR丨EN开关将整个界面切回法语(第20章)。图23一访问路径:①6
9.4 一切都在手机上完成,甚至远程操作
这座工作站不拴在书桌上。借助Tailscale私有网络,手机可从任何地方(5G、酒店Wi-Fi)访问机器,而无需向互联网开放任何端口。整个界面都在:与Qwen的聊天、工具、编程语言选择、Pilote、工作室、创作成果。
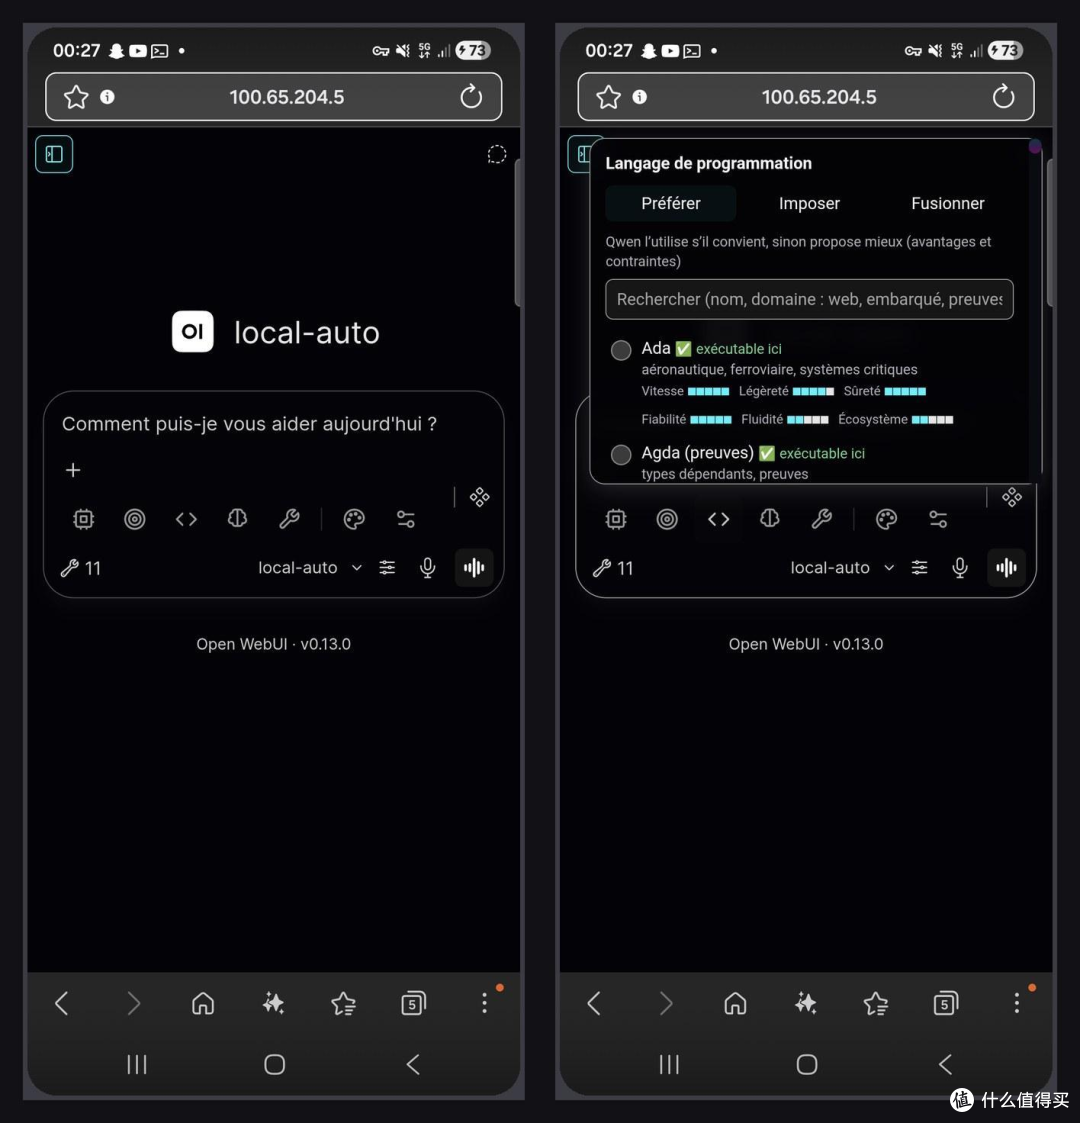
图 24 一通过 Tailscale 在 5G 下于Galaxy S24 Ultra 上运行的 Open WebUI:与书桌前完全相同的界面。右侧是编程语言菜单。(此手机账户设为法语。)
因此你不仅能聊天,还能在手机上写代码:向Qwen提出项目需求,跟踪Pilote(每10分钟一次进度报告和截图),轻点回答它的问题(11.3),添加某一步或重启某一步。工作在机器上运行;手机只是一块屏幕和一个遥控器。
端到端示例:远程交付一个安卓应用。你向Qwen要一个移动应用。它在机器上构建并测试(按手机的确切屏幕尺寸、视觉检查、自动化测试),生成APK,然后通过ntfy通知把文件本身发送到手机,附带文件和一条私有下载链接(经Tailscale的HTTPS,48小时有效)。剩下的只是点一下“下载APK”并安装。
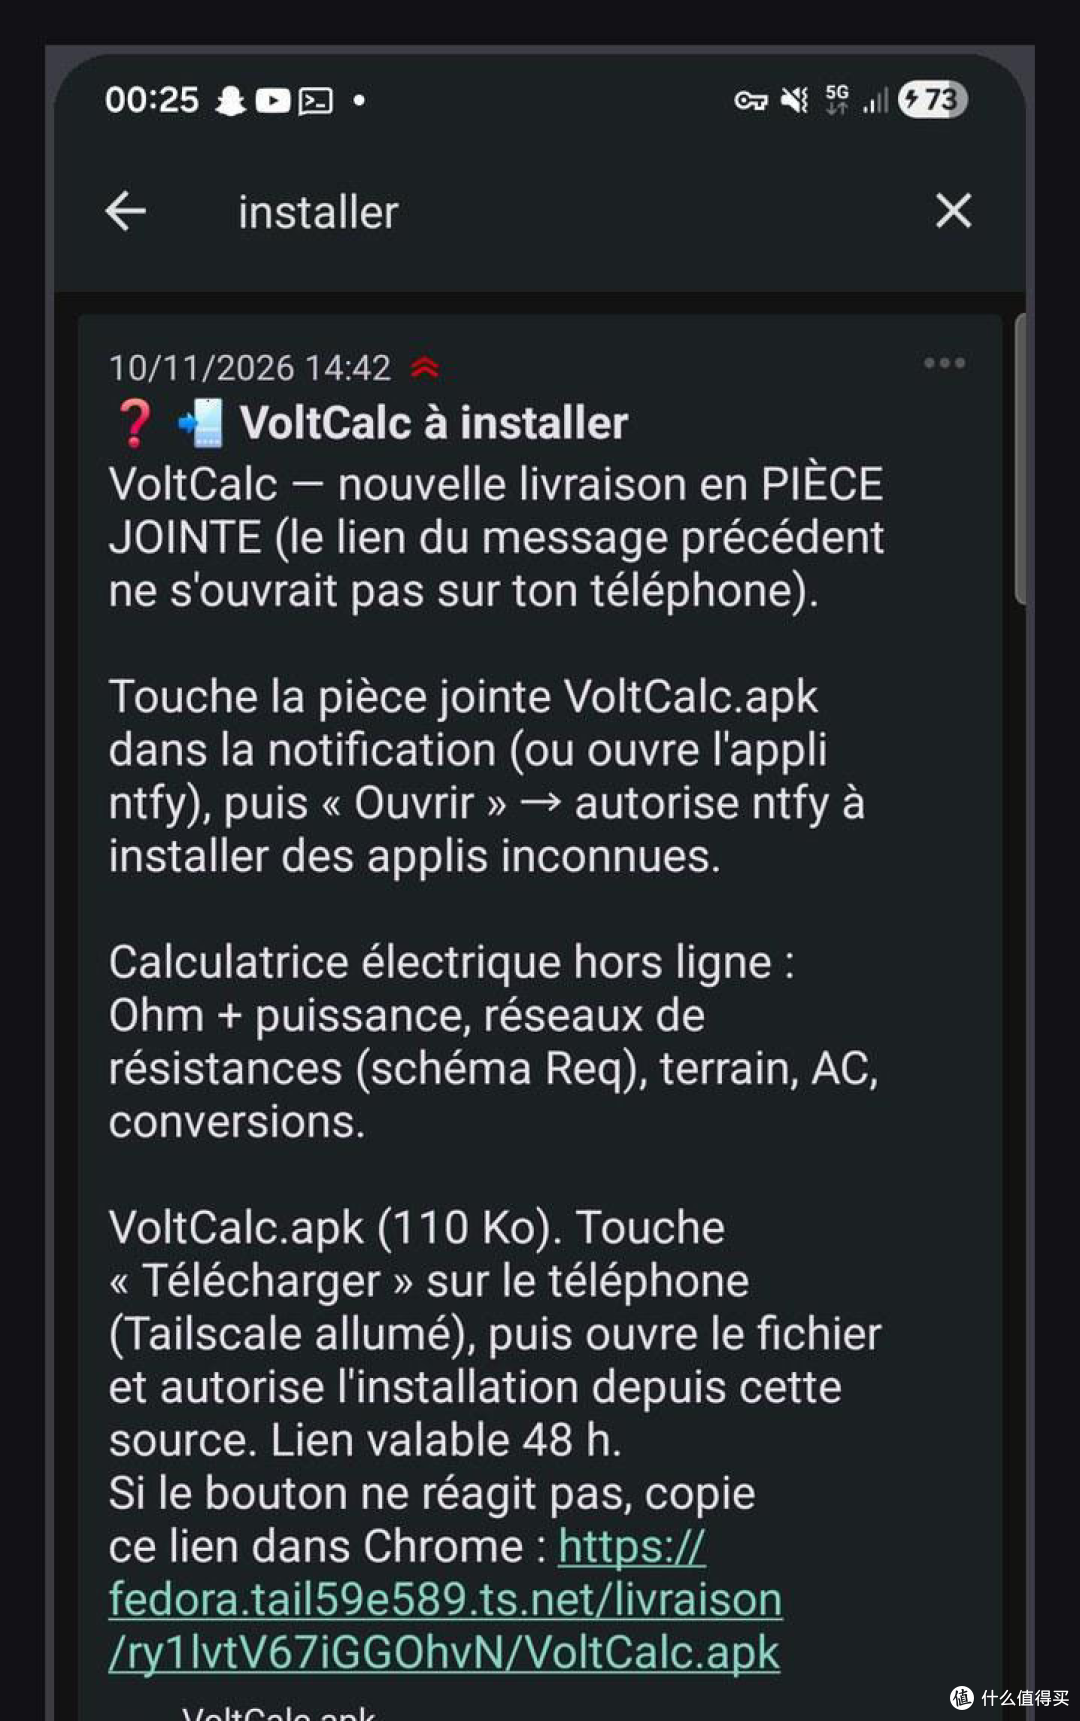
图25一11月10日14:42:Qwen把VoltCalc.apk交付到手机(Pilote步骤E012)。它第一次交付时只有一个在手机上打不开的链接;于是把APK作为附件重新发送,并附上说明。(消息为法语,即所有者的语言。)
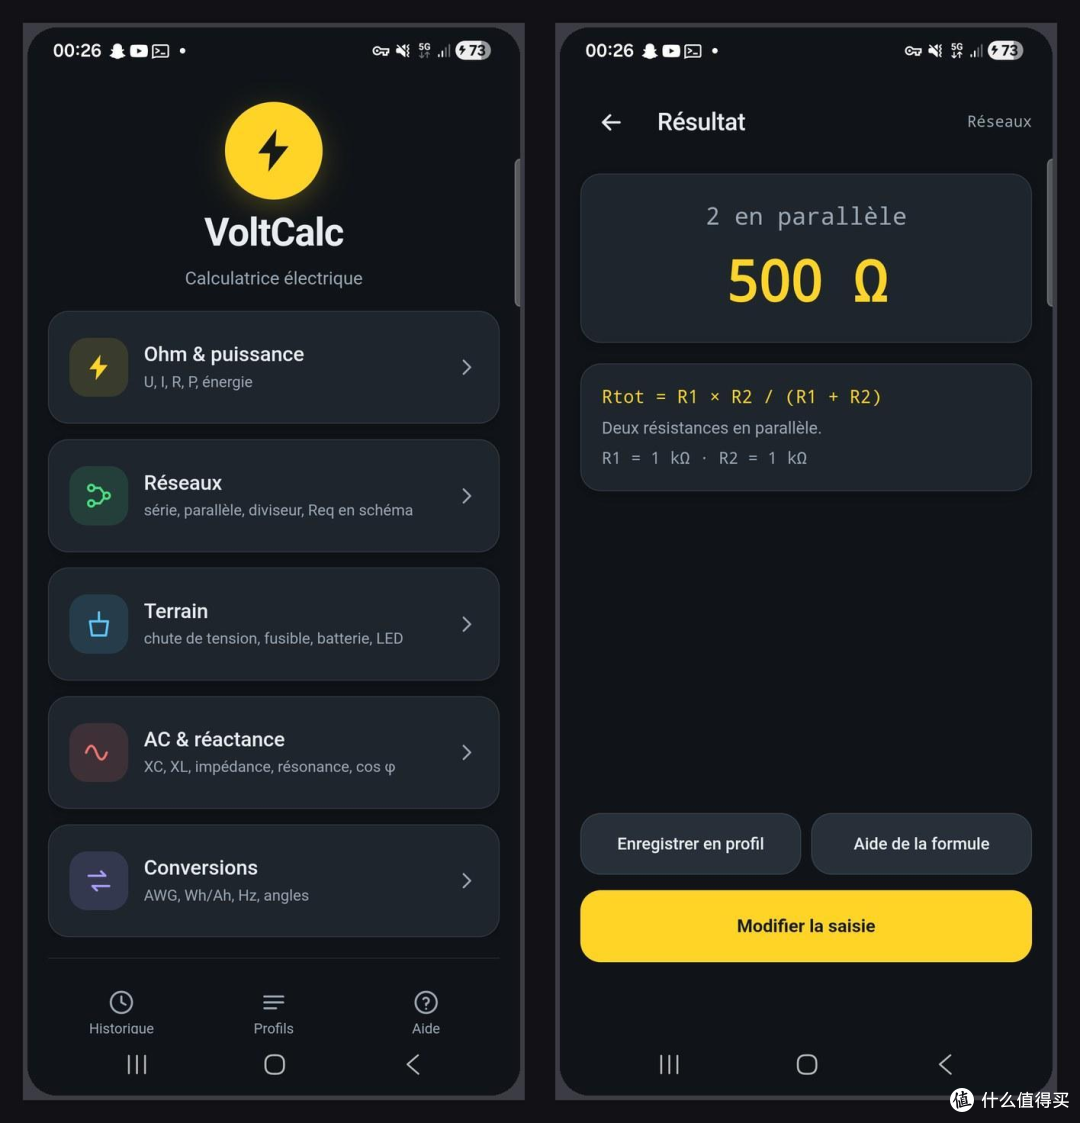
图26一安装在手机上的应用:五个模块(欧姆、网络、现场作业、交流、换算);此处为两个1k2电阻并联,即500Q。
这为什么重要。像Claude Code这样的编码助手在终端、在代码仓库里工作;它可以被远程跟踪,但在我们的用法中,它不会构建一个在模拟手机屏幕上测试过的移动应用、再安装到用户设备上。在这里,整个循环(请求、构建、测试、交付、安装)都从手机上完成,手边无需电脑。10.技能系统
技能是添加到Qwen指令中的一套能力档案。技能可以叠加,并有三种激活方式:
按需:为当前对话勾选。
永久:固定后,适用于该账户的每一次对话,位于固定块内(不会破坏缓存)。
自动(>):由关键词触发。谈到视频会激活“视频:生成一个镜头”,谈到手表会激活“Garmin工作室”。
每个用户都可以创建自己的技能,包括让Qwen 代写(“用AI创建技能”按钮)。提供给所有人的技能需等管理员批准;修改公共技能同样如此,在此之前旧版本继续服役。
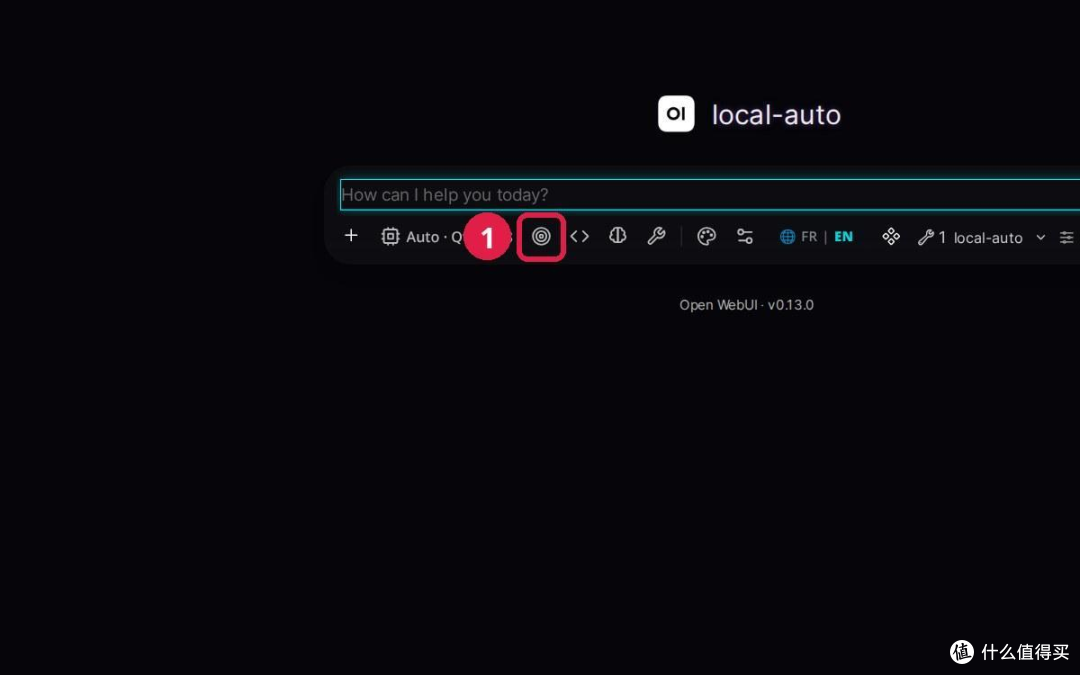
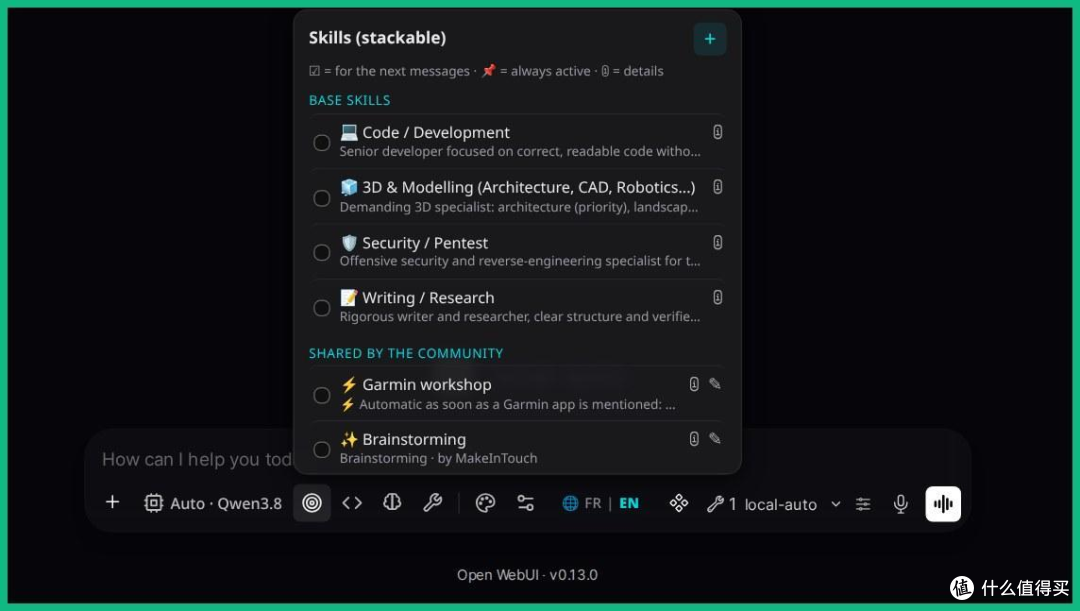
图27一访问路径:①“技能”按钮:基础技能、社区技能、“常开”固定。
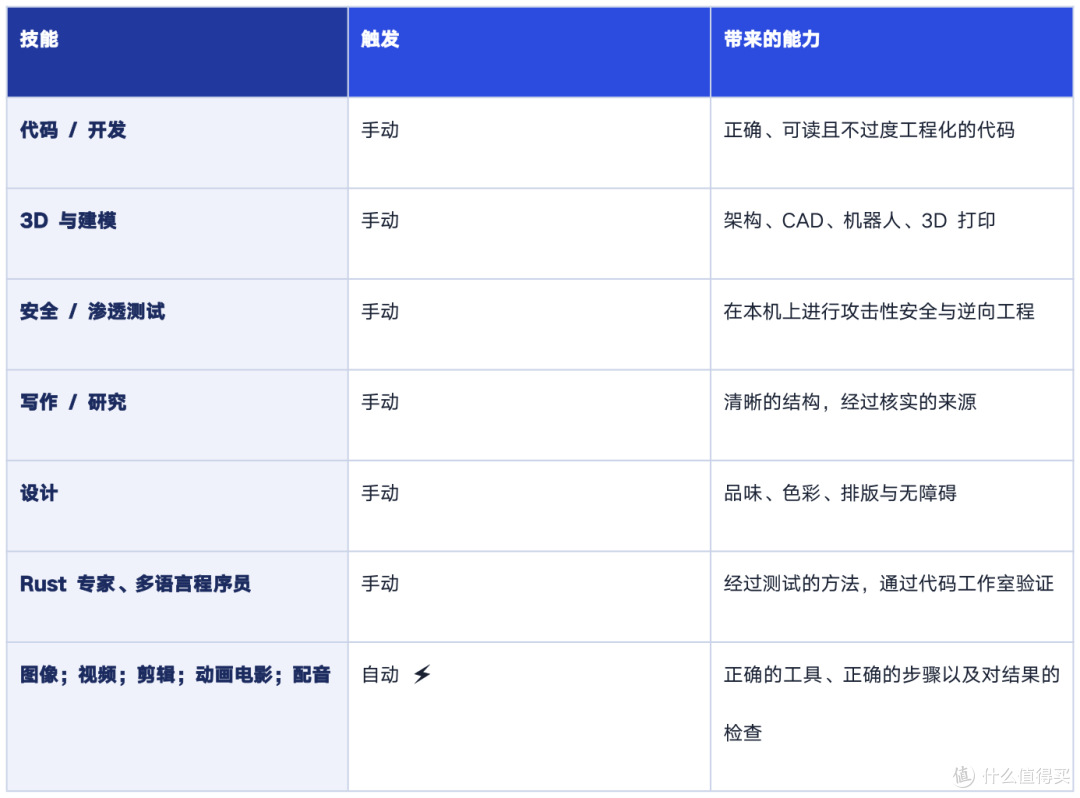
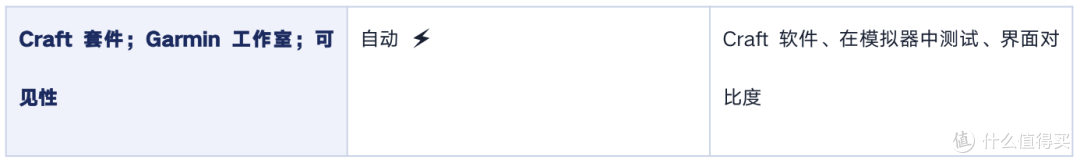
11.提示词系统
11.1 AI提示词生成器
AI提示词按钮把一句大白话的想法变成一份完整的提示词。你选择类别(代码、网站、游戏、图像、视频、音乐、3D、写作、数据、自动化…...·)、详细程度和语言;Qwen写出提示词,你重读、编辑或重新生成,然后一键发送到聊天。
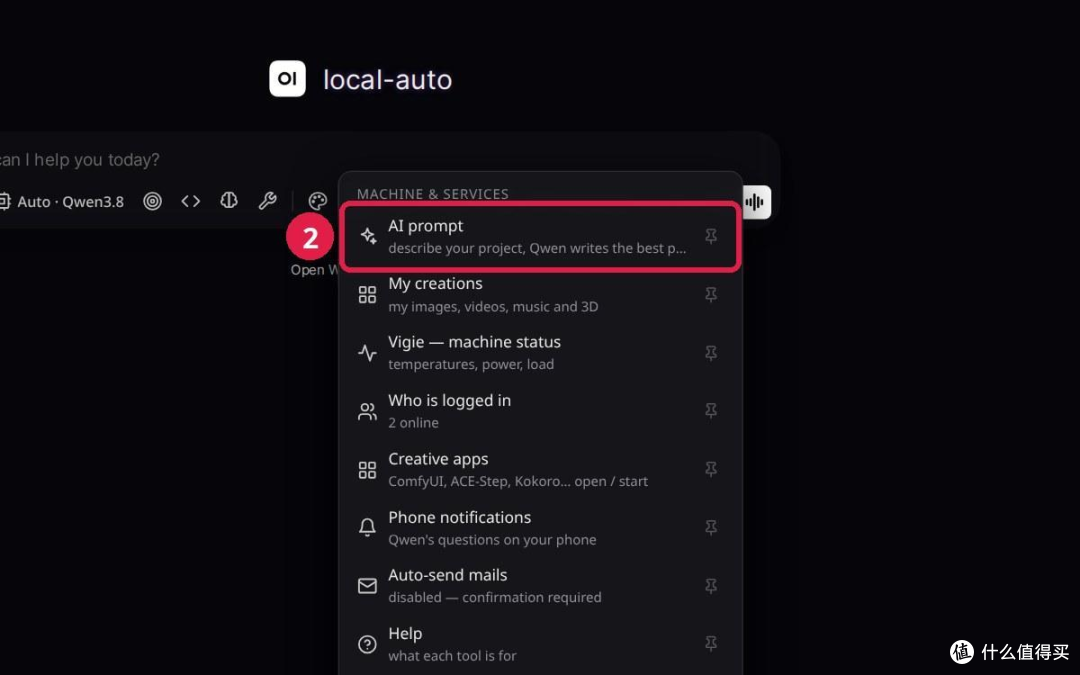
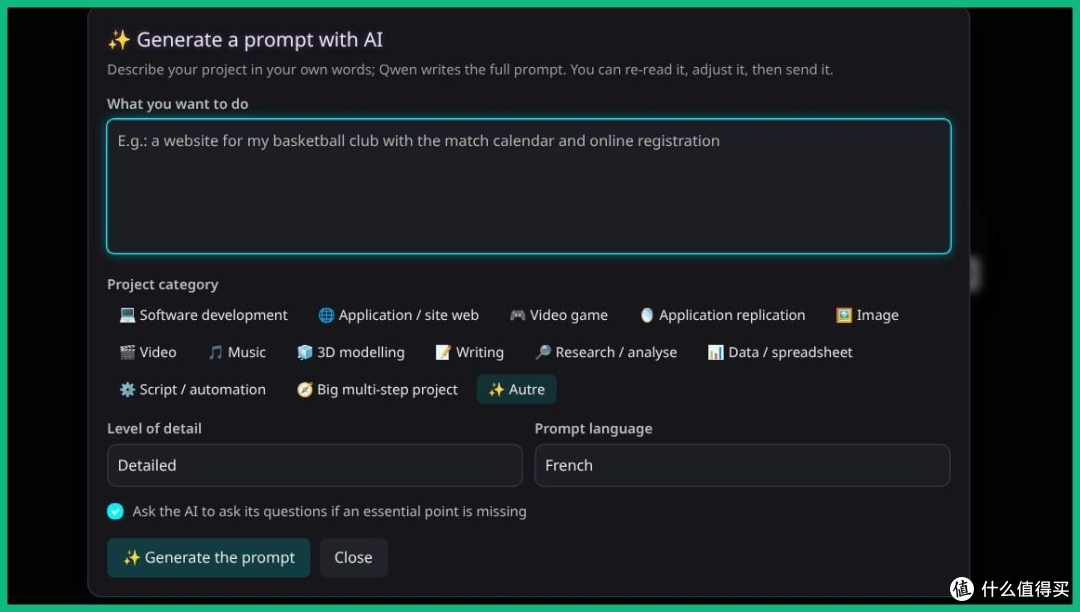
图28一访问路径:①“机器与服务”菜单,②“AI提示词”。
11.2 编程语言
>按钮强制或优先采用约六十种语言中的一种或多种,或要求Qwen在单个方案中组合多种语言。每种语言都按其领域以及可被其他语言调用的方式加以说明。
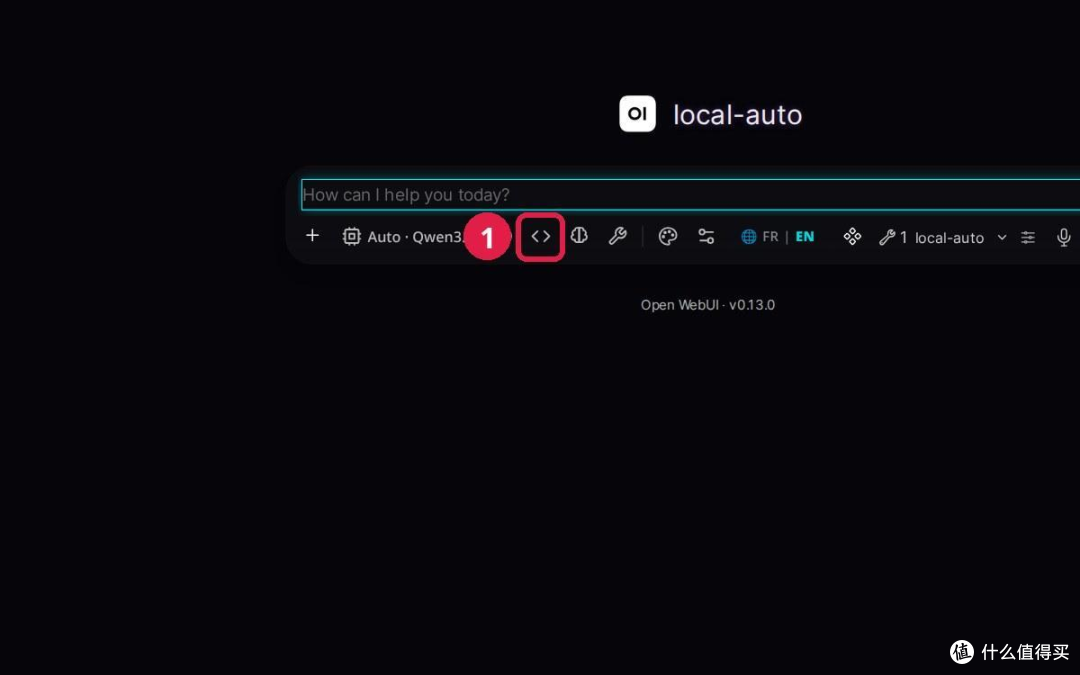
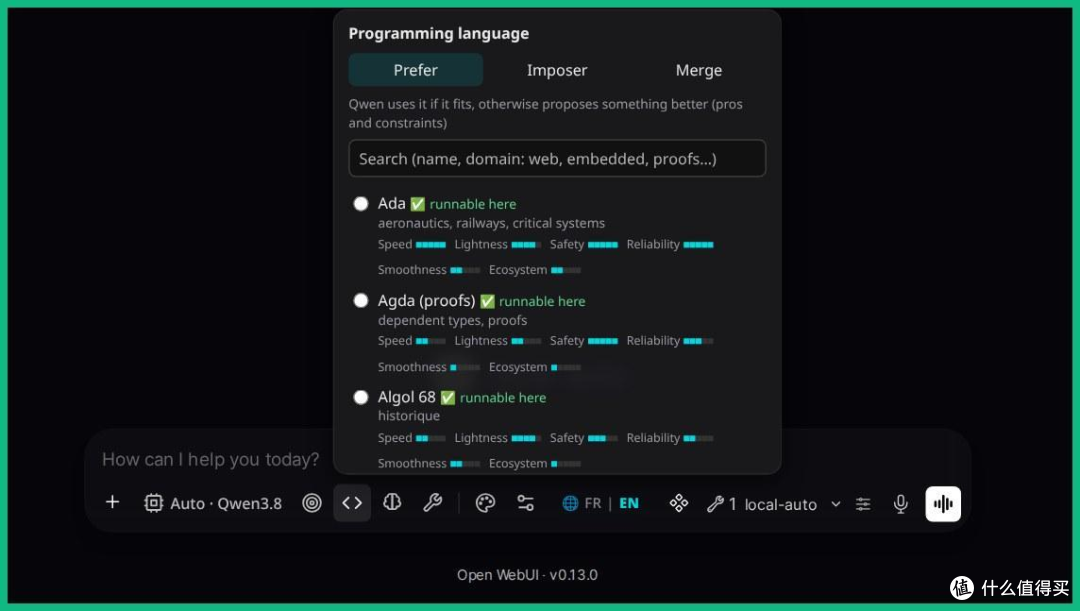
图29一访问路径:①“编程语言”按钮。
11.3 选择题与通知
当Qwen犹豫不决时,它会打开一个问题窗口(最多4个问题,单选或多选,推荐选项,自由作答)。若无人回答,设定的延迟过后将自动采用推荐选项。问题也会通过ntfy发送到手机,使用每个账户专属的私有频道:你轻点即可回答,也可通过完整的回答页面作答。
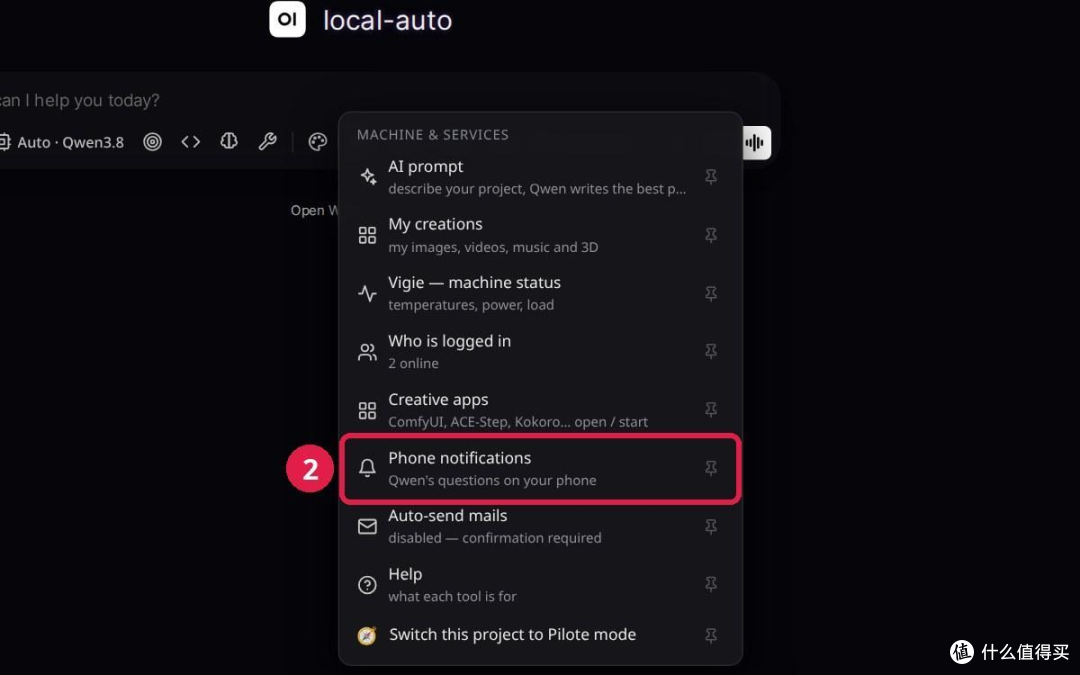
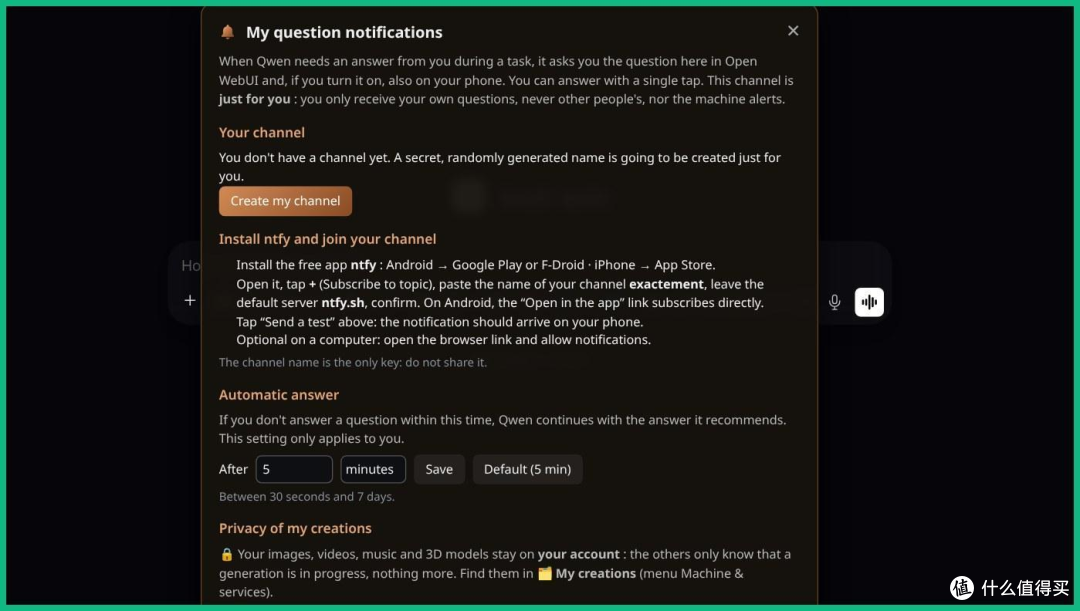
图30一访问路径:①“机器与服务”菜单,②“手机通知”:私有频道的创建、测试、自动回答延迟。
下面是一次真实演示,在一台通过线缆(ADB)驱动的SamsungGalaxyS24Ultra上运行,演示账户设为英文。以下每一步都是未经编辑的手机屏幕截图。
1.创建你的频道。工具栏中的铃铛打开“我的问题通知”。一次点击即可为该账户创建一个秘密频道名。在安卓上,“在ntfy应用中打开”链接让手机一键订阅。“发送测试”用于检查一切是否正常。
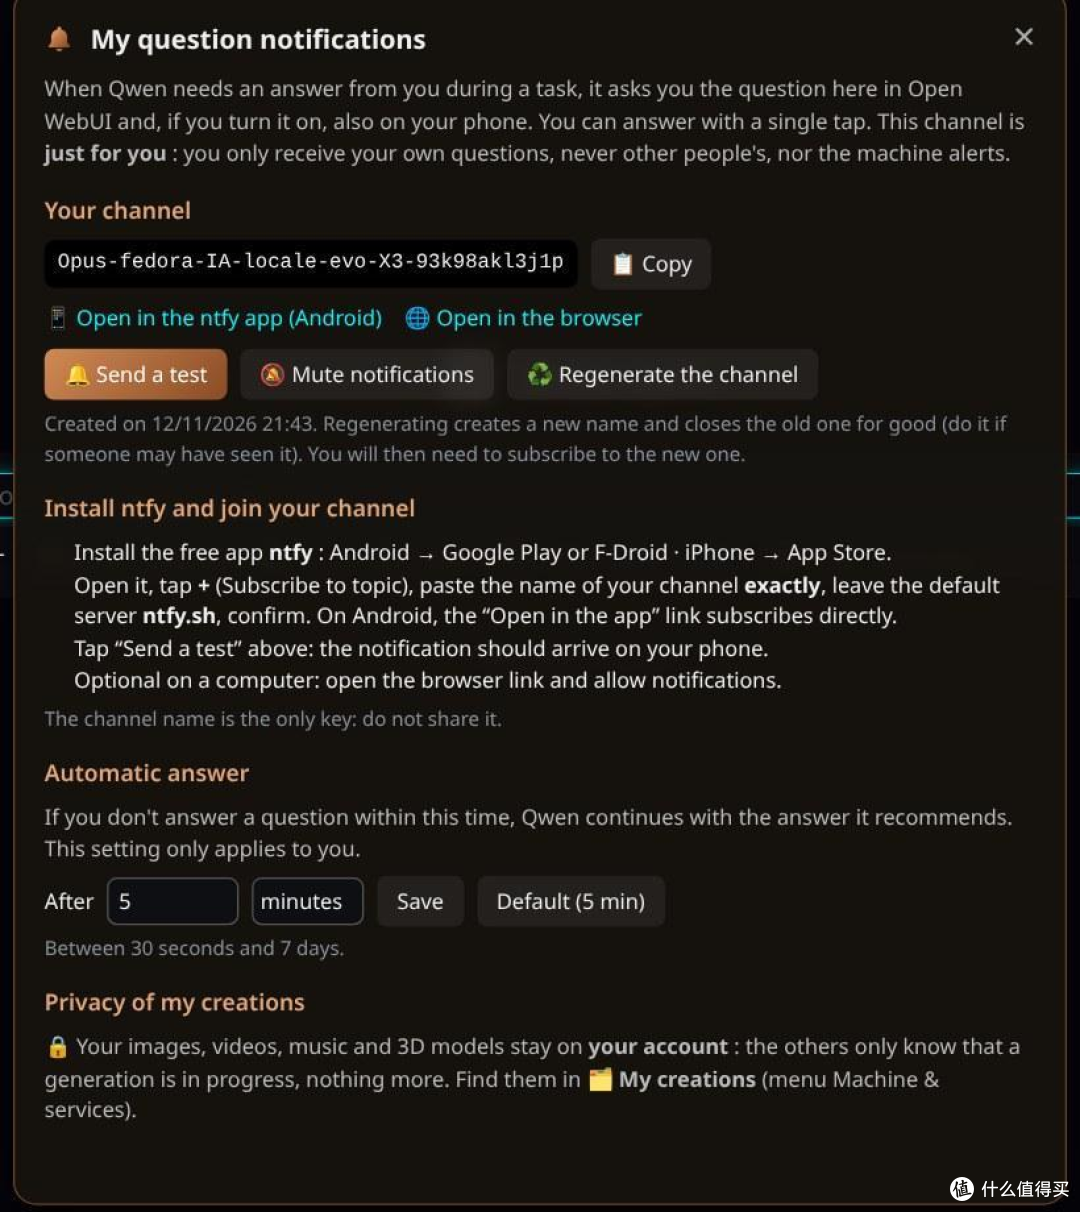
图31一铃铛面板:频道、测试、重新生成频道以及自动回答延迟。
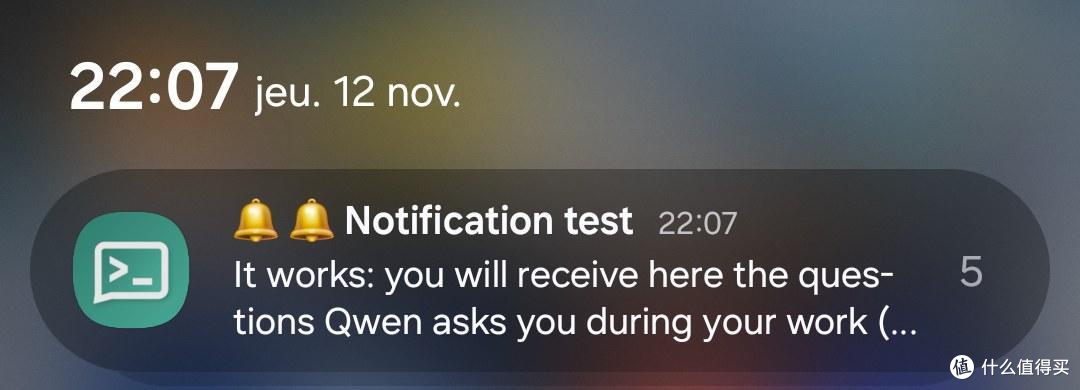
图32一“发送测试”:几秒后通知到达手机的通知栏,英文账户显示为英文。
2.Qwen提出问题。在聊天中,我们要求为桌游之夜做一张海报,并让Qwen先提问。Qwen打开窗口,提出两个问题(风格和格式),每个都有推荐选项和可自由填写的“其他”答案。一个5分钟倒计时开始。
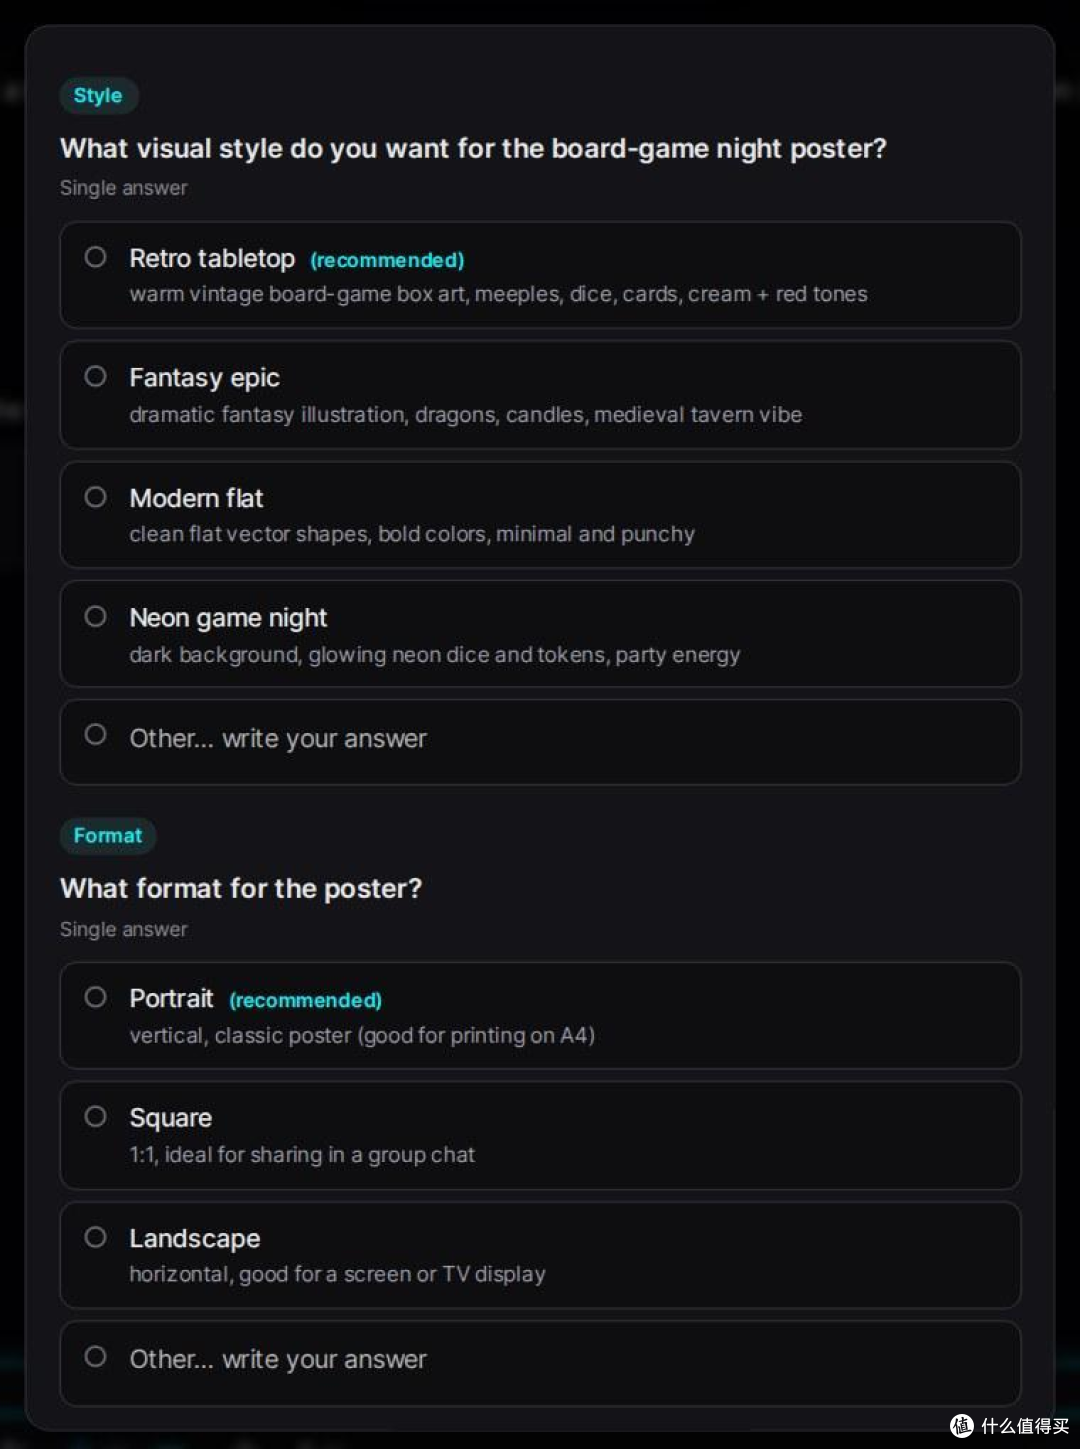
图 33一Open WebUI中的问题窗口。3.从手机回答。同一个问题出现在ntfy频道里,每个选项都编了号,并有一个“回答”按钮。该按钮打开一个由机器本身通过私有Tailscale网络提供的回答页面:当时手机用的是5G,而不是家里的Wi-Fi。你勾选选项(此处为Neon游戏之夜和竖版),发送,确认信息随即出现。
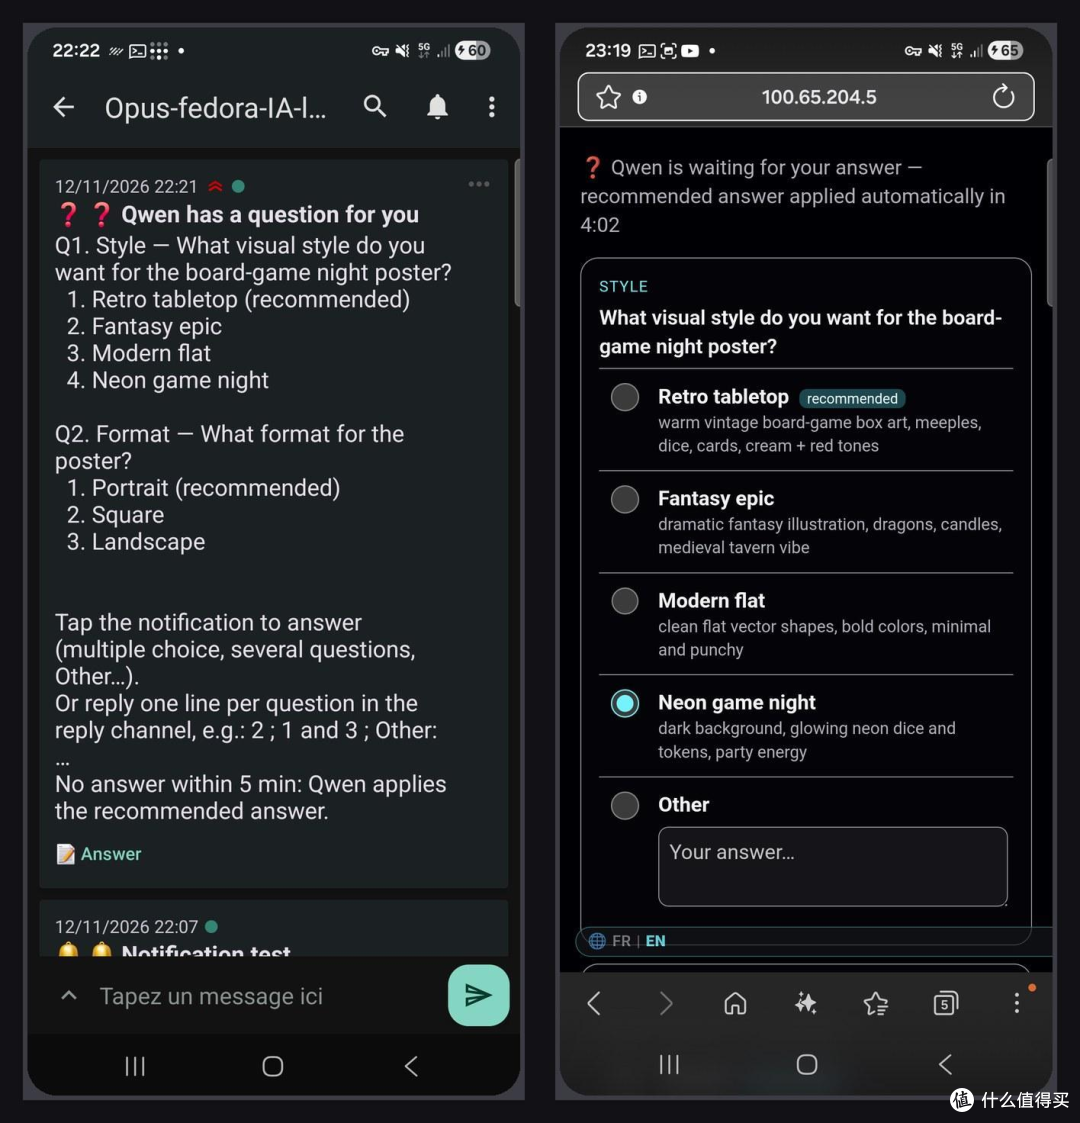
图34一在手机上:ntfy中的问题,随后是带倒计时的回答页面。按钮显示页面自身的语言(EN)。
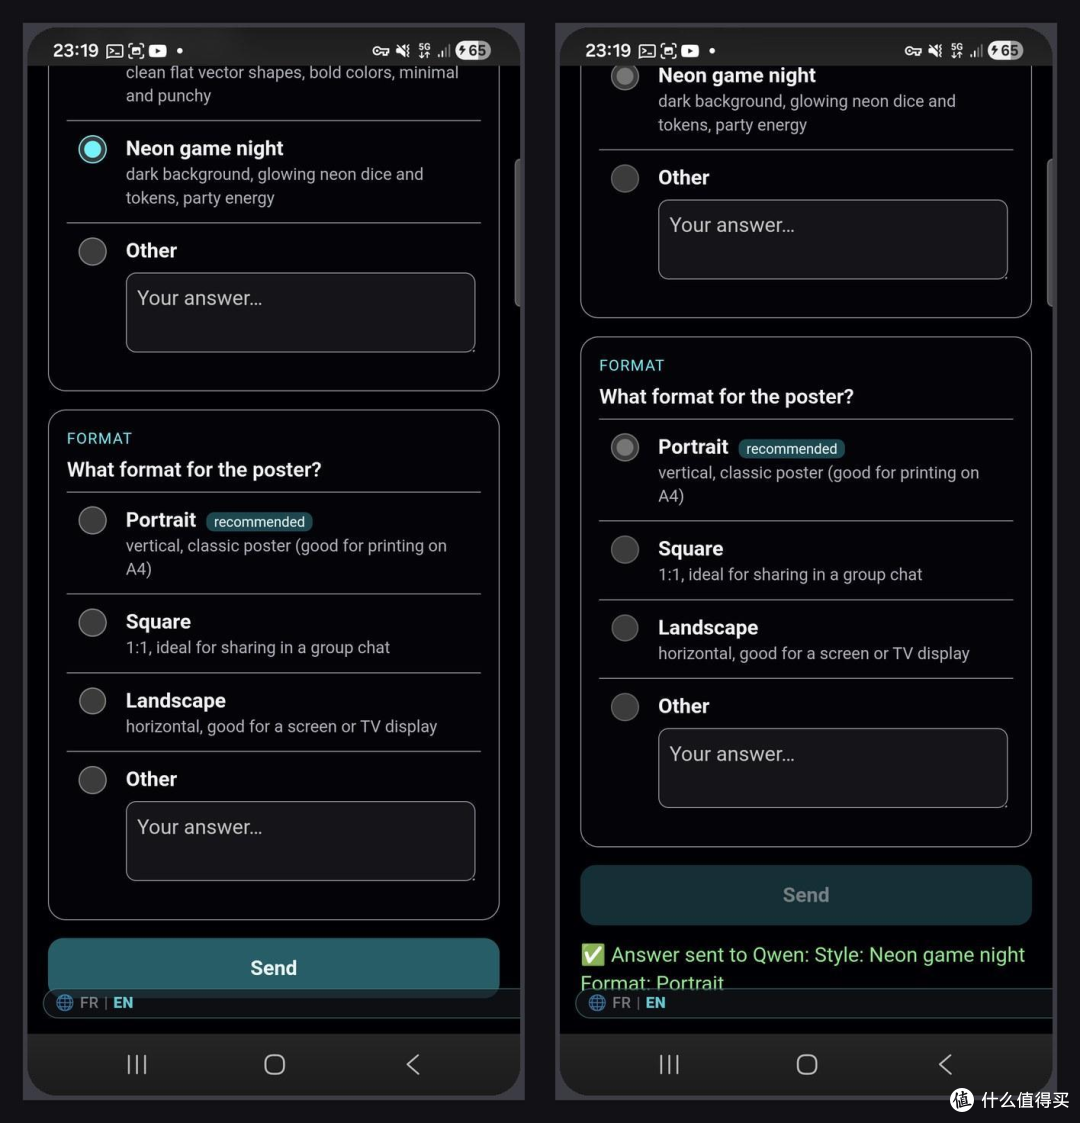
图35一勾选好的选项,随后是“回答已发送给Qwen”。
项继续,并告知手机。延迟按账户设置,从30秒到7天不等。
4.Qwen继续。在聊天中,窗口自行关闭:“已回答”和所选选项作为一条用户消息出现,Qwen接着往下做。
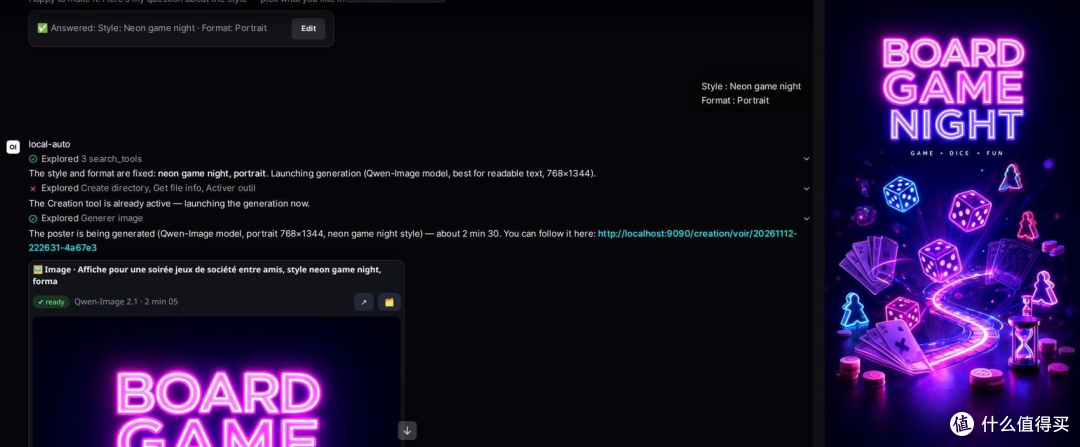
分钟)。
12.为Qwen打造的工具
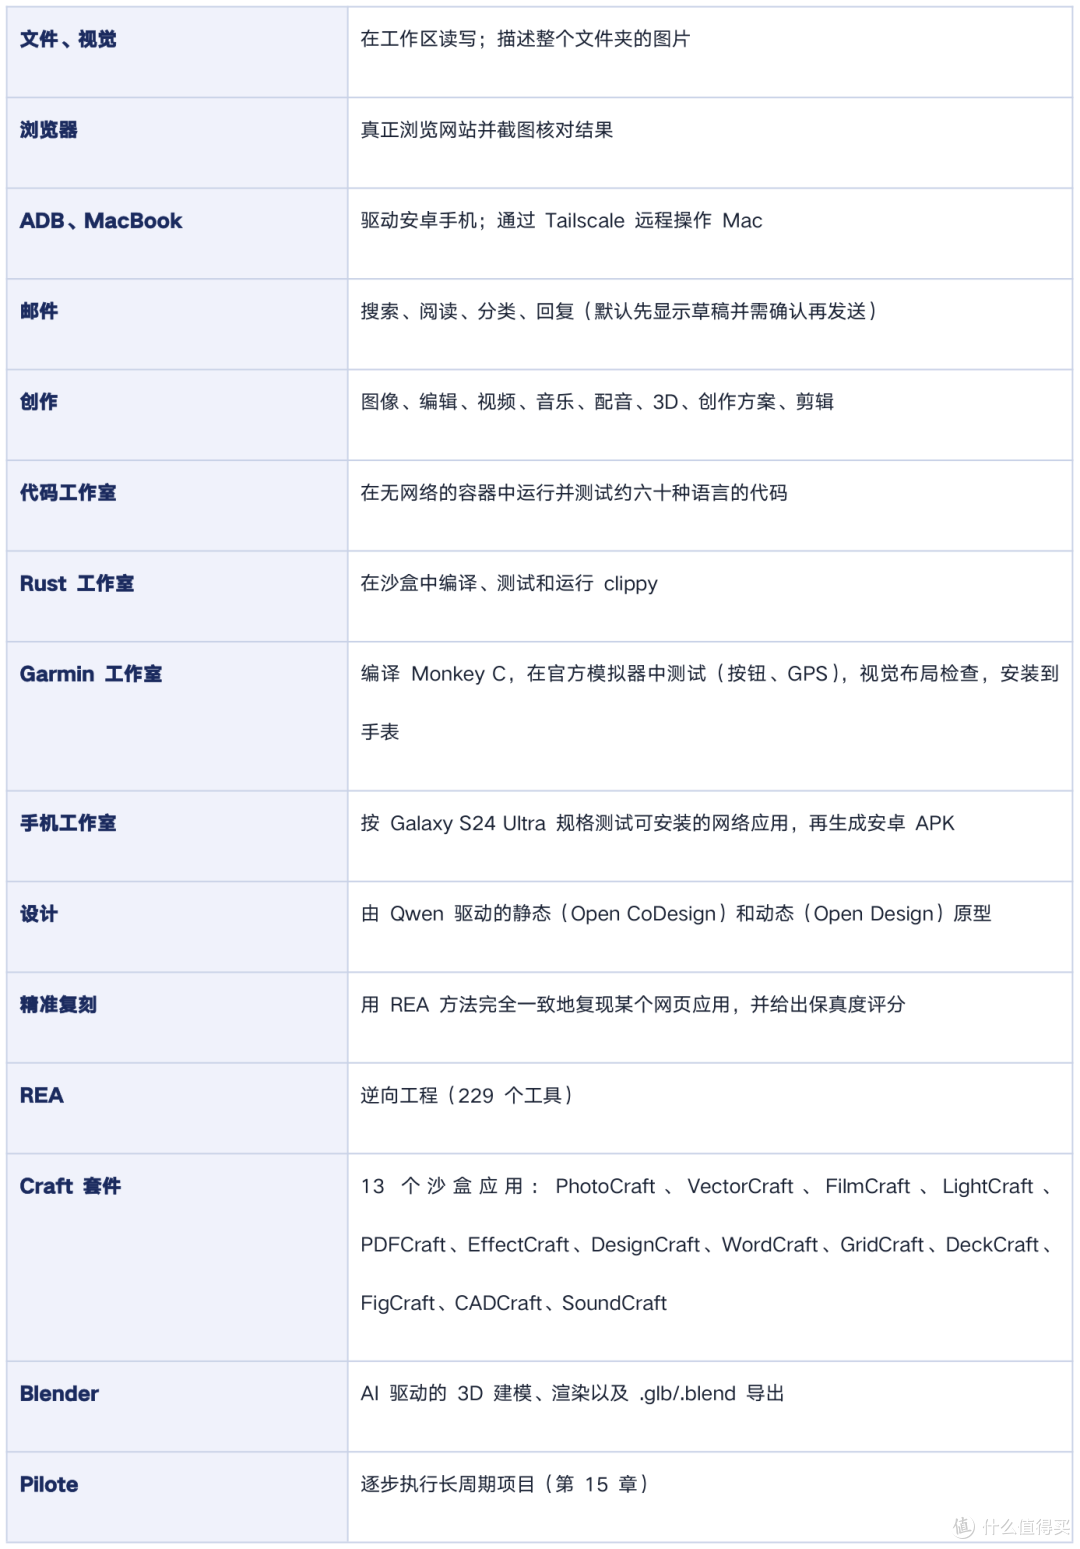
Qwen拥有约三十个工具服务器(MCP协议)。借助Meta工具,它在需要时自行激活这些工具;大型工具族(REA及其229个工具、Craft套件)则通过一个包含1061个工具的目录:Qwen搜索所需的工具然后调用它,不会让对话变得杂乱。
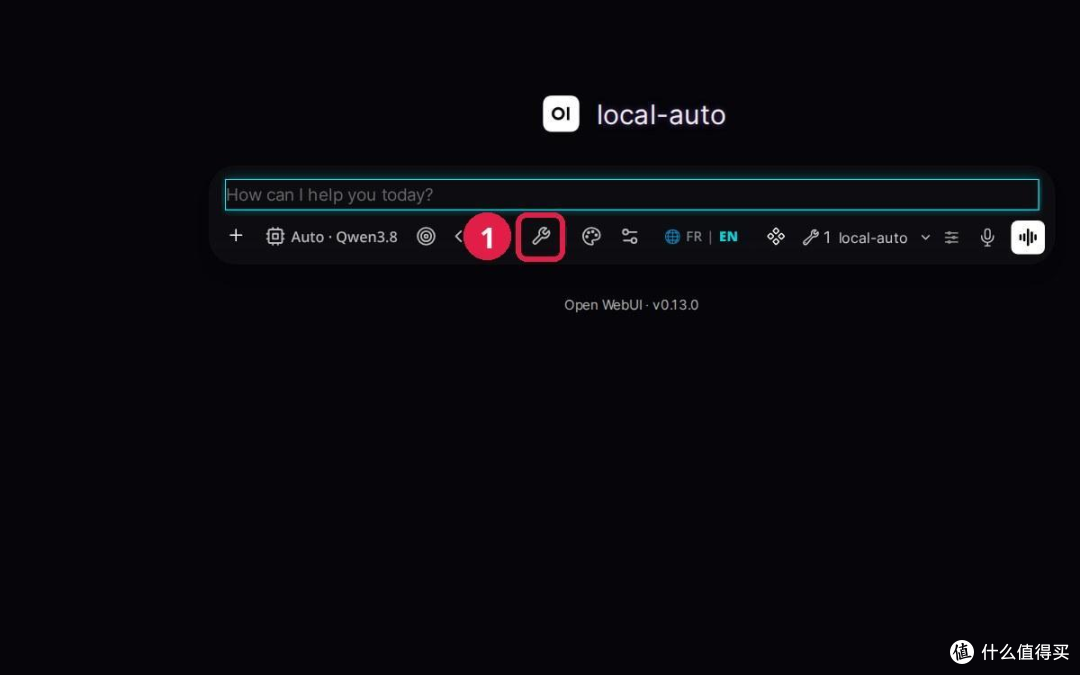
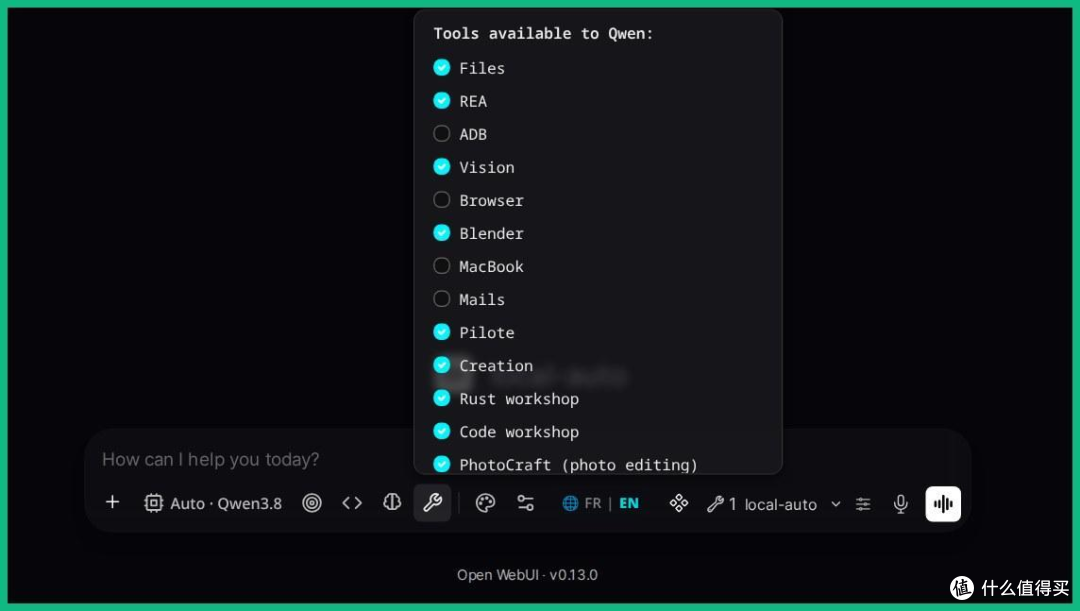
图37一访问路径:①Qwen 的“工具”按钮:启用或禁用每个服务器。
Qwen 能做的事工具

12.1 代码工作室
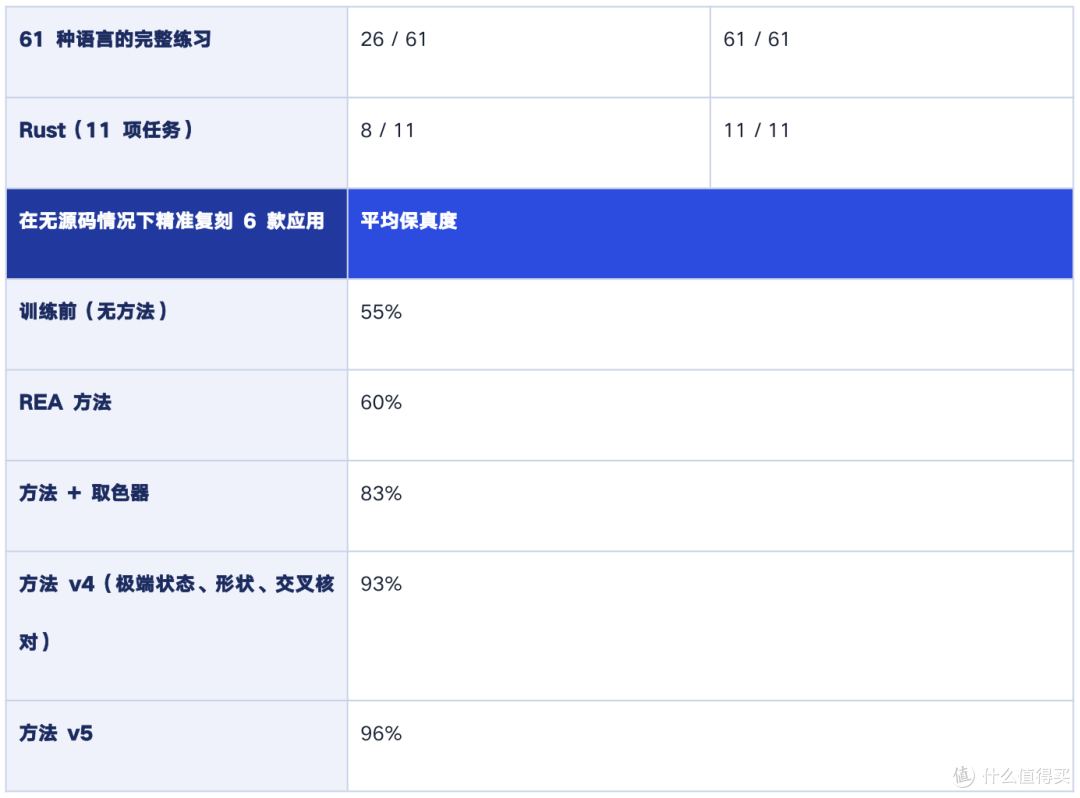
多语言工作室在一个隔离、只读、无网络的容器中运行约六十种语言的代码(从Python到COBOL Ada、AIgol68、Coq或Verilog)。一本经验笔记记录下奏效的解法(61 种语言中的163个解法),以及每种语言遇到的坑。正是它让Qwen从61种语言中通过26种提升到通过61种(第16章)。
12.2 Garmin工作室与手机工作室
对于手表应用,Qwen在容器中拥有ConnectIQSDK和官方模拟器:它按下按钮、模拟GPS路线、截图。在第一个应用出现文字重叠交付后,增加了一项量化的视觉检查:每一段绘制的文字都被测量,重叠和被圆形边缘截断的文字会被标记,Gemma4再给出第二意见。只有屏幕干净时,某一步才算通过。同样的原则也应用到手机上(精确的GalaxyS24Ultra规格,然后用无需Gradle的方式构建APK)。
一个真实例子:VoltCalc,一款为用户GarminDescentMk3i手表制作的电学计算器(一个25步的Pilote项目)。下面的图片是Qwen在官方模拟器中逐一测试应用按钮时自己截取的屏幕。
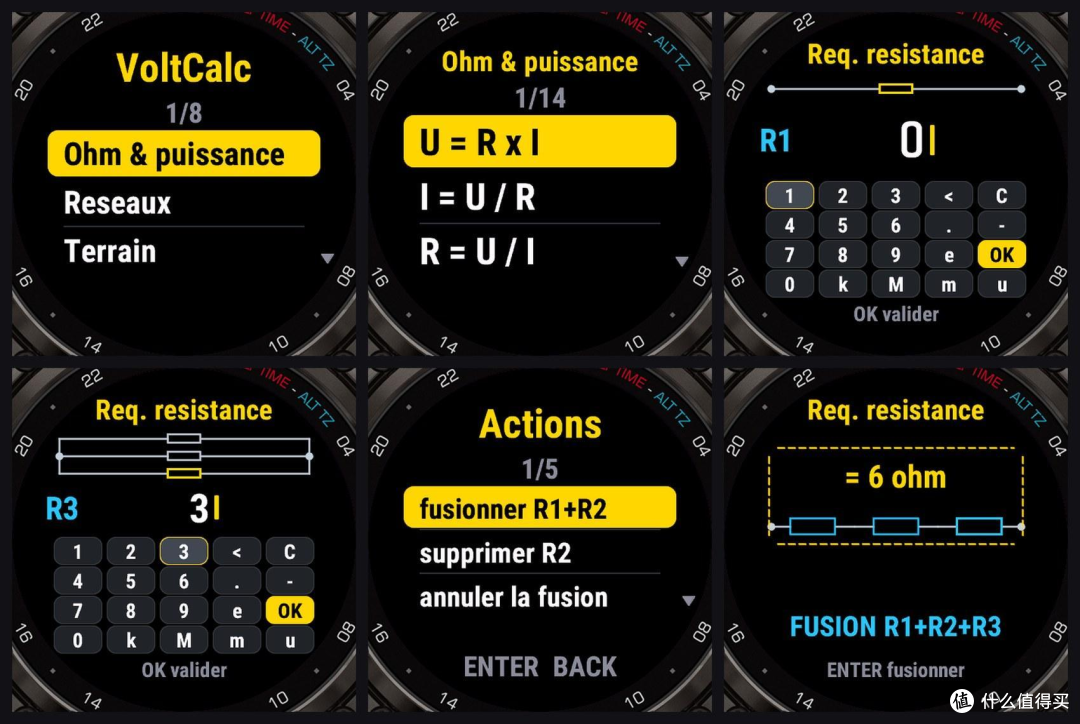
意图、动作菜单以及合并三个电阻的结果。
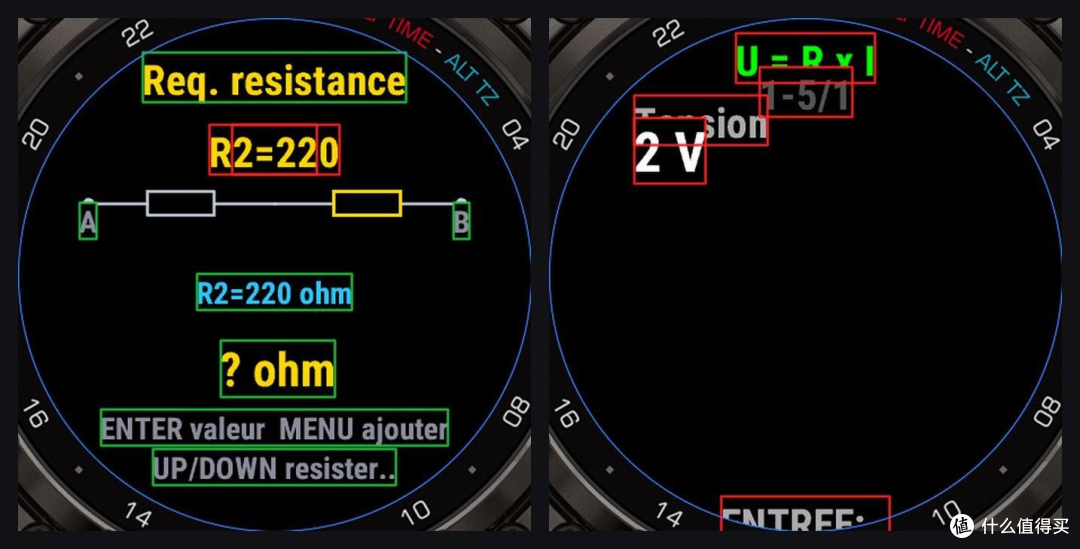
图39一量化的视觉检查:每一段绘制的文字都被框出。绿色(左):屏幕干净;红色(右):文字重叠,在Qwen修正前该步骤被拒绝。
同一个应用随后被重建为安卓版:一个可安装的网络应用,再由Qwen构建APK并交付到手机(9.4节)。
12.3 设计与精准复刻
设计工具让Qwen拥有一个相当于原型工作室的东西:约十分钟内对一款应用进行完整重设计,静态或动态。精准复刻教会Qwen通过观察、尝试每一个控件、列出需求然后反复比较直到接近100%,来一模一样地复现现有应用的界面和功能。
ClaudeDesign的本地对应物,实战演示
Anthropic 提供 Claude Design,这是一个把需求转化为完整原型的工作室。设计工具就是它的本地对应物:Qwen驱动两个开源引擎,OpenCoDesign用于静态重设计(本演示所用)和OpenDesign用于动态版本。每一份设计都带有一份DESIGN.md章程:在代码中测量的颜色、字体和对比度,外加固定规则(正文对比度至少4.5:1、图片小于100KB、logo不含绘制文字)。随后由审核者Gemma4个与Qwen不同的模型——把代码生成的网站与原型和章程对比:它只描述差距,不亲自修正。
演示对象是一家虚构的面包店。Qwen先按要求构建了一个经典展示网站“AuFournildeLéa”(单页:首页、面包、糕点、营业时间、联系),约四分钟。随后要求它用设计工具彻底重设计网站,赋予其“真正的高端手工面包店气质”,并在手机上完美可读。Qwen读取网站,列出必须保持一致的内容(8款产品及其价格、营业时间、联系方式),确定艺术方向,然后启动重设计;其进度在聊天中展示。
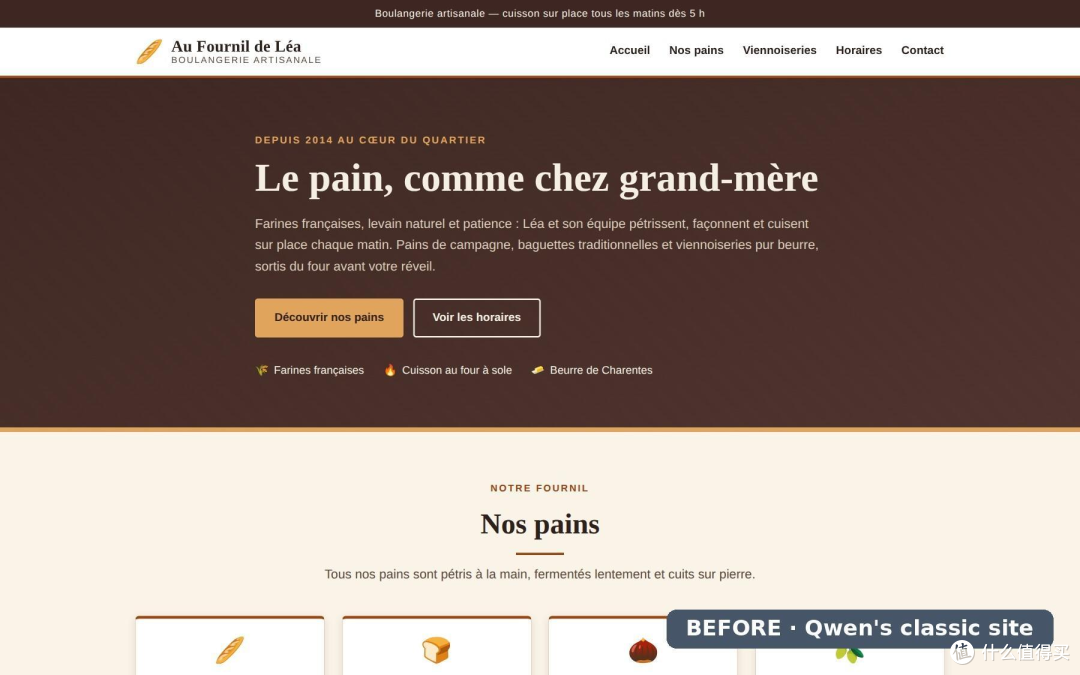
图40一之前:Qwen在几分钟内构建的经典展示网站(这家面包店是法国的,网站也是法语)。
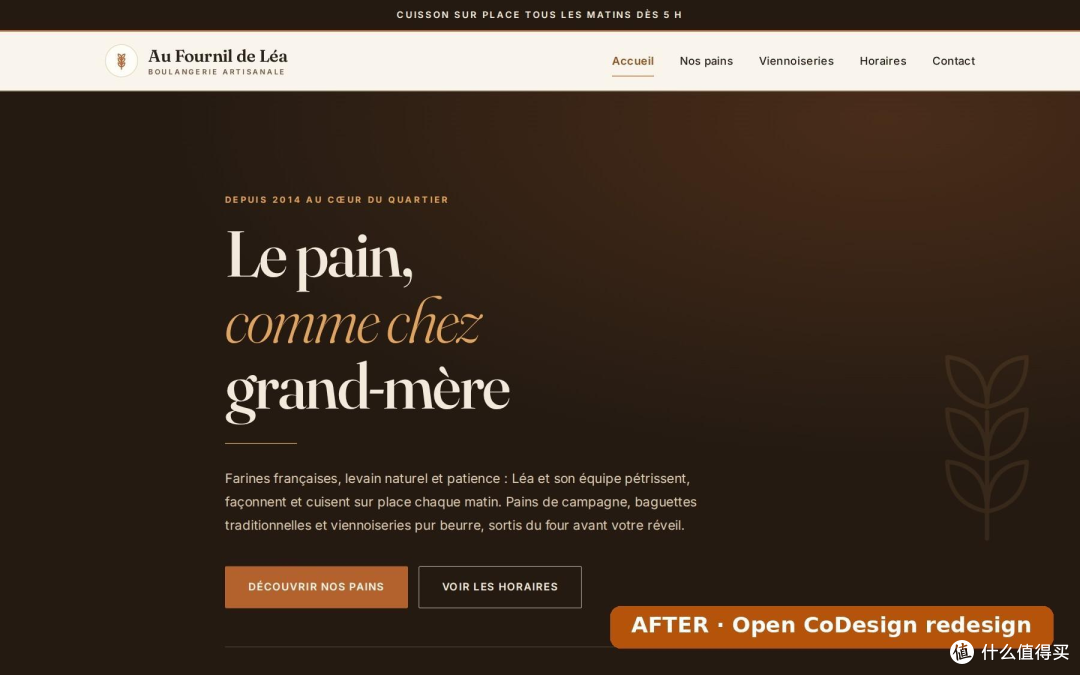
图 41 一之后:Open CoDesign 的重设计,耗时 30 分钟计算。带一点斜体的衬线标题、手绘的麦穗、线条图标、奶油色/棕色/焦糖色调;文字、价格和营业时间保持一致。
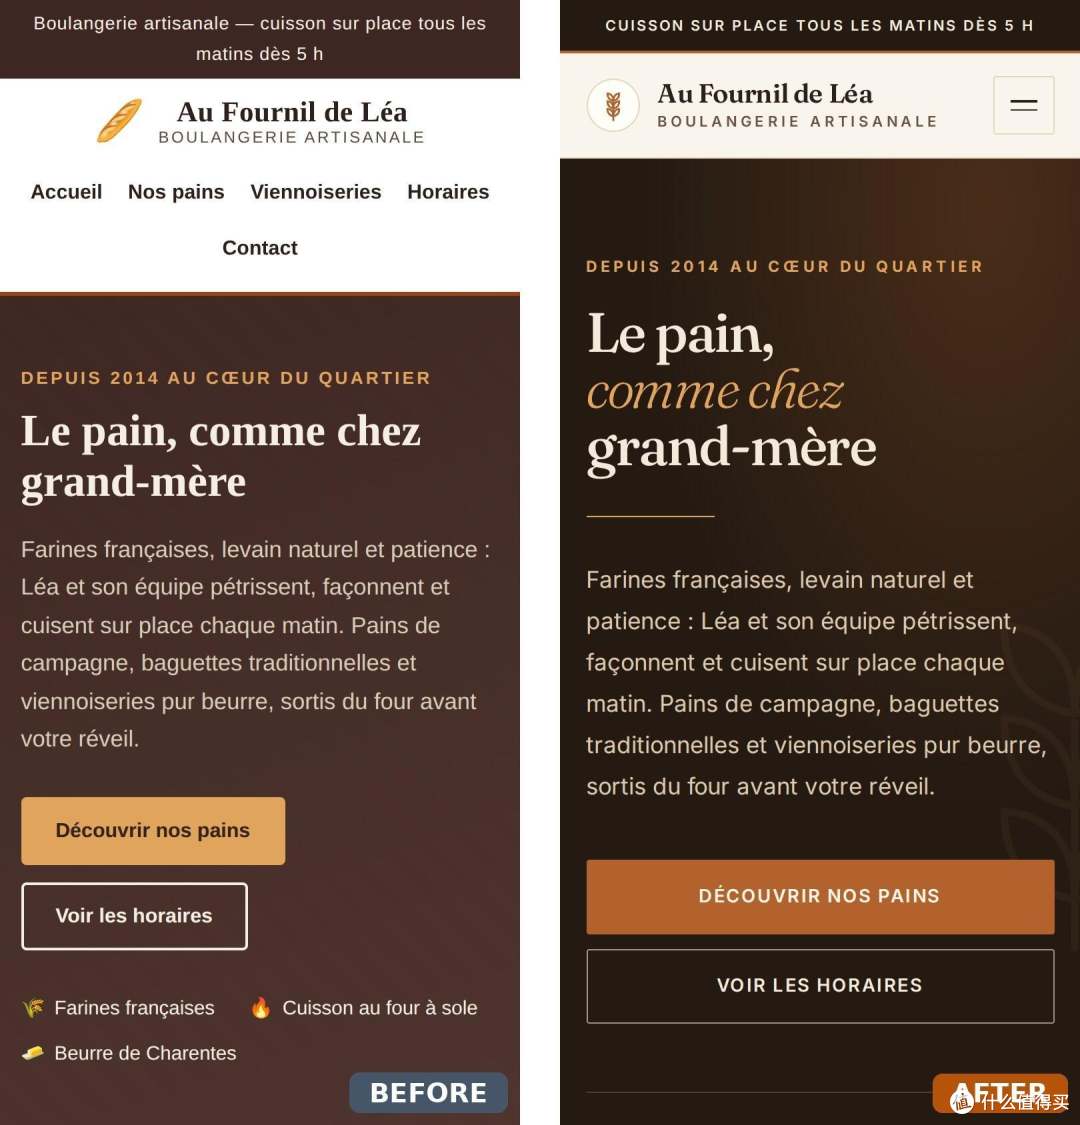
图42一在手机上:跨两行铺开的菜单变成可折叠菜单。重读章程后,Qwen自己要求做了两处快速微调:一处超出章程的颜色,然后是顶部的全宽按钮。
该工具交付的是一份忠实的原型及其章程。把它应用到真实网站仍是开发者的工作(聊天中的Qwen,或项目用Pilote),之后由审核者检查。
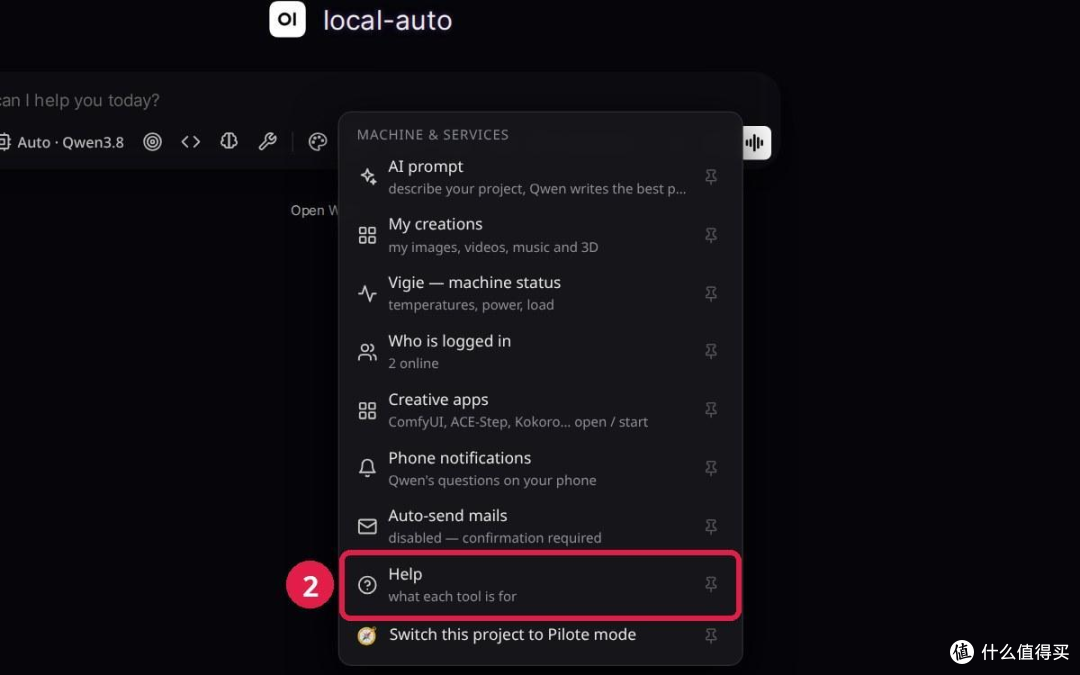
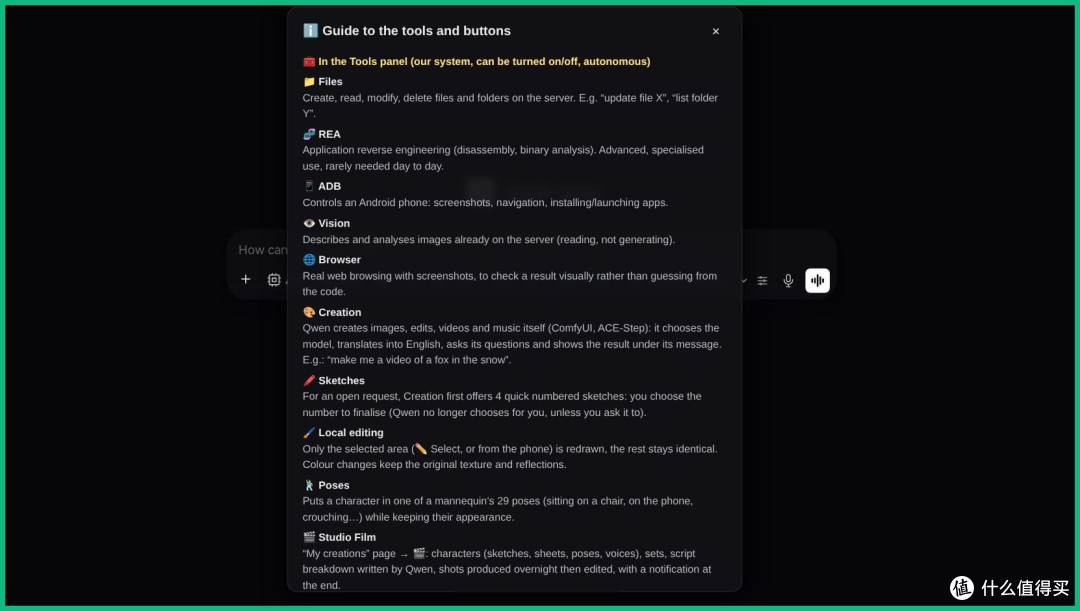
图43一访问路径:①“机器与服务”菜单,②“帮助”:每个工具和按钮的内置指南。13.图像:创作、编辑与Workbench
模型及其使用时机13.1
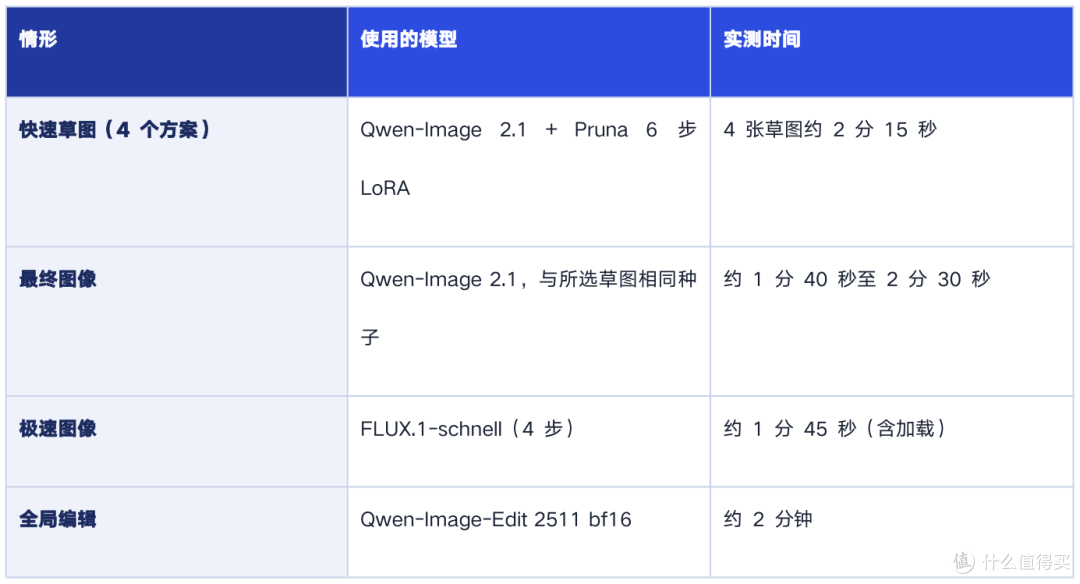
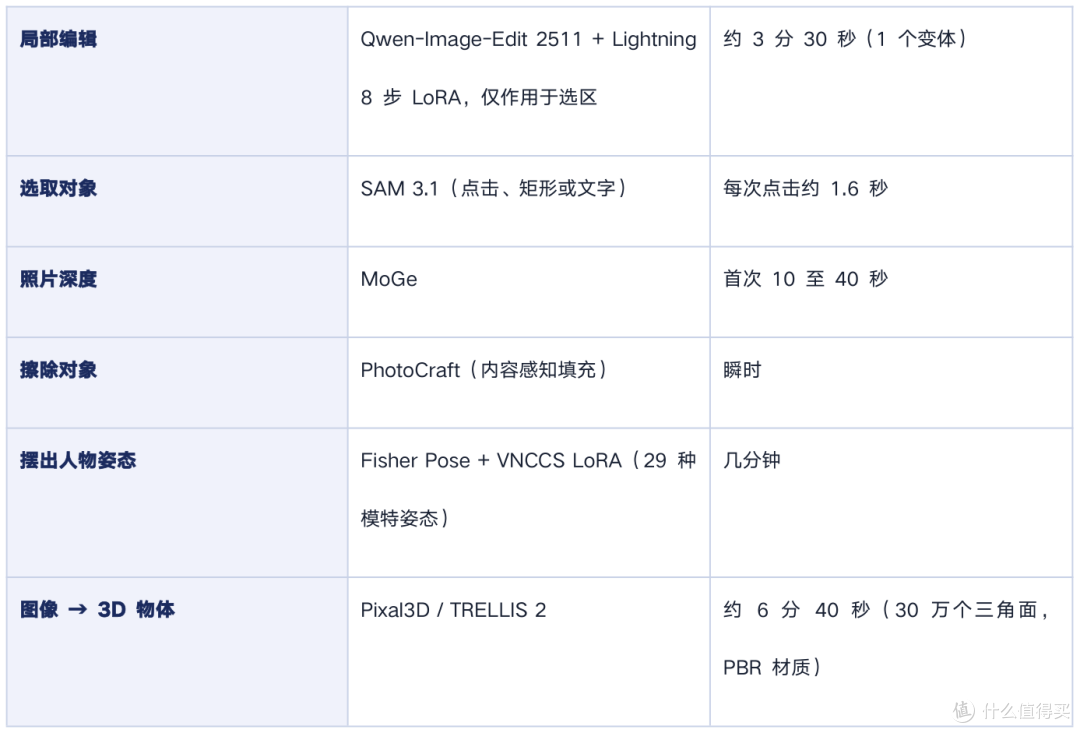
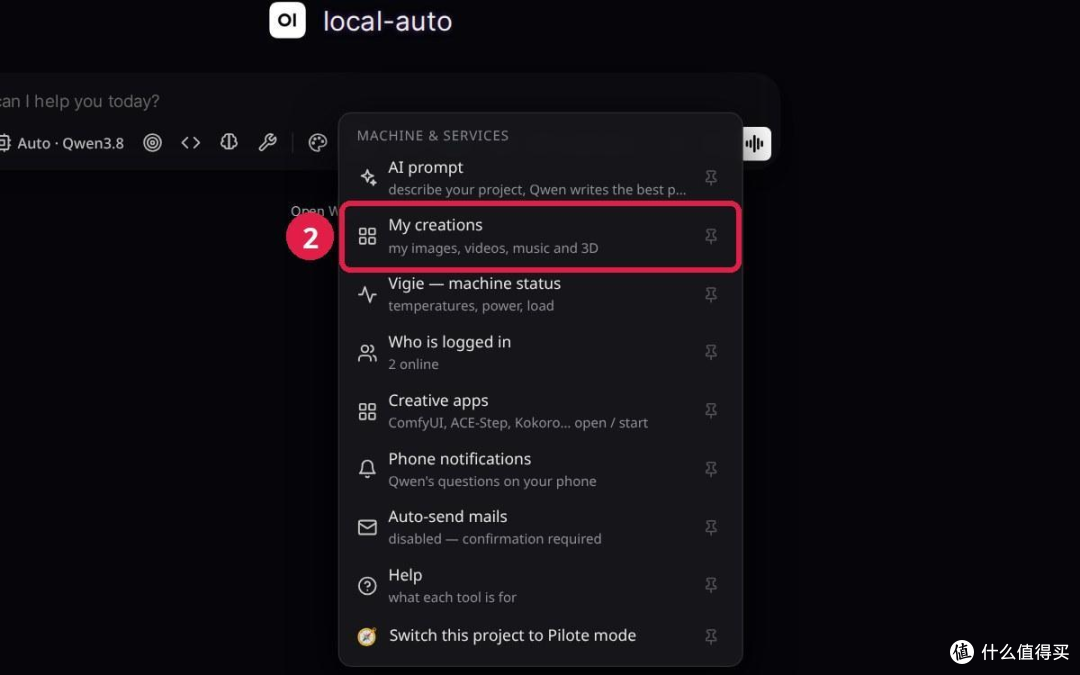
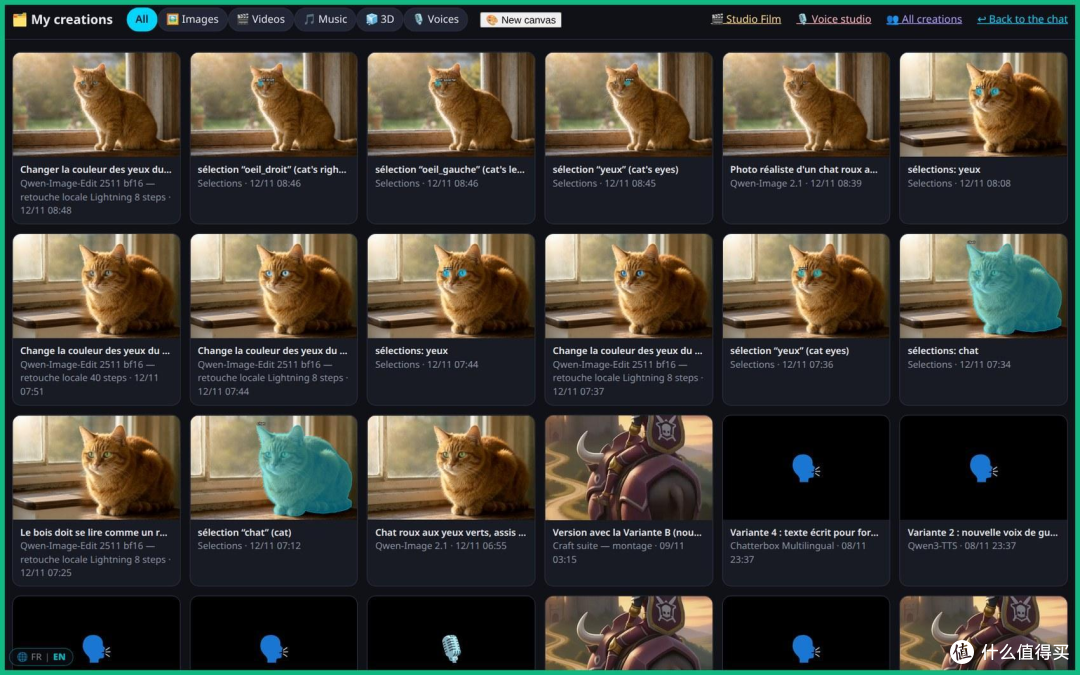
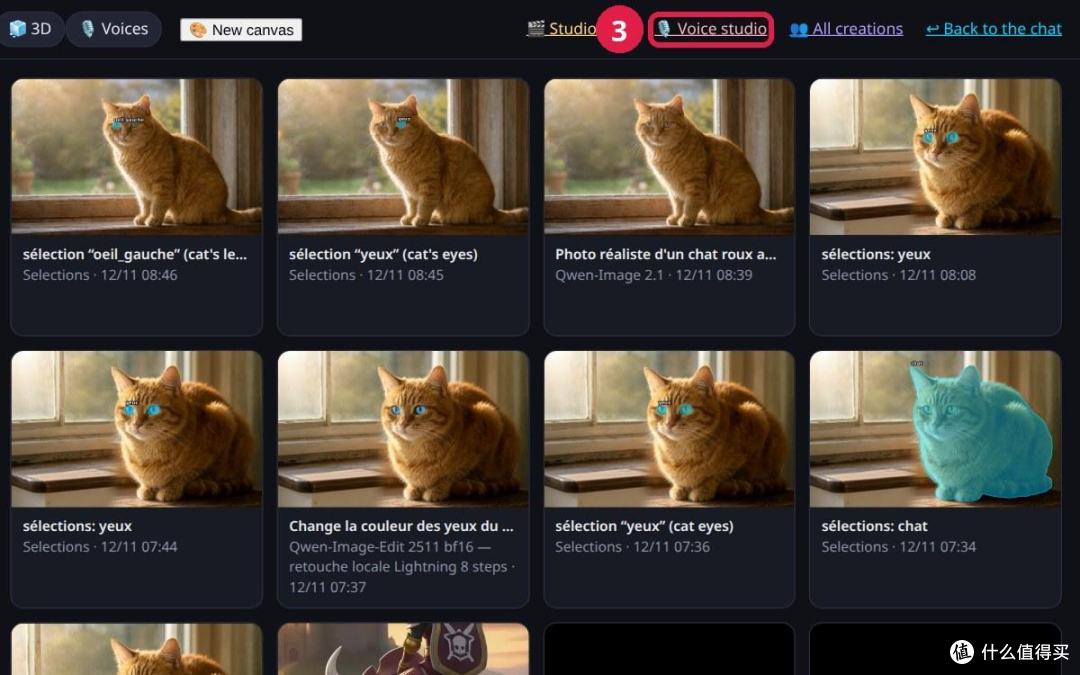
图44一访问路径:①“机器与服务”菜单,②“我的创作”:每个账户都能找到自己的图像、视频、音乐和 3D 物体。
13.2 演示一:从草图到最终图像
为避免等上几分钟却得到一张不喜欢的图,Qwen先出草图:用一个轻量模型(6步而非25步)生成四个快速方案。你挑一个,然后Qwen 用相同的种子生成最终版本,因此构图相同,但为完整画质。
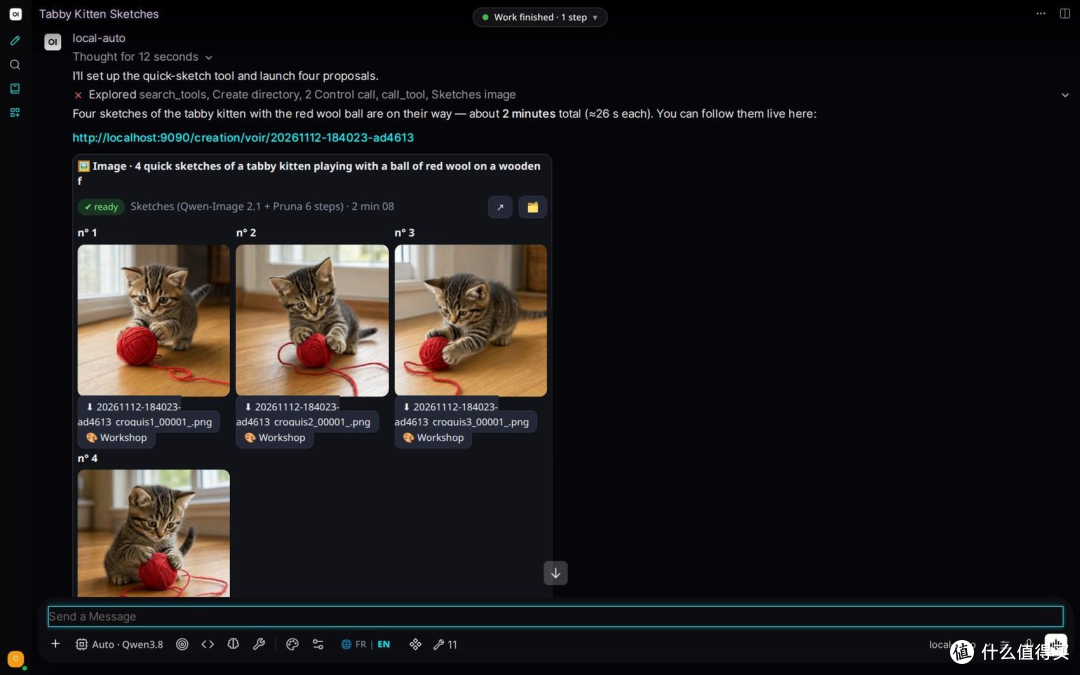
图45一请求:“4张快速草图,一只虎斑小猫玩红色毛线球”。四个方案仅用了两分多钟就送达。
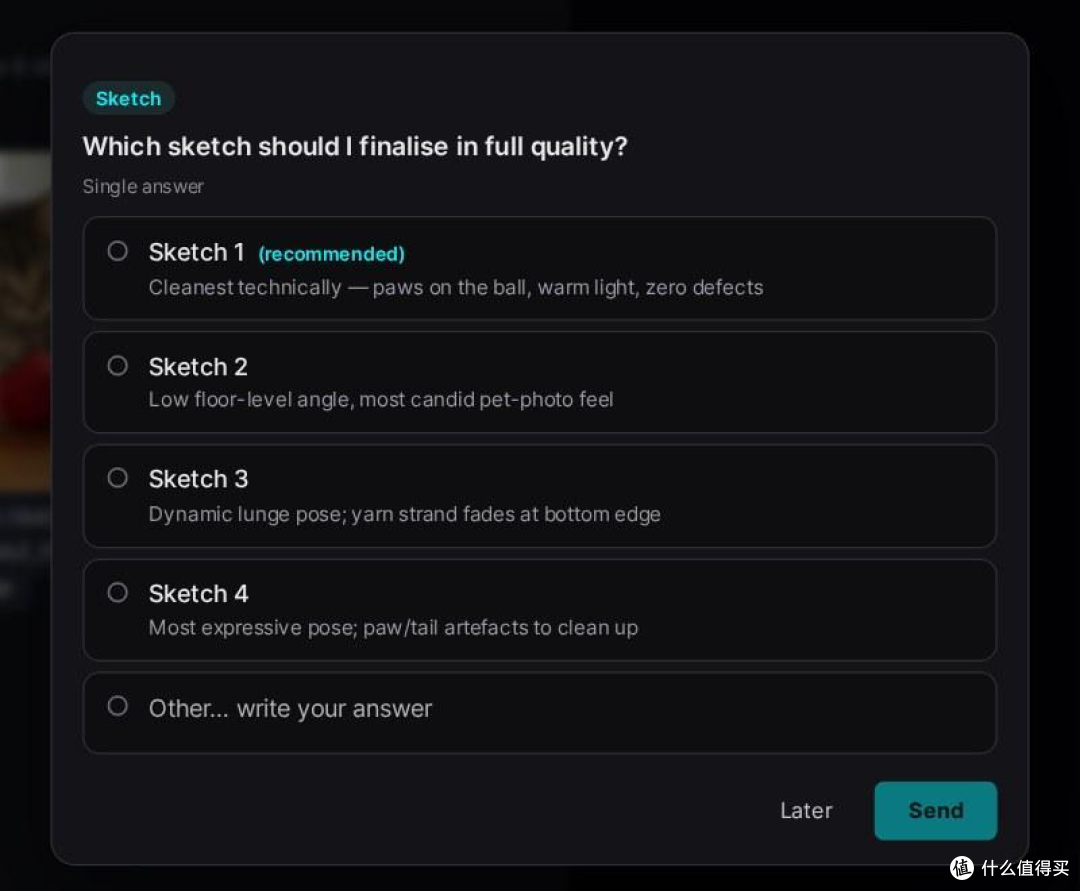
图46一Qwen描述每张草图并询问要定稿哪一张,并给出推荐选项。
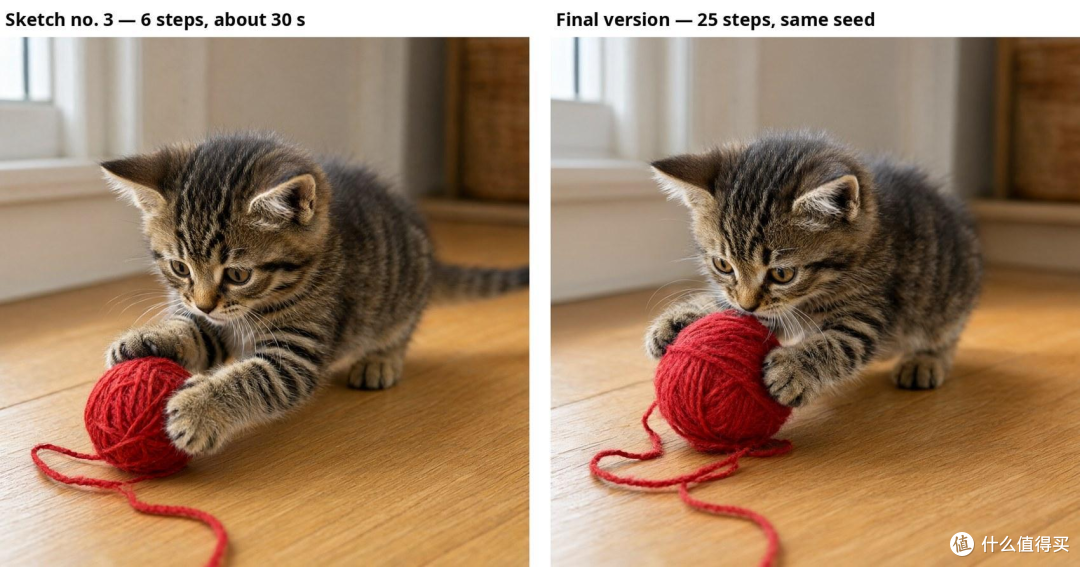
图47一“我要第3张草图,把它定稿”:左边是草图(6步),右边是用相同种子生成的最终版(25步,2分钟)。小猫、场景和取景都保留了;由于用25步而非6步,姿态仍可能略有变化,如此处所示。
13.3 演示二:一只猫,从需求到编辑
这次真实会话以英文界面运行,全程无任何人工干预,展示了完整的闭环。请求像是对人说话一样书写:“创建一张图像,一只绿色眼晴的橘猫趴在木质窗台上”,然后“把猫的眼睛颜色改成浅蓝色,不要动图像其余部分”
Qwen自行选择模型(Qwen-lmage 2.1,1344×768),写一份详细的提示词并启动生成。其间Qwen被暂停,暂停窗口提醒每位用户。图像就绪后,解释器以“自动续写”重启Qwen。Qwen用视觉检查图像,发现眼晴仍是绿色:只要求蓝眼晴还不够。于是它用SAM选中每一只眼晴,检查两个选区确实覆盖了双眼,然后只用局部编辑重绘眼晴。
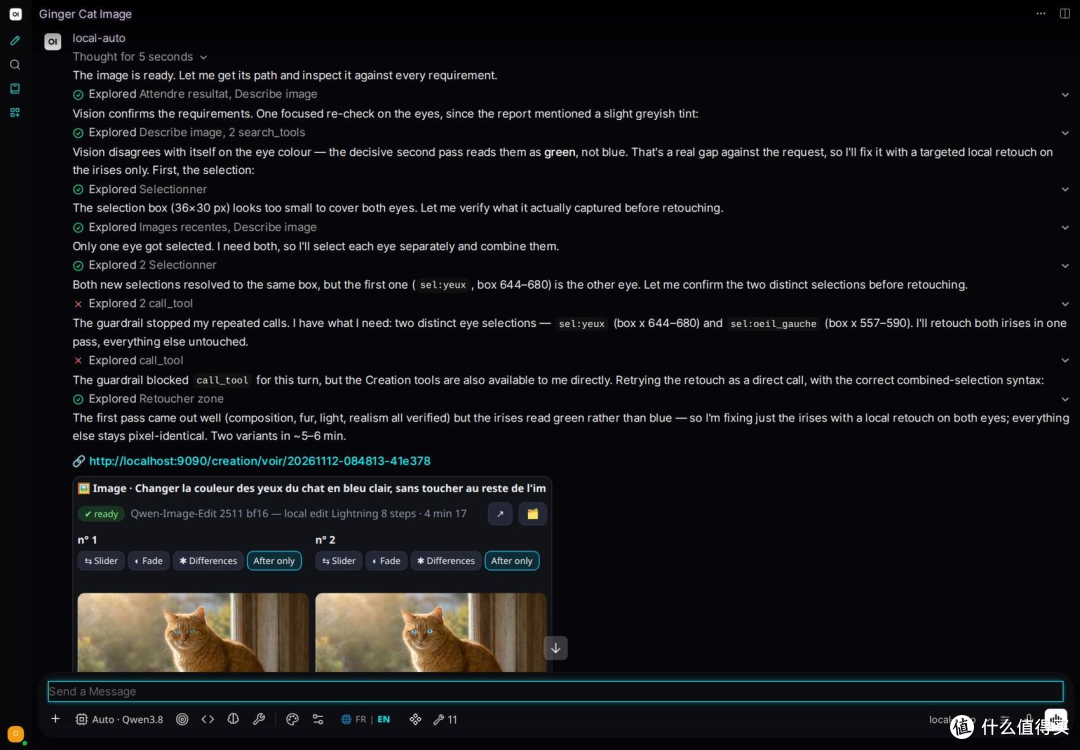
图48一自我检查:视觉发现眼晴仍是绿色;Qwen选中双眼,检查选区,然后启动定向局部编辑。注意那条护栏——它叫停重复的工具调用,迫使Qwen换一种思路。
在对应的法语会话中,Qwen做得更进一步:它判断木头看起来更像木地板而非窗台,把猫锁定使其一个像素都不动,然后只重绘图像左侧部分。
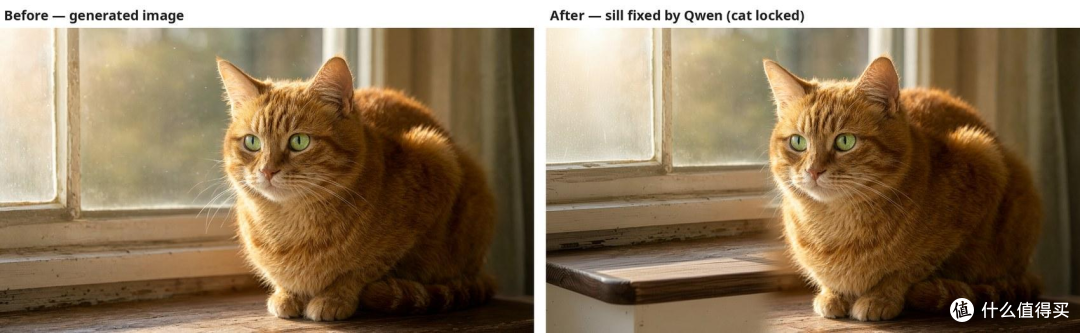
图49一之前(左)与之后(右):只有左侧部分、也就是窗台发生了变化。
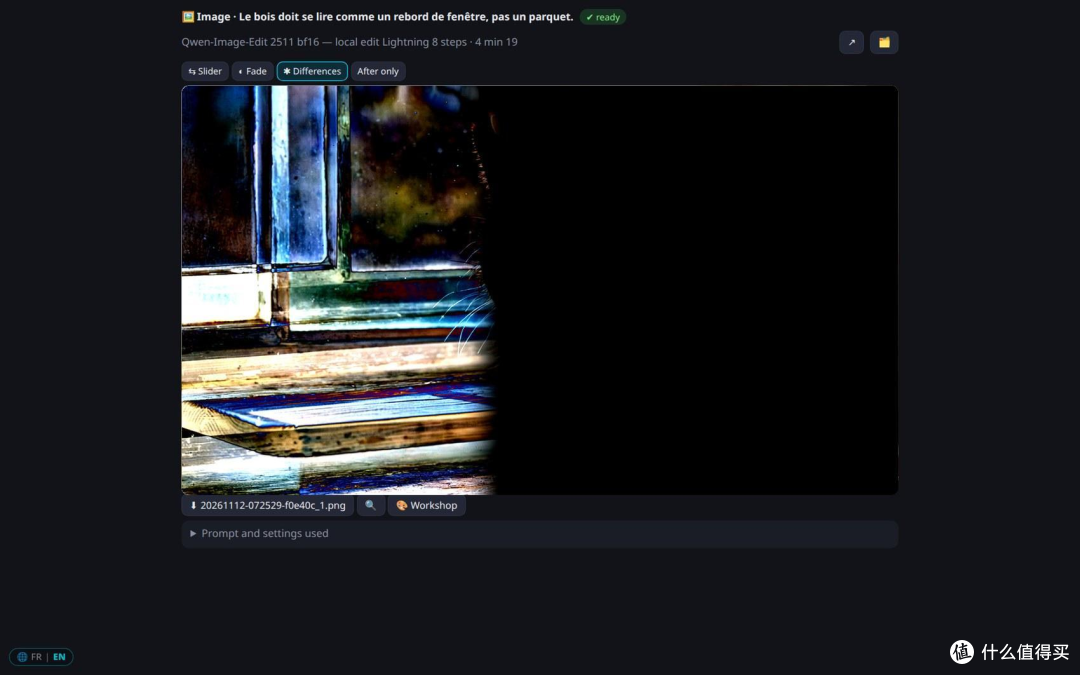
图50一查看器的“差异”模式:被修改的区域亮起,其余保持黑色。每当编辑很细微时,就该用这个工具。
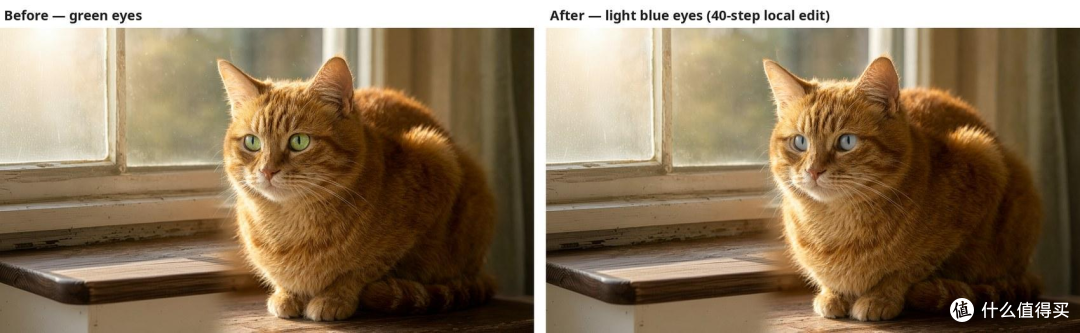
图51一局部编辑前后的眼晴(40步,最终画质):只有虹膜的颜色变了。
13.4 本地编辑
在项目开始时,每次修正都要重绘整张图(21分钟,而且一个成功的细节可能消失)。本地编辑改变了一切:
参考网格(A至L列)用于指定区域,或通过点击/文字建立命名选区。
编辑某个区域:在该区域周围裁剪,快速或精细编辑,1至4个变体,然后以混合方式贴回全分辨率原图。
合并版本:瞬时地从另一个版本取用某个区域。
锁定:保护一个成功的区域;Qwen便无法再编辑它。
溢出:当模型在选区外绘制的内容与选区相连时予以保留(一道阴影、一只袖子)。
忠实图案:把用户精确的图案(一枚纹章、一个logo)放入某个区域,而不是让模型描述它再重新发明。
用PhotoCraft擦除对象,不留幽灵般的残影。
13.5 Workbench @
Workbench是一个从任意图像打开的完整编辑器。它用于精确准备Qwen要做的事:
选区:SAM魔棒(点击添加,右键排除)、矩形、英文单词、套索、画笔和橡皮(可调大小和硬度)。
图层:把选区复制到图层、移动对象(其原位置由Qwen填充)、把像素置于前景、镜像、旋转、导入图像并自动抠图。
深度:MoGe以米为单位重建照片的几何;一个“放进场景”的图层会被前方物体遮挡,“放到地面”时其大小会遵循透视。
按区域的指令,可附任意数量的参考图,然后发送给Qwen。
触摸与手写笔:双指缩放,手写笔压感控制笔刷大小,识别橡皮擦笔尖。
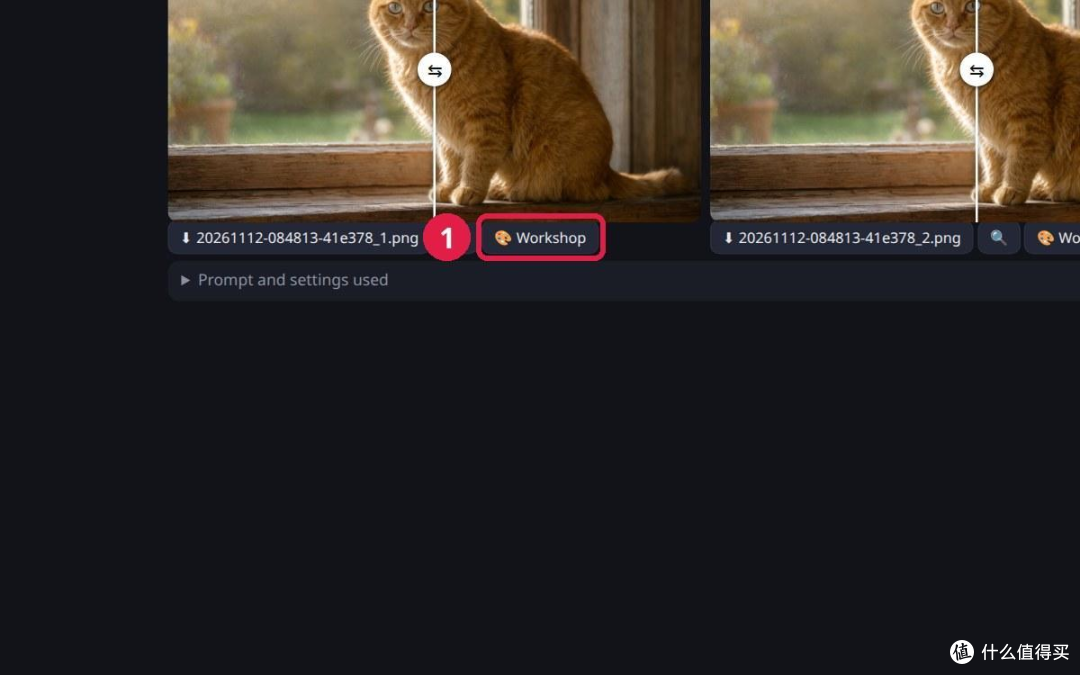
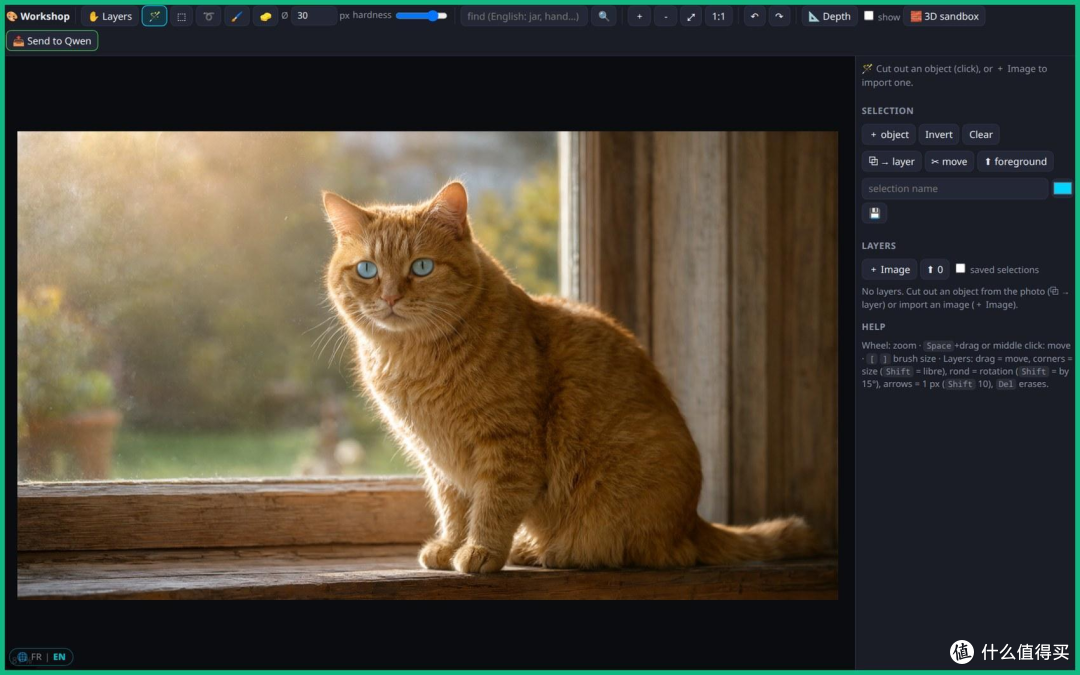
图 52一访问路径:①图像下方的 Workbench 按钮;编辑器在该图像上打开。
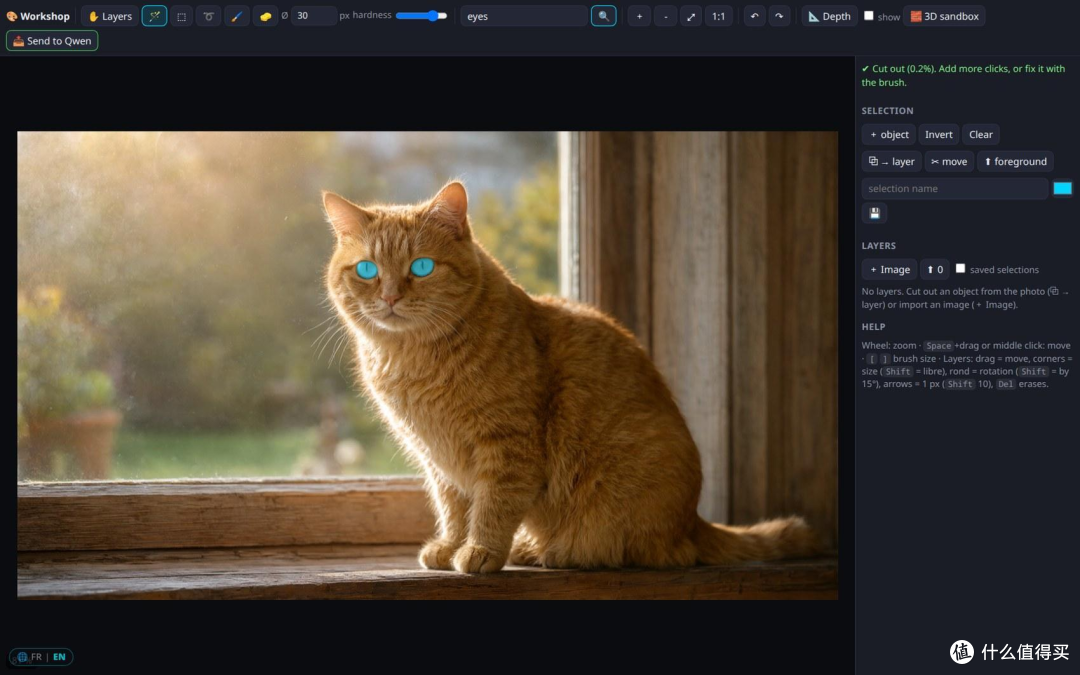
图53一用SAM魔棒选中眼晴:一次点击就够,每个选区都有名称和颜色。
13.6 演示三:借助参考图进行多次本地编辑
为展示Workbench的全部潜力,Qwen先生成了一间客厅(灰色沙发、茶几、落地灯、抽象画、植物、地毯),然后按要求生成三张产品图作为参考:一张祖母绿天鹅绒沙发、一幅“星夜”风格的画和一盏黄铜弧形落地灯。在Workbench中,随后用一个简单的词选中房间里的三个对象,各自按名称保存,连同一条指令和每个区域一张参考图交给Qwen。
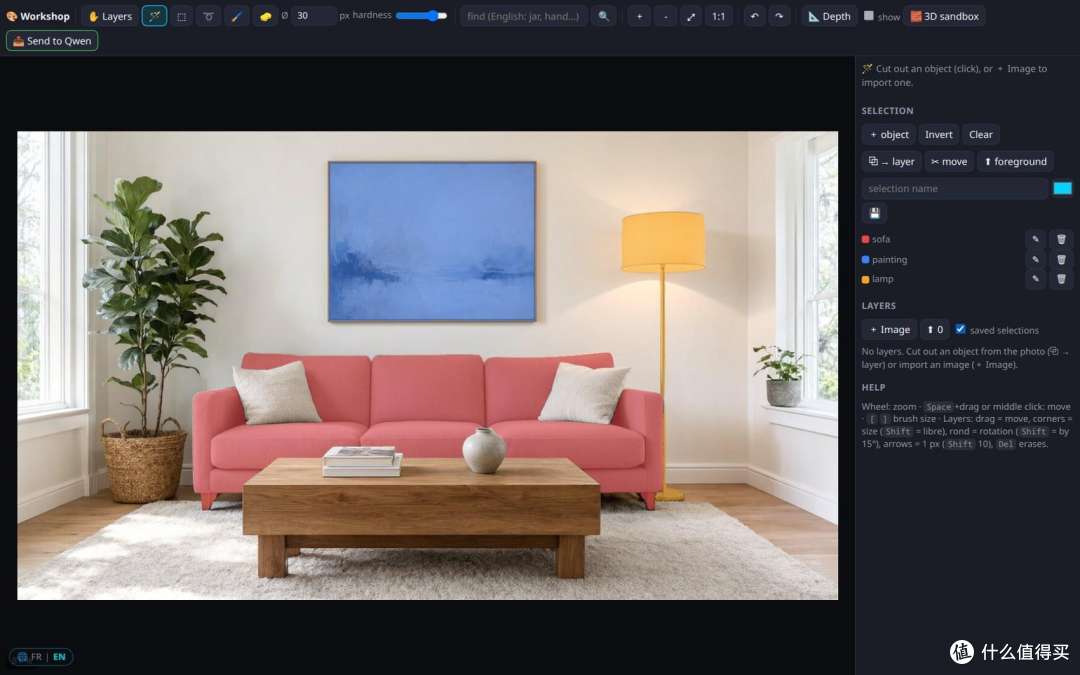
图54一通过词语(“沙发”“画”“落地灯”)做出的三个选区,随后命名:每块抠出的区域都染上各自的颜色(红、蓝、橙)。
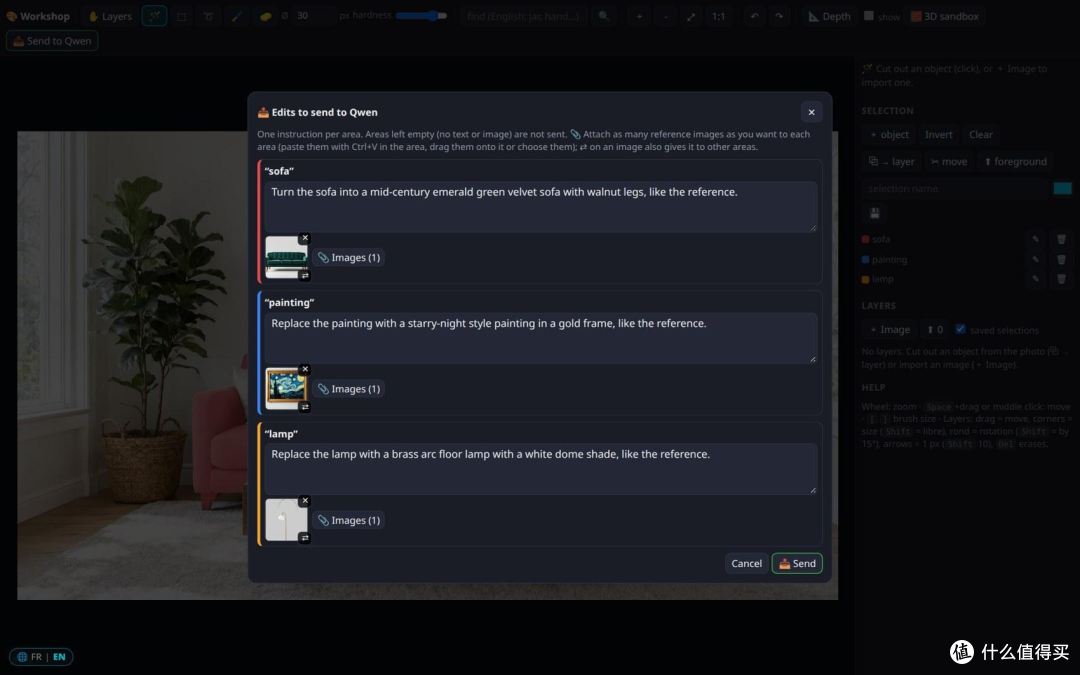
Qwen自行执行三次本地编辑(每次约9分钟),并用视觉逐一检查。沙发和画一次成功。落地灯则不然:灯罩悬空,与灯杆脱节。Qwen自己发现了问题,用两遍干净地擦除该区域,然后放置一盏完整的弧形落地灯。
这正是查看器的“差异”按钮体现价值之处。结果看起来不错,但与上一版本对比后发现编辑区域溢出了:茶几末端被延长,出现了第二个花瓶,沙发变长了。Qwen在报告里没有注意到这一点。
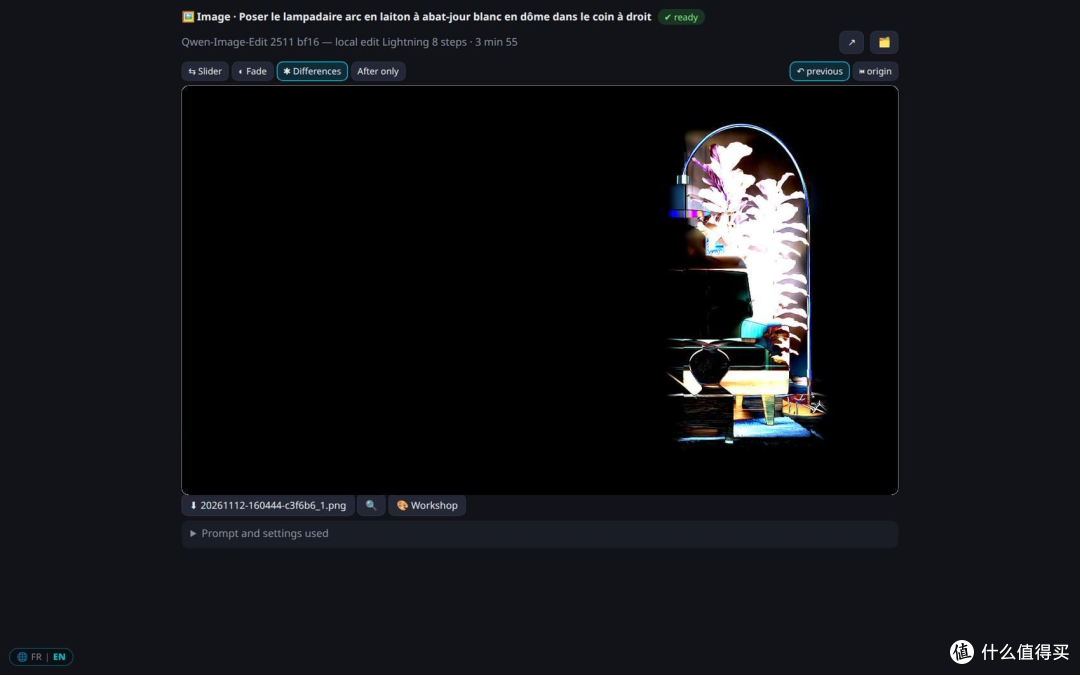
图56一落地灯放置上的“差异”模式:除了灯,沙发末端、茶几和一个花瓶也亮了起来。区域溢出了。
像用户那样在对话中反馈后,修正尝试了好几次:两次“版本合并”都复用了已经损坏的版本(Qwen原地打转约五十分钟,其轮次被叫停),随后按一条精确指令(从落地灯成功的版本重新开始,锁定好的部分,只做一次本地编辑),一次编辑、用PhotoCraft擦掉多余花瓶,再做最后一次清理编辑。结果:只剩一个花瓶,茶几和沙发一致。这个教训很实在:本地编辑很强大,但区域过宽会溢出,而“差异”模式能让你一眼看出来。
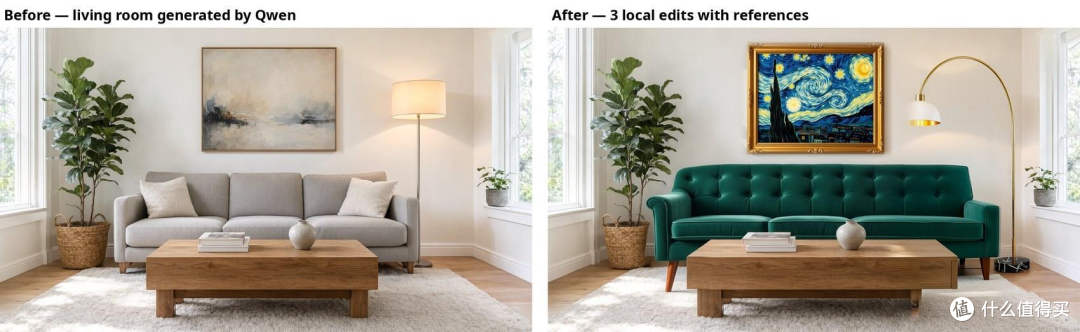
图57一前后对比:沙发、画和落地灯呈现出参考图的样子;植物、窗户和墙未受影响。
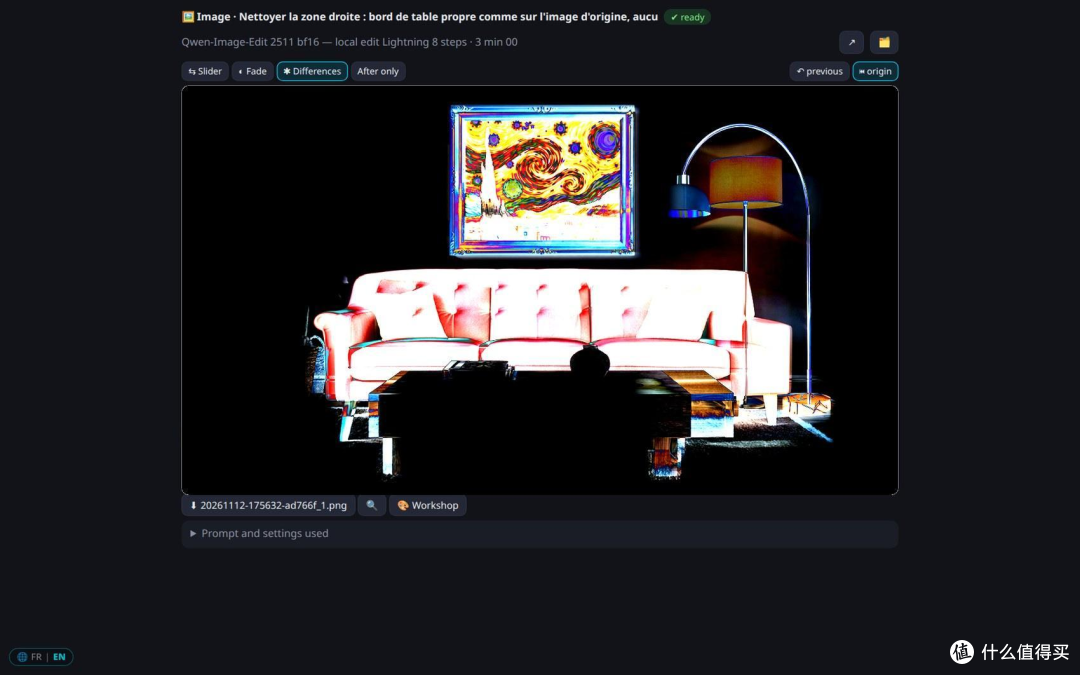
图58一与原图对比的“差异”模式:只有画、沙发、落地灯和桌子末端亮起。
13.7 3D沙盒
3D沙盒借助MoGe(它估算每个像素的距离)把照片变成一个带起伏的空间。理解它的最好方式是旋转照片:它不再是一张平面图,而是一个你可以绕着走的场景。
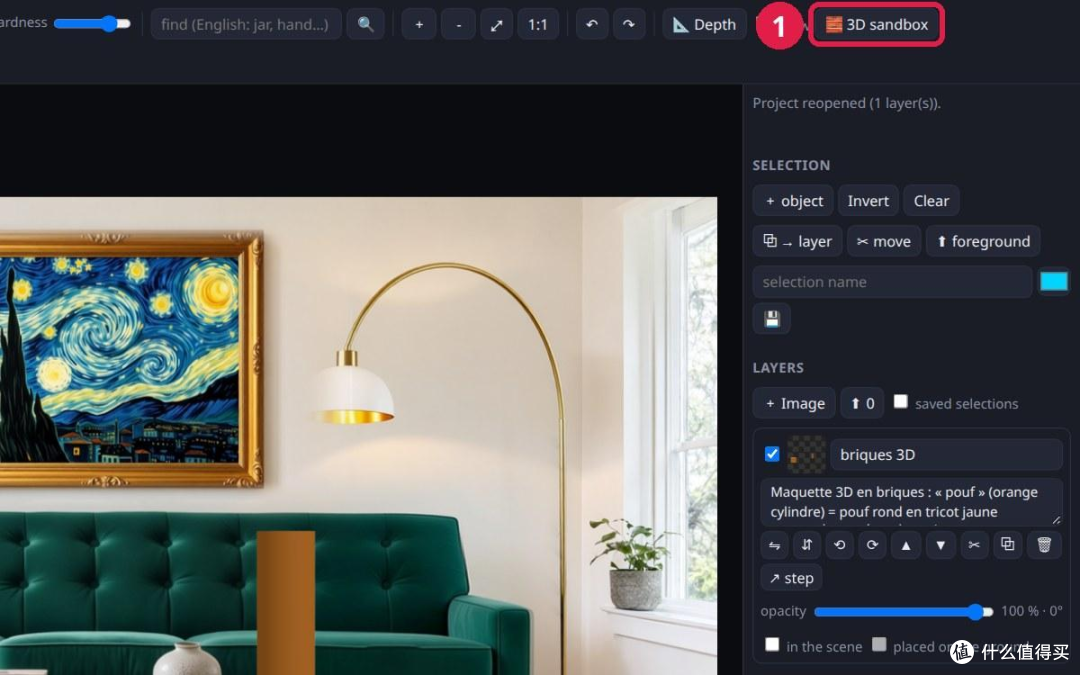
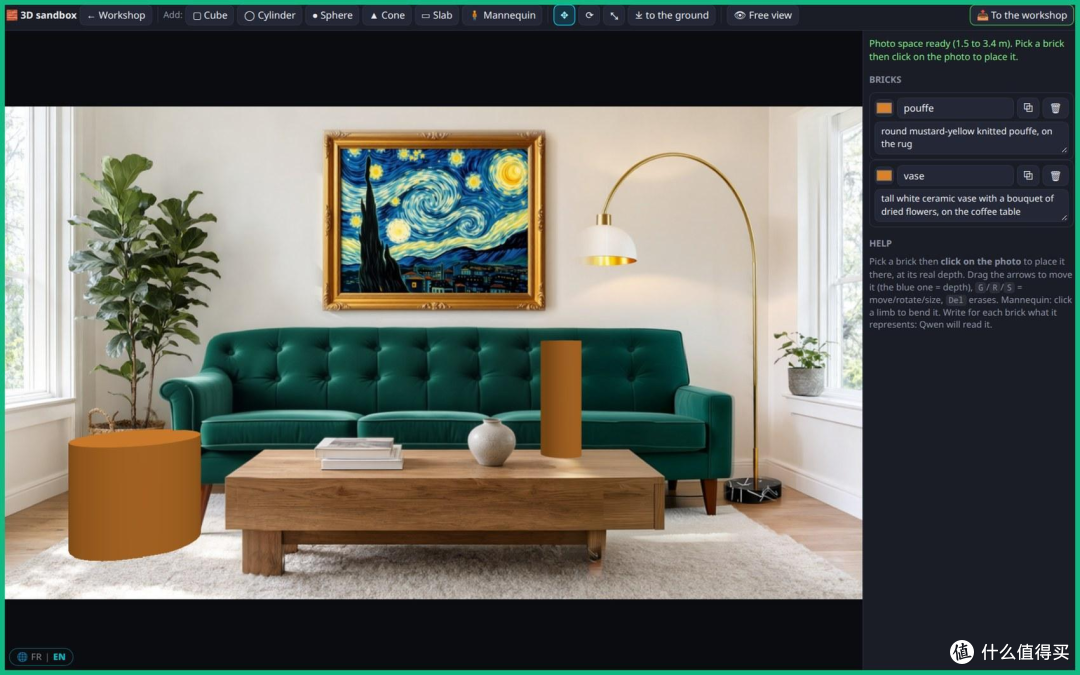
图59 一访问路径:在Workbench 中,① 3D沙盒按钮。
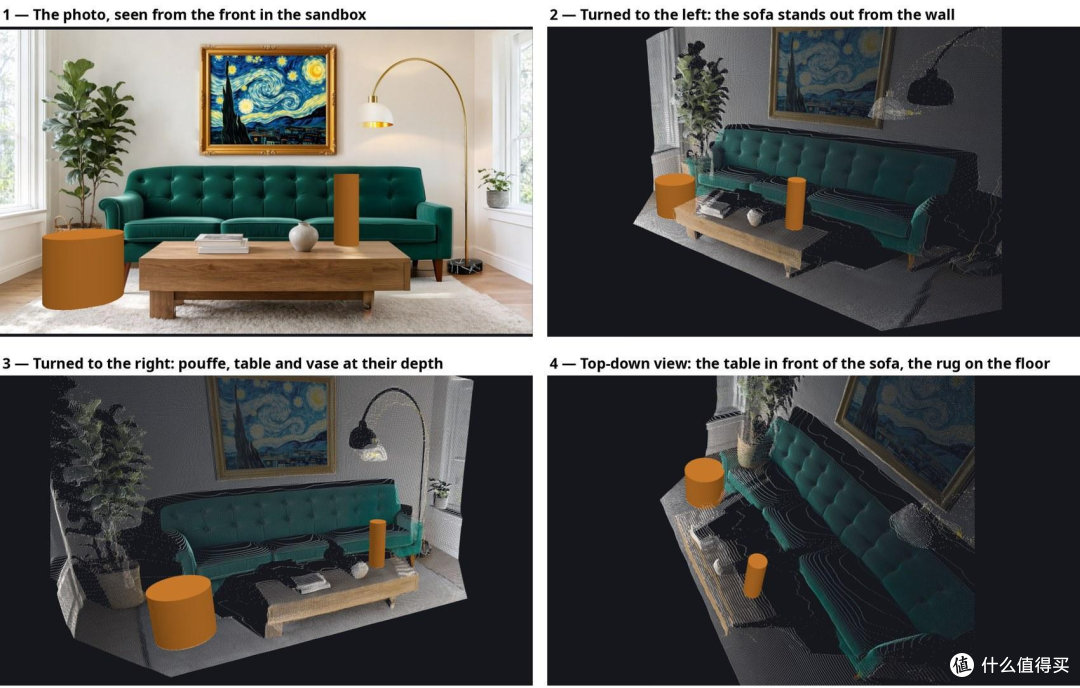
图60一同一张照片,在沙盒的自由视角中旋转:墙在后方,沙发在墙前,茶几和地毯在前景。每个点都是照片的一个像素,被放回它真实的距离处。
你在其中放置简单体块(立方体、圆柱、球体、圆锥、板)代表要添加的对象:它们会根据距离自动采用正确尺寸,隐藏在前面的物体之后,并落在照片真实的地面上。每个体块都有一个名称和给Qwen的描述。然后把原型导出到Workbench并交给Qwen,它用照片的光线和透视把每个体块替换成所描述的对象。
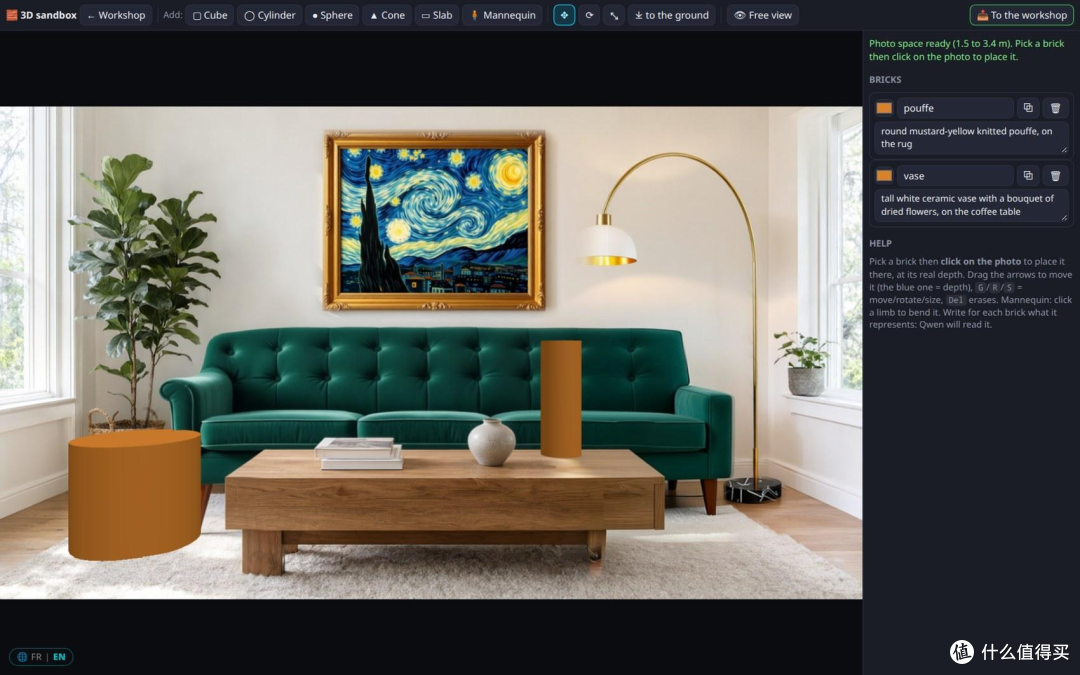
图61一沙盒中的客厅:地毯上一个45cm的圆柱代表坐墩,茶几上一个细长40cm的圆柱代表花瓶,各自命名并描述。
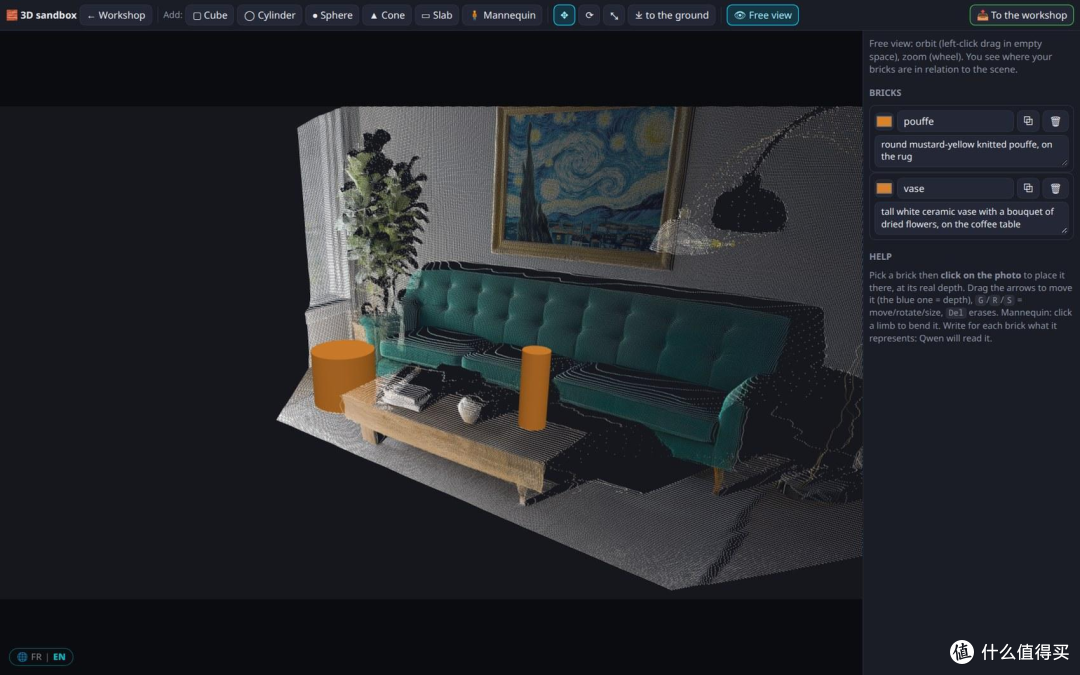
图62一等轴测的自由视角:你检查坐墩是否在地上、花瓶是否在桌上,且深度正确。
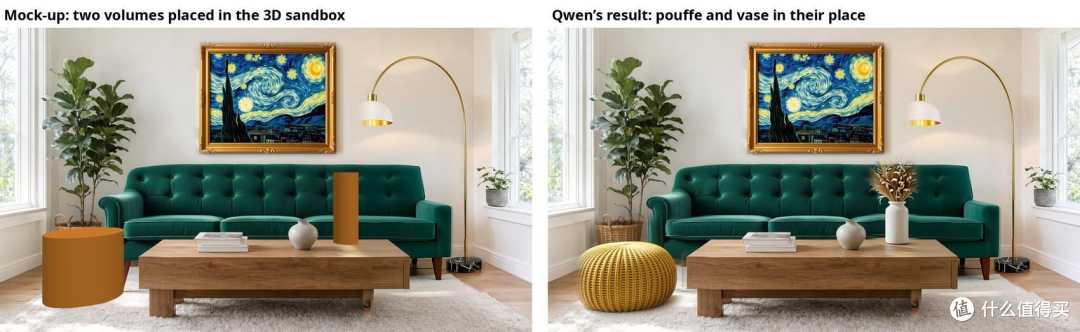
图63一发送给Qwen的原型(左)及其结果(右):一个芥末色针织坐墩和一个插着干花的白瓷花瓶,一次就放在正确位置、呈现正确大小。
13.8 从图像到3D
一张图像可以变成带贴图的3D物体(Pixal3D或TRELLIS2),导入Blender,放到地面上并自动布光。Qwen 也可以直接在Blender 中建模,它在后台启动 Blender,并展示染图以及可下载的-glb和 .blend 文件。
14.视频、剪辑与音频
14.1 视频
和图像一样,你只需向Qwen提出要求:它根据想要的画质和可用内存选择模型,用英语写带镜头运动的提示词,然后通过一张编号顿表(用视觉查看)来检查视频。
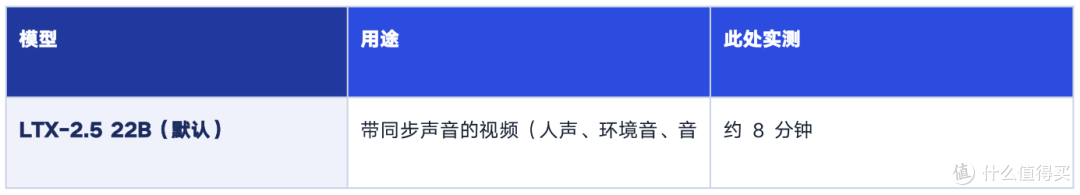
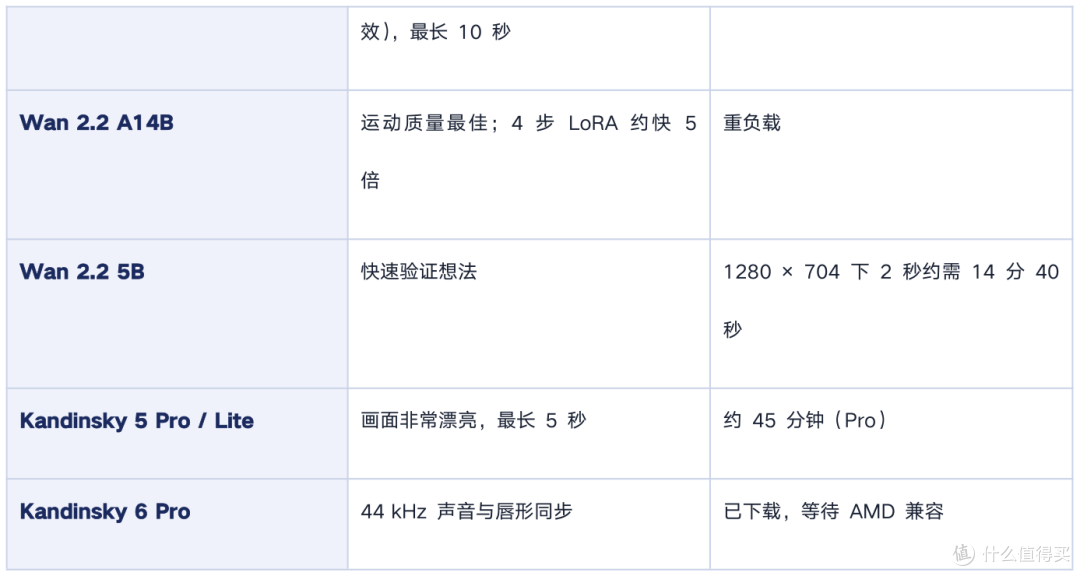
经过比较,LTX-2.5被选为默认:8分钟对Kandinsky5Pro的45分钟,而且还带声音。
14.2 由Qwen完成剪辑,借助Craft套件
光生成镜头还不足以构成一部电影:必须把它们剪辑起来。为此,Qwen可以使用Craft套件的视频剪辑应用FilmCraft,它通过命令驱动,就像剪辑师用鼠标一样:
创建剪辑项目并导入镜头(刚生成的视频、ACE-Step音乐、配音);
如果缺某个镜头,它可以搜索免版税素材(Openverse)并下载到项目中,自动记录署名;
创建序列,然后把每个元素放到时间线上:视频和音频轨道,精确到顿的位置和时长;
以H.264导出影片并发布到创作成果中,附上署名。
换句话说,Qwen可以自行把它的所有动画剪成一部电影,无需任何人打开剪辑软件。其他Craft应用是自动工具不够用时的后备:PhotoCraft用于手工修图(仿制图章、图层、滤镜),SoundCraft用于声音。
14.3 电影工作室
电影工作室为一部完整动画电影做准备:
角色:档案、参考图、4张草图、选择,然后是视图表和表情表以检查一致性、姿态、声音。
场景,以同样方式创建。
剧本:Qwen把它分解为若干场和3至10秒的镜头(取景、动作、声音、台词)。
夜间制作:对每个镜头,生成关键图像、带声音的LTX视频、配音台词;每个镜头两次尝试。
合并:角色的配音混到视频的环境音上(环境音降到35%以保证可懂),然后所有镜头按剧本顺序首尾相接合成一部电影。开始和结束时都会发出通知。
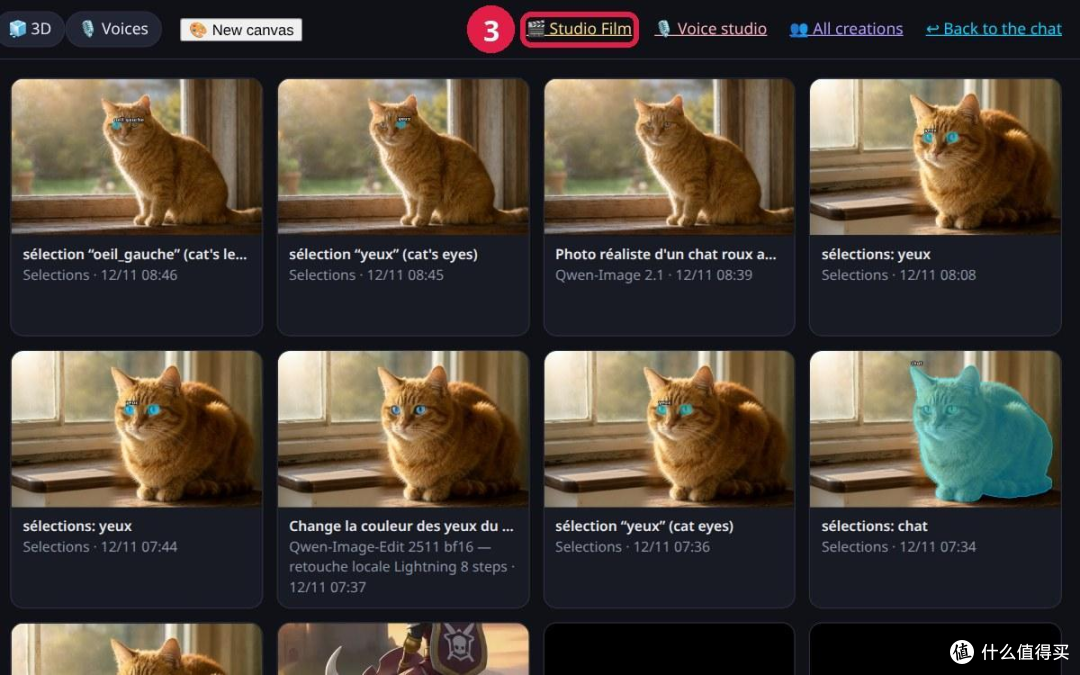
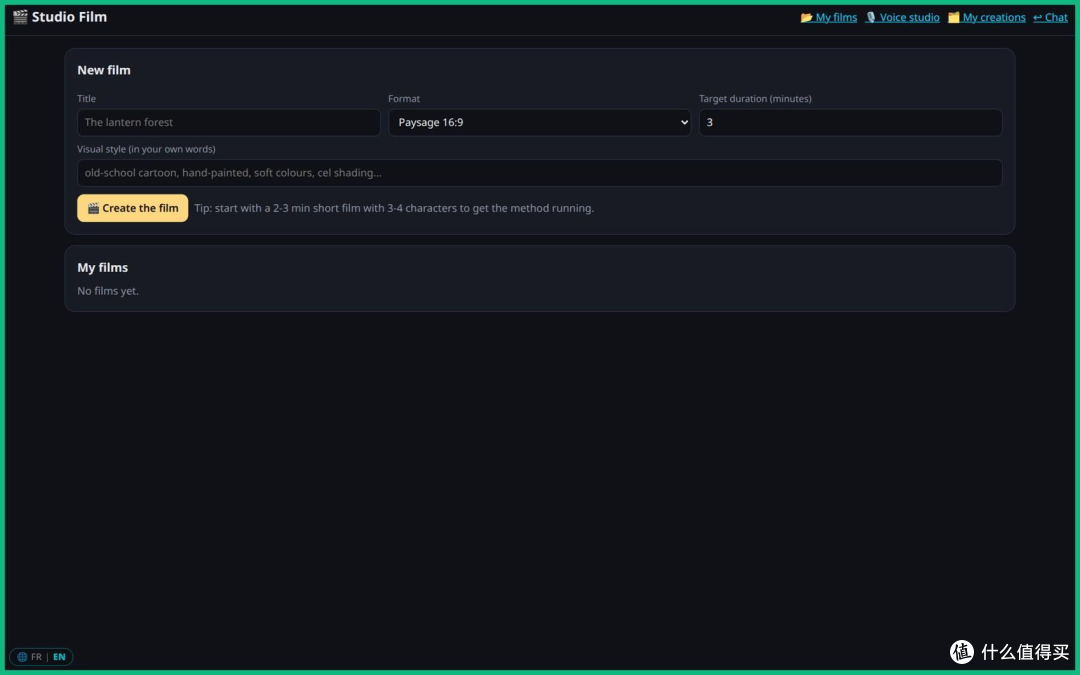
,?“与器,①一9
一次带看,基于一部真实的演示影片。为本文,在电影工作室里端到端准备了一部短片:《守塔人》,讲述穿黄色雨衣的小女孩Lina 和脾气强的老守塔人Gaspard,在一个暴风雨之夜共同重新点亮灯塔的故事。下文所有内容都在本机生成,没有任何外部图像。
影片头部设定标题、画幅(16:9横版、9:16竖版或方形)、自标时长和视觉风格,用你自己的话描述(“手绘卡通,柔和色彩,温暖的黄昏光线”)。该风格只翻译一次成为给模型的指令,并应用到影片的每一张图像。随后工作在五个标签页中按顺序进行。
标签页1:角色
每个角色都有一份档案:名字、服装、外貌描述、性格、举止(行动方式)、最多40张参考图(如果有),以及来自声音工作室的一种或多种声音。“制作4张草图”按钮在约两分钟内给出四张图;你用星标选一张,它就成为角色的基础图像,在每个镜头中复用,使角色从头到尾保持同一张脸。
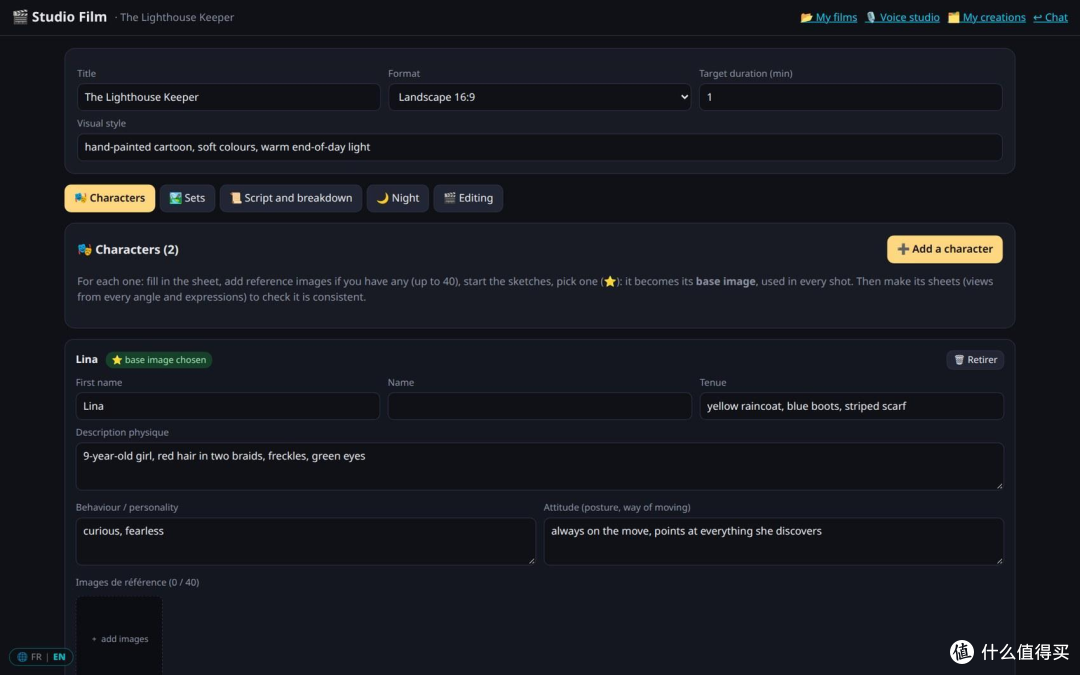
图65一“角色”标签页:影片头部、Lina填好的档案和她的四张草图;星标标出选中的基础图像。
接着是检查表:视图表(正面、四分之三侧面、侧面、背面)和表情表(中性、喜悦、悲伤、愤怒、惊、恐惧),以便在生产开始前检查角色从各个角度都一致。借助3D人体模型,角色还可以摆出29种预设姿态之一(坐、跑、跪)。
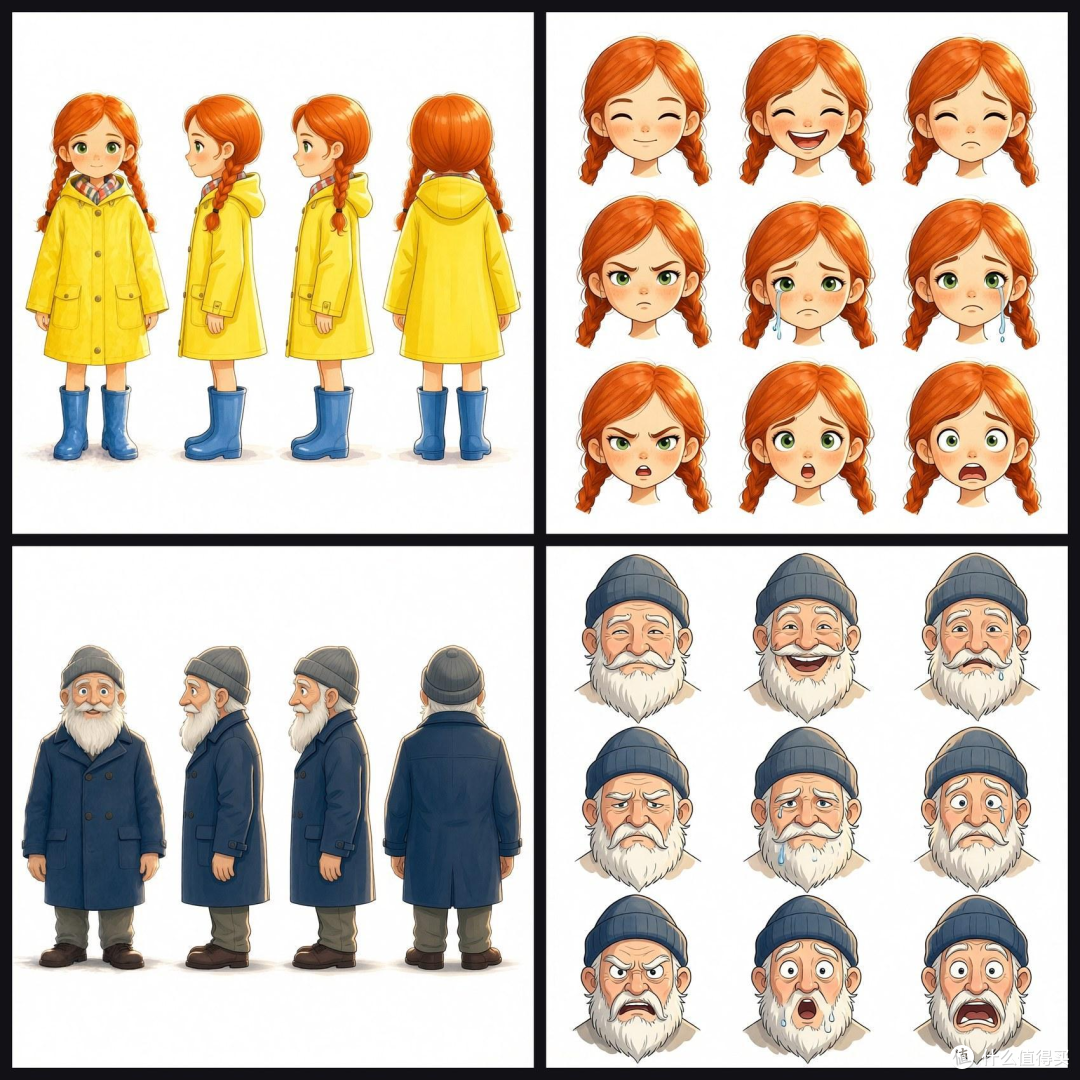
图66一Lina和Gaspard的检查表:从四个角度看的视图和面部表情,由它们的基础图像生成。
标签页2:场景
影片中每个地点一个场景,带一个整体主题(年代、地区、季节)。与角色一样:四张草图,或根据提供的照片/平面图绘制,然后选择基础图像。
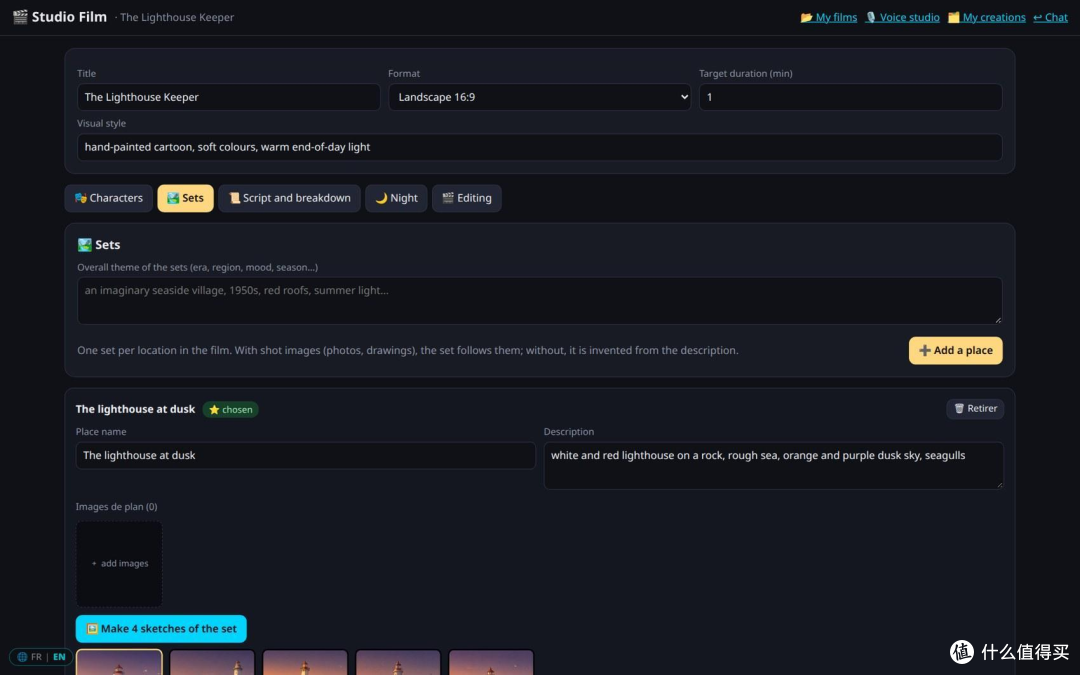
图67一“场景”标签页:“黄昏时的灯塔”,它的描述和四个方案。
标签页3:剧本与镜头表
你用几句话讲故事,然后“用Qwen分解为镜头”按钮把它转成若干场和3至10秒的镜头。对每个镜头,Qwen给出地点、在场角色、动作、时长和台词,并用英语写出两条技术提示词:起始图像,然后是运动、镜头和声音。对于《守塔人》,Qwen在几分钟内为1分钟的影片生成了12个镜头。一切仍可手工编辑,“重做”会把某个镜头送回下一个夜间处理。
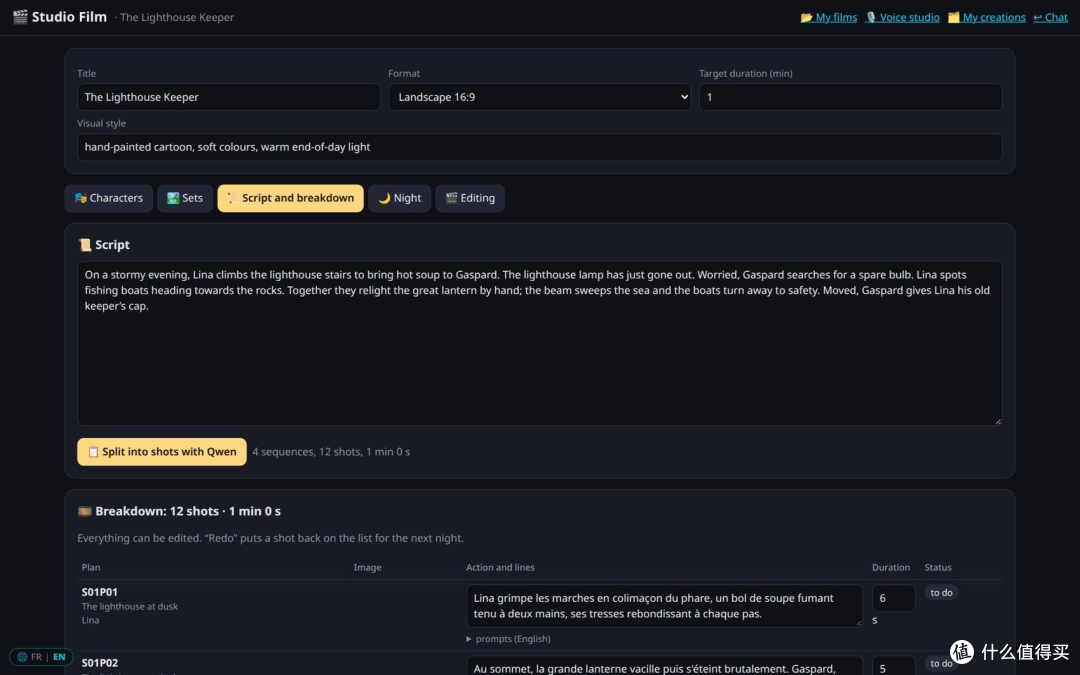
图68一“剧本”标签页:几行故事,然后是Qwen分解为12个镜头(地点、角色、动作、时长、状态)。如实说明:Qwen仍用法语写镜头描述——分解尚未跟随账户语言。
标签页4和5:夜间与剪辑
“夜间”标签页在生产前复核准备工作(角色及其基础图像和声音、选定的场景、已分解的镜头)并估算计算时间:每个镜头约10分钟(关键图像、带声音的LTX视频、配音),即每个9小时夜晚约50个镜头。你选择开始和结束时间;其间Qwen被暂停,开始和结束时都会发出通知。如果一部影片一个晚上做不完,第二天晚上重新启动即可:一切从停止处继续。
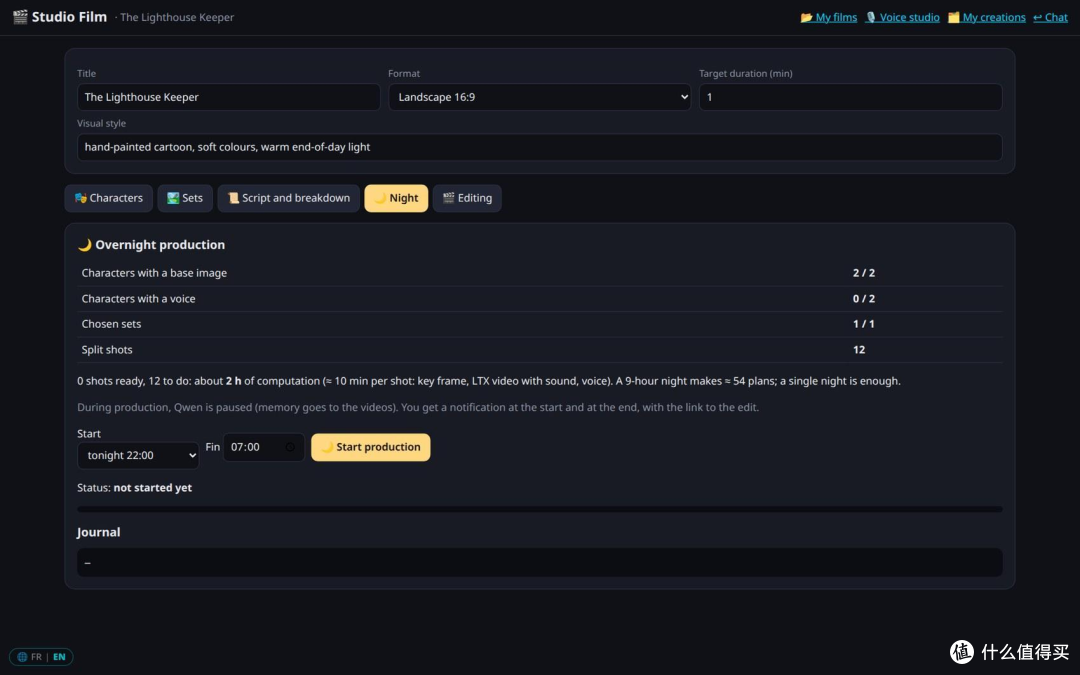
图69一“夜间”标签页:准备状态、估算(此处12个镜头,约2小时,一个晚上)和排期。
“剪辑”标签页按剧本顺序把完成的镜头组装起来,把台词下的环境音压低,生成影片;每个夜晚结束时自动完成。若要更精细的剪辑(音乐、转场、字幕),你要求Qwen 在FilmCraft 中打开它(14.2)。
一个更精简的夜晚,且不损失任何东西。自11月15日起,夜间把重型创作归组:不再为每张图像、每个视频停止并重启Qwen,工作室把它们串在同一次暂停中(最多45分钟,随后给Qwen10分钟喘息)并在之后处理配音。在一次15个镜头的模拟中,45项创作保持与之前完全相同的设置,但Qwen只重启4次而非30次。用户的条件是:质量不下降,“哪怕1%也不行”。
完成的影片不在此展示:动起来看时,它被判定为失败。上面的角色、场景和镜头表都是真实的;失败、其原因以及此后的改变在14.5中详述。
14.4 音乐与配音
ACE-Step创作带歌词的完整歌曲(20秒约需4分40秒)。Qwen3-TTS根据描述设计一种声音(“给Gaspard一位老水手”)或克隆一段3至2O秒的录音(需获得同意);Chatterbox做多语言配音。一句台词约需15秒。
Kokoro 朗读 Qwen 的回答。
声音服务只在需要时启动,闲置5分钟后停止。
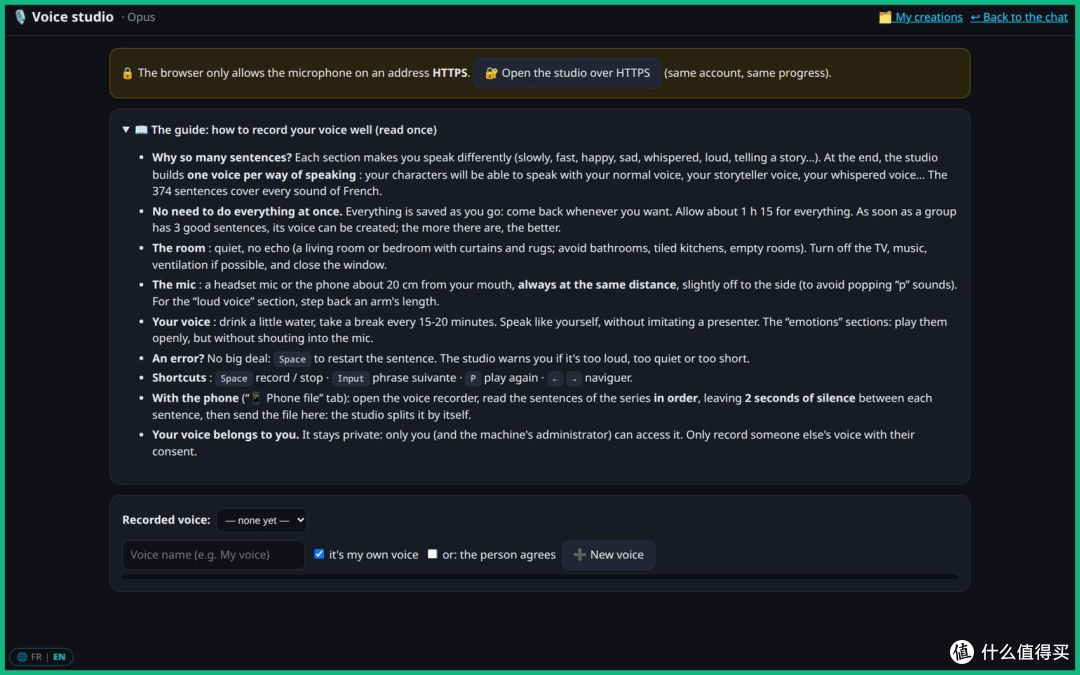
声音工作室指导录制20个分组中的374个句子(慢、快、开心、悲伤、耳语、大声、讲故事),可通过浏览器麦克风,或从手机录音机按系列以单个文件导入,自动切分。它检查爆音、音量和过短的句子,然后用用户的音色创建最多10种声音,供影片角色使用。
,“,①
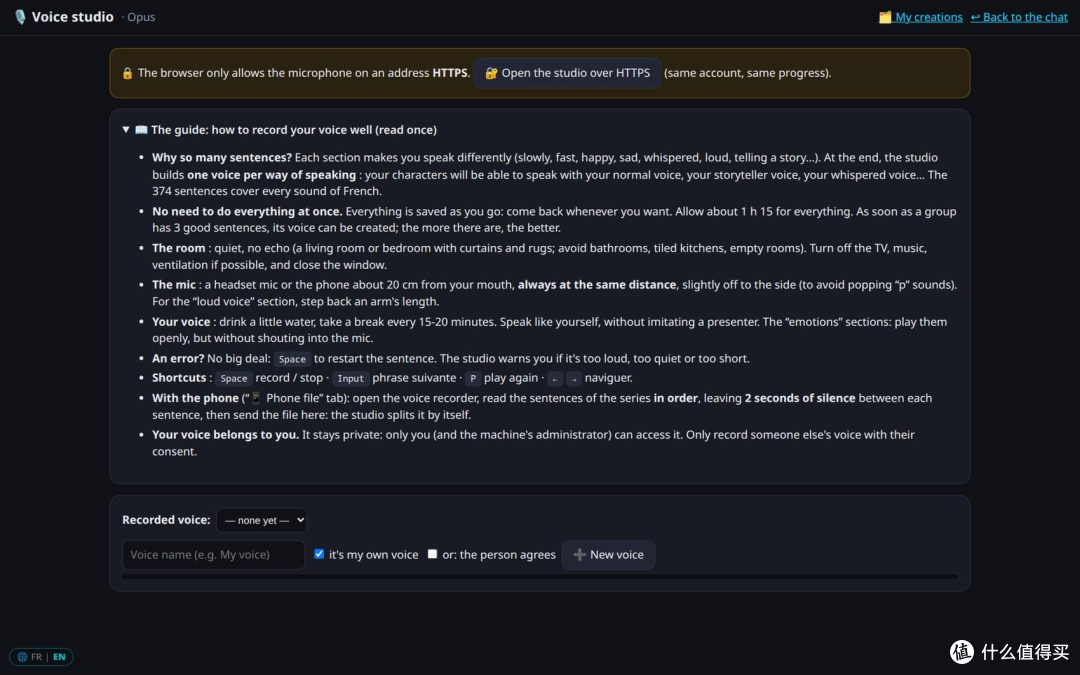
图71一声音工作室:录制指南与声音创建。
14.5 动画电影:两次失败、条件、方法
生成几秒视频很容易;制作一部让同一角色在镜头之间保持完全一致的电影,则是完全不同的问题。自本文上一版以来,这是让机器最忙碌的项目,有两次明确的失败,在此不加粉饰地呈现,用户提出的要求也改变了影片的制作方式。
第一次失败:《守塔人》(11月13日)
在11月12日至13日的夜里,电影工作室(14.3)自主制作了上面这部短片:15个镜头、60秒、2小时54分计算时间,其中两个镜头因LTX内存不足重做。在静态帧上看起来还不错;动起来看则是一场失败。用户的评价:“糟透了,太丢人了”。影片从文章和媒体文件夹中撤下,并在工作室代码中追查原因。
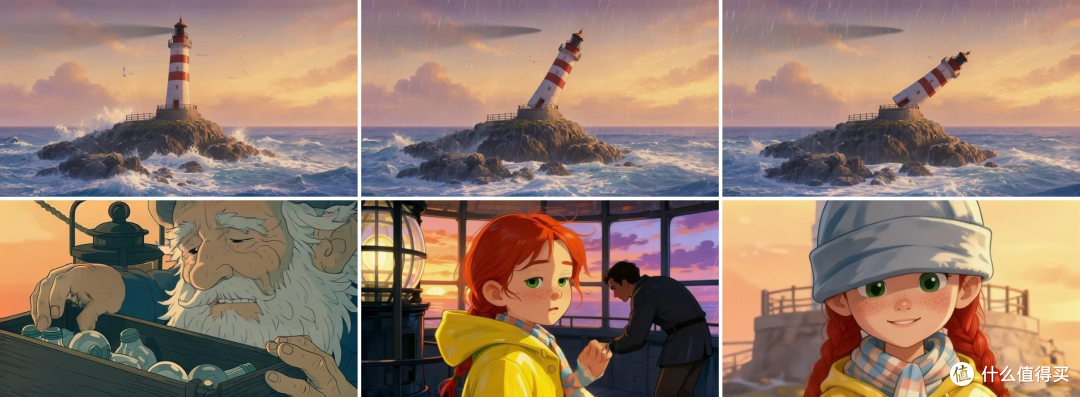
图72一逐帧观看《守塔人》。上:从第一个镜头起,灯塔就在倾斜倒塌(“镜头向上摇向灯塔”被误读)。下:Gaspard 这个白胡子的老守塔人,在下一个镜头变成了黑发男子;最后一个镜头里Lina 的眼晴被毛线帽遮住了。
找到的原因:
整部影片只用了一个场景:每张关键图像都是同一个黄昏外景的编辑版,连楼梯和灯室也是如此。一处未报告的矛盾:“暴风雨之夜”的剧本配上了“温暖黄昏光线”的风格。
镜头彼此独立:没有一张关键图像考虑上一个镜头,因此取景无法衔接。
身份丢失:带多张参考图的快速4步编辑无法保持面部;Gaspard换了脑袋。
没有检查视频:LTX-2.5把灯塔弄倒了,剪辑前没有任何环节发现。
声音生硬:每个镜头都有自己的环境音和音乐,首尾相接,因此每次转场都出现断裂。
这个教训同样适用于Claude——它也是根据静态帧评价这部影片的:视频必须动起来看,随时间逐帧查看,并且要听。
用户设定的条件
这次失败之后,用户定下了简单且不可商量的规则。影片的任何元素只有满足这些规则才会被接受:
每个镜头中角色完全一致。角色哪怕有细微变化的镜头都会被否决。模型只构建一次,通过后即锁定。
场景被严格遵守。每个镜头、每一集里同样的家具放在同样的位置;打开的礼物保持打开;时间推进,光线随之变化。
电影的语法。建立镜头、180°和30°规则、视线、节奏:每一集都必须是观看的享受。
物理上合理的互动。没有物体穿过身体或家具,手与所握之物接触,手臂伸直处不拿过大的东西:太重的东西就用推的。
角色在运动中忠实于参考,而不只是在模型表上正面好看:通过时展示一张姿态表(搬东西、走路、转头....。
画面干净:无颗粒、无闪烁材质。
主角是无词的声音:机器人发声(“Ohhh”“Ahhh”、笑声、蜂鸣),可爱且可辨识。每个阶段都需人工批准:角色、场景、道具、声音、音乐,然后是每一集。未经批准,不得推进。
不为省时间牺牲质量,“哪怕1%也不行”:优化必须给出完全相同的结果。
展示前先检查:Qwen和Claude都会在呈现前亲自检查每一张宣染图。
答案:Plateau,一个由Qwen驱动的3D工作室
为满足第一条要求,对反复出现的角色放弃了逐镜头生成视频的做法:视频模型会在每个镜头里重新发明角色。自11月13日晚起,动画电影都经过Plateau一个建立在 Blender5.2之上、作为新项目类型集成到Pilote(第15章)的真正3D电影引擎。Claude用一个晚上带一个智能体团队构建了这个工具;Qwen则负责拍电影。
用规格而非提示词:Qwen在规格文件中描述角色、场景、道具和镜头;Plateau据此一次性构建真正的3D模型,然后做动画、布光、取景、染、加声音和剪辑。
锁定的元素:一旦被用户批准,模型就被冻结并无差别复用。这道锁定被证明很严格:11月15日它拒绝替换Fedora(加了一个logo),因为已染的一集用的是旧版本,这样主角就不会在集与集之间变化。
任何宣染前的自动检查:镜头间的连贯性、180°和30°规则、取景、碰撞。
Qwen会看:预览图和检查表展示给它(视觉),只有看到最新预览后它才能完成某一步。
渣染绝不阻碍Qwen:一旦Qwen开始写作,或可用内存低于24GiB,Blender染队列就暂停。
从手机上批准:每个请求作为带检查表的通知发出;你回复“批准”或“重做”并附意见,Pilote自行插入修正步骤。
301项自动测试(外加21项网页测试)覆盖该引擎。
第一部影片:Fedora,极摩客的吉祥物,一个约4ocm高、长着猫耳的机器人,屏幕显示它的表情,出演一季关于分发礼物的1分钟短片。这个项目同时也是训练:长期目标是制作10分钟、20分钟、再到1小时30分的影片,且没有一个失败镜头。
第二次失败:Fedora的第一版动态分镜(11月14日)
11月14日,Qwen在Pilote下自主完成全部准备工作:Fedora构建并检查四次、它的房子、十二件道具、34种发声、一个音乐主题,然后是第一集《礼物清单》:11个镜头、66秒动态分镜,从剧本到分镜约3小时。每项自动检查都通过(0错误)。用户仍然否决了它:
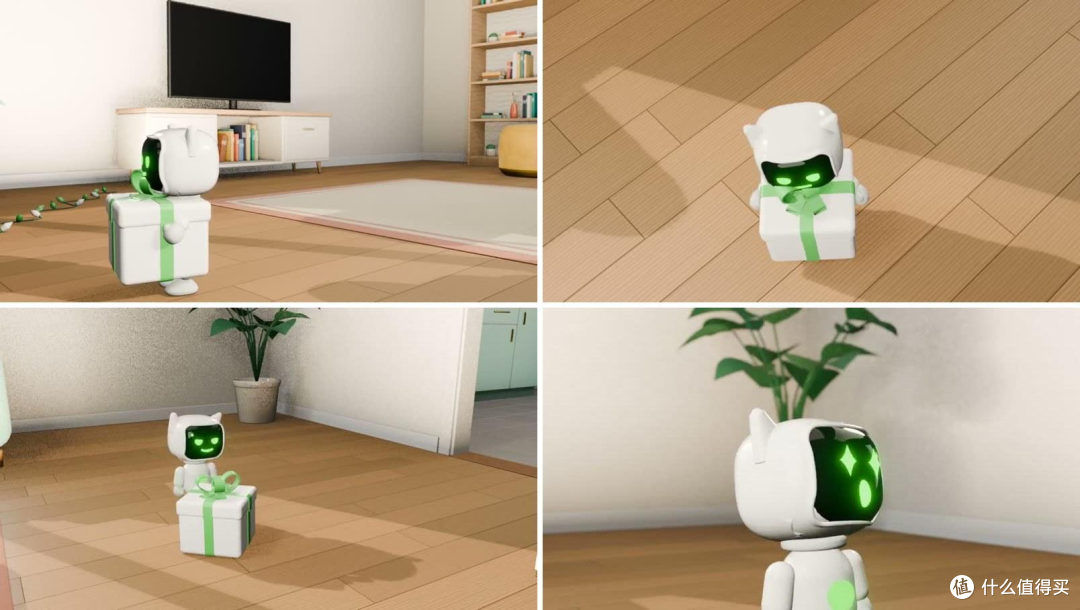
图73一被否决的动态分镜:礼物“像裙子一样”穿着、嵌进躯干,一次抓取把盒子“瞬移”,身体散成碎块(颈环、腿、耳朵),以及带颗粒的预览。
礼物“像裙子一样”拿着,穿过躯干,一次抓取把盒子“瞬移”到手里;
身体“散成碎块”:像充气项圈一样的颈环、脱落的腿、盘子状的耳朵、凸出的屏幕边框;
画面有颗粒,天鹅绒材质闪烁,茶几的腿发光,一个礼物嵌在桌上的碗里。
然而这个角色此前已经通过批准…..··但那是在一张静态模型表上。于是有了第五条要求:角色要在运动中评判。引擎连夜返工(版本2,11月15日凌晨2点左右投入使用),从三个方面:
角色:Fedora改为一体成型(头盔式头部、结实耳朵、嵌套的四肢),自动关节检查,每次批准都附一张姿态表。
互动:真实的搬拿(从上方抓握、地面上的姿态)和四项新的遮挡检查:物体在另一物体内部、物体在身体内部、角色陷进地面、物体大到搬不动。实测物理极限:Fedora搬不动大于约15cm的物体;那个18cm的大礼物改为用推的。
染:更干净的预览(16次采样而非8次),去掉假反射,重做木质材质。
今天已获批准的内容
此后,每个元素都重新交到用户面前。两天内:14次批准请求,11次通过,2次附指令退回(在Fedora肚子上加官方GMkteclogo;把礼物改成圣诞配色),1次误发取消。同时这一季转向圣诞方向:一套写进影片圣经的暖色调(深红、冷杉绿、金、奶油、木色),GMKtec的绿色标识保留在Fedora的屏幕和按钮上。
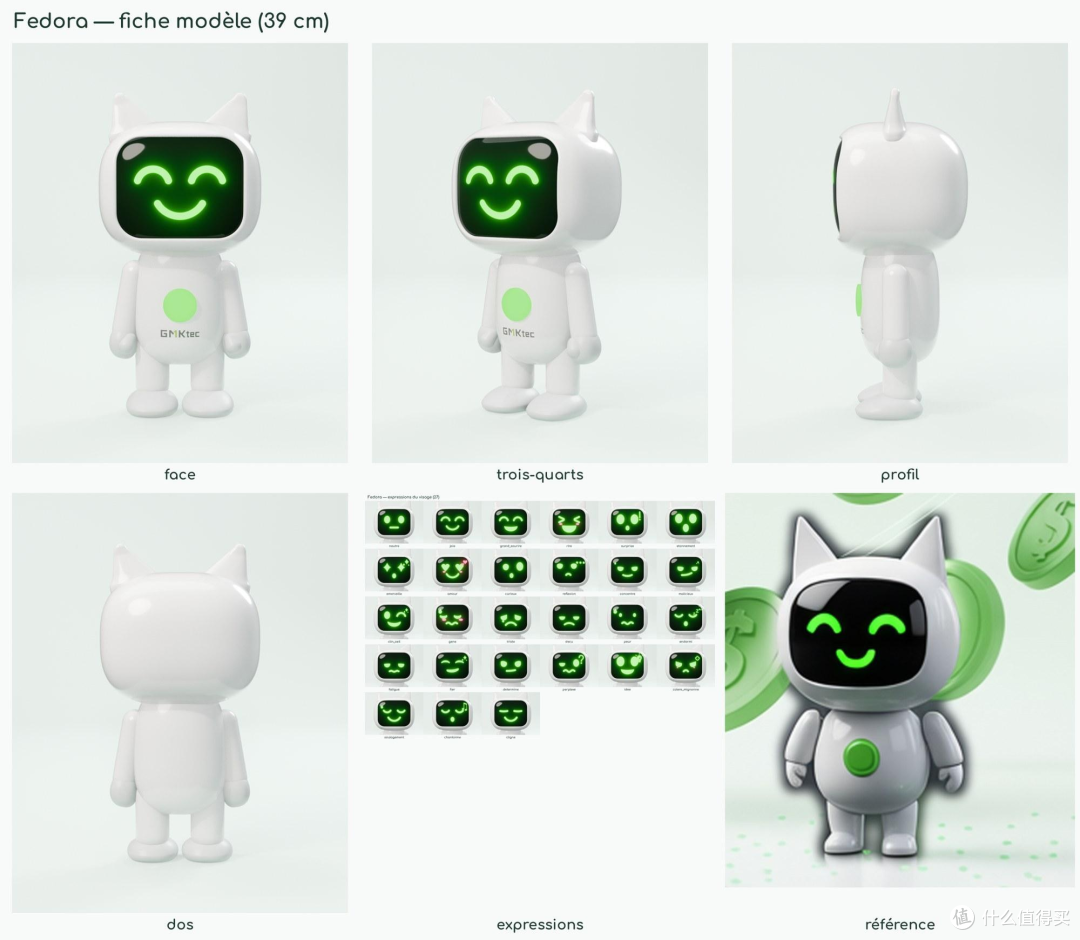
图74一获批准后锁定的Fedora(39cm):正面、四分之三侧面、侧面、背面、27种屏幕表情,以及提供的参考图用于并排比对(标签为法语)。
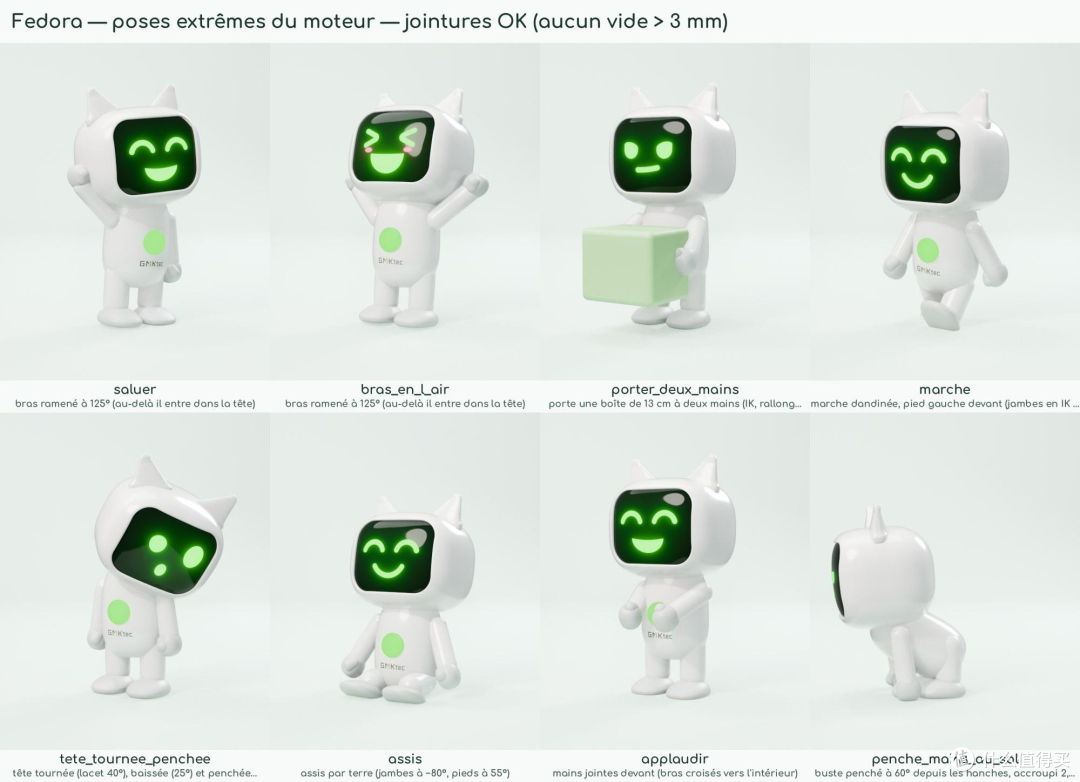
图75一第二次失败后要求的姿态表:挥手、举双臂、双手搬13cm盒子、走路、转头、坐姿、拍手、俯身。关节检查验证没有任何缝隙超过3mm(标签为法语)。
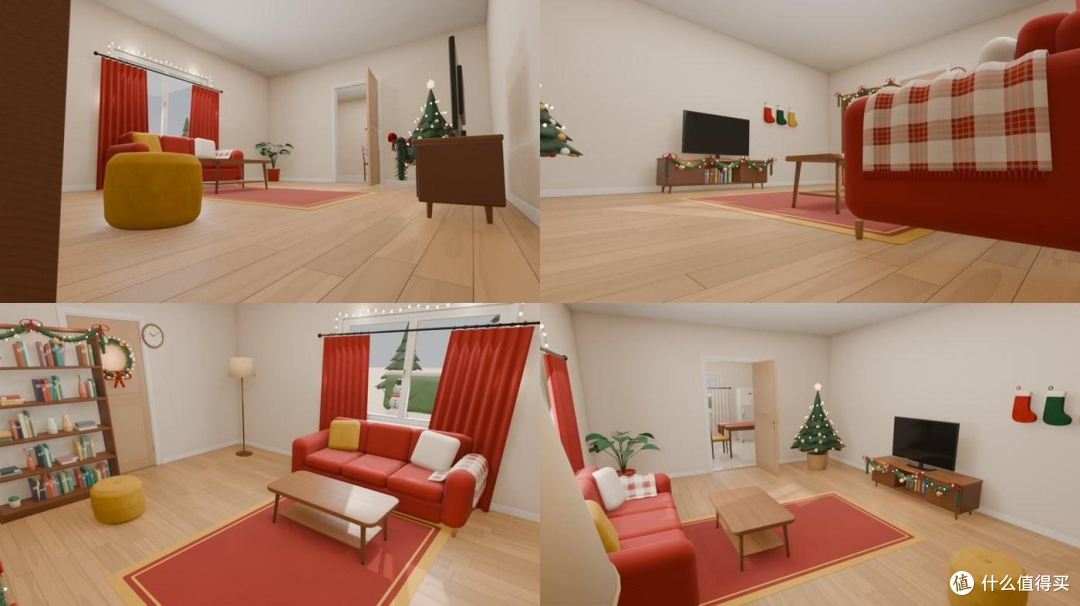
图76一为圣诞装饰的Fedora之家,以机器人视角观看:墙和家具与之前同位置,只有装饰变了(点亮的树、花环、长袜、红色窗帘和织物、外面的雪)。
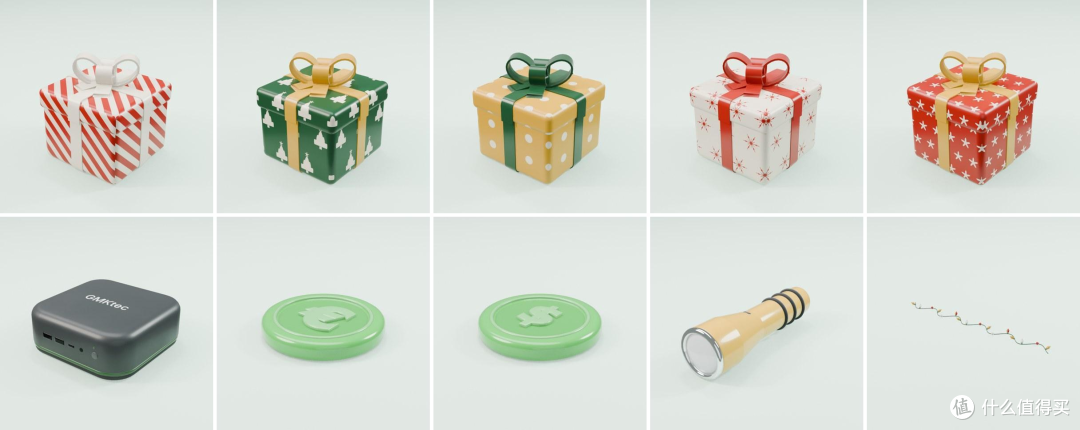
图77一15件已批准道具中的一部分:五个圣诞礼物(右边那个大的用推的)、GMKtec迷你主机、欧元和美元硬币、手电筒和花环。
Fedora的声音(34种发声,无词语)和圣诞主题曲(雪撬铃、钢片琴、钟琴、拔弦,每分钟104拍)已通过听觉批准。求每个互动在物理上都必须可行。本文不展示任何完成的剧集:只有在逐帧观看并由用户批准后才会展示。15.Pilote:长周期项目自主运行
饱和,即便有自动摘要,质量也会下降。Pilote用不同的方式解决这个问题:项自的每一步都从一个全新的上下文开始,只保留目标、计划和上一步留下的交接便签。这样一个项目可以有数百甚至数千步,而Qwen不会失去头绪。
15.1 从头到尾看懂Pilote
本节围绕“A.创建项目”展开说明。
A.创建项目
在聊天中,通过Pilote工具:描述项目并选择其规模。
或通过转换:当一段对话变成真正的项目(很多动作、创建了文件)时,会弹出一个窗口询问“在此项目上启用Pilote?”。Qwen随后根据对话写出目标,复制工作文件夹并打开一个跟踪对话。Qwen也可以自行决定启用。
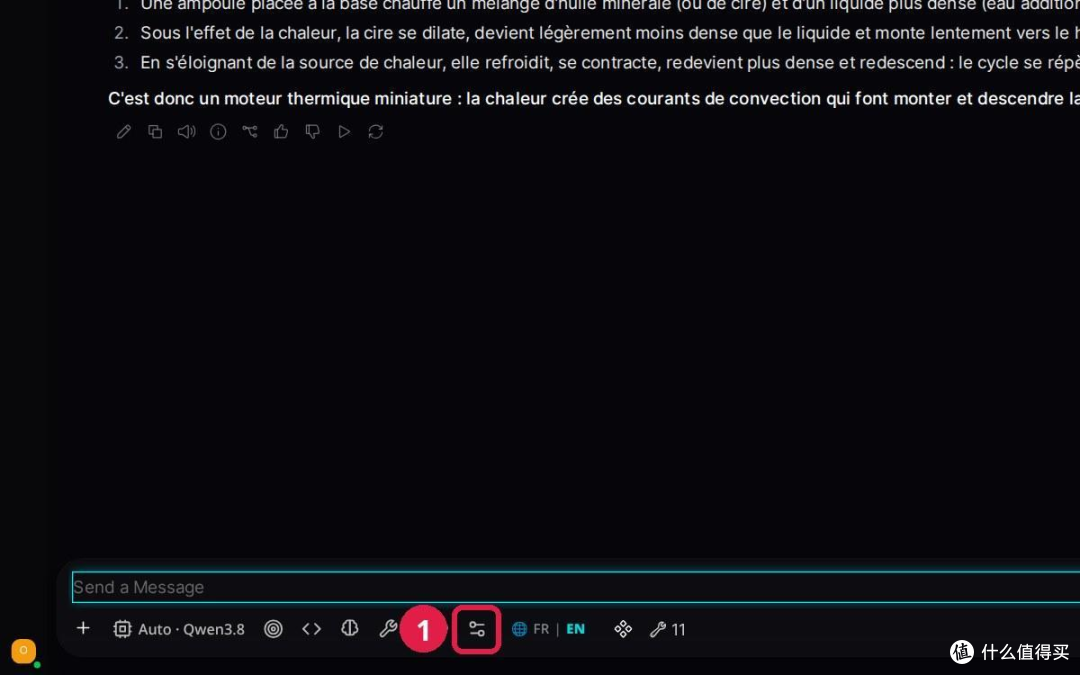
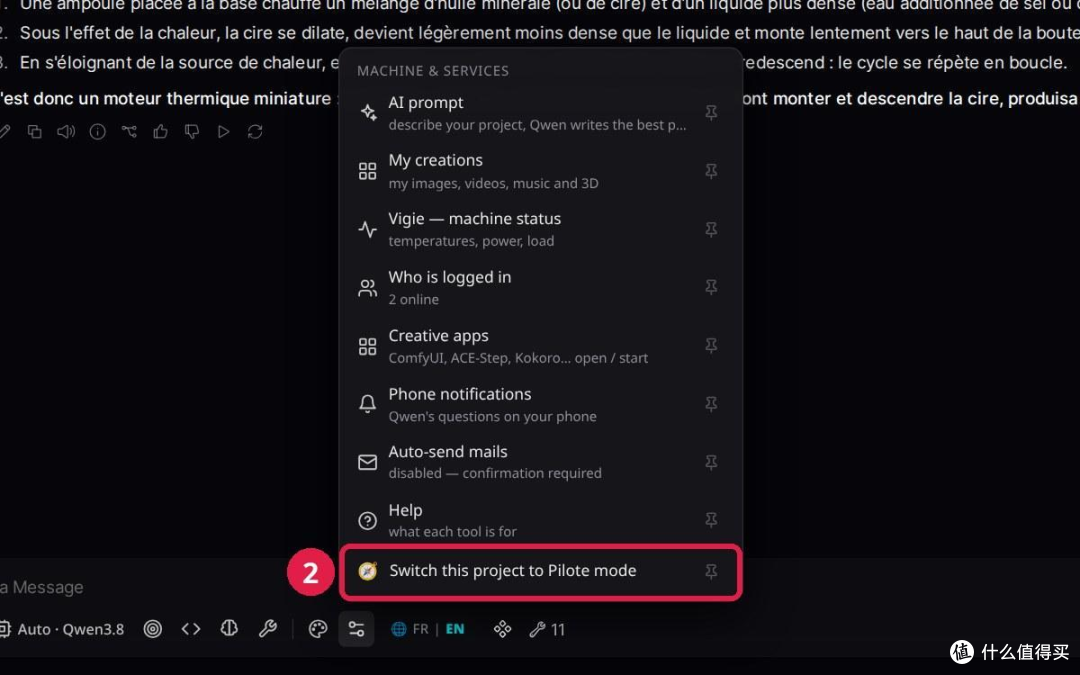
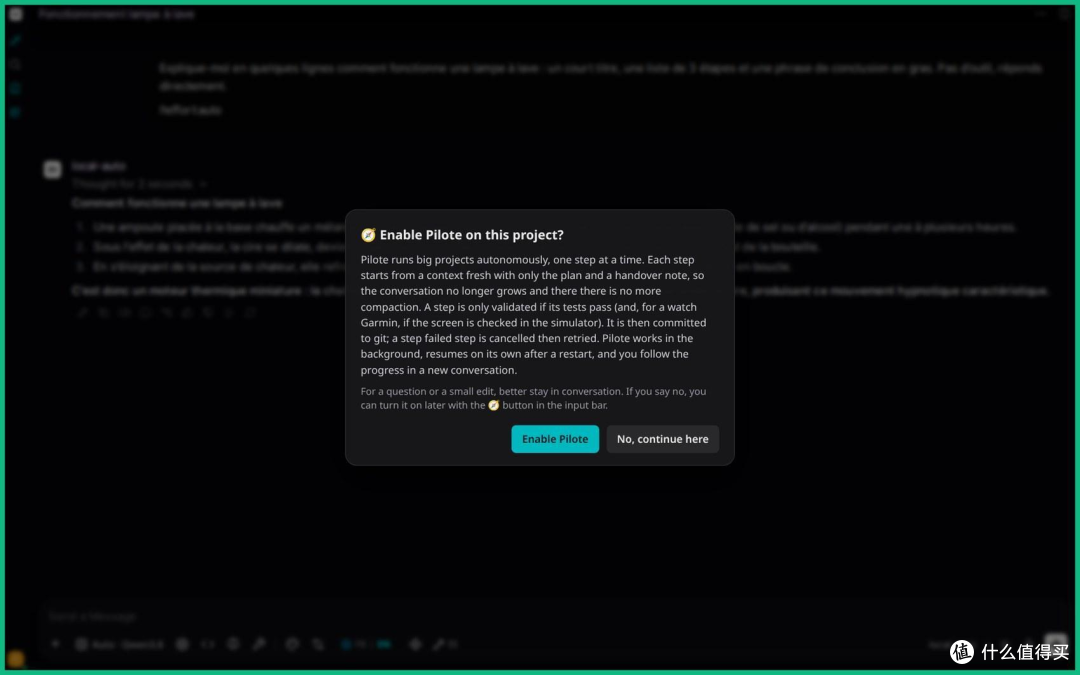
图78一访问路径:①输入栏中的按钮(或自动弹出的窗口)。
B.选择规模
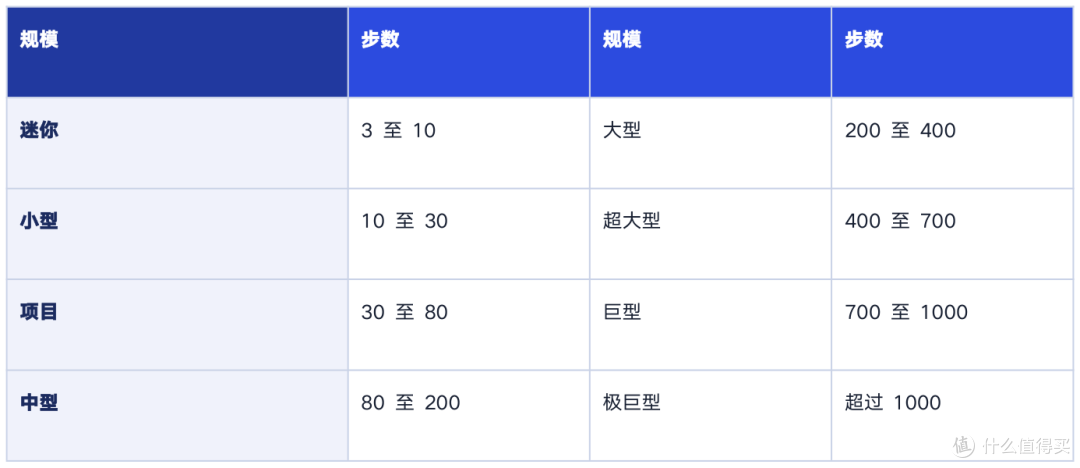
在自动模式下,Qwen自行估算规模,必要时借助网页搜索。C. 计划
Qwen写一份由可验证步骤组成的计划,每步都带成功标准(“EO21一最短路径:标准:无法穿越障碍,3项测试”)。对于大型项目,所有部分都会写出来,但只有第一部分是详细的;后续部分到执行时才细化。
D. 一个步骤
全新上下文:目标+计划+交接+本步任务。
Qwen只读取所需内容,在项目文件夹内写代码、运行、测试。
只有当测试真正通过时它才能下结论(对于手表或手机,还要屏幕已检查)。
该步骤提交到git,Qwen重写交接便签,带一节“下一步,操作指南”:要改的文件、代码模板、针对性测试、坑。
E.卡住时
级别升级:每遇一次困难,推理强度上调一级,随后调用DeepSeek-R1作为增援。
失败的尝试:代码回滚但保留为补丁;如果方向正确,下一次尝试可以重新应用它。
第二次失败:该步骤自动拆分为2至4个子步骤。
第三次失败:该步骤标记为受阻,项目继续推进。
F.跟踪与介入
每10分钟在跟踪对话中发一次进度报告,附截图,每一步都发手机通知。
范围壁垒:每个被修改的文件都必须有理由;未被要求的内容只报告、绝不修改。读取守卫:若Qwen读取其项目之外的文件则告警。
持久性:原子写入、每步前检查仓库、定期备份、断电后自动恢复。
15.2 新旧两代Pilote
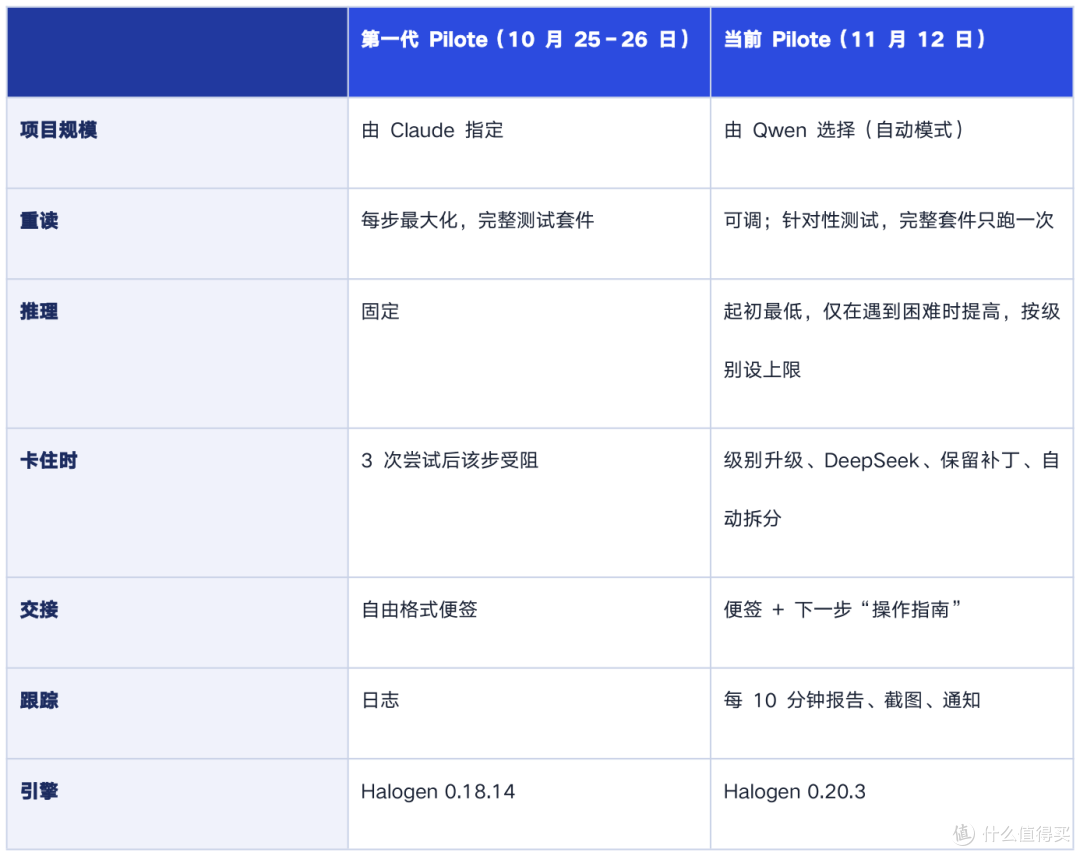
“16 小时20 分”计算器:一次教训,而非极限
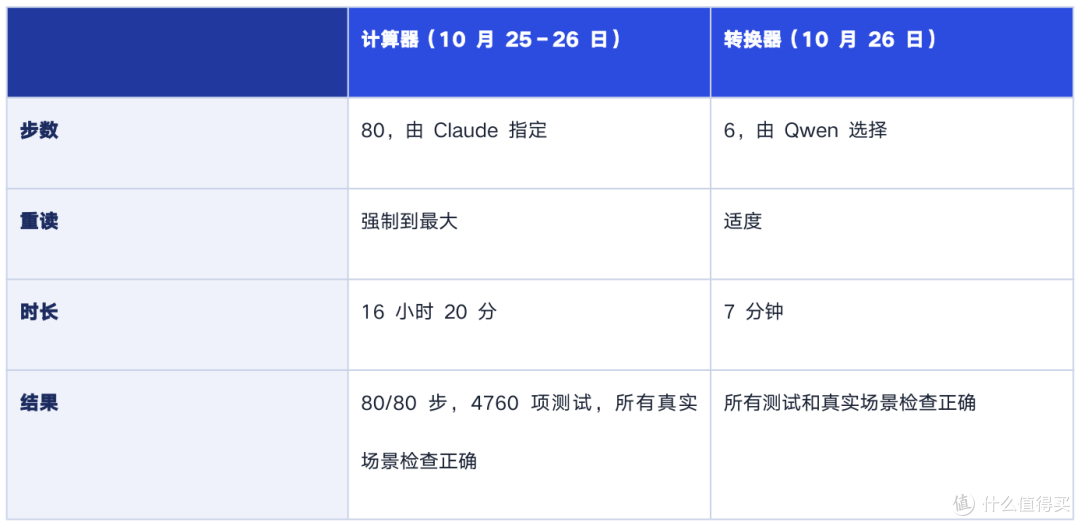
15.3第一个 Pilote 项目是一个命令行计算器,80 步用了16小时20 分。远看上去,“16 小时做个计算器”显得荒谬。个中缘由值得了解。
Claude本身也促成了这种缓慢。为测试Pilote,它刻意强加了一份8o步计划,每一步都要重读和系统测试。结果:Qwen为3700行代码写了28000行测试,有时还不停打磨一个已经成功的步骤,直到用完轮次。Claude途中还修改了Pilote,而且项目跑在Halogen0.18.14版本上。
第二天,一个同等工作量的项目(命令行转换器)交给Pilote并让Qwen自己决定步数:它在24秒内选择了“迷你”规模,写了一份6步计划,并在7分钟内交付了一个可用、经过测试的应用,包括断电测试。
此后,Pilote得到深度改进(见上表),此后在同一步骤上的测量显示:一步耗时减半(除以2.3),另一步最多除以7.4,靠的是方法而非原始速度(15.5和15.6节)。
15.4 大工程:为网页版重制DofusTouch
正在进行中最雄心勃勃的项目是用户的信任测试:以网页形式重制游戏《DofusTouch》,先做一个以盗贼职业(法语“Roublard”)为核心的可玩战术战斗模拟器。Qwen几乎从零开始:一份旧的HTML+jQuery“视线模拟器”(锦标赛和Kolizeum地图、等轴测网格、视线计算)以及盗贼的游戏数据(法术、动画、精灵图)。绝对规则:它不读取项目之外的任何内容,也不到别处寻找现成代码。
项目于11月11日02:43以“项目”规模启动,于11月12日19:48完成,68步全部验证通过(其中数步是途中用户要求的),约4.8万行JavaScript(含测试)、744项通过的测试和77次git 提交:从参考资料中提取48张地图并显示在等轴测网格上,视线计算原样移植并在每一对格子间测试;
角色放置、AP和MP(默认6/3)、四方向最短路径、可达格预览、动画移动;
全部30个盗贼法术及其消耗、射程、是否需要视线、直线施放、冷却,逐一测试;
炸弹玩法:水炸弹、爆炸炸弹、龙卷炸弹、连击层级、引爆、成排炸弹之间的墙及其伤害、炸弹处理(踢、磁力、计谋、诡计)、Kaboom状态;
推、拉、传送交换、重力、召唤(胡萝卜、盗贼机器人及其3个法术);
一个真正的游戏界面(带图标的法术栏、仪表、回合时间线)、一个敌方AI、完整的回合结束以及胜负画面。
当某条游戏规则在数据里含糊不清时,Qwen不会悄悄编造:它写进一个“待确认规则”文件由用户决定。DofuS玩家会认出盗贼、它的炸弹和墙。
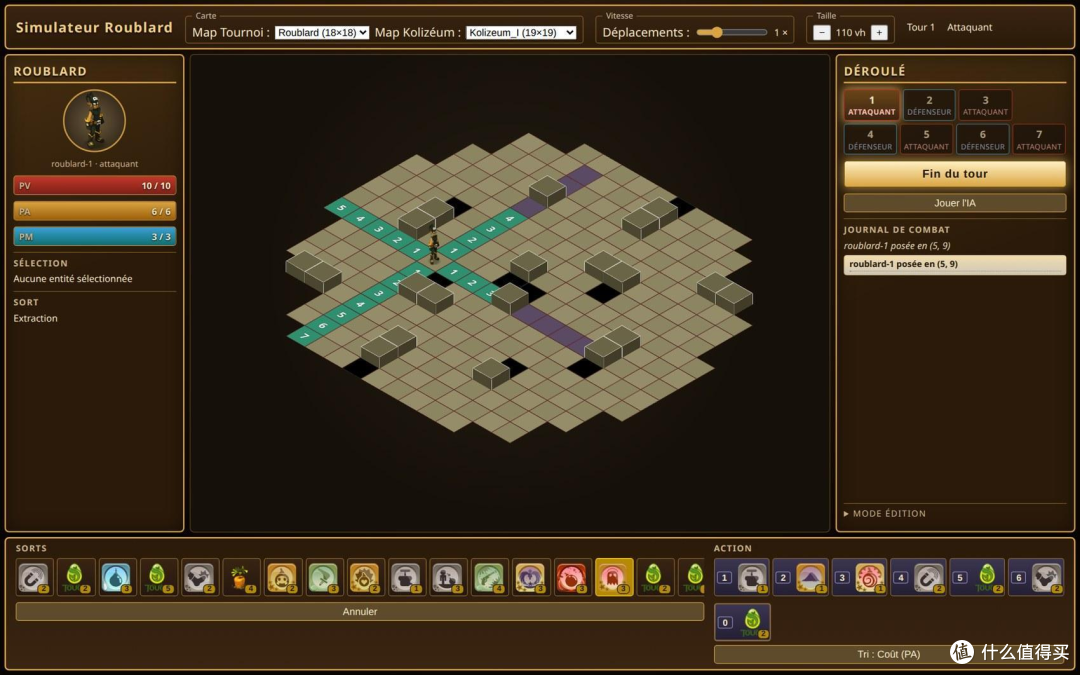
图79一Qwen通过Pilote重制的战斗模拟器:等轴测地图、盗贼、炸弹和法术栏。
15.5 工作速度:同一项目上的三次测量
《DofusTouch》模拟器被用作Pilote本身的测试台。为公平测量,从相同的起点(仓库的一份副本)重做完全相同的步骤,只改变工作方式。Qwen每次都从空白上下文开始:它不记得上一次尝试。
E054、E106、E107、E108是什么意思?它们是Pilote为《DofusTouch》模拟器制定的计划中的步骤编号(“E”代表étape,法语“步骤”;计划共68步,编号从E001到E106)。E054:显示胜负和游戏结束画面。E106:用户要求的一处修复;在游戏中,放置在格子上的任何东西(角色、召唤物、炸弹)都必须遮挡视线。它涉及15个文件:7个代码文件、6个测试文件和2个文档。E107和E108只存在于项目的一份一次性副本中,专为15.7节的测试而加:E107让Qwen写4个全新、独立的测试文件(推、墙、引爆、传送交换;各8项测试),E108让它把6份项目文档(333KB)完整翻译成英文。
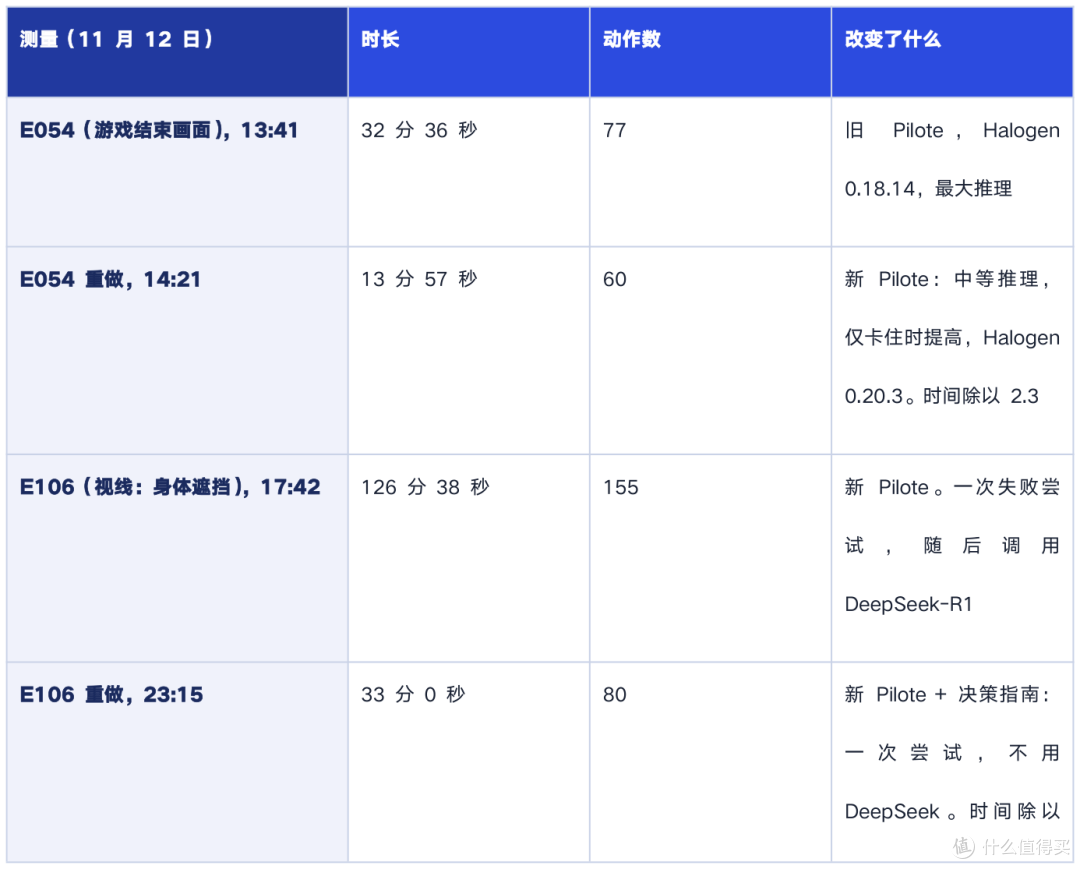
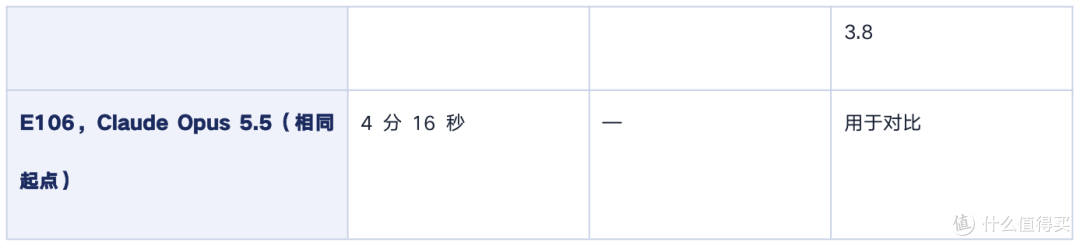
11月12日晚加入的决策指南源自一个观察:在E106上,Qwen在第一次写入之前做了约45次读取(搜索、重读测试),然后随机尝试。现在Pilote会总结每一项失败的测试(文件、行、预期、实际),让Qwen直接定位出错行;它会放慢节奏,并拒绝长时间只读取不写入,同时强制执行一种方法:最小改动、完整测试套件只跑一次、每次失败写一条原因。
几点补充说明,以免夸大:
这不是模型的原始速度:Qwen每秒写入的token数基本没变(0.20.3仅+3%)。收益来自工作方式:更少的无用动作、更少的失败尝试。
两项收益不能相乘。×2.3和×3.8是在两个不同步骤上测得的;声称“×9”是假的。
每个案例只测一次,且有波动:同一晚用较早版本的指南首次重跑E106,第一次尝试失败,总共花了64分钟。这已经是原始成绩的两倍好,但仍比23:15的测量慢一倍。
与Claude的差距仍然很大:在E106上,23:15重跑后Claude比Qwen快约7.7倍,而下午约为30倍(最后一个晚上之后约4倍,见15.6节)。
模拟器本身90%是用旧Pilote构建的:68步中有61步在11月12日14:21切换之前完成,最后7步用新版本。因此该项目的总时长尚未反映这些收益。
实际上,如果这些收益能在其他项目上保持,同样的工作耗时应比模拟器初期少两到四倍;最后一个训练之夜在E106上表现得更好(15.6节)。这是一个有待随时间检验的估计,而非实测。
15.6 最后一个训练之夜:每次重跑加一项更新
在 11月12日至 13日的夜里,就在发布之前,Claude让 Qwen在项目的一份一次性副本上连续重做E106七次,每次都从相同起点开始,并从历史中抹去之前的解法。两次重跑之间,只给Pilote增加一个新功能,以弄清每一项真正带来的收益。Qwen每次开始时都不记得之前的尝试。
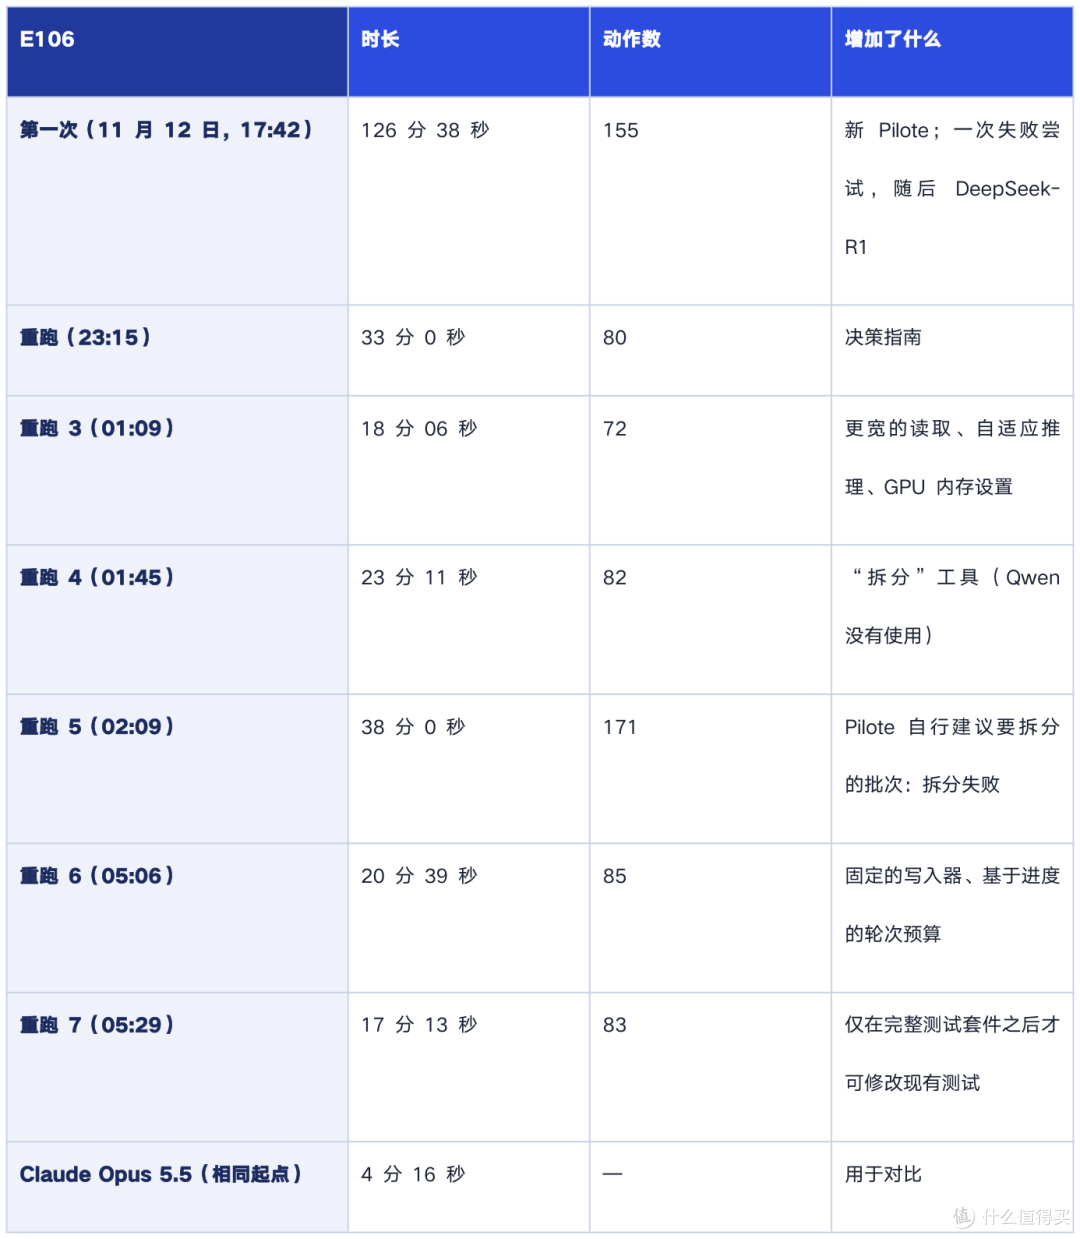
七次重跑全部通过验证:每次所有测试都通过(根据Qwen选择添加的测试不同,为742至748项),且无法访问原项目。自23:15那次干净重跑以来,除重跑5外没有任何尝试失败,也没有一次调用DeepSeek。
每项更新带来的收益:
更宽的读取。Pilote过去把每次文件读取截断在12000字符,甚至去掉大文件的中间部分,迫使Qwen重新读取。现在上限为40000字符,按整行截断并标出续读位置。一项测试说明了为何划算:在这台机器上,读取的成本比写入低约28倍(1750token/s对63)。拖慢Qwen的是轮次数量,而不是读取。
GPU内存设置。图形芯片没有自己的内存:它共享系统的124GB。LinuX在后台重组这些内存并迁移GPU 使用的页,导致 Halogen 冻结。一项可逆的系统设置关闭了这种主动重组:在23:15 的重跑中GPU被冻结4.6分钟,重跑 3中为6秒,重跑6中为0秒。
自适应推理。在一个成功的轮次之后(读取文件、改动被接受、测试通过),Qwen的推理降低一级;失败
分钟,速度从 50 提升到69 token/s。
基于进度的轮次预算。每次尝试固定80轮的上限让重跑5在Qwen仍在取得进展时失败。现在,只要它在最近10轮里写入了内容或通过了一项测试,就再给10轮,最多160轮。重跑6和7用到了这种延长。
成对写入,即“拆分”工具。在一个写两个测试文件的测试中,两个Qwen并行用了3.8分钟,而一个用5.9分钟(×1.57);三个则没有进一步收益。一项改动的核心完成后,Qwen可以把两批文件交给两个写入器,每个只能在自己的文件里写。当失败集中在三个或更多文件时,Pilote会自行提出均衡的批次。重跑5失败后,写入器会收到决策指南和主Qwen已做的改动,若轮次用完则交回它们的发现。
现有测试只在套件之后动。在重跑6中,Qwen猜测哪些测试会失败,甚至在跑套件之前就改了它们。现在,在代码改动后重新运行套件之前,Pilote拒绝任何对现有测试的修改。这也更安全:通过的测试不再“以防万一”地被改动。在重跑 7中,这种拒绝触发了一次,Qwen 照办了。
还是要说几点保留:
17分13秒是最好的一次测量,不是平均值。排除重跑5,各次重跑在17至23分钟之间:Qwen现在做这项修复比第一次快5.5至7.4倍。在完全相同的系统上,同一次重跑不同运行之间约有25%的波动。
在代码上,成对写入并不省时间。在重跑4中,Qwen忽略了该工具;在重跑5中,两个写入器之一什么也没写,该步花了38分钟;在重跑6和7中,它没有被使用,这是对的:在E106上,可拆分的部分只相当于三分钟的小改动。下面专为它设计的 E107测试表明它会拖慢Qwen。
这一夜的教训:Qwen常常忽略一条写下的指令。真正改变其行为的是Pilote强制执行的东西:失败摘要、拒绝只读连续操作、轮次延长、拒绝过早改动测试。
只测量了一个步骤。这些收益仍需在其他项目上确认。在E106上Claude仍快约4倍(4分16秒),而11月12日下午为30倍。
最终测试:E107写入测试
为了了结成对写入的问题,11月13日上午特意写了一个步骤E107,且处于最有利的情形:四个全新、独立的测试文件(推、墙、引爆、传送交换),各8项测试,即要从零写32项测试。三次运行,从相同起点开始:
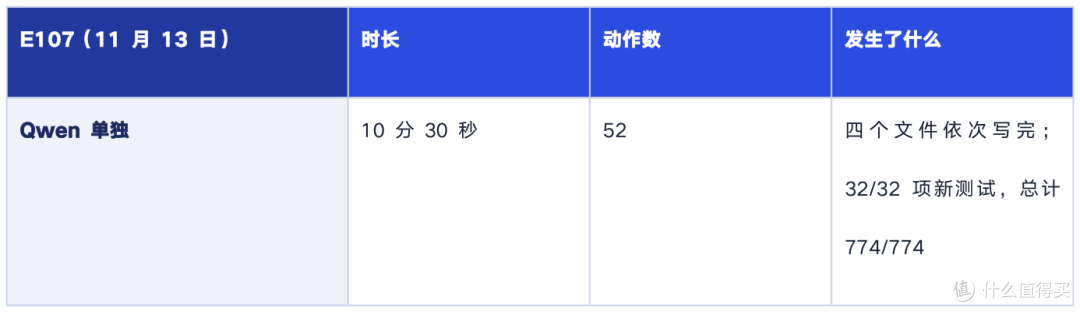
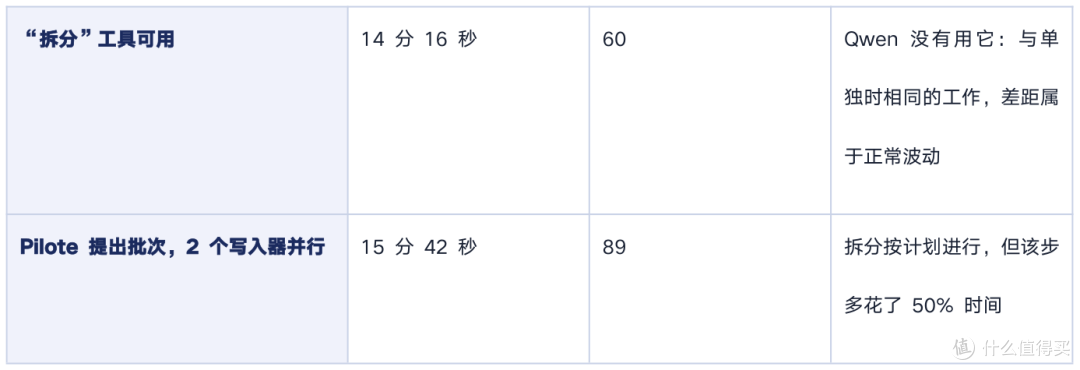
三种情形下质量完全相同:32项新测试和整个套件都通过,没有触碰范围外的文件,没有失败尝试,没有DeepSeek,也没有 GPU 冻结。只有时长变了,而 Qwen 单独做最快。
为什么两个Qwen比一个慢:
写入器都从零开始:每个都要重新阅读模块和测试风格,在写下第一行之前约花4分钟,而Qwen单独时只需1分50 秒。
Qwen单独做能受益于刚学到的东西:每个文件2.2分钟,而写入器要5.4分钟,且为同样的结果多写65% 的 token。
引擎收益在实践中比测试中更小:两人并行时,Halogen的写入只快1.24倍(每个写入器47token/s,而单独时76),不是1.6倍。
即便没有这些损失,收益上限也只有约15%,小于两次相同运行之间正常的25%波动:没有任何调优能让它被可靠地测出来。
对代码的结论:Qwen不再自行拆分工作:由Pilote决定,且只针对翻译或转换,后一项测试给出了相反的结果(15.7节)。这一夜真正的收益来自方法:决策指南、更宽的读取、自适应推理、按进度授予轮次以及GPU内存设置。E106从2小时06分降到17分13秒。
15.7 多智能体:多个Qwen协同同一任务
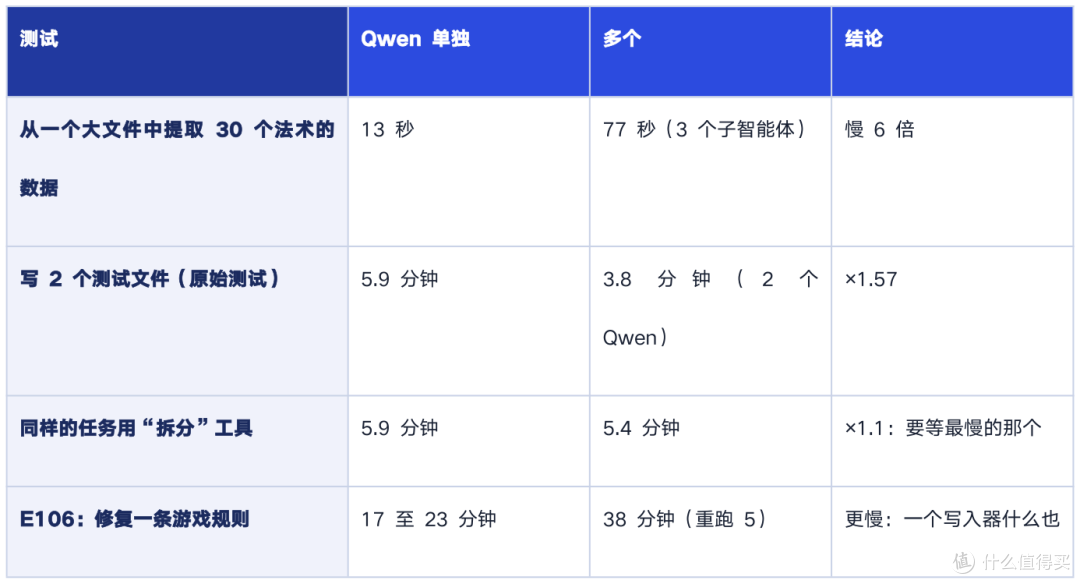
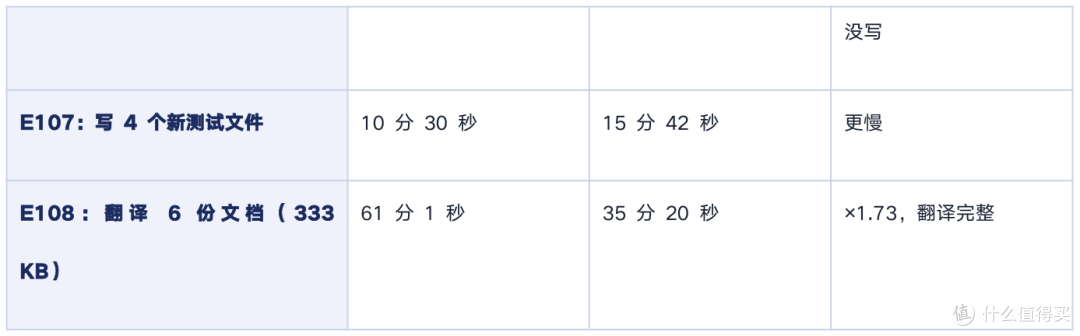
让多个Qwen同时工作似乎是一条明显的加速之道。在这台机器上,只在特定情形下成立。11月12日和13日运行的六项测试说明了是哪些(步骤E106、E107和E108见15.5节的框注)。
引擎允许什么。Halogen最多可同时服务四个请求,但它并非同等加速所有请求:
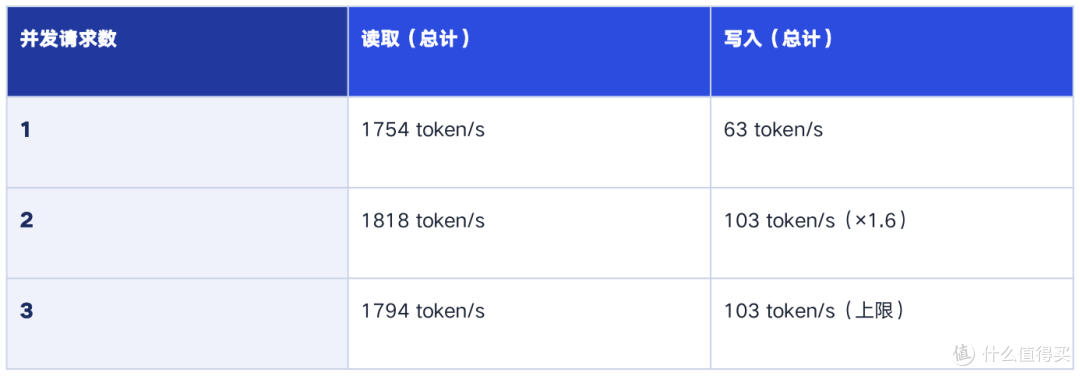
读取不享受并行收益:Halogen逐个读取请求。只有写入受益,且仅限两个Qwen。由于读取成本比写入低约28倍,拖慢Qwen的是轮次数量和写入量,而不是读取。
测试结果:
优势:
大量独立的写入工作。当每个写入器只需要自己的文件(翻译、转换)时,它几乎立即开始,成对写入快1.6 倍。
更轻的工作记忆。在E108上,Qwen单独做时一份比一份慢:记忆被读过和重写的六篇文本填满。每个写入器只承担一半,这正是大部分收益的来源。
质量保持。标题和表格行100%一致,内容完整,没有失败尝试,没有调用DeepSeek。
范围安全。每个写入器只能在自己批次的文件中写入;Pilote 拒绝其他一切。
劣势:
启动成本。每个写入器都从零开始:在代码上,它需要约4分钟理解项目才能写下第一行,而Qwen单独只需 1分 50 秒。
没有共享学习。Qwen单独做时,会把第一个文件上理解到的东西复用到后续文件(每个文件2.2分钟,而写入器要5.4分钟),且写入器为同样结果多产出65%的token。
引擎收益比测试中更小。在真实条件下,两个Qwen写入只比一个快1.24倍,三个并不更快。
你总得等最慢的那个。批次分配不均或一个写入器笨手笨脚都会抵消收益:在E106的重跑5中,两者之一什么也没写,该步花了38分钟。
要留意格式差距。在E108上,行数最多减少6%(段落合并,英语更短,内容无损失),并在最后检查期间于指令之外创建了一个测试文件,现已修复。
Qwen自己决策不佳。工具摆在面前时,它要么不用,要么用错了时机。
采用的规则。Qwen不再拥有拆分工作的工具:只由Pilote在某一步开始时决定,且必须满足三个条件。任务必须是翻译或转换,至少有两个现成源文件要转成新文件,且预计写入时间至少10分钟。随后两个写入器在均衡的批次上同时写,之后由Qwen 检查并收尾。对于修复bug 或演进相互关联的代码——这是Pilote的大部分工作——它从不拆分。
一个保留:每项测试只测了一次,同样的任务不同运行之间约波动25%。翻译的×1.73是可靠的,因为它远超这个余量;表中的小差距则不足以得出结论。
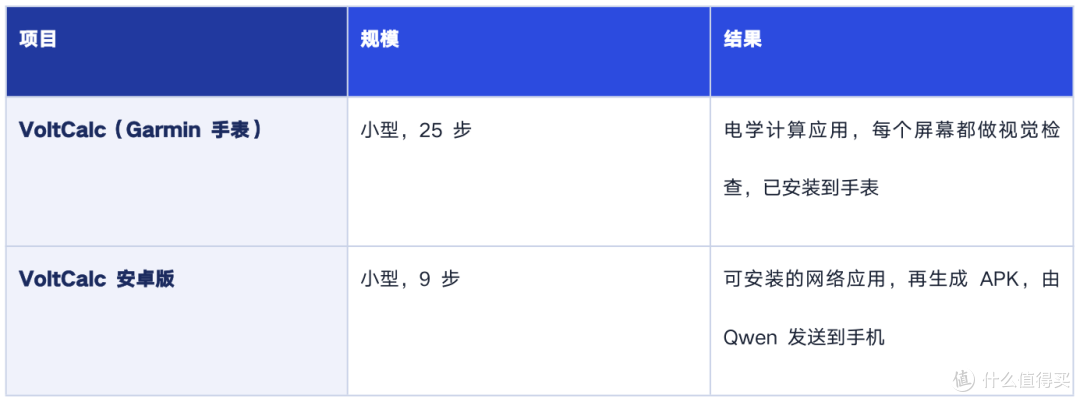
15.8 其他已完成的项目
16.日夜训练Qwen
Qwen
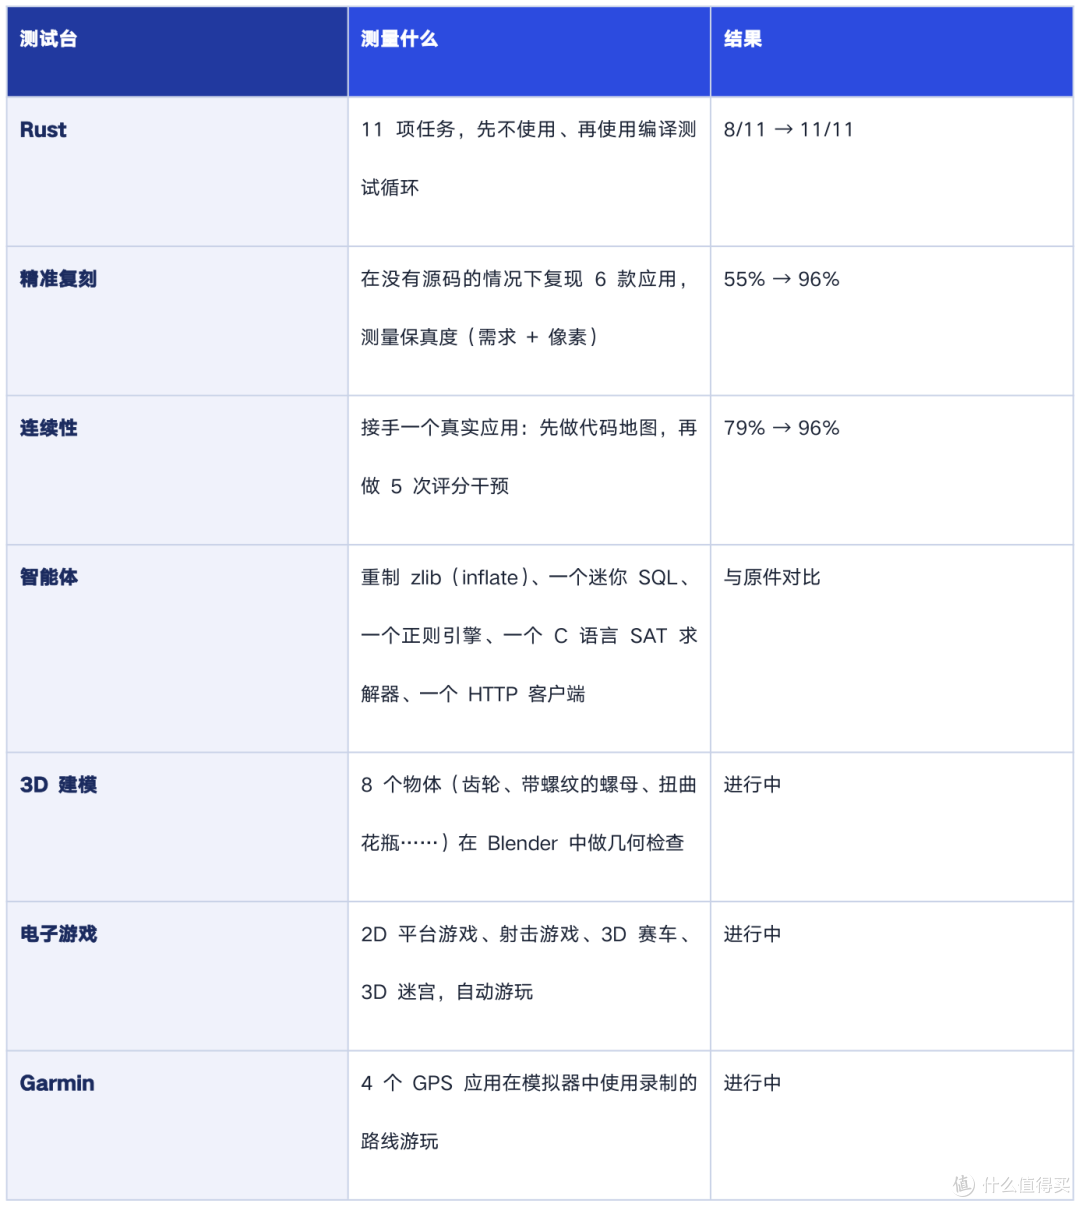
Qwen模型本身从不重新训练。得到改进的是它周围的一切:写下来的方法、经验笔记、工具和安全护栏。为衡量这种进步,Claude构建了由隐藏测试评分的测试台:Qwen永远看不到预期答案。
16.1 教练:Claude Opus5.5
训练由Claude Opus 5.5(claude-opus-5-5)设计并跟踪,这是 Anthropic 的顶级旗舰模型,通过Claude Code在终端中使用。它从不代替Qwen工作:它设计测试台和评分器(使用前先用参考解验证),编写方法,补充缺失的工具,分析每一次失败以找到真正原因,并持续关注一份事件日志(服务停止、步骤失败、调用DeepSeek、项目完成),定期在手机上报告。
一个找到真因的例子:Qwen 似乎“产生幻觉”,把错误的工具调用了5o次。真正的问题是Open WebUI把想要的工具藏在了工具搜索之后;一旦该工具始终加载,问题就消失了。若归于模型就错了。
16.2 组织方式
一个调度器在工作日早7点至下午4点依次运行测试台。一旦用户使用Qwen,它就冻结训练,并在安静10分钟后恢复。
夜晚留给Pilote项目和影片制作,每小时发一次通知报告。
每次运行都计时;当Qwen修复了一个真实bug 时,Claude会在一份一次性副本中并行做同样的修复以比较时长。
一个登记表保存所有结果,以便未来的模型可以做完全相同的测试并被公平比较。
16.3 高强度练习:覆盖60多种语言
这些练习不是“Hello World”。在每种语言中,多语言测试台都要求写一个完整的程序,读取最大到1012的整数,计算总和、最大值、排序后的去重值和素数个数,用5个隐藏的刁钻输入评分(不规则空白、超大数字)。专门语言有自己的测试:用Verilog 或VHDL 写一个电路,用Coq 或Agda 写一个证明(任用。“困难”测试台增加96道算法题(最小生成树、行列式、数独、生命游戏、约瑟夫环、表达式求值.。
工作室的 61 种语言:Ada、Agda、AIgol 68、AWK、Bash、BASIC、bc、C、C++、C#、Chicken Scheme、COBOL、CoffeeScript、Common Lisp、Coq、D、Emacs Lisp、Elixir、Erlang、Fortran、GAP、Go、Groovy、Haskell、Haxe、Java、JavaScript、Julia、Kotlin、Lua、LuaJIT、Maxima、Modula-2、Monkey C、NASM(x86-64 汇编)、Objective-C、OCaml、Octave、PARI/GP、Pascal、Perl、PHP、Pike、Prolog、Python、PyPy、R、Racket、Raku、Ruby、Rust、Scala、Scheme、SQL、Tcl、TypeScript、Vala、Verilog、VHDL、WebAssembly(WAT)和 Zig。
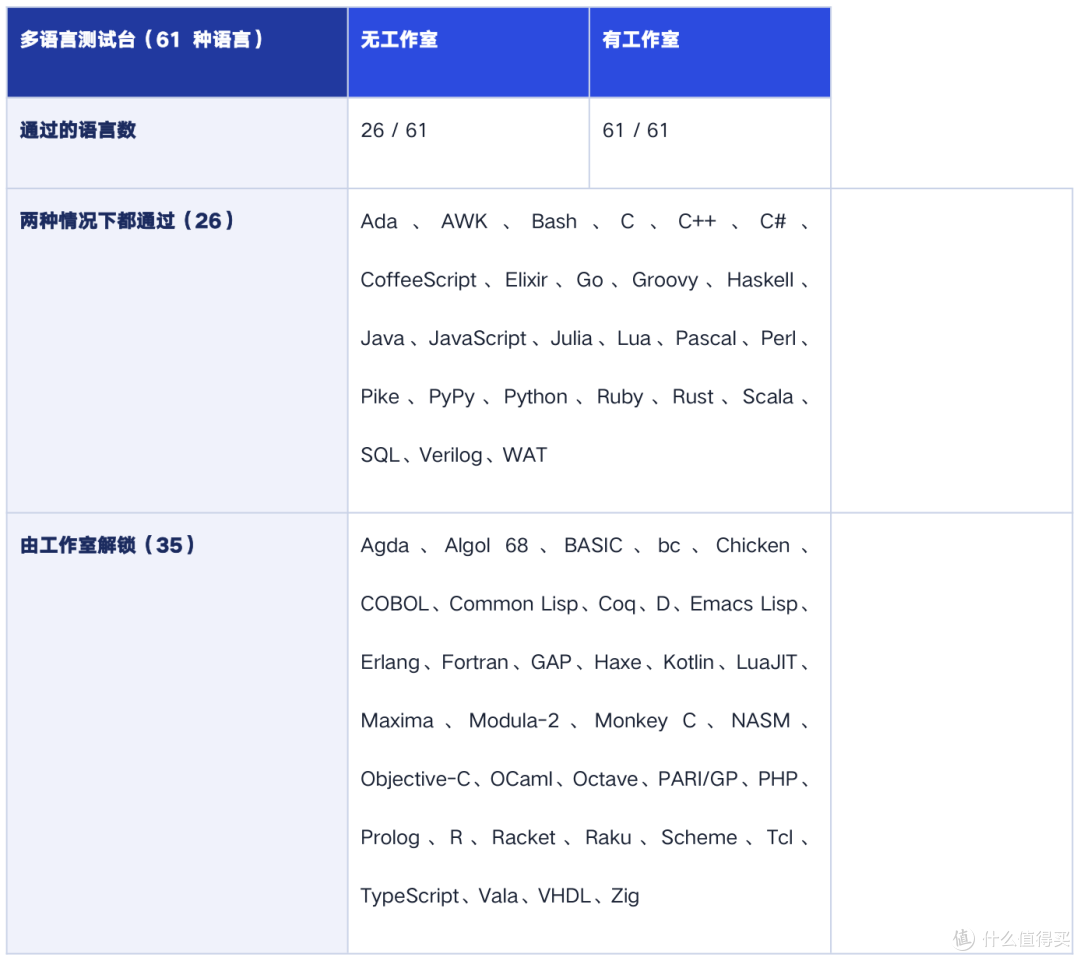
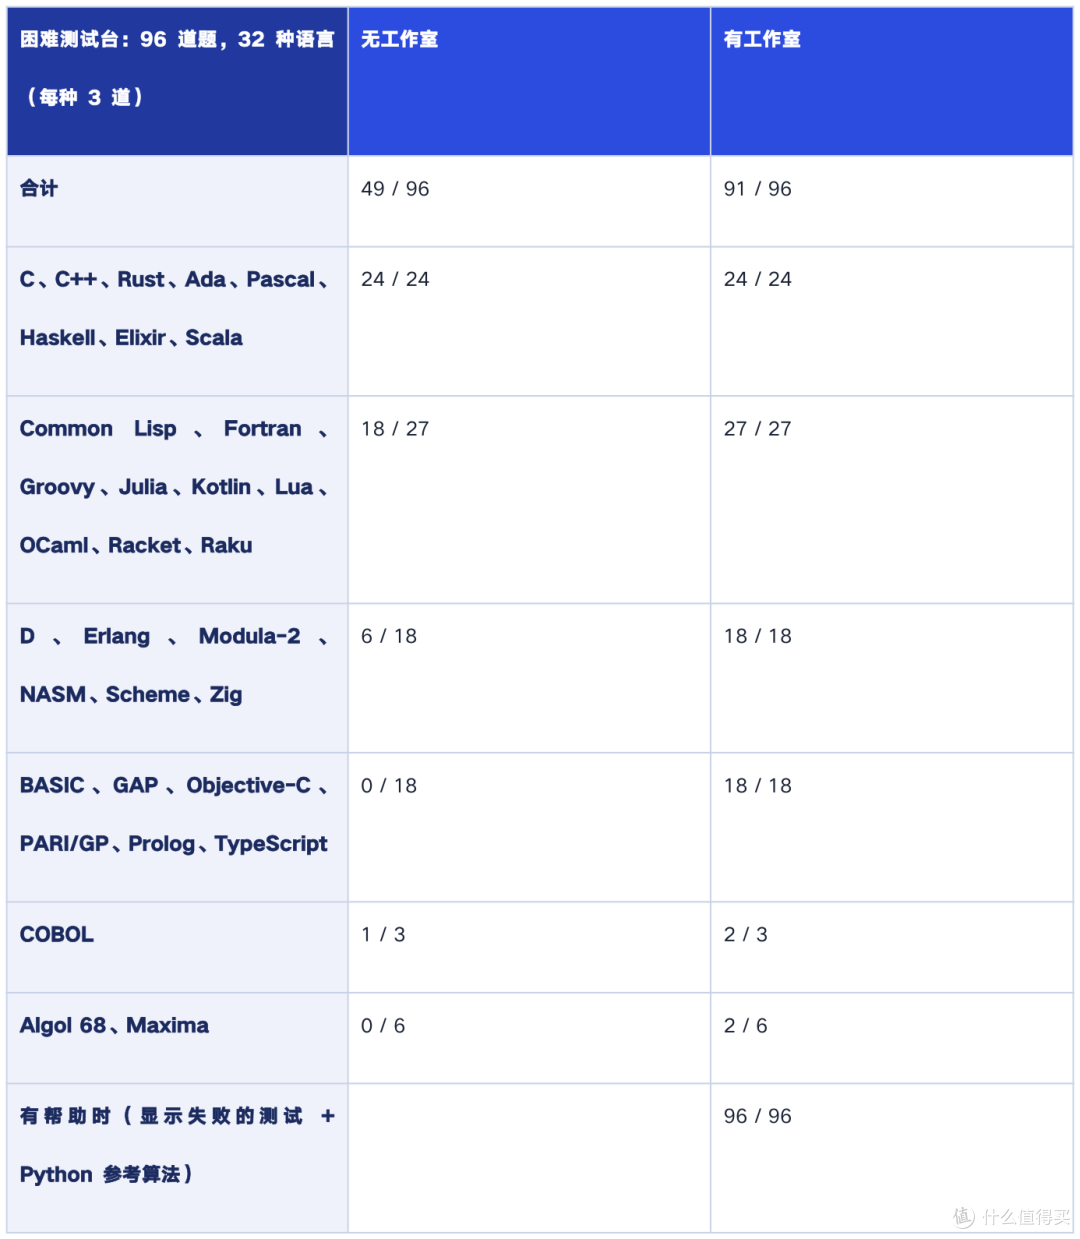
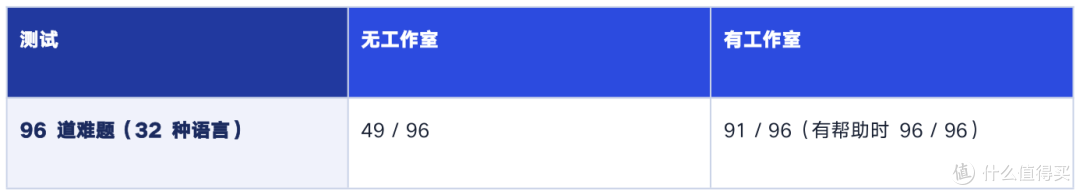
“无工作室”指单次回答,不运行任何代码,没有笔记和便签;“有工作室”指Qwen在给出答案前可以编译、运行和测试,并查阅经验笔记。剩下的5项失败涉及最冷门的语言(AIgol 68、Maxima、COBOL)。
16.4 其他测试台
16.5 与Claude Code的对比
困难测试台最初用于测量Claude本身。2026年10月29日,从10:13到13:24,Claude Code(2.1.310版本)搭配ClaudeOpus5.5模型,在同一个代码工作室里、用217个独立会话(每题一个,题与题之间无记忆)解决了同样的问题。
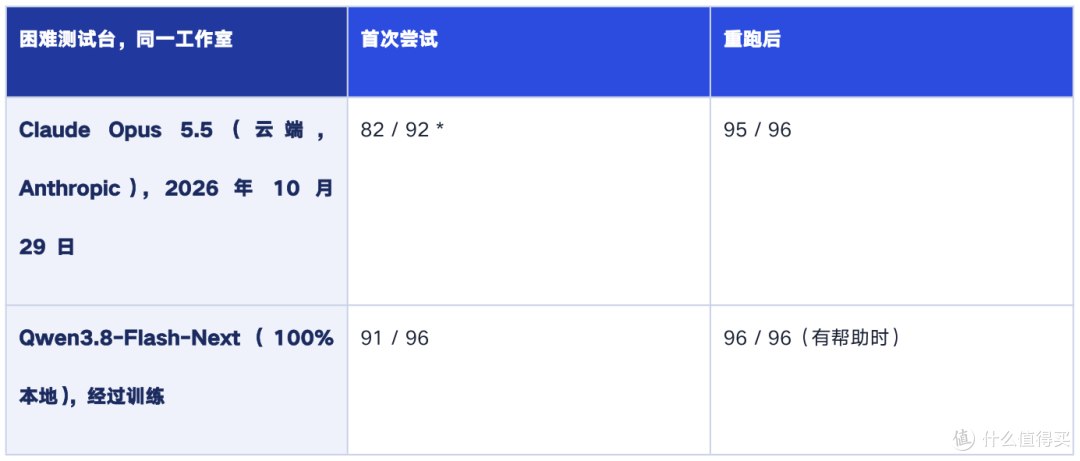
*有4道题因订阅的用量限制而在第一轮无法评分;它们在重跑中被补上。来源:保存在工作站上的这一轮活动的日志和结果(测试登记表,“claude-code”标签)。
这张表必须如实解读:Claude是“冷启动”参加测试的,而Qwen是在这些问题上受过训练之后才参加,还有经验笔记和部分借助那一轮活动写就的每种语言笔记。所以这并不意味着“Qwen比Claude强”这张表所显示的是:一个装备良好、训练充分的本地模型,在这类工作上能够达到与前沿云端模型相当的水平。17.Vigie:监控与韧性
Vigie全天候监控这台机器:每个组件的温度、功耗、CPU和GPU负载、内存、SSD健康度和损耗、热点时段及其原因、电费以及归因到每个程序的能耗。工具栏里一个彩色徽章可一眼看出状态,桌面上还有一个小组件。若机器过热,Vigie可阻止升级到DeepSeek。
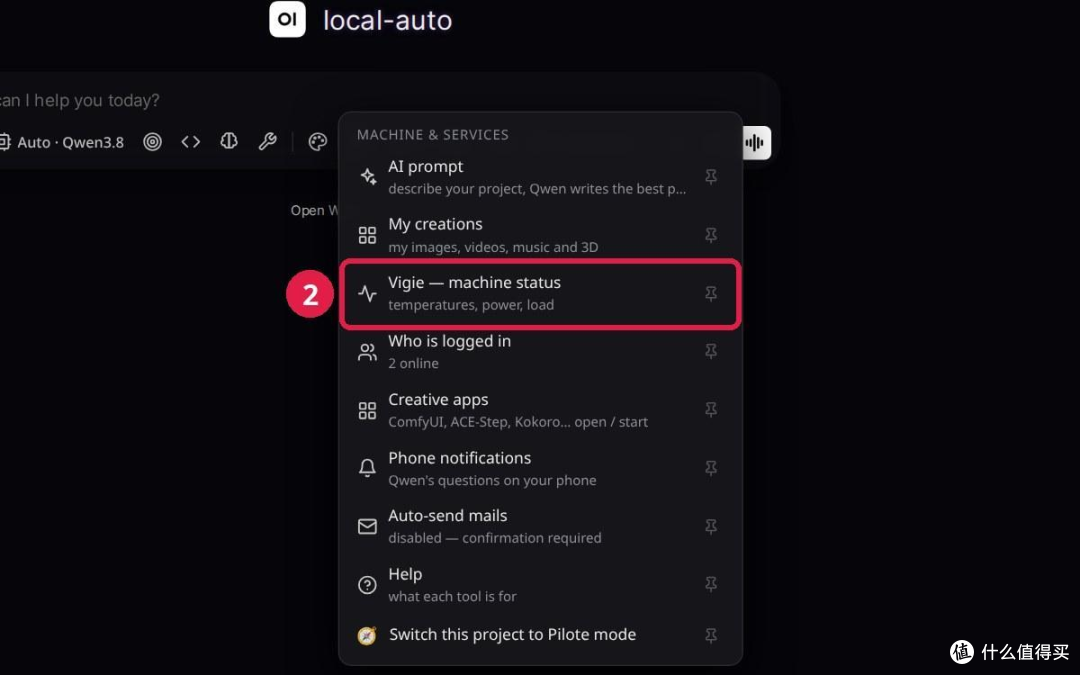
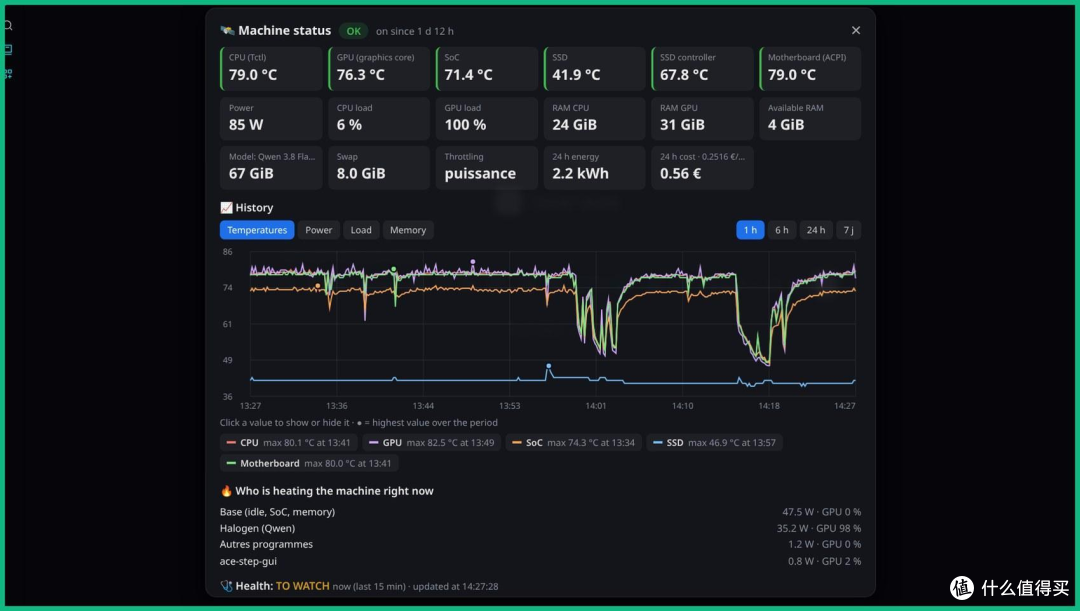
图80一访问路径:①工具栏中的Vigie 徽章:面板打开并显示实时传感器数据。
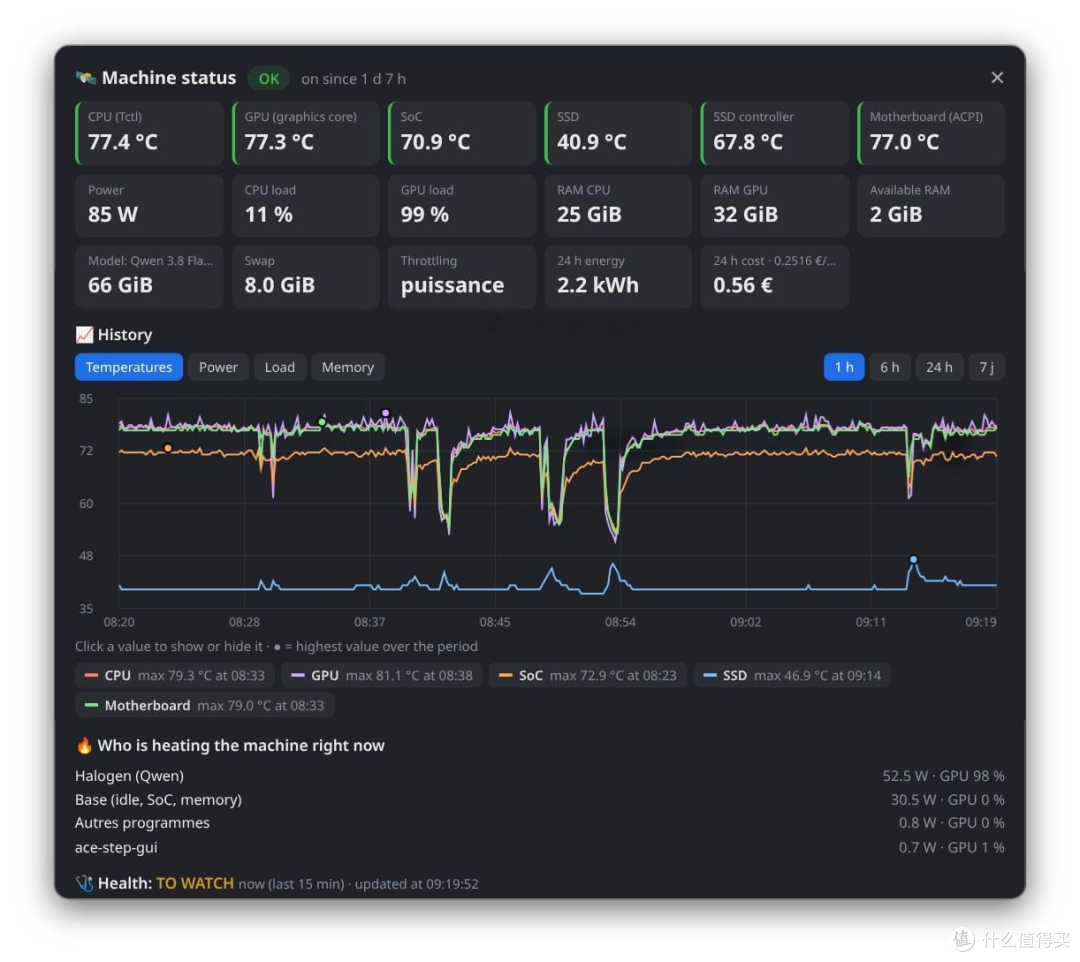
图81一Vigie面板:实时传感器、历史记录以及“当前是什么在让机器发热”
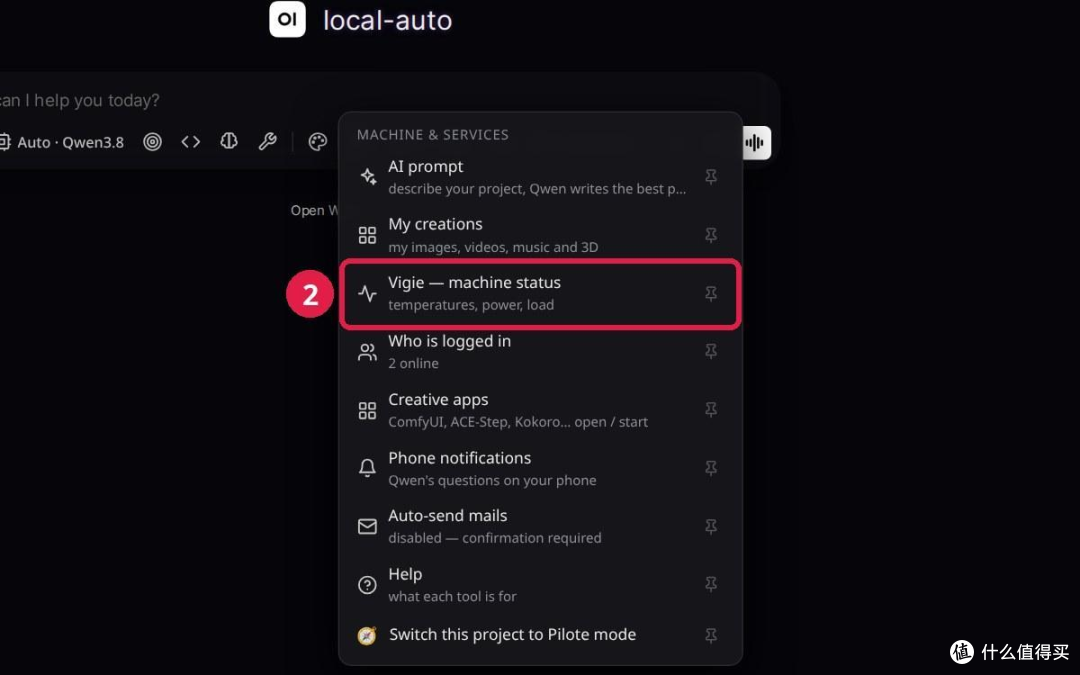
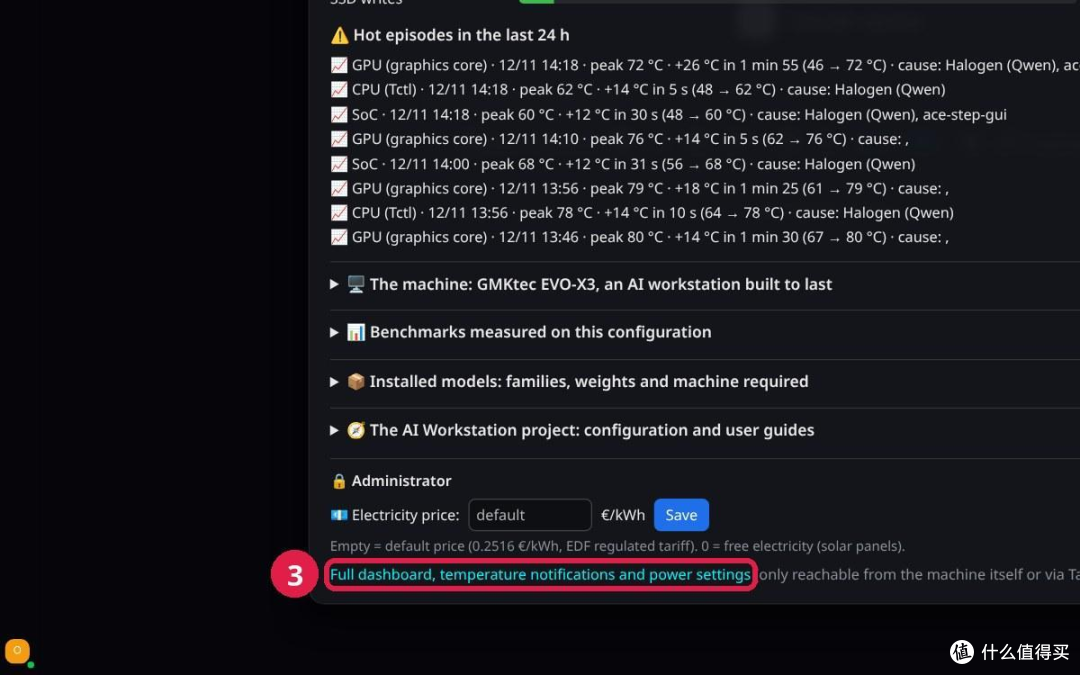
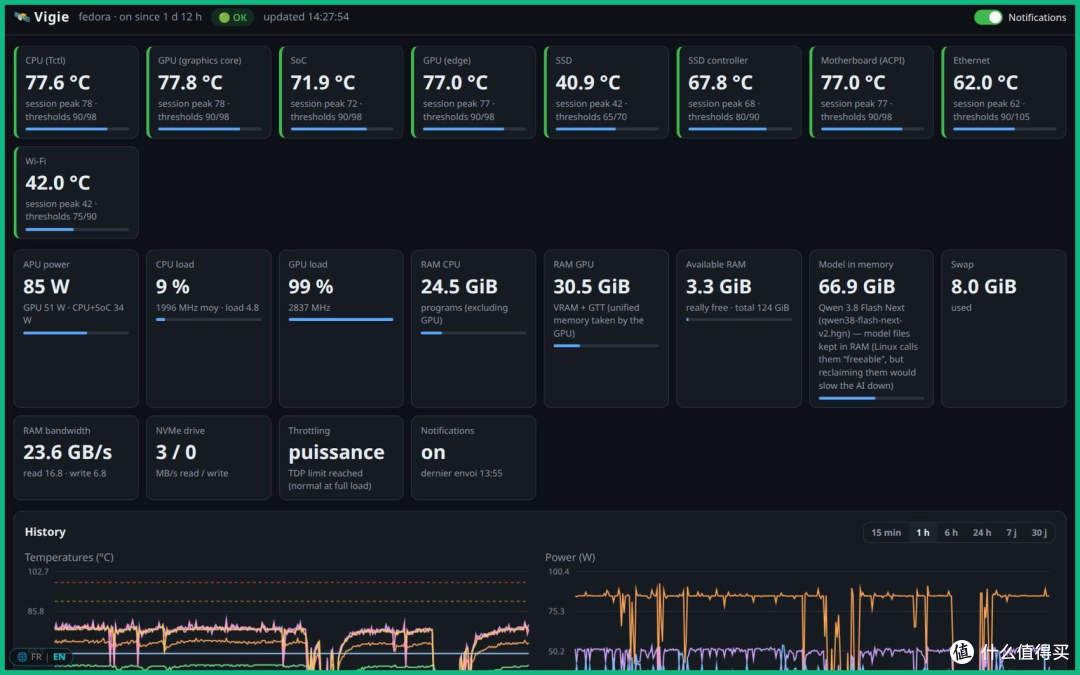
图82一访问路径:①Vigie徽章,②完整仪表板。
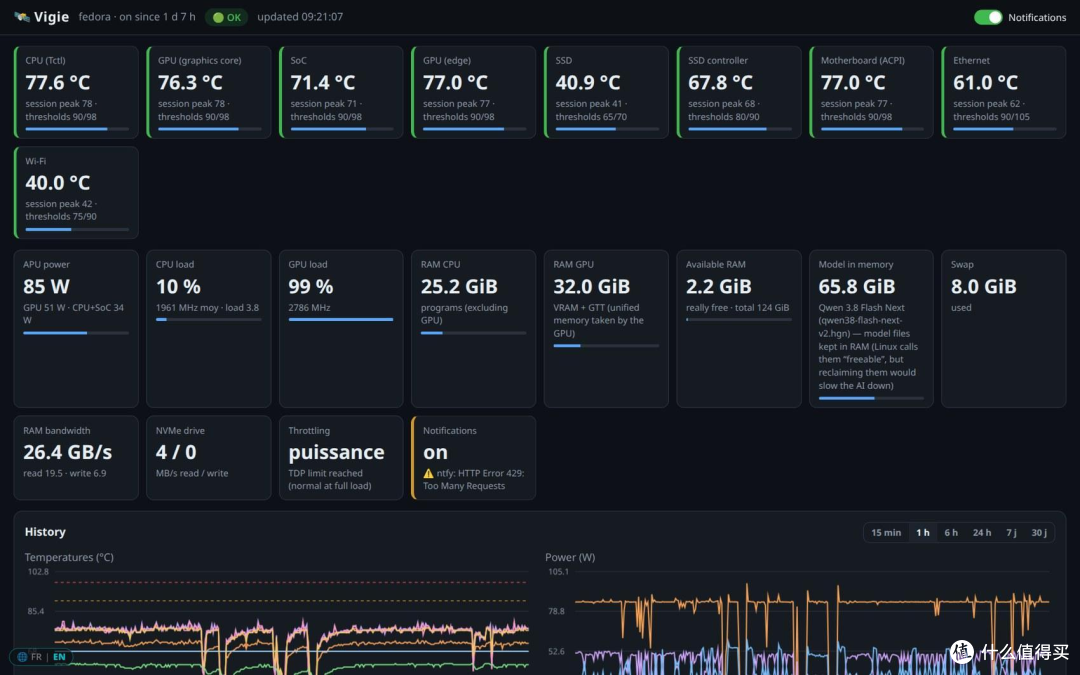
图83一完整的Vigie仪表板,含健康报告和诊断。
Vigie还会每小时向手机发一份报告:总体状态、每个组件的平均和最高温度及峰值时间、功耗和用电量(及其费用)、负载和内存、任何降频,以及各程序在消耗中的占比。
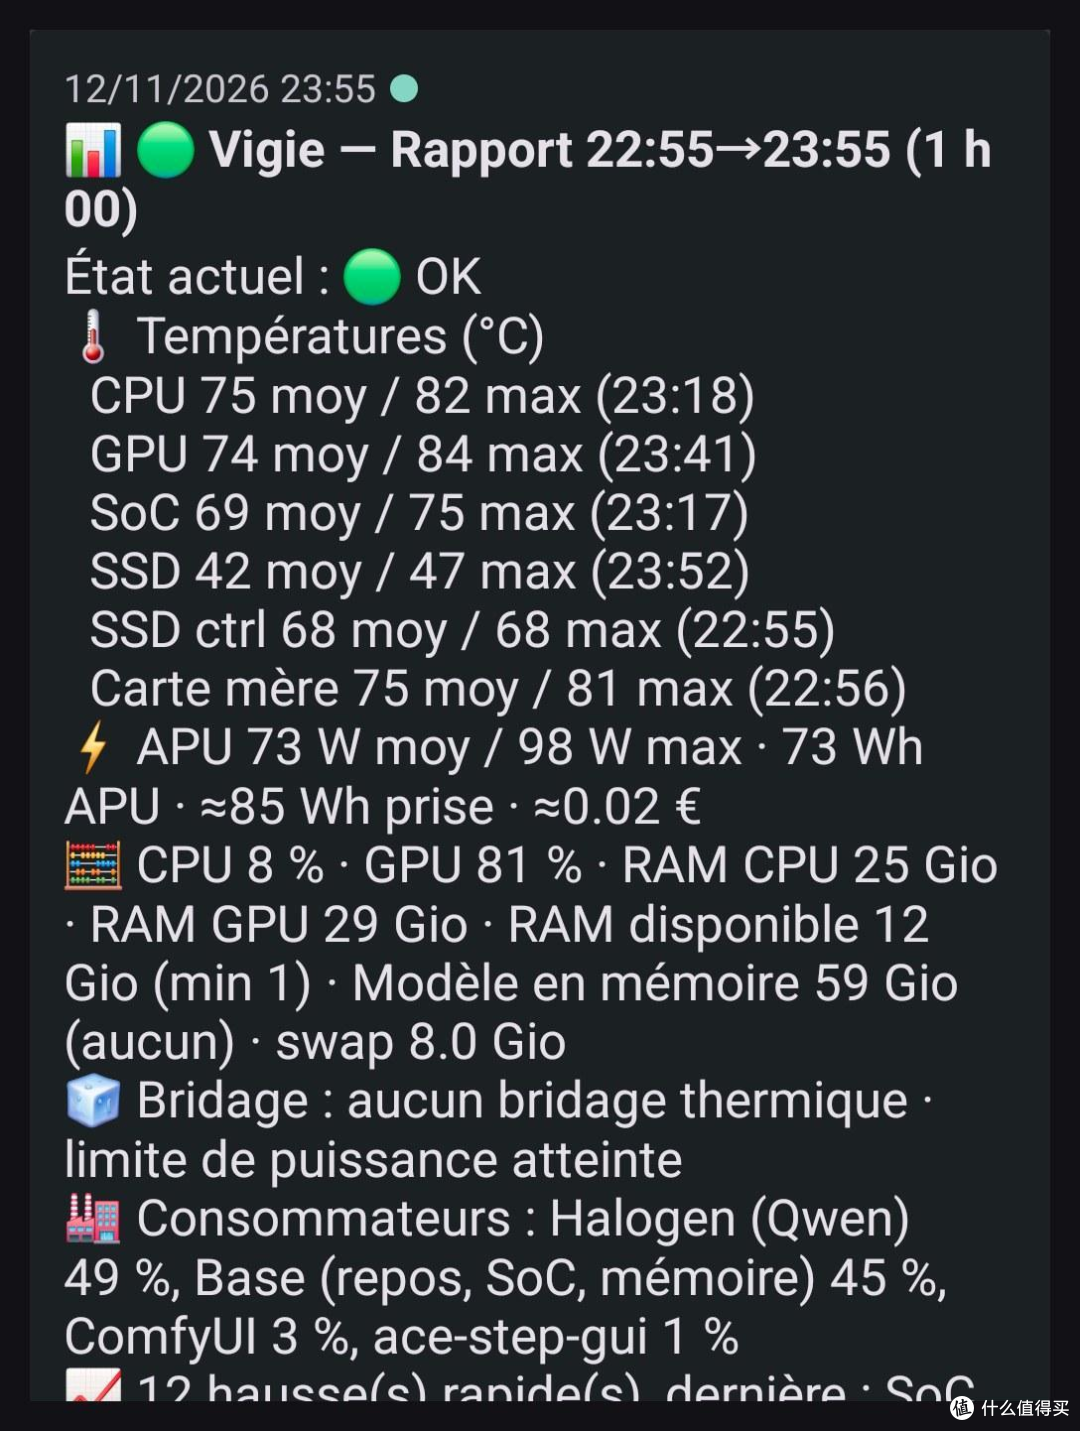
图84一Vigie在手机上的每小时报告(11月12日,22:55→23:55,正值一个 Pilote项目期间):CPU平均75°C、最高82°C,无降频,墙上电表约85Wh,即0.02欧元。(通知以所有者的语言法语发送。)
17.1 为断电而生
这座工作站的设计自标是无人值守也能工作:
无需打开会话:所有 AI服务(Halogen、Ollama、OpenWebUI、编排器、ComfyUI、Pilote、工具)都在开机时启动,早于任何用户登录。机器可以在没有屏幕、键盘或鼠标的情况下搬运:插上电即可。
断电后自动重启:电力恢复时机器自行开机,随后服务重新启动。
进行中的工作会恢复:Pilote从最后一次git提交处恢复被中断的步骤;守卫重启Qwen正在工作的对话;任何崩溃的服务在15秒后自动重启。
每次重启都有通知:Vigie判断关机是正常还是异常(断电、崩溃),并向手机发送发生了什么以及Fedora的重后情况。关机时、服务down掉或恢复时也会发送通知。
硬件看门狗:若系统完全死机,主板的看门狗芯片会将其重启。
无网络甚至无路由器时重启
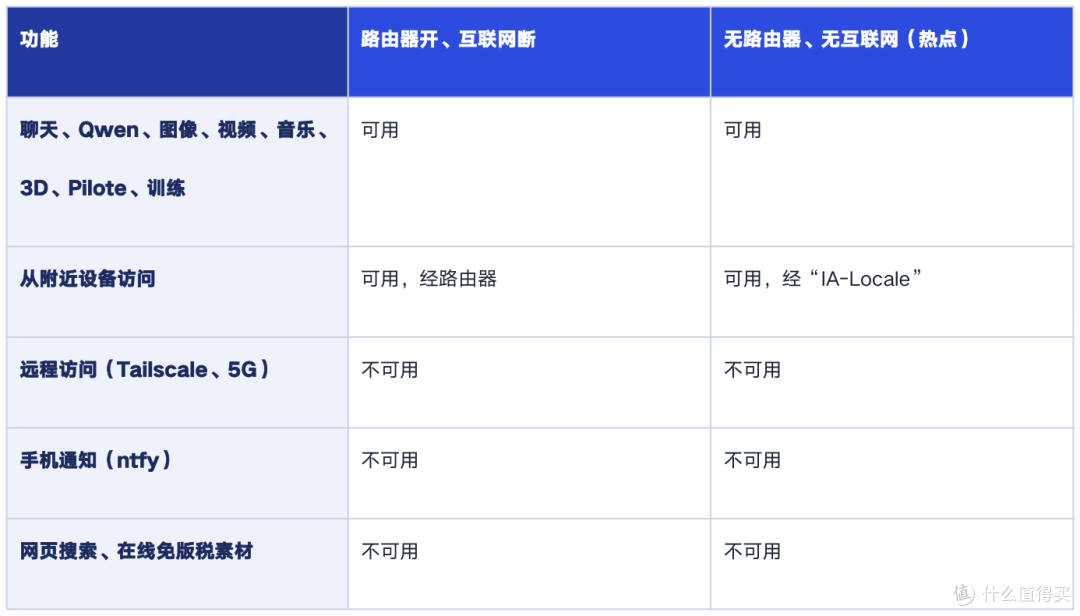
11月13日,一次真实的断电成了一次全面测试。机器于18:12自行开机,但Wi-Fi路由器晚了1分45秒才恢复。所有AI服务在没有网络的情况下启动,只有一点例外:OpenWebUI在Wi-Fi之前启动,无法再连到编排器,聊天界面在手动重启前根本不显示任何模型。当晚增加了四项保护:
聊天不再依赖网络。OpenWebUI现在直接跑在机器的网络上,在本地访问其服务:无论开机时有没有路由器、有没有互联网,聊天都能找到Qwen。保留给机器专用的服务,如Ollama和ComfyUI,仍像以前一样无法从聊天访问。
一个守卫每分钟检查一次聊天。它检查聊天能否应答、能否连到编排器。连续两次失败后,它会重启聊天(等待Qwen写完答案),并记入事件日志。已通过模拟故障做过测试。
“IA-Locale”备用热点。若Wi-Fi有3分钟找不到网络(路由器关闭、机器被搬到别处),工作站会创建自己的带密码Wi-Fi网络:手机和电脑连接它,在10.42.0.1:3000打开聊天。路由器一恢复,工作站立即重新加入。此前这版切换在断电时没有触发(它等待一个“无连接”状态,而无线网卡在寻找路由器时系统并不报告该状态),且热点防火墙曾阻挡聊天:两者都已修复。如果路由器开着但互联网断了,则一切照旧:家中每台设备仍能访问AI。
训练从中断处恢复。断电曾中断一项Garmin手表的训练活动,调度器错误地把它标记为“已完成”。现在它能识别被重启杀掉的任务,把它放回队列(最多三次),且测试台不重做已评分的任务:四项任务中只剩一项需要重跑。
无网络时可用的功能:
17.2 安全与远程控制
安全值守:网络监控(域名、国家、发送量)以及AI进程对敏感文件的访问,均带私有告警。远程控制:从手机上,通过一个封闭的命令列表(状态、结果、停止、给Claude的指令)。
17.3 内存守卫:三次Halogen冻结解析
共享内存(5.4)在两天内三次显出极限。Qwen的引擎Halogen在11月13日晚冻结(当时并行试跑一个Gemma评审:约一小时停机),14日凌晨约3点冻结(Qwen推理时启动了一次Blender渣染,而ACE-Step仍占着14.6GB),15日凌晨约2:30又冻结(16分钟:交换空间被占满,/tmp里残留8.4GB工作副本,而/tmp位于内存中)。调查还显示,当Halogen的加速表(48GB,从磁盘读取)被逐出缓存时,Qwen读取长指令的能力会崩溃:读取时间可达864秒,而平时只需几十秒。
一个“Qwen正在工作”标记:Pilote在每次调用Qwen期间写入它,只要该标记存在,Blender宣染就冻结。
一个新服务——内存守卫,跟踪每个生成应用的内存:它在ACE-Step闲置10分钟后卸载它(归还8.7GB,界面10 秒内恢复),在 ComfyUI 队列为空时释放其内存,对其他一切(Blender、语音、/tmp、交换空间)只发出告警:它从不中断任务。若Qwen似乎工作20分钟却毫无进展,它也会预警。
更大的压缩交换空间:16GB,使用zStd而非原来的8GB。
电影工作室的夜间归组(14.3),使15个镜头中Qwen的重启次数从30次降到4次。
一个想法经测量后被放弃:预加载整个48GB表。Halogen在其62GB权重旁只保留约20GB;这张表永远无法完整装下,预加载反而把有用的部分挤了出去。另一个陷阱:报告缓存情况的系统工具对这
18.基准测试
18.1 速度与硬件
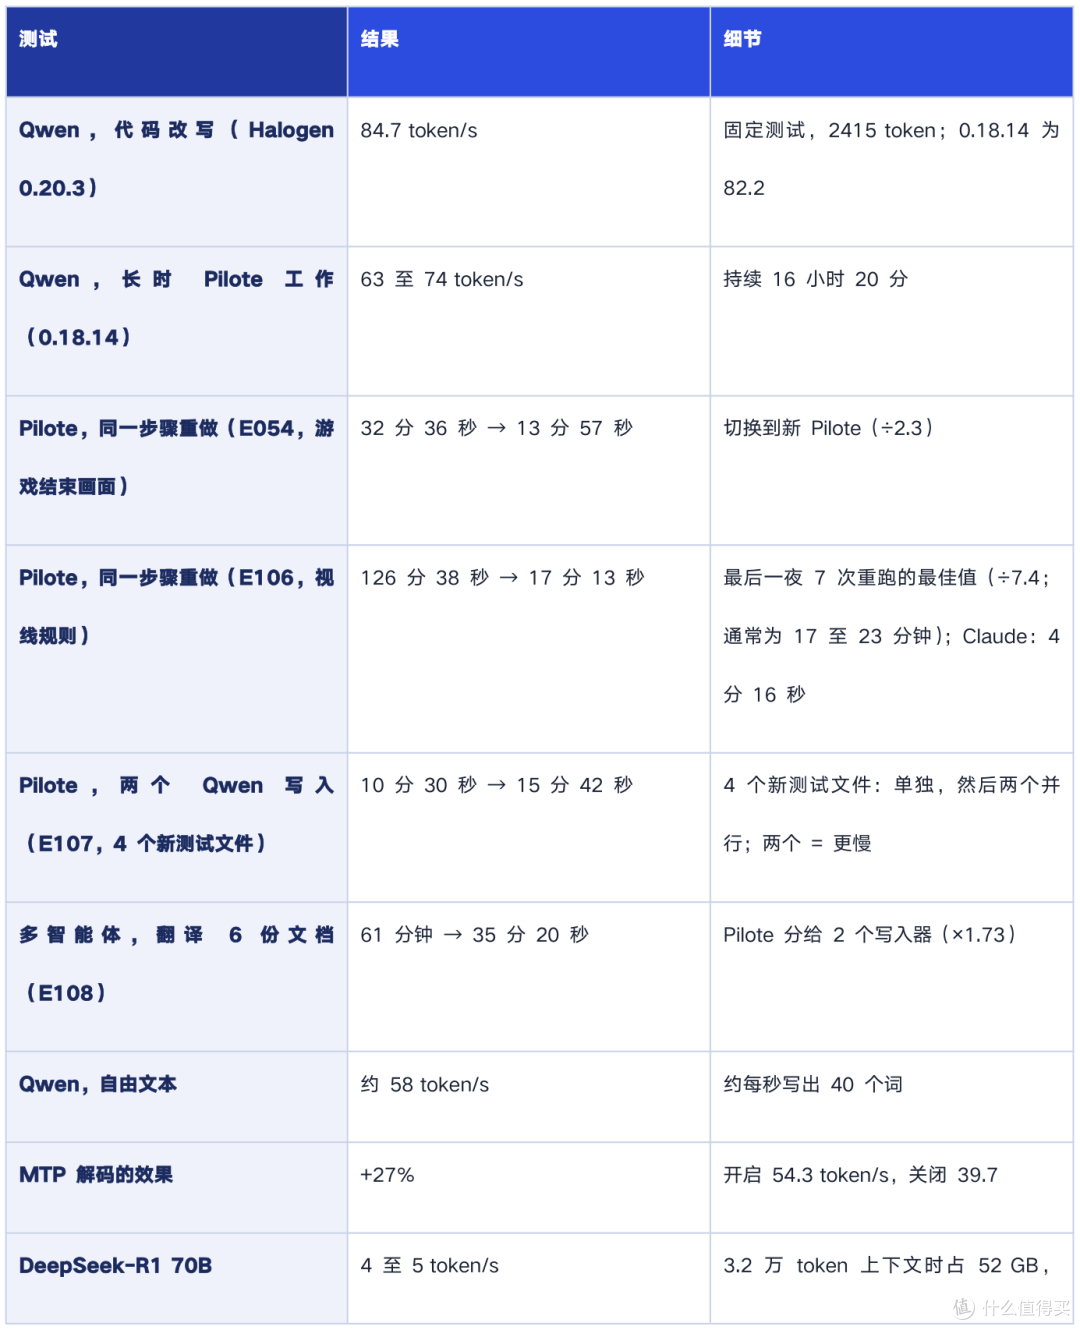
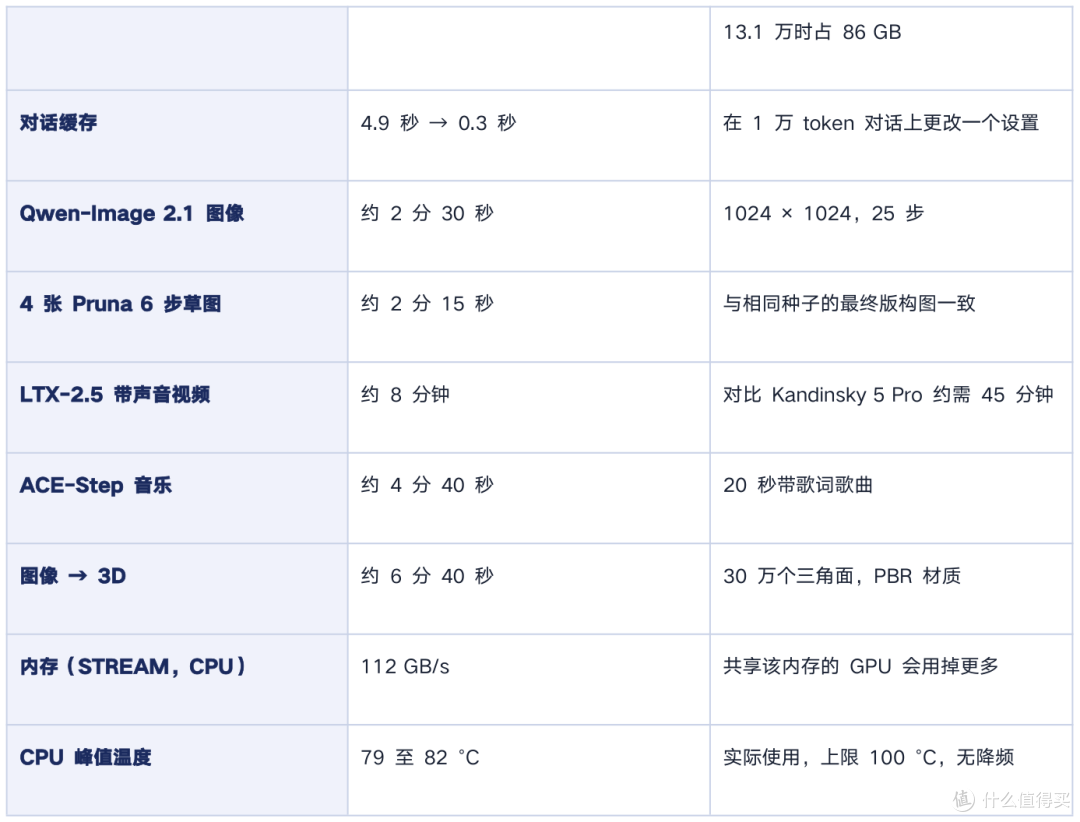
18.2 响应时间:如实呈现
写入速度(每秒token数)并不能告诉你看到答案前要等多久。在一个短问题上,在已缓存的对话中,第一个词在零点几秒内就到了。但在实际使用中,等待往往长得多,原因有三:
读取上下文:一段长对话、指令和工具卡片加起来有数万token。首次读取(“冷”)需要几秒,3.4万token 时可达约二十秒;之后由缓存接管。
推理:在写入之前,Qwen会思考;根据所选强度,这可能从几秒到一分多钟不等,而且这段推理不会显示为答案文本。
工具:一次搜索、一次文件读取或一次图像生成都会增加总时间。
因此,向Qwen提出的一个问题有时要等上一分钟才出现第一行答案,这是正常的。本文一个初稿版本公布的0.14秒对应的是一个理想情形(问题极短、缓存预热、无推理),并不反映日常使用;该数字已被删除。
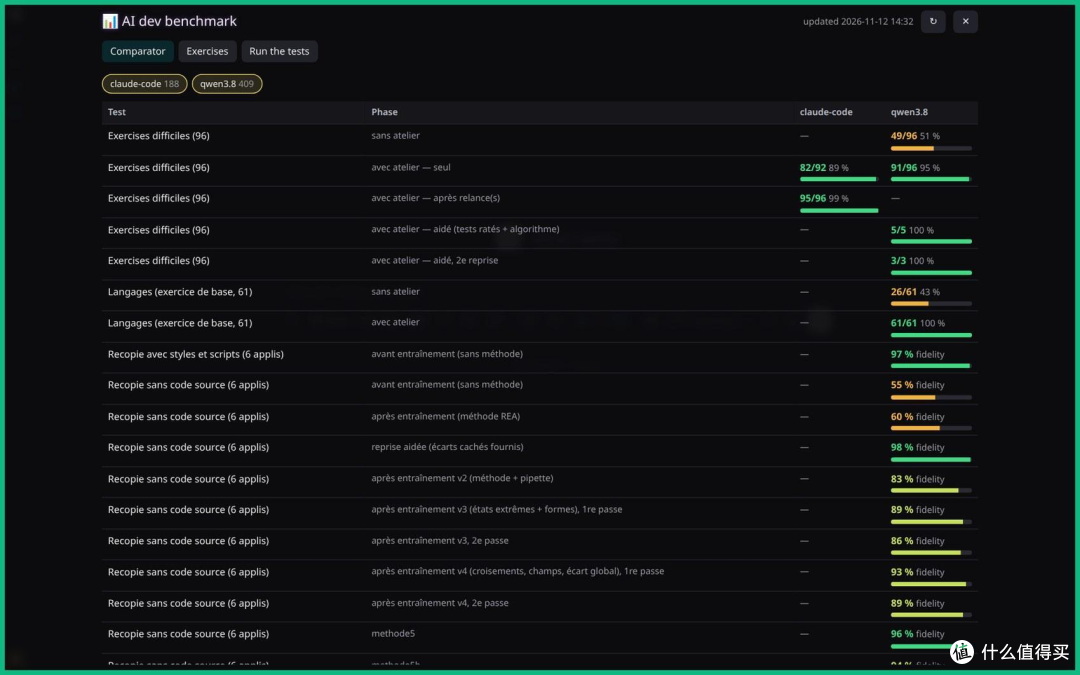
图85一访问路径:①Vigie 徽章,②“基准测试":可随时查看测量结果。
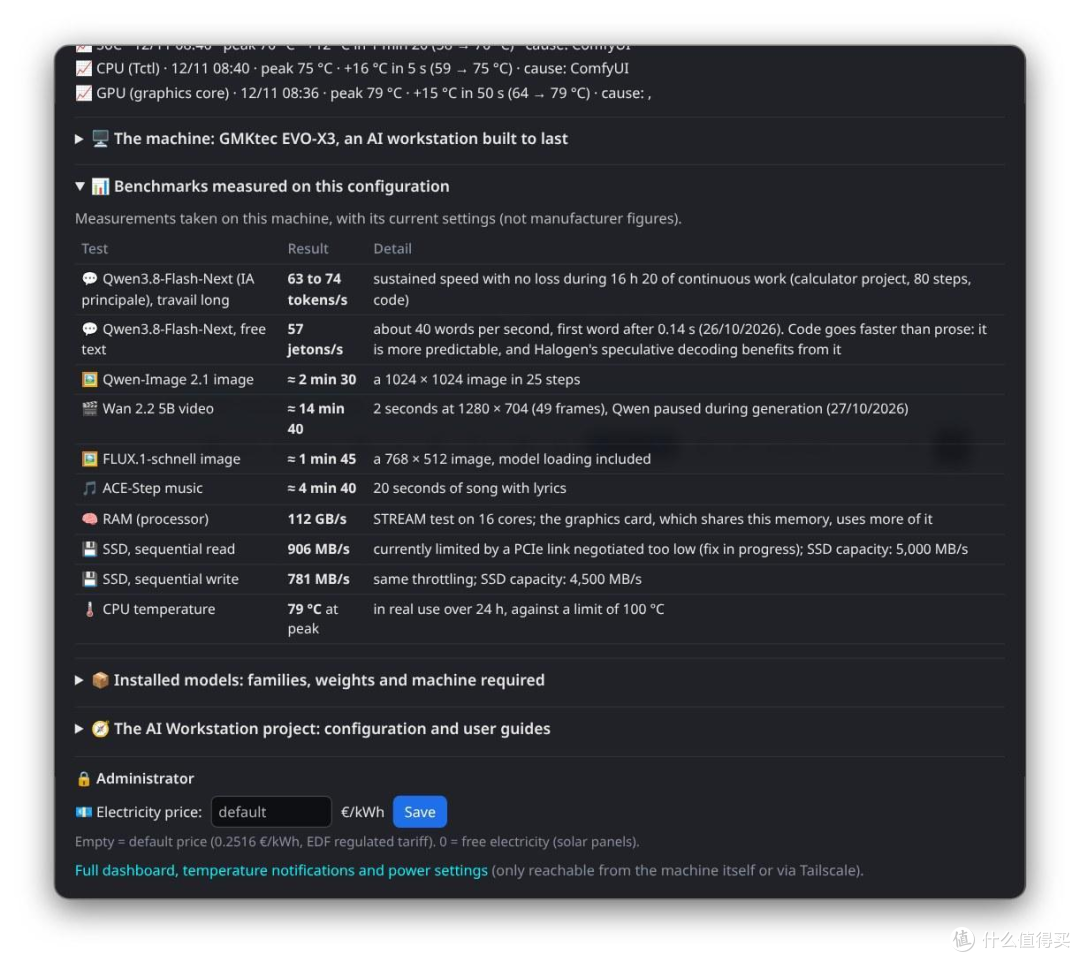
图86一Vigie 面板中的实测基准。
18.3 AI开发测试台
第16章详述了结果。简而言之:借助代码工作室,Qwen从通过一半练习提升到几乎全部通过。
19.多用户、隐私与访问
每个账户都有自己的对话、主题、技能、通知和创作成果,默认私有。
每个账户都能访问所有AI和所有工具,唯独管理员邮箱除外;只有共享设置保留给管理员。
通过Tailscale(加密私有网络)远程访问,浏览器麦克风走HTTPS,可从PC、Mac或手机访问。
完全没有网络时,机器会创建自己的Wi-Fi热点。
网页搜索默认关闭,按对话逐一开启。
20.双语界面
整套自研界面都用法语编写。为这次展示,增加了一个完整的英文版本作为独立层:工具栏中的 FRI EN开关把Open WebUI、每个模块、面板和设置、Vigie、创作、Pilote和技能都切换成英文,随后Qwen也用英文回答。该选择按账户记忆。法语代码未被修改:法语版仍是原始版本。本英文版的所有截图都是在英文界面下截取的。
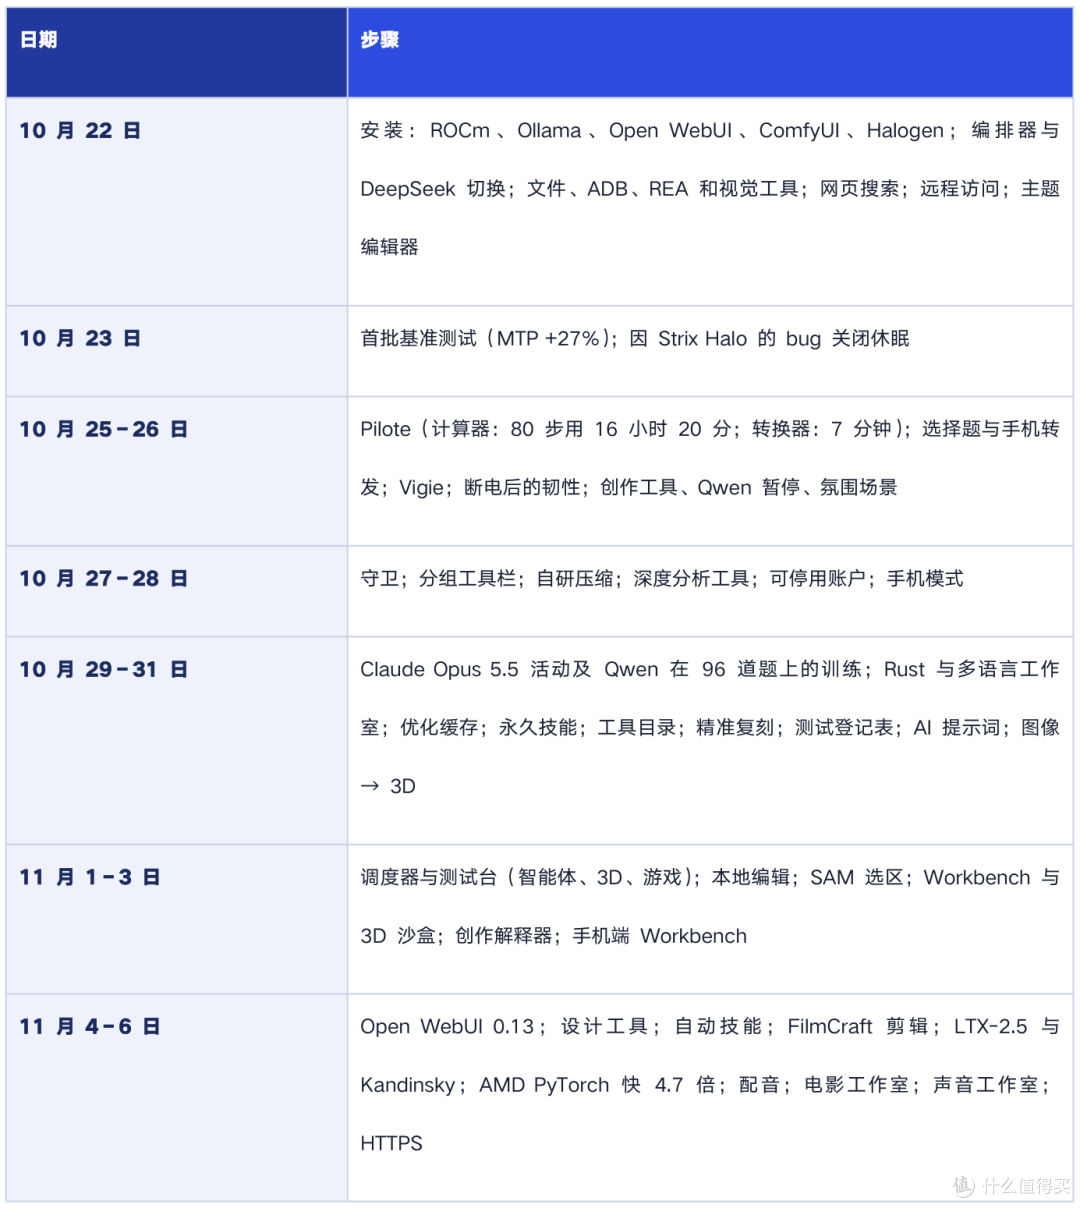
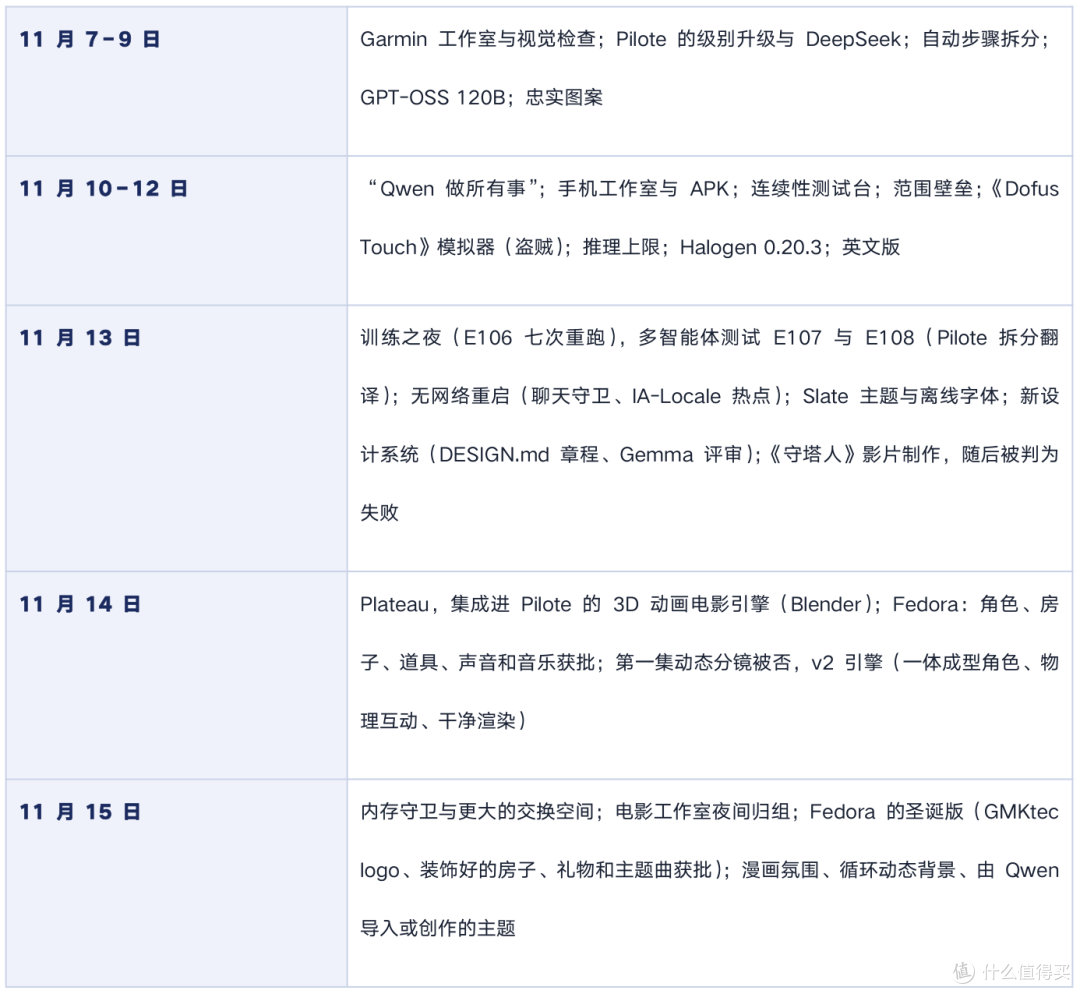
21.三周工作,逐步记录
22.结论
模型,每秒写出58至85个token,另有700亿和1200亿参数的推理模型作为增援;一条完整的创作链(图像、本地编辑、带声音的视频、剪辑、音乐、配音、3D、影片);以及一个能够自主执行数百步软件项目的系统,例如重制一款战术游戏。
真正拉开差距的并非某一个模型,而是整体:StrixHalo芯片的128GB统一内存、每次发布都在进步的优化引擎、在恰当时刻选择合适模型的编排器、让AI检查自身工作的工具、可量化且持续的训练,以及让人能够完全放心地把长达数天的任务交给它(即便经历断电)的监控系统。
动画电影是这座工作站近几天学到最多的一个领域:一部未经检查、一口气生成的影片失败了;答案是一个3D工作室,其中每个元素只构建一次,经过检查验证、由Qwen查看、由用户批准,然后锁定。它更慢,但这是通往没有失败镜头的长片的唯一路径。
本文来自极摩客授权。
当前文章无评论,是时候发表评论了