想装机跑大模型?先把8G、16G、24G显存的段位表看清
2026年攒机的人,理由换了:去年拼的是游戏帧率,今年问的是"本地跑大模型行不行"。偏偏赶上硬件最贵的时段:华强北内存条一年涨超300%,16G DDR5从最便宜的200多元涨到1400元以上。连RTX 5080都从1.8万元降到1.4万元,依然不算便宜。钱这么紧,更要花在刀刃上。先记住一件事:本地大模型的配置天花板,不归CPU管,归显存管。界面新闻36氪界面新闻
一、显存决定你在哪个段位
知乎用户"黑虾"整理的显存分级表很直白:当下消费级硬件能部署的本地通用模型基本都是阿里千问的天下,尤其是Qwen3.6-35B,8GB、12GB、16GB显卡都能跑起来,智商明显高于4B、9B小模型。知乎
再往上,24G及以上才能跑Q4量化的Qwen3.8-27B,这是目前消费级硬件能跑的最强本地模型;27B之后直接断层,下个台阶是180B的大家伙,Q4量化都要95GB显存。知乎
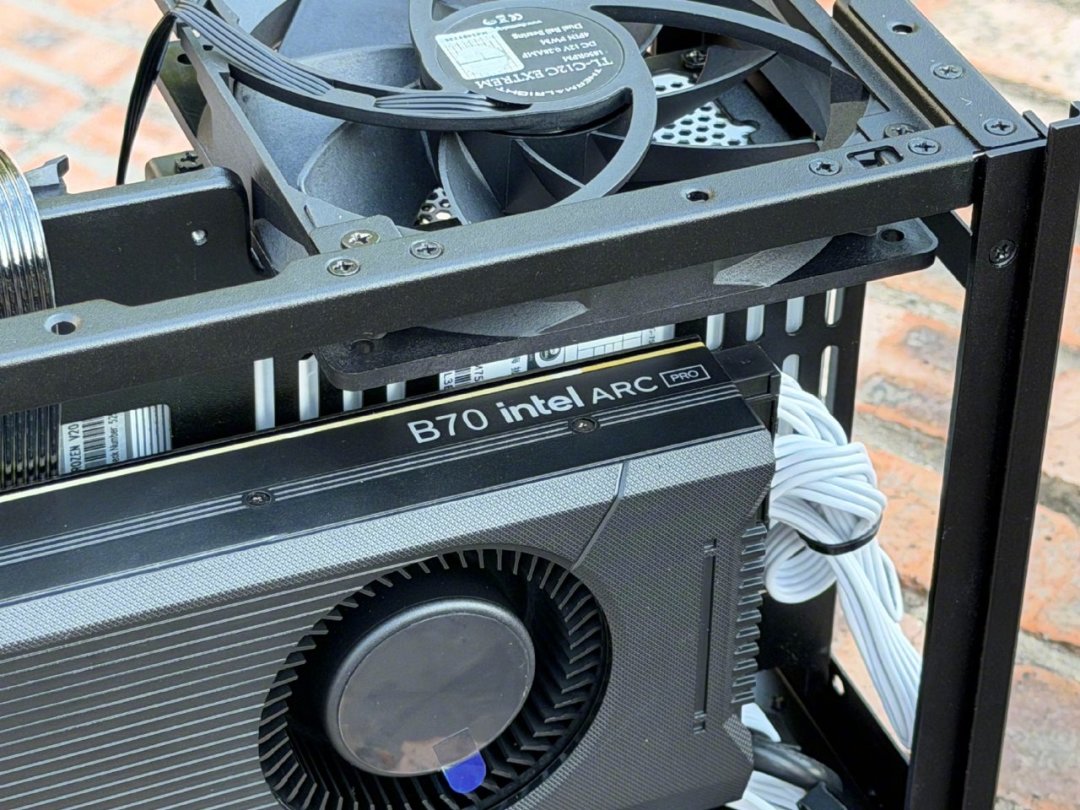
所以对个人用户,24G显存基本就是天花板,32G、48G能跑的模型和24G一模一样,只是上下文长短的差别。知乎
图片和视频生成模型只会更吃显存和内存。给新装机用户一句话结论:优先考虑16GB显存,别为"跑更大的模型"去堆卡。知乎
二、最贵的坑:拿内存补显存的课
很多人觉得多插内存就能弥补显存不足。有位知乎用户拿X99老机器实测:同一台机器、同一个模型,GPU推理36.8 t/s,纯CPU直接掉到9.3 t/s,差4倍。CPU是"能跑",GPU才是"能用",瓶颈在带宽不在容量。知乎
16G显存的真实定位很坦白:7B舒适区、14B将就用、32B别想。知乎
更要警惕的是:模型溢出到CPU超过30%,速度断崖式下跌,宁可换小模型,别让模型掉CPU。另外别忘细账:4K上下文额外吃2~3G显存,Chrome开着就能占掉1~2G。知乎
三、低预算路线:Strata香,但它是内存吞金兽
开源项目Strata把模型权重一部分放内存、一部分放SSD,显存需求从几百GB直接降到8GB,实测一条二手GTX 1060就能跑千亿参数的Qwen3.8-Flash-Next,生成速度能到19-21 tok/s,家用电脑真就转起来了。知乎
但教程作者也提醒:它对显卡要求不高,对内存要求极高。内存行情这鬼样子,这条路本质还是烧钱,而且机械硬盘绝对不行,原话是"太慢,慢死"。知乎
四、被劝退的AI小主机党
知乎那个58万浏览的问题——“怎么没人提用AMD MAX395跑本地大模型了?”——高赞回答相当残酷:Strata加Qwen3.8-Flash杀死了比赛,民用级显卡的推理和预填充速度大幅超过DGX Spark和MAX395。知乎
博主"老章"从HackerNews的4932万条评论里清洗出647票高精度实测基准。知乎
数字摆在那:同一个Qwen3.8-27B,Mac阵营中位数12.75 tok/s,N卡单卡50 tok/s。速度差距面前,统一内存神话补不回来。知乎
最后泼盆冷水
正经写代码干活的,云端订阅比装机划算。除非你是超高频使用,或者数据不能出门,这才是本地部署值得花大价钱的唯二理由。这轮AI装机潮的核心问题从来不是"多少钱配",而是"你到底用不用得上"。知乎