一部新发布的千亿MoE模型,社区量化包还没出来,想在自己电脑上跑的人,常常卡在量化这一步。卡住他的不是算力,而是你得先有一台装得下全精度权重的机器。Qwen3.5-122B-A10B的FP16权重大约244GB,常见的个人工作站连打开都做不到。所以过去两年的默认玩法是:量化由机房先做完,本地玩家等社区投喂量化好的文件。知乎
11月11日,华为计算系统实验室把MACaQ论文更新到v2,并开源了工具。论文里的头号实验:把这颗122B的MoE量化到W4A4,耗时64分钟,过程中峰值显存只有32.5GB,量化后权重占用74GB。也就是说,一张96GB的显卡,现在可以自己完成一颗千亿模型的量化。知乎哔哩哔哩知乎
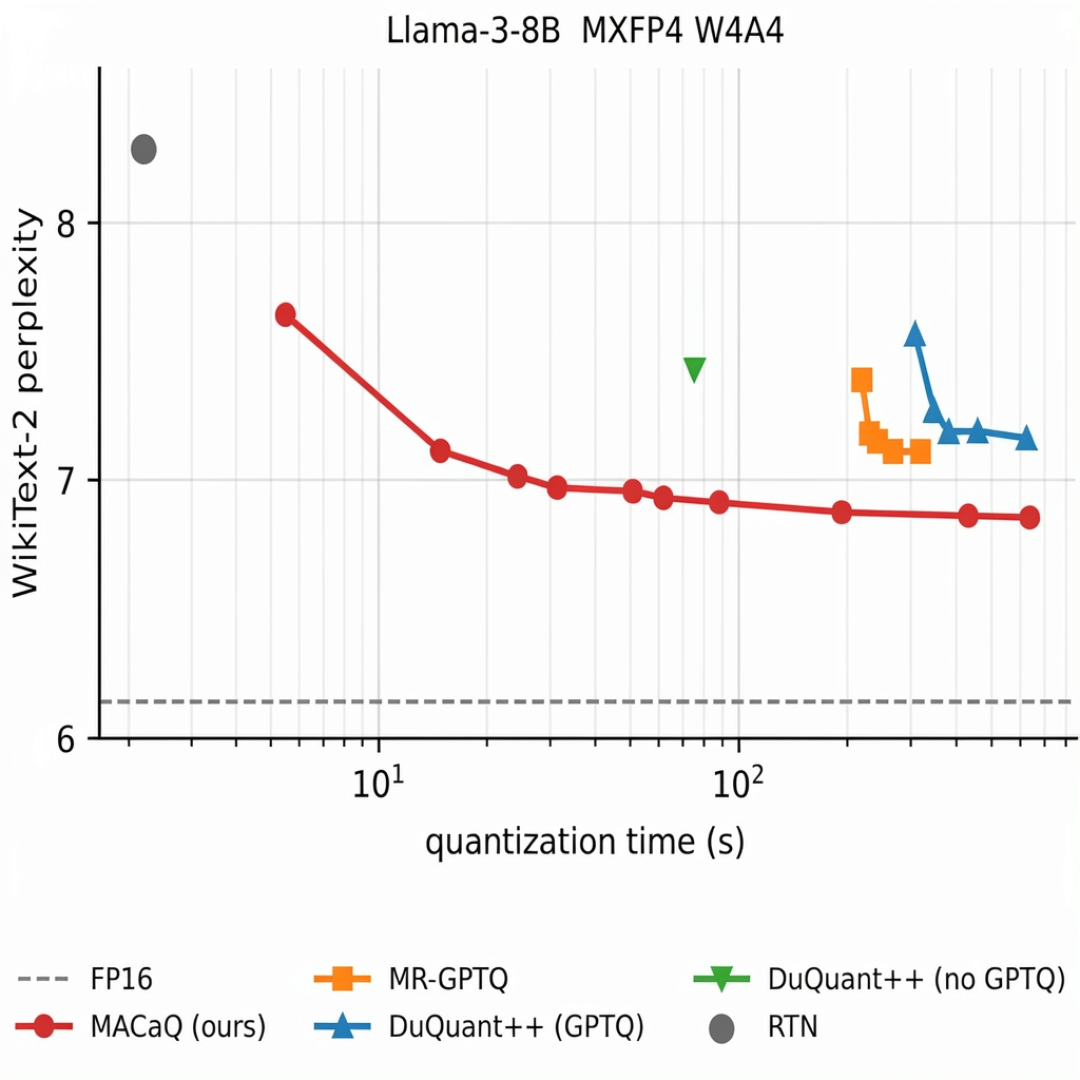
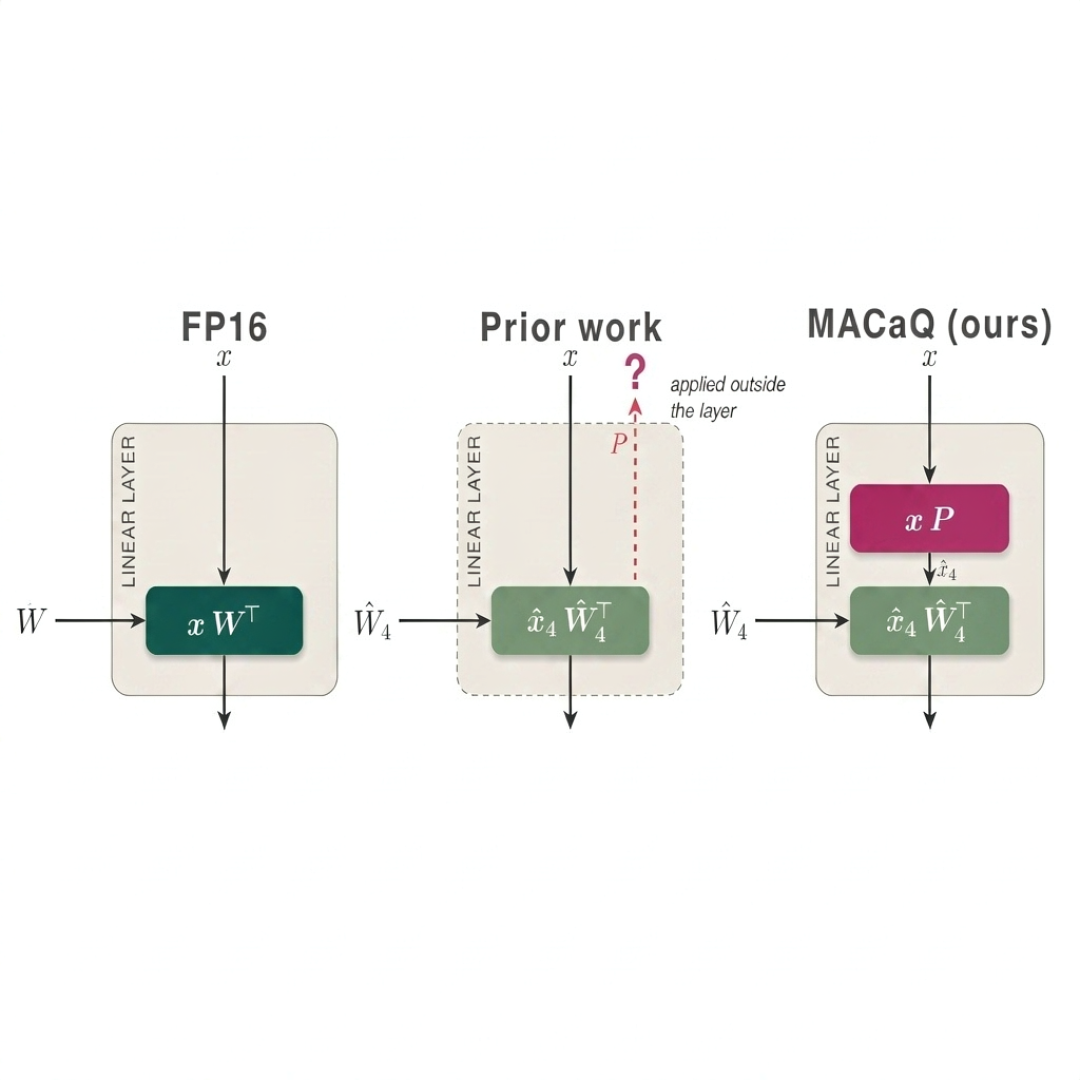
MACaQ的思路不复杂。量化到4位时,麻烦主要来自激活值里的“尖峰”:少数通道出现远高于其他通道的数值,共享的缩放比例要容纳最大值,剩下的数就被挤进很少几个档位,误差变大。常见的解法是Hadamard旋转,把一个坐标上的能量摊到更多坐标。但传统做法要么把变换推进相邻层的权重里——得跨层传播,处理归一化、残差这些结构;要么全模型统一处理。两种都让量化绑死在“整个模型先进机器”上。知乎
MACaQ把旋转限制在每个线性层内部,权重逐层交给GPU处理。量化就变成了流式:内存峰值只需要装下一层,而不是244GB。这就是64分钟和32.5GB的来历。知乎
代价同样写明。变换没法折进相邻层,推理时就留下了在线变换,逐层付出开销:论文按不同模型给出2.3%和约8%两笔实测账。另外这组实验只量化了专家层,embeddings和lm-head保持原精度,并不是全模型4位。知乎知乎
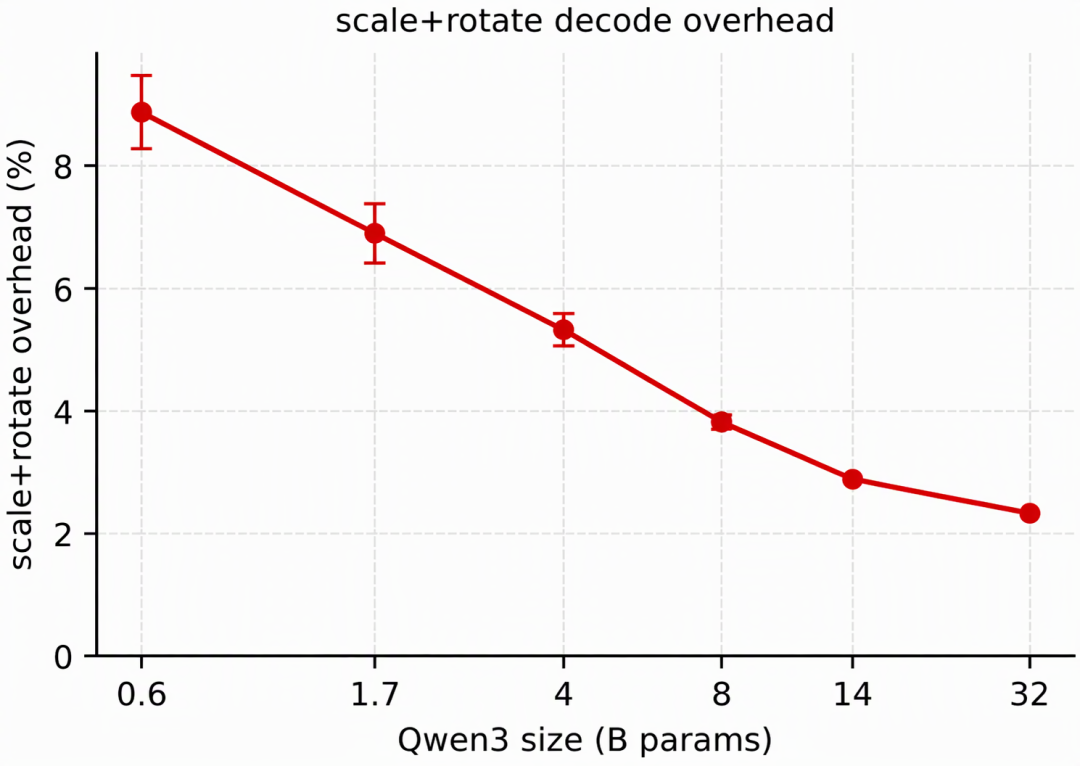
还有一个容易被误读的数字。74GB是量化后权重的占用,不等于“能跑多长”。96GB的卡装完74GB,名义上只剩约22GB,要留给KV cache和运行时。论文展示的是单卡能跑起来,能撑多长上下文、扛多大并发,并没有给答案。把标题里的“单卡可跑”理解成“单卡好用”,是这周最容易犯的错。知乎
对习惯直接下载社区量化包的玩家,这件事暂时不改变日常;真正被它够到的是三类场景:社区量化包还没出的新模型、不方便上网的机器,以及内网自部署的微调权重。量化从“借机房的事”变成“一台工作站的事”,门槛降的不是运行速度,是动手资格。这个月llama.cpp 1.0还给MoE专家做了常驻内存调度。两件事指向同一个方向:MoE的本地化,正在一层一层被解锁。哔哩哔哩