卡住的不是显卡,是"一个字一个字读权重"这件事
这两个月,本地推理社区的提问换了口味。8月大家问的还是"我这张卡能不能跑":Qwen3.8-27B 八月中开源,36氪都在写海外开发者怎么"榨干"它;8月26日阿里又放出 Qwen3.8-Flash-Next:125B 总参的 MoE,外加 51B n-gram 查找表和 4B 草稿头,凑成约 180B,每 token 只激活 6B。 到了10月,问题变成了"跑起来了,怎么这么慢",以及紧随其后的翻车贴:速度一快,模型开始说胡话、死循环。知乎知乎
先给一个很多人不愿意听的结论:如果你的生成速度卡在 20~40 tokens/s 这一档,加内存大概率救不了你。真正决定速度上限的是内存带宽,不是容量;想跨过这堵墙,靠的是"猜字"——推测解码;而把"猜字"开关和量化档位配错,代价是模型当场降智。这篇文章把近两个月全网实测样本、27组开源社区配置、翻车记录拼成一张决策表:先换引擎、再定档位、最后才轮到掏钱买内存。
一、速度墙的物理账:带宽决定上限,和显卡算力关系不大
本地跑大模型时,decode 阶段每生成一个新 token,都要把模型权重重新读一遍。瓶颈因此不在算力,在"读得多快"。
一个最干净的例子来自10月21日知乎上一篇对 Uzu 引擎的实测:同一台基础款 M5 MacBook Pro、同一个 Qwen3.5-9B(权重约 5.2GB),三个引擎跑出的生成速度是 llama.cpp 22.0 t/s、MLX 25.1 t/s、Uzu 92.1 t/s。 前两个不是优化差,是都被带宽顶死了:M5 内存带宽约 153GB/s,153÷5.2≈29.4,这就是逐 token 读权重的理论天花板,22 和 25 都是在天花板下面爬。知乎
这也解释了为什么"垃圾佬神机"和"旗舰显卡"最后都挤在同一档速度里。有人用 UltraX7358H 笔记本本地部署 Qwen3.8-27B-Q4,实测生成速度只有 5.6 tok/s。 也有人晒 8G 显存+32G 内存的机器跑 Flash-Next 量化版,“能用,25t”。 数字难看,但物理上合理——机器越省,带宽越薄。知乎哔哩哔哩
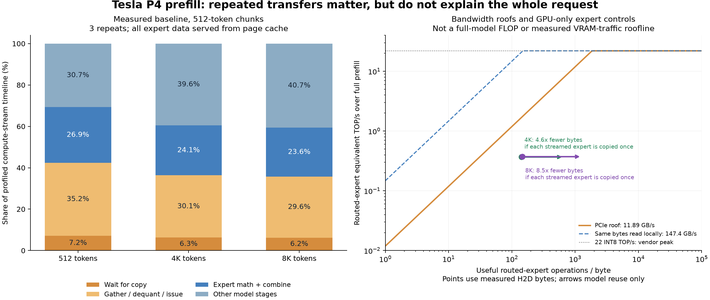
反过来看,模型厂和引擎作者都在想办法"少读":Qwen 官方给 Flash-Next 做的架构改动里,51B 的 n-gram 嵌入表不参与主干计算,每个 token 只查 16 行、约 5KB,所以敢扔进系统内存甚至 NVMe 映射而几乎不掉速;QSA 稀疏注意力把 1M 上下文场景的 decode 提速了 4.9 倍。 社区在老卡上的 roofline 实测也把问题摊开了:一块 Tesla P4 上,prefill 阶段走 PCIe 通道重复传输的带宽只有约 11.9GB/s,比本地读取的约 147GB/s 慢一个数量级——“从哪读、读几遍”,比"算什么"更能决定你的 tokens/s。知乎
二、引擎这层在发生什么:从"读一遍"变成"猜一串、验一次"
Uzu 冲到 92.1 t/s 的原理是推测解码:先让一个小模型一次最多猜 16 个位置的 token,用 Weaver 技术把多条候选串组织成一棵树,交给完整 9B 模型一次并行验证——实测每次验证平均能接受 7.5 个 token,而普通解码每次只能生成 1 个。 验证一次只读一遍权重,等于把带宽成本摊薄到 7~8 个 token 头上。92.1 不是算力魔法,是"读的遍数变少了"。知乎
这件事在 Qwen3.8-27B 上早就被量化过了。开发者 SudoSu 发布的 qwen38-mtp 项目(llama.cpp 合入 draft-mtp 推测解码后专门做的 A/B 实测),发布两天积累 21 名贡献者、27 组配置,同一张卡、同一份权重,只开一个 MTP 开关的差距是这样的——比如 RTX 3090 从 31.0 tokens/s 提到 41.3。36氪
显卡 | MTP 关 → 开(tokens/s) | 提升 |
|---|---|---|
RTX 3090 | 31.0 → 41.3 | +33% |
RTX 4090 | 47.7 → 76.3 | +60% |
RTX A6000 | 26.7 → 52.5 | +97% |
RTX 5090 Mobile | 36.7 → 50.9 | +39% |
RX 7900 XTX | 30.7 → 43.9 | +43% |
RTX 5090 32G(UD-Q4_K_XL、262K上下文) | 76.3 → 171.7 | +125% |
双 Tesla P40(2016年的12G老卡) | 13.2 → 23.4 | +77% |
RTX PRO 3000 笔记本 12G(27B放一半在CPU) | 5.3 → 10.8 | +104% |
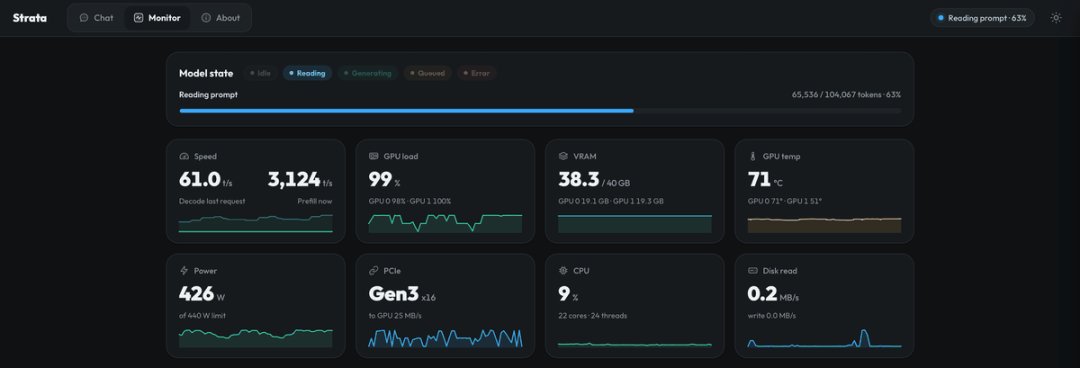
NVIDIA 生态这边还有一个更激进的答案叫 Strata(github.com/Niko1221/Strata),10月2日一条"12G显卡跑 Qwen3.8 Flash-Next、速度93t/s"的B站视频把它捧成了"专武":播放破 20 万、评论 2350 条,项目 star 数按用户说法从 1200 左右飙到近 5K。 它的看家本领是自动把显存、内存分配压到极限,再配合 MTP 草稿头。高赞评论里的实测样本:5070Ti 16G+48G 内存跑 IQ2_XS、128K 上下文,解码 70~85 t/s;2080Ti 22G+64G 跑 IQ3-XXS 能到 60+;双至强+128G 内存配 2080Ti 也有 35~40。10月20日的 0.2.1 社区基准更直接:一张 12G 的 RTX 3060 跑 IQ3_XXS,短任务解码中位数 64.4 t/s,双 A4000 机器 90.3 t/s。哔哩哔哩GitHub
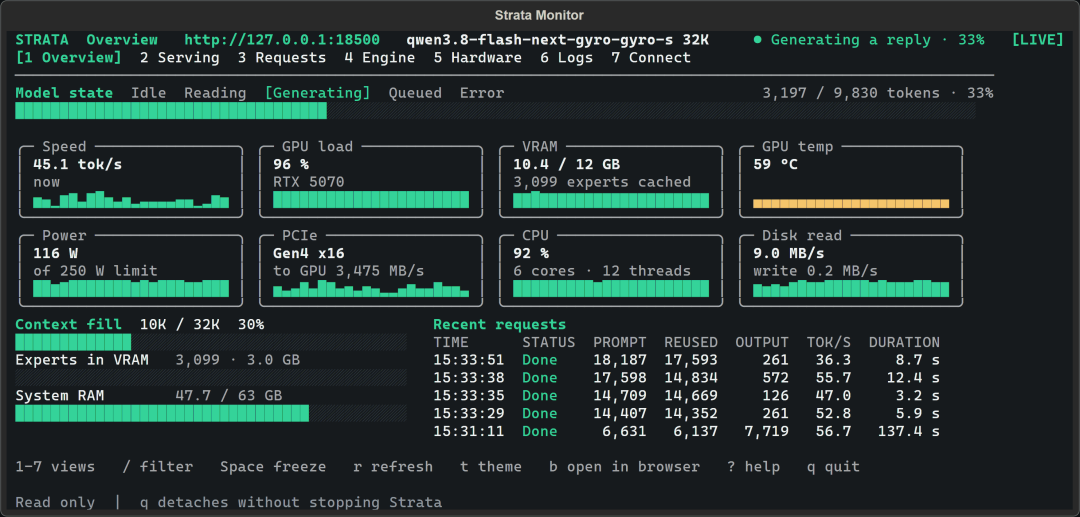
不过这里必须泼一盆冷水:你看到的"速度"和别人的"速度",可能根本不是同一个口径。Strata 官方在 0.2.2 发布说明里自己承认:聊天底栏、监控、API、控制台用的是不同定义——同一批真实请求,按"解码时间"算是 47.8、64.8、65.9 t/s,把"读入 prompt 的时间"也算进去就只有 20.6、29.0、31.5。 这就解释了微博科技博主"挨踢牛魔王"10月5日那条吐槽:项目方说 12G 能跑 90 tokens/秒、有人实测只有 30 多——两边都没撒谎,口径不同、量化不同、任务长短不同。 看任何跑分,先问一句:分母里有没有算读题时间。GitHub微博
另一个要泼冷水的地方:推测解码不是万能药。qwen38-mtp 的表里也有坏消息——Apple M4(约120GB/s带宽、Metal 后端)上开 MTP 整体是"wash":基线 5.8,开了之后 5.6~5.9,代码快 9~10%、散文反而慢 22~24%,Batch 8 验证摊不平带宽,猜错的 token 全得重读一遍。 还有社区提醒:短输出(≤400 token)时推测解码的开销可能大于收益,长生成才是它的主场。GitHub
三、硬币的另一面:速度是"猜"出来的,降智也是
如果故事到 93 t/s 就结束了,这篇文章就不用写了。真正的新信号是那 2350 条评论里长出来的翻车共识:低精度量化 × MoE 架构 × 打开 MTP,是死循环三件套。Strata 视频下 481 赞的主楼说得很直白:作者拿 IQ3-S 量化版对比阿里官方 API,数学推理只是略落后,但编程长任务"因为死循环导致分数塌陷严重",并提醒低精度量化、MoE 模型开 MTP 都是死循环的常见诱因。 楼下跟着的是"Q2 掉智有点严重,能上 Q3 就上 Q3,真不行就回去跑 27B IQ3-S"、“量化到 Q4 以下质量都是严重塌陷,循环断流非常常见”。哔哩哔哩
36氪那篇稿子里的"反面样本"可以佐证这不是 Strata 一家的锅:测评人 BijanBowen 把 Qwen3.8-27B 拉到 xhigh 思考档,生成一个 C++ 滑板游戏时模型多次准备写文件、又停下来继续思考,同样的循环至少出现了 5~10 次,一个多小时后仍卡在无法自行解决的 bug 上。 HackerNews 上另一名用户实测这个 27B 通过私人推理测试的 token 消耗约为 Gemma4 的 5 倍,开了 MTP 整个任务仍耗时 12 分 30 秒。稠密模型不是不会循环,只是循环的姿势不同——按任务分配思考预算,已经成了社区公认的必修课。36氪
这条量化降智的经验也有对照数据。10月17日同一位 up 主在 RTX 5090D 上做的同题包实测:803 道源题、920 个执行实例、11 个加权维度、同一个 judge,结果是——Unsloth 的 UD-IQ4_XS 量化版本地跑 Strata 得分 89.50,阿里官方 qwen3.8-flash API 得 86.99 分,而 IQ3_XXS 档的 Swift 分支只有 83.62 分。 在他的题包里,IQ4_XS 不仅没输反而赢了 API;IQ3_XXS 已经在悬崖边。另一个自报成绩单来自把 Flash-Next 压成逐张量 GSQ 的 DASLab:3.5 bit 拿到原版均值、2.4 bit 数学榜还剩 96.7——注意这是自报数据,第三方还没有干净的复现,当参考别当承诺。 也有翻车其实不怪量化:评论区给过一个免费修法,部分死循环是 jinja 模板的锅,换成 froggeric/Qwen-Fixed-Chat-Templates 这类社区修复模板就能绕开,动手调量化前先用它排除一次。哔哩哔哩知乎
四、按机器档位抄表:先引擎,再量化档位,最后才是内存
把上面的散样本收拢成一张表,对着自己的配置直接查:
你的机器 | 引擎建议 | 量化档位 | MTP/推测解码 | 预期与备注 |
|---|---|---|---|---|
8G 显存 + 32G 内存 | llama.cpp/Ollama,Flash-Next 别硬上 | 27B 的 Q4_K_M/IQ4_XS | 老卡收益大(双P40 +77%),先试 | 10~25 t/s,写文档够用;上下文从 32K 起步 |
12~16G 显存 + 48G 内存 | Strata(自动分层调度) | IQ4_XS 优先,IQ2_XS 只留闲聊 | 开 | 3060 12G 实测 64.4;70~85 t/s 档;Agent 长任务死循环就升 IQ3,再不行回退 27B |
Mac 16~32G 统一内存 | MLX/Uzu(M系);Strata 0.2.2 起支持 Mac | 9B 级推测解码收益最大 | 谨慎:M4 实测 MTP 是 wash | 27B 在 24G 以内是"能跑但别指望丝滑";Flash-Next 系权重约 38GB,32G Mac 只能流式跑专家(Mac mini M4 32G 跑 Gyro-S 量化实测 9.1 t/s) |
64~128G 统一内存/Spark 级 | NVFP4 + PLE 表放内存/NVMe | 官方 NVFP4 | 按 SGLang/vLLM 路径 | 128G 档约 104 GiB 占用可日常使用;GSM8K 抽样准确率 97%(个人 n=200 自测) |
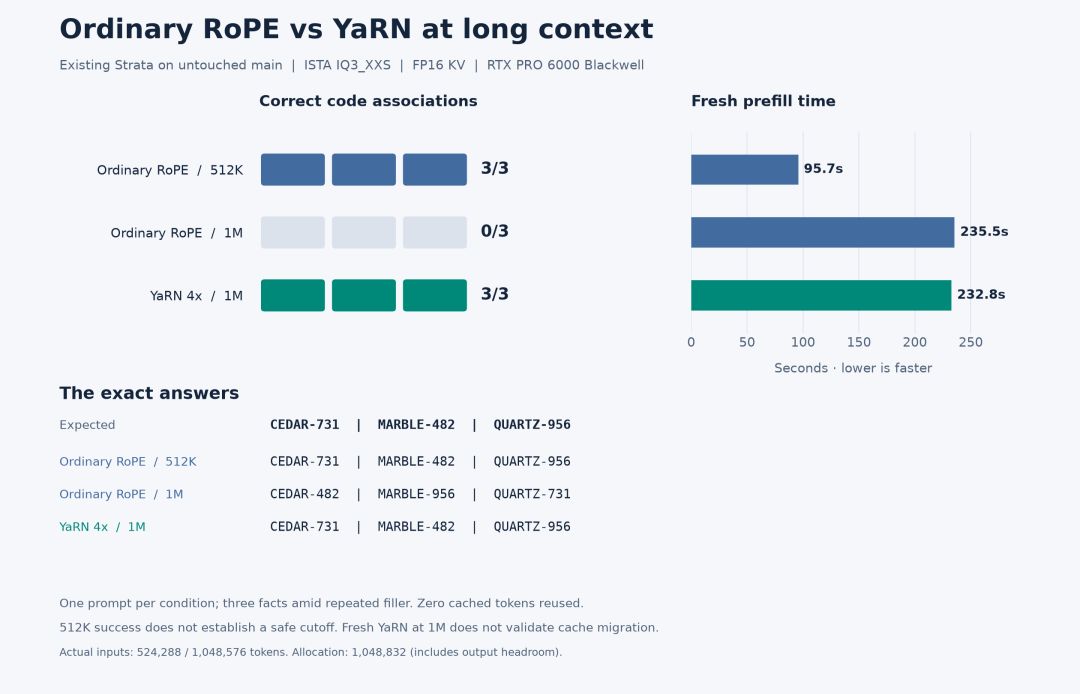
上下文这笔账必须算:小红书那篇被收藏最多的部署帖给过两个数——官方说 27B 量化文件 17GB 能跑,但那是没算系统占用和上下文缓存的,真实体验及格线是 24GB;上下文也别一上来拉满,从 32K 起步验证再往上加。 Strata 官方发布的 512K 与 1M 长上下文对照实测里,不同 RoPE/YaRN 配置下 fresh prefill 耗时最高约 235 秒——拉满上下文的代价首先是翻倍的等待,模型质量也可能随之波动。小红书GitHub
至于买内存这件事,请把两种慢分开:内存/显存占满且硬盘灯狂闪,是容量不够,加内存有效;占用没满、速度照样爬不上去,那是带宽顶死,加多大内存都一样慢。连 Strata 0.2.2 的推荐档位都改成了"RAM+VRAM 合计再减 5GB 才是可用空间"——32G 内存加 16G 显存的机器,系统会直接劝你别贪 48G 档,否则就去读 SSD。 偏偏现在是内存涨价周期——AI 数据中心挤占消费级内存闪存产能,从 2025 年底吵到现在没停,Strata 评论区那句"好处:strata确实卸载内存优化好,坏处:你需要顶着内存涨价去买内存条"说得很实在。 所以顺序应该是:免费的动作(换引擎、调档位、管上下文)全部做完,确认是容量瓶颈,再考虑在涨价周期里上车。GitHub哔哩哔哩
五、接下来盯什么
这波"引擎月"还没到终局,节奏快得夸张:Strata 10月20日放出 0.2 测试版,加了图形界面、中文界面和模型推荐,内存与显存合计最低约 27.6GB 就能进门。 紧接着 0.2.1、0.2.2 又连续跟进——Gyro-S/M 低比特专家量化开始在 Intel Arc 和 Mac 上跑、RX 6000 老卡有了专属引擎包、每张显卡可分配 Main/Helper/Off 三种角色(8G 以下默认 Off),速度口径也统一了。哔哩哔哩GitHub
值得留的继续观察信号:Flash-Next 被普遍视为月底 Qwen4 架构的前身,知乎的趋势日报里已经在传"Qwen 将推性能对标 Opus5 且可本地运行"的模型——目前还是传闻,没有官宣。 Mac 阵营除了 Uzu,oMLX 也在 10月21日发了 0.7.1.dev2 开发版把 Qwen3.8 系列接进 MLX 生态。 Uzu 的 92 t/s 仍是单模型单机器特定条件下的数字,还没等到第三方全模型矩阵复测;量化生态里 Unsloth、GSQ、Swift 几个分支的口径混战才刚开始;27B 这边,社区已自发贡献约 500 个量化版本、开源两天下载破百万,NVIDIA、AMD、平头哥、摩尔线程等芯片厂全部跟进适配。 "人人能跑"之后,"跑得快还不降智"的军备竞赛才刚开场。在这轮终局落定前,用上面那张表把现有机器榨到位,是当下性价比最高的一步。知乎小红书36氪
你现在的机器卡在哪一档速度?哪个量化版本翻过死循环?评论区贴一下配置和数字,给下一个人少踩一步。