两家AI公司接连开源"印钞机":秘方公开了,你还开不起饭店
这几天AI圈挺热闹。10月20日,DeepSeek把生产环境真在用的推理框架DeepInfer开源了;10月22日,创业团队StartLux(原点星辉)跟上,放出了号称首款专门面向"决策模型"的开源推理引擎Prism。两家接连把自家闷声赚钱的系统摆上桌,网友给这层东西起了个外号——印钞机。知乎36氪
但想用上这台印钞机,你得先知道推理引擎到底是个啥。
模型是菜谱,推理引擎是后厨的排班表。跟大模型聊一次天,其实是两件事:先把问题读一遍(Prefill,算力活),再一个字一个字把答案吐出来(Decode,显存带宽活)。引擎的本事,就是让同一张显卡塞下更多并发、跑得更快。36氪
DeepSeek公开的参考架构把视觉编码、Prefill、Decode拆成三段各跑各的,解码段把专家权重摊到更多卡上少读几份,按官方性能曲线,131K长文场景每卡吞吐能多出约两成,都是实打实的后厨效率工程。知乎
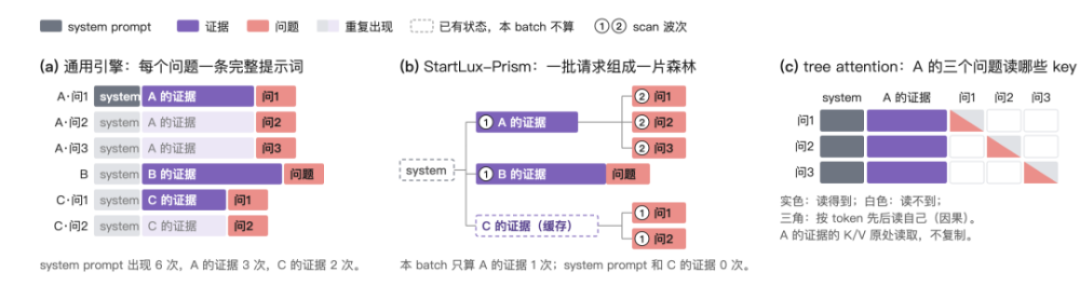
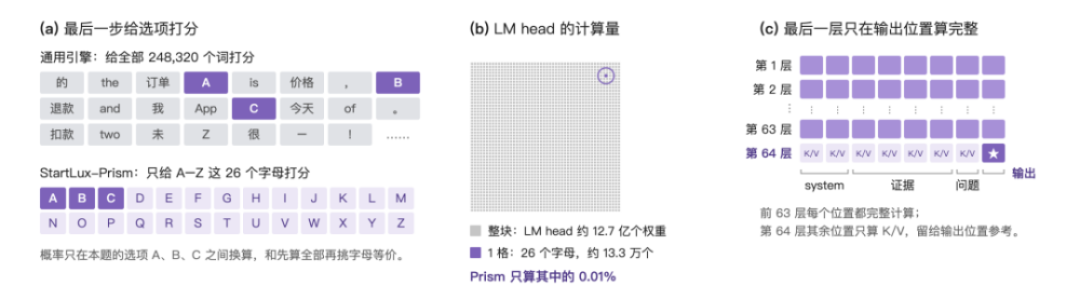
新玩家StartLux走的是另一条道。决策模型不聊天,只出结论:一张工单归哪个部门、风险几分、是不是欺诈。通用框架跑它有多浪费?27B模型每次要把24.8万个候选词全打一遍分,而决策选项只有26个英文字母——Prism把这段无效计算砍到原来的0.01%。同一份材料连问三题,通用框架是三场从零开始的重复劳动,Prism把公共材料当"树干"算一次、各问题只补"树枝"。知乎
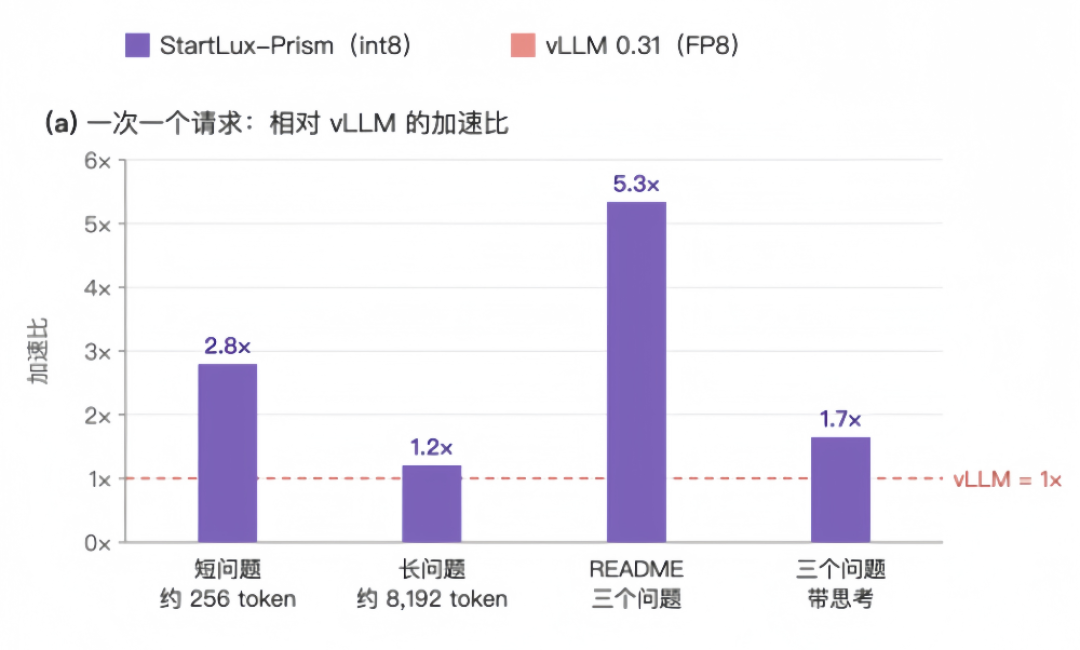
实测单张H200上,第一题快2.8倍,三题追问最快5.3倍;231题横评里Prism平均41毫秒排第一,用得最广的vLLM要112.7毫秒;日常高频轻负载下它每秒能处理100题,最快的竞品只有38题。知乎
听起来像白捡?B站高赞评论泼了盆冷水:"把秘方贴了出来,你只要开得起饭店你也能做生意——但前提是开得起饭店。"真不是抬杠:DeepInfer开源的只是引擎本身,部署编排、KV存储、跨副本负载均衡都没放出来。硬件这关更硬,云端训练和推理吞掉存储产能,部分DDR5内存价格从2025年中到现在涨了近10倍,显卡仍是入场券。对普通人来说,更现实的受益姿势可能是等第三方API把降下来的成本卷进价格里,而不是连夜去蹲显卡。哔哩哔哩知乎知乎
这轮开源潮真正的信号只有一个:大模型的胜负手正在从"谁的模型强"挪到"谁的推理省",而推理层从黑箱变成了公共课本。秘方已经贴上墙,能不能、该不该开饭店——这道题,现在连硬件账单一起交到了你手里。知乎