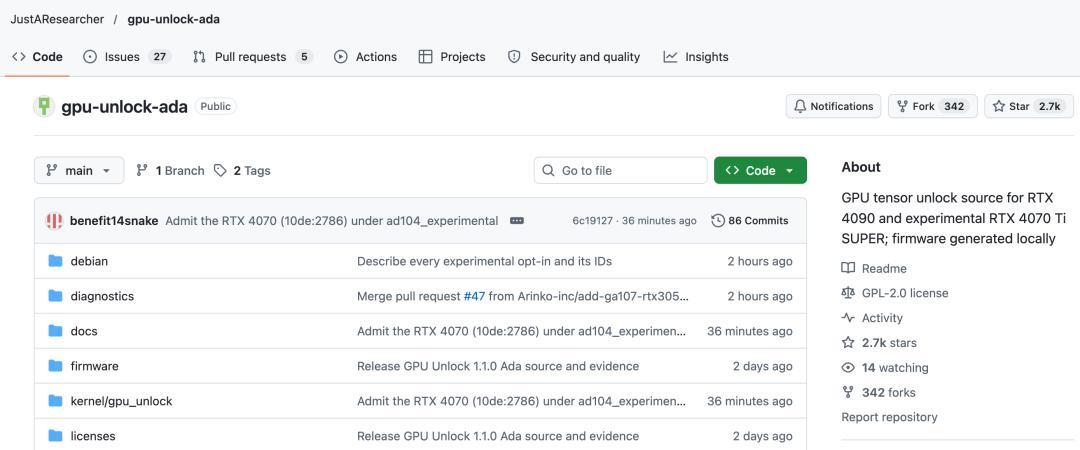
这两天,装机群和AI本地部署圈都在转同一件事:英伟达给显卡藏的那部分算力,被开源项目解了。不用换硬件、不刷BIOS、不超频、官方驱动照常跑,RTX 4090的TensorCore吞吐直接翻倍。GitHub项目两天攒下2.7k star,B站实测视频7.3万播放、747条评论区吵翻天。36氪哔哩哔哩
对本地部署玩家来说,这消息的诱惑力拉满——但先别动手,看完这三组数字。
第一组:「翻倍」翻的是什么。
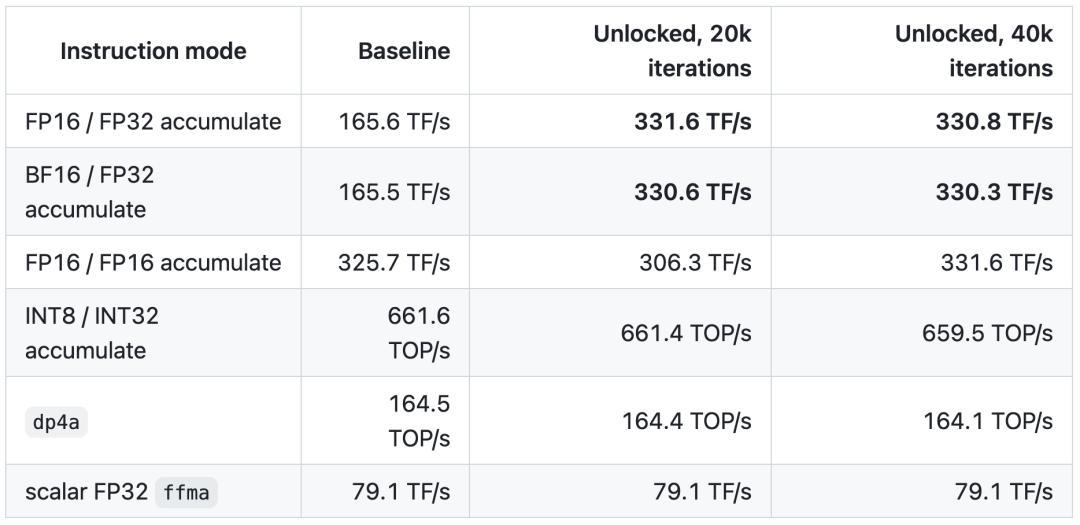
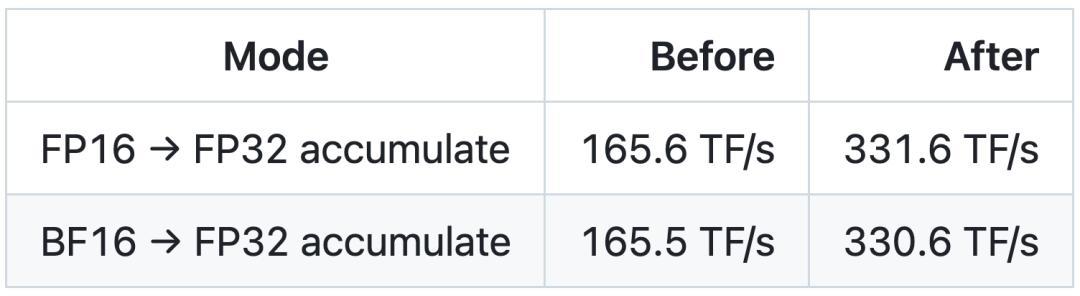
4090在FP16输入、FP32累加的特定TensorCore运算里,吞吐从165.6飙到331.6 TFLOPS,BF16同样翻倍。另一位卡主用同一张卡独立复测,160.4→320.4,基本坐实。30系更猛:3090Ti BF16提升80%、TF32提升94%,3080、3070、3060也报了70%到80%的提升,连8年前的2080Ti都被turing-unlock挖出64%~77%的实测涨幅。原理是开发者利用GPU启动阶段固件里的漏洞,在官方驱动接管显卡前,用内核模块改掉控制指令发射速率的寄存器——相当于把「干一拍歇一拍」的限速开关拨成了连续档。小红书36氪微博
第二组:实验室翻倍,不等于你的机器翻倍。
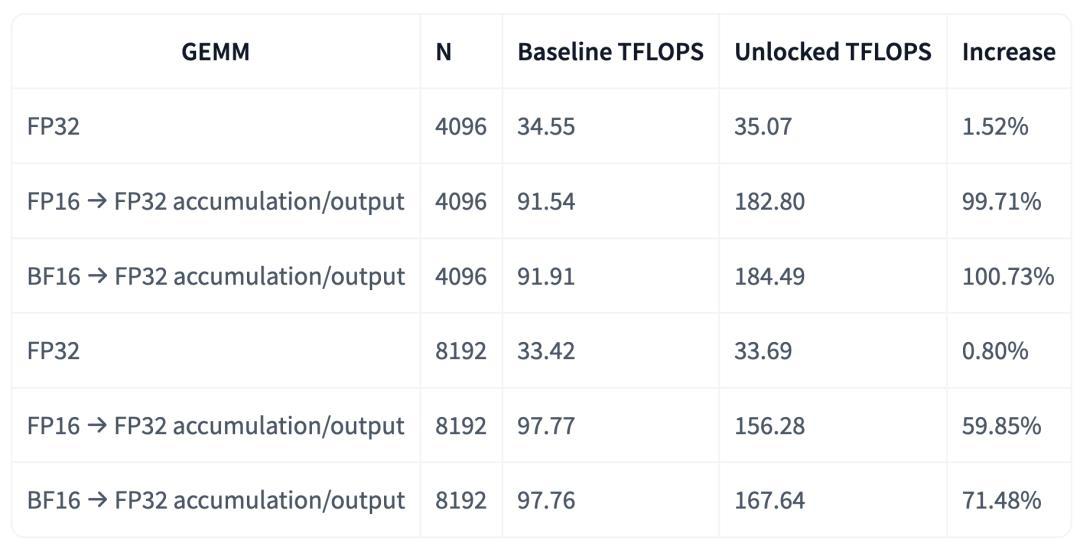
换成真实的矩阵乘法(cuBLAS),4090只涨12%~34%,BF16某些规模几乎没动。有人用vLLM跑27B BF16模型,预填充快了33%、首Token响应缩短24%,但逐Token生成速度基本没变——因为生成阶段卡的是显存带宽,这个补丁解不了带宽。评论区738赞的最高赞总结得很干脆:只有ComfyUI的FP16工作流能吃到10%~15%,其它模型几乎没提升,还得是Linux原生,虚拟机都不认。也就是说,天天用llama.cpp、Ollama跑Q4量化GGUF的大多数本地玩家,这次完全陪跑。36氪小红书微博哔哩哔哩
第三组:谁该上,谁该等。
受益的是手里已有30系/4090、跑BF16/FP16全精度推理、ComfyUI生图或训练的人——对你们这是白捡的升级。风险面也得摆上桌:社区已有人报「炸了4张4090」。Windows方案还停在实验阶段,那份接近翻倍的4080数据出自一块改到32G显存的特例卡,别往自己普通卡上套。主力机用户,建议等稳定版。哔哩哔哩36氪
最后提醒一句双11前最现实的:这消息一出,二手市场30/40系老卡已经开始抬价,有人喊「现在别买,等理性估值回来再说」。记住,解锁的是算力吞吐,解不了的是显存容量和带宽——那才是本地跑模型的天花板。别为一张补丁追高价收卡,更别为它专门装机;老卡在手,让勇士先趟,趟稳了再吃肉,不亏。哔哩哔哩