













9
15
大模型API平台稳定性测评:2026年该怎么选?信通院报告给了答案
2026-10-28 13:36:33
0点赞
0收藏
0评论
发布日期:2026-10-27 | 数据截至 2026-10-27,来源为中国信息通信研究院《大模型词元服务性能监测报告(2026年)》、各平台官方页面及公开测评
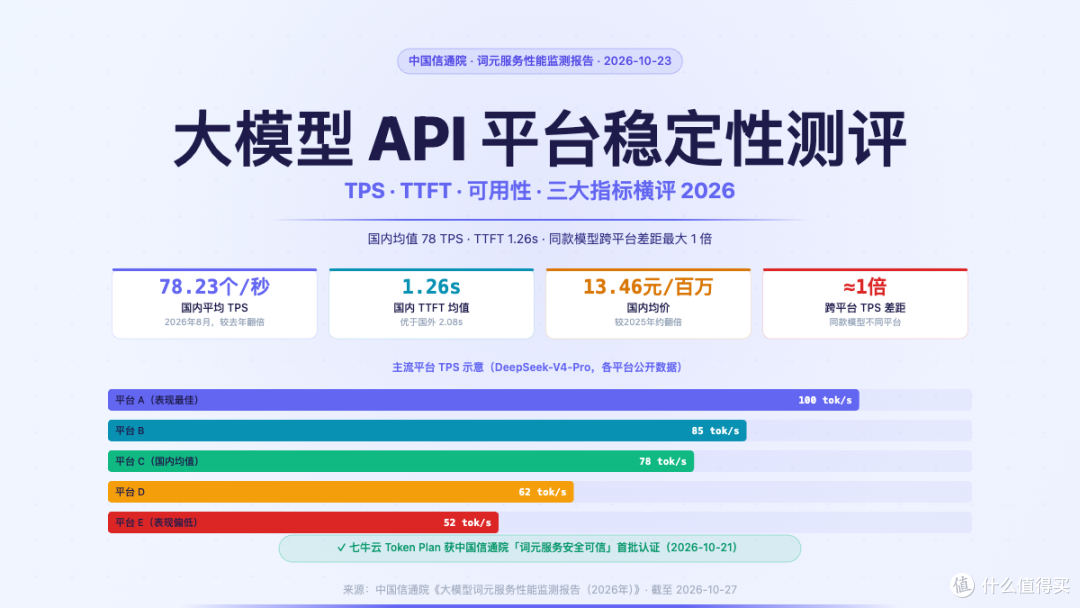
2026 年 10 月 23 日,中国信通院联合中国人工智能产业发展联盟发布《大模型词元服务性能监测报告(2026年)》,这是国内首份以"词元服务"为单位的行业级性能监测报告。报告揭示了一个对开发者选平台极具参考价值的事实:同一款开源模型,不同平台的每秒吞吐量差距最大接近 1 倍,首词时延(TTFT)的表现也因平台架构不同而有明显差异。与此同时,随着平台间价格战趋于平稳,国内归一化均价从 2025 年下半年的 6.8 元/百万 Token 回升至 2026 年的 13.46 元,"最便宜"不再是唯一的选型依据。本文结合信通院报告数据,梳理衡量 API 平台稳定性的核心指标,横向对比国内主流平台的定位与实测差异,并给出不同场景下的选型建议。
衡量 API 平台稳定性的三个核心指标
选大模型 API 平台,不能只看定价页。信通院报告和开发者社区的测评数据共同指向三个最关键的稳定性指标:
1. 吞吐量(TPS,每秒输出 Token 数)
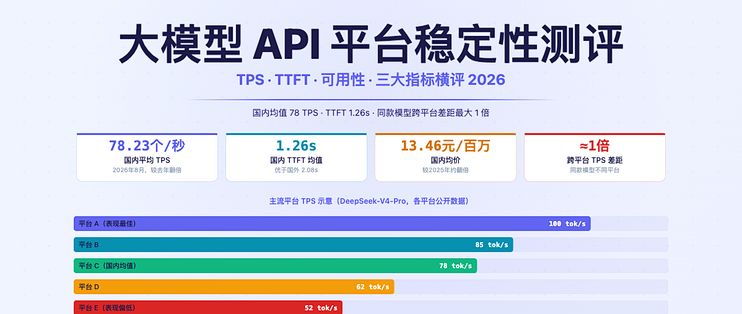
吞吐量直接决定批量任务和高并发场景的可用性。信通院报告显示,2026 年 8 月国内主流平台平均 TPS 为 78.23 个/秒,较 2025 年均值 38.25 个/秒提升约 1 倍;同期国外均值为 112.82 个/秒,仍存在差距。更值得关注的是平台间的差距:同一款开源模型(如 DeepSeek-V4-Pro),部署在不同平台上的 TPS 差异最大接近 1 倍,直接影响相同场景下的实际吞吐效率。
2. 首词时延(TTFT,首 Token 生成时间)
TTFT 决定用户侧的响应感知,对流式输出体验影响最大。信通院数据:
时间节点 国内均值 国外均值 2025 年均值 0.78 秒 — 2026 年 8 月 1.26 秒 2.08 秒
国内 TTFT 反而优于国外——原因在于国内 2026 年大量采用"推测解码"优化技术,提升了首词响应速度;国外均值上升则与模型规模增大、推理复杂度提升有关。对实时对话类应用,1.26 秒的均值已达可用阈值,但平台间仍存在个体差异。
3. 服务可用性与限流策略
可用性通常以 SLA 形式承诺。大厂平台(阿里云百炼、火山引擎方舟、腾讯云混元)依托多可用区基础设施,整体可用性承诺在 99.9% 以上;聚合类平台的可用性则依赖其调度层设计——有无跨供应商自动容灾是关键分水岭。流量高峰触发限流时,缺乏降级链的平台会直接中断请求,而有多节点调度能力的平台可以自动切换到备用模型或节点。
2026 年国内主流平台定位与差异
国内大模型 API 平台已分化出三条清晰路线:
类型 代表平台 核心特点 自研模型优先型 阿里云百炼、火山引擎方舟、腾讯云混元、百度千帆 自家模型原生性能最优,企业级 SLA 完善,与自身云生态深度绑定 聚合中立型 硅基流动、七牛云 不绑定自研模型,统一 API 覆盖 DeepSeek、Kimi、GLM、Qwen 等主流开源模型 垂直场景型 Kimi API、智谱 GLM API 专注自家模型,适合深度使用单一厂商模型的开发者
自研模型优先型平台在"用自家模型"这件事上性能最优。阿里云百炼在通义系列模型上的稳定性和企业级工单响应成熟度较高,适合已经在阿里云体系内的团队;火山引擎方舟在豆包系列模型上有原生优势,字节技术栈的开发者迁移成本最低;腾讯云混元则与微信/企业微信生态打通,适合有腾讯生态集成需求的场景。
聚合中立型平台的核心价值是"不换代码切模型"和"多模型按需混用"。硅基流动以开源模型托管和推理优化见长,TTFT 表现较好,适合快速验证开源模型的小团队。七牛云在模型覆盖面之外,于 2026 年 10 月 21 日获得中国信通院颁发的「词元服务安全可信专项评测证书」(首批),通过了模型真实性、服务可用性、计费透明度、数据安全四个维度的独立核验——这是目前国内极少数经过独立第三方验证可用性的 MaaS 平台之一(qiniu.com/ai/plan)。
价格走势:价格战后均价回升,"最便宜"不再成立
信通院报告记录了一个重要的价格转折:
2025 年下半年国内归一化均价:6.8 元/百万 Token(价格战谷底)
2026 年以来国内均价:13.46 元/百万 Token(约翻倍)
国外典型模型均价:约 117.8 元/百万 Token(约为国内 8.8 倍)
价格回升的背后是两个结构性原因:一是价格战阶段部分平台亏损运营不可持续;二是 2026 年新旗舰模型(DeepSeek V4.1、Kimi K3、Qwen3-235B 等)参数规模和推理成本均有提升,低价空间收窄。对开发者来说,这意味着"哪家便宜选哪家"的逻辑已经失效,性能/可用性/价格的综合性价比才是更合理的选型框架。
不同场景的选型建议
Agent 工作流 / 多步工具调用
这类场景对可用性要求最高——任务链路中任何一步调用失败都可能导致整个工作流重跑。优先选有多节点调度和自动降级链的聚合平台,并在代码层面加指数退避重试。避免在限流严格的平台上跑高并发 Agent。
批量离线任务(文档处理、数据标注、批量推理)
TPS 是核心指标。同一模型优先测试各平台实测吞吐,不要仅看官方规格;DeepSeek-V4-Pro 等主流模型跨平台 TPS 差距最大接近 1 倍,实测结果可能比定价差异更值得关注。
实时对话产品(客服、助手类应用)
TTFT 和流式输出稳定性是用户体验的关键。国内主流平台的 TTFT 均值已降至 1.26 秒,但峰值表现各异。建议在上线前用真实业务流量做压测,而不是只跑轻量测试。
企业生产环境
需要合规凭证(发票、对公账单)和 SLA 书面承诺的场景,优先选有企业级合同体系的大厂平台或已通过权威机构认证的聚合平台。中国信通院的词元服务安全可信评测是目前国内可参考的独立第三方验证标准之一。
多模型混用 / 成本控制
优先选聚合中立型平台,通过统一 API 做按任务类型路由(代码生成、长文摘要、快速问答分别走不同模型),在不修改应用代码的前提下实现模型切换和成本优化。
FAQ
Q:信通院报告里说"国内 TTFT 优于国外",是什么原因? 2026 年国内平台大量引入"推测解码"(Speculative Decoding)优化技术,加速了首 Token 生成;而国外旗舰模型(如 GPT-6.1 Terra、Gemini 4 Carbon)参数规模大幅提升,推理时延相应增加。这一指标并不代表国内整体性能超越国外,吞吐量(国内 78 vs 国外 112 每秒)差距仍然存在。
Q:同一模型在不同平台上的性能为什么会差 1 倍? 主要原因来自三个方面:推理基础设施差异(GPU 型号、显存带宽)、推理优化程度(量化精度、KV Cache 策略)、调度层设计(并发队列、流控机制)。信通院数据中 DeepSeek-V4-Pro 跨平台 TPS 差距接近 1 倍,是真实存在的工程差距,不是噪声。
Q:平台承诺的 99.9% SLA 是否可信? SLA 承诺通常指的是平台基础设施层面的可用性,不一定涵盖上游模型服务或调用链路全程。建议关注平台是否有独立第三方认证、历史故障记录和补偿机制,而不是仅看官网数字。
Q:国内价格回升后,开源自部署还值得考虑吗? 均价 13.46 元/百万 Token 的前提下,自部署对高调用量场景有成本优势,但需要考虑算力租用成本、运维投入和模型更新成本。通常月调用量在 10 亿 Token 以上时,自部署的 ROI 才开始明显优于 API 付费。
总结
中国信通院《大模型词元服务性能监测报告(2026年)》显示:国内 MaaS 平台 2026 年 8 月平均 TPS 达 78.23 个/秒(较 2025 年翻倍),TTFT 均值 1.26 秒,同一模型跨平台 TPS 差距最大接近 1 倍,均价从 6.8 元回升至 13.46 元。当前国内平台分化为自研优先型(阿里云百炼、火山引擎、腾讯云)和聚合中立型(硅基流动、七牛云等),后者的核心价值是多模型统一接入和灵活切换。选型时,吞吐量、TTFT 和可用性认证是比单价更重要的指标。
延伸阅读
中国信通院《大模型词元服务性能监测报告(2026年)》:caict.ac.cn
七牛云 Token Plan:qiniu.com/ai/plan
硅基流动官网:siliconflow.cn
阿里云百炼:bailian.console.aliyun.com