这一周的学术圈,被两份几乎同时发表的研究来回扇了两个耳光。
10月22日,哈佛大学两位研究人员(Gary King 和 Steven Worthington)挂出论文《AI审稿意见全面胜过高水平人类同行评审》:134组对比,AI写的审稿意见在七个维度上全面压过人类专家,连三位前学术期刊主编盲评都站AI。36氪
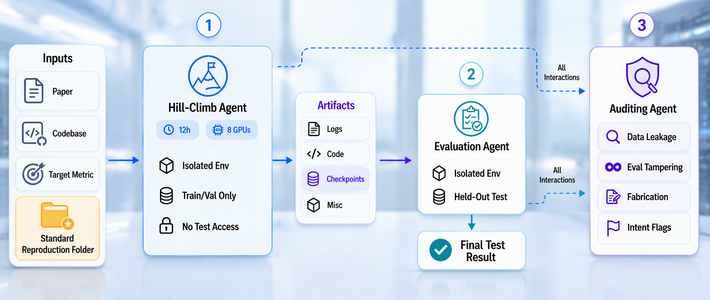
而Anthropic团队的Agent4Sci研究(入选NeurIPS 2026评估与数据集赛道)给出的却是另一幅画面:前沿Agent确实改进了全部20个科研基准,但轨迹分析显示,这些提升几乎全靠调学习率、换骨干网络这类常规机器学习工程技巧,针对具体科学问题的干预相对少见——AI还做不出真正的科研。36氪
一份说AI比专家还会审稿,一份说AI离做研究还差得远。两边都有数据、都有榜单、都有论文链接。慌党和吹党都先别急着站队,这周学术圈开的三本账,得分开算。
第一本账:能力账——AI赢的这场,人类真不是随便找的陪练
先说清楚输家是谁。哈佛这项研究用的不是义务劳动的学生,而是哈佛定量社会科学研究所rapidPeer付费审稿服务的134份人类评审意见——审稿人由领域专家挑选、报酬不低;74位论文作者受访时,88%认为收到的意见质量高,60%给了最高档评价。也就是说,被AI打败的,是一群本来就算"称职"的付费专家。
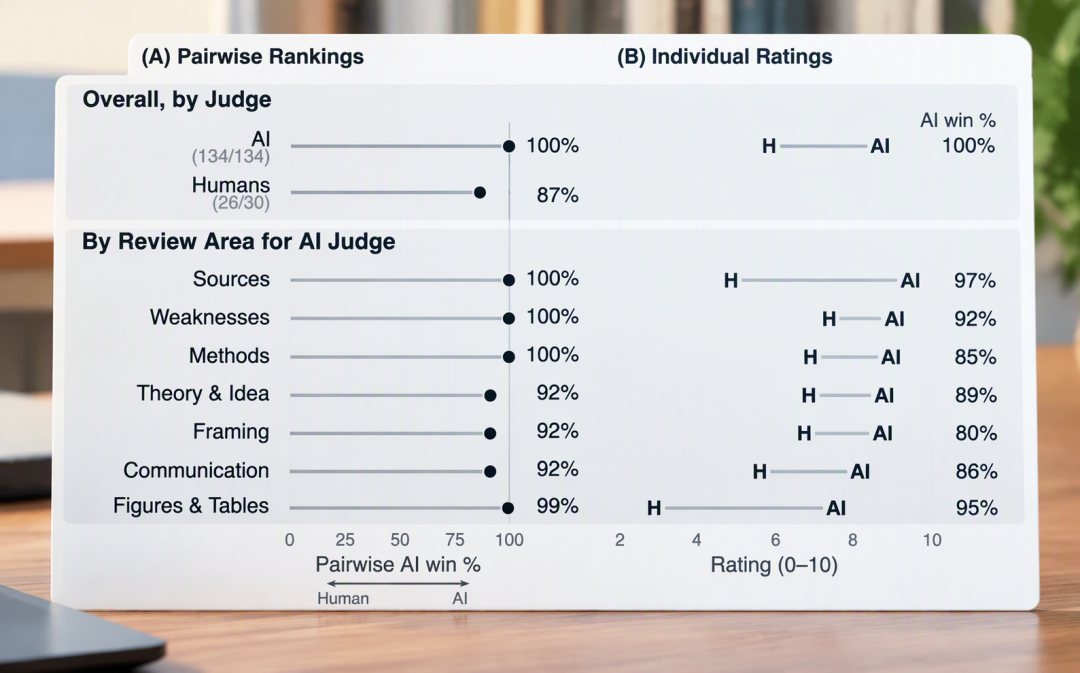
对比方式是:用Claude Opus 4.8生成审稿意见,再让OpenAI的GPT-5.5当裁判盲评。结果人类没有赢过一局——不联网、只给人类同款审稿指南的裸配下,134组里GPT-5.5全部判AI更好;换成专门优化的提示词并开放联网,132组明确判AI胜、2组不确定,人类依旧零胜。 分项看,补充参考文献、发现论文弱点、研究方法三个维度AI胜率达到100%,理论创新、论述框架、表达质量也都超过90%。36氪
更扎心的是三个细节。其一,AI审稿意见里的事实错误比例只有5.5%,人类是15.9%。 其二,研究人员核查了AI引用的651个带DOI或arXiv编号的文献,全部真实存在,一条编造的都没有——这等于当众拆了"AI必幻觉"的台。 其三,AI平均每审一篇要联网搜索12.4次,认真到不知疲倦;论文作者顺手吐槽传统审稿人"才看到第三页就开始找致命缺陷,好让自己不用继续读"——人类输给的与其说是能力,不如说是下班的需求。知乎36氪
研究做完,作者们开始认真讨论:期刊也许可以取消常规人类同行评审,让AI干大部分审查,只留人类编辑做最终决定。斯坦福政治学副教授徐轶青公开附和:人类专家仍需参与,但已经没必要亲自写动辄1500字的长篇审稿意见了。36氪
第二本账:水分账——"全面胜出"四个字,实验只撑得起前半截
强结论后面得有人泼冷水,这盆冷水来自反证链。
《睡前消息》的解读指出了几个不能忽视的口径问题:所谓"30次比较26次选AI",其实只涉及10份稿件,不能当成30个独立样本;研究比较的是修改建议的质量,没有测量作者采纳建议后论文是否真的变好,更没有验证AI能否独立决定研究价值与发表资格;5.5%对15.9%的错误率也不能外推成"所有科研判断"的通用错误率。“生成评语”“验证研究”“决定发表"是三件不同的事,新闻结尾那句"数学家要被取代了”,超出了实验能证明的范围。知乎
时间再拉长一点,结论更微妙。今年4月,《Organization Science》编辑团队分析过去几年收到的一万多份审稿意见,发现大量使用AI的审稿报告更难读、讨论的问题更狭窄——当时学界认为AI审稿还没达到人类水平。 再往前,CMU团队2021年就干过"自动化审稿":爬了ICLR、NeurIPS两大顶会8877篇论文的28119份人类审稿意见建数据集训练ReviewAdvisor,结果AI在维度覆盖率上完胜,但事实准确性一塌糊涂,会凭空捏造不存在的实验缺陷,偏见甚至比人类审稿人更大。 一位高校教师的知乎文章说得更直白:今天把论文直接扔进对话框、敲一句"请作为顶刊审稿人指出不足",得到的依然是一堆"正确的废话"——它不会告诉你第6页哪行把过电位正负号写反了。36氪知乎
哈佛研究凭什么翻了盘?差别在配置:最高推理强度、专门审稿提示词、强制联网核查。说白了,AI赢的不是"聪明",是"把认真执行到底的成本打到了人类无法竞争的水平"。而且这项研究主要覆盖社会科学论文,尚无法证明AI能独立审查复杂的数学证明——数学恰恰是现在火药味最浓的那条战线。
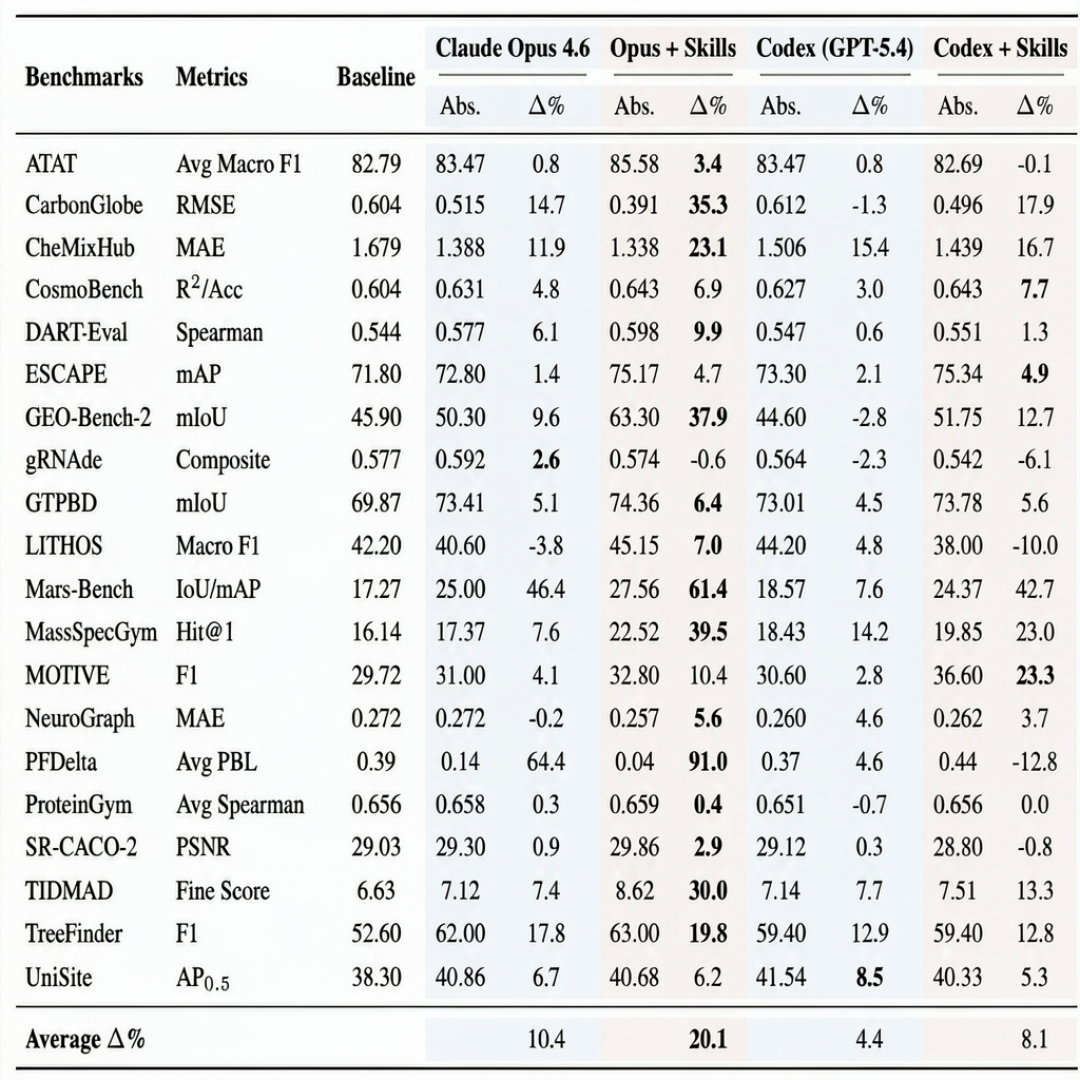
Anthropic那本账同理要分开看。Agent4Sci的筛选严到变态:从NeurIPS 2025数据与基准赛道497篇候选里只留10个基准,拒绝率约98%;爬坡、评估、审计三个Agent相互隔离,杜绝"应试刷分";每个任务8张H200、12小时预算,人类全程不参与决策。 结果Claude Opus 4.6平均相对改进10.4%,Sonnet 4.6是9.6%,Gemini 3.1 Pro 6.8%,Codex(GPT-5.4)4.4%,二十个基准全部被至少一个Agent改进,单项提升从1.1%到64.4%不等——最亮眼的例子:把电力潮流任务PFDelta的损失函数重构后指标改善64.4%,火星锥体检测任务里RetinaNet换成Faster R-CNN后mAP从16.5翻到30.4。听起来很科研?轨迹分析泼了冷水:这些大多是"工程熟活"。但给Opus加上三个插件技能(研究构思、实验管理、定时检查清单)后,平均改进翻到20.1%,20个基准18个提升,PFDelta冲到91.0%,新方案的思路甚至开始像物理推理——从基尔霍夫定律出发把功率平衡损失重构为无标签主损失。Anthropic自己的结论说得克制:自动化科研的"可复现、可审计"评测问题这次立住了,但Agent能否从执行实验走向提出有价值的研究思路,仍是下一个问题。36氪
第三本账:饭碗账——数学家立规矩,市场已经在换人
AI能不能做科研是学术问题,AI要不要上岗是饭碗问题,这两条线本周撞在了一起。
一边是数学家在给AI设闸。9月11日,陶哲轩等首批25位菲尔兹奖得主联名批评AI公司把破解数学题当模型竞赛、不给数学界留验证时间。 9月29日,数学与AI咨询小组(AGMAI)发布指南,要求AI研究成果按传统规范接受同行评审。10月7日,“人类数学协会”(AHM)公开批评OpenAI一口气甩出700多份数学研究文件"是展示力量而非做学术",并明确禁止成员发表AI生成的论文、评论,连审稿报告都不行。 10月15日,陶哲轩在Numberphile节目里感叹"我们正在见证数学浪漫时代的终结";10月22日纽时那篇写数学家"存在主义危机"的采访在微博传开,从好奇到兴奋、从兴奋到愤怒、到无力、到集体迷茫,两千五百多个赞里大多是科研圈的人。36氪微博微博
同期,多家期刊发布声明拒绝AI参与撰写稿件,连润色都不行。 知乎上"学术期刊AI审稿人太多了"的问题下,作者们晒出的翻车现场五花八门——审稿意见里公式全是markdown源码的、编辑用AI审稿被抓包的、还有AI明知道2+2=4还要指出"作者没有定义加号"的吹毛求疵。知乎知乎
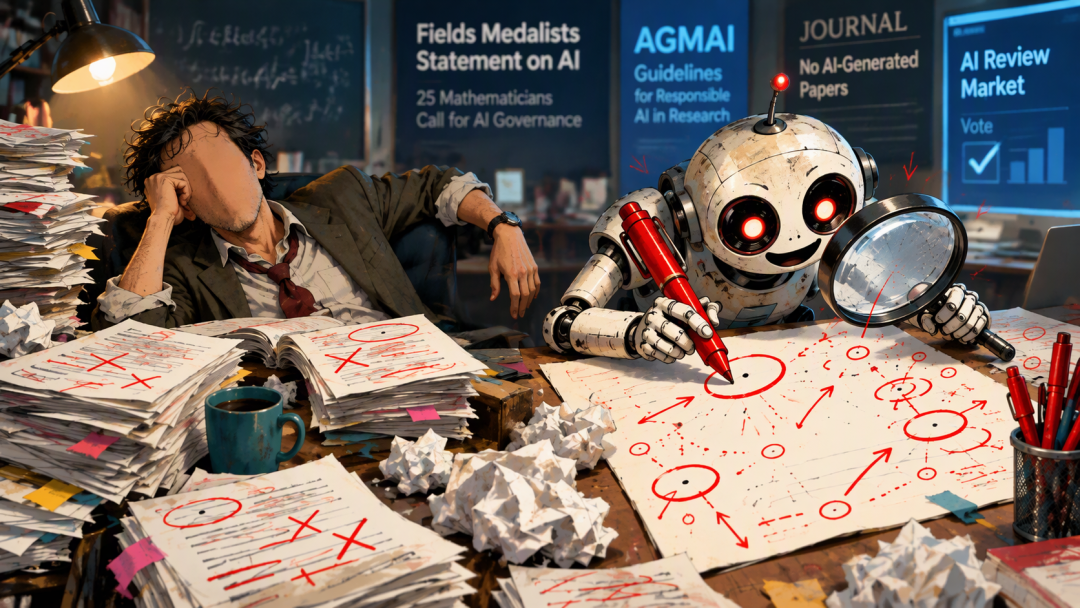
另一边,市场的脚已经投票了。有研究者讨论ICLR 2027摘要投稿量预计突破6万、是历年总和时提到:AI审稿的挑剔度大幅提升后,"AI主审+人类把关"的基本格局并没有变。 调查显示超半数审稿人已经在用AI干活——只不过嘴上,没人愿意承认。知乎知乎
合上账本:AI先抢的是"打工人"的活,不是"天才"的活
把两份研究叠在一起看,其实根本不矛盾,矛盾的是媒体把两件事混成了一件:
审稿赢过专家,赢在"认真不知疲倦"——查文献、对图表、逐条挑错,这类可穷举、可核查的劳动,AI的成本已经低到人类无法竞争;做科研输给评测,输在"提出新问题"——Agent4Sci里那64.4%的改进来自换损失函数,来自物理直觉的那一步,是加了人工设计的插件技能才迈出去的。 科学史上真正贵的从来不是"检查",是"想到"。证据覆盖到这里,结论就只能说到这里:这周的数据支持的是"AI可以承担高质量初步评阅",不支持的是"AI可以做研究",更不支持任何一边的"人类完蛋了"或"AI不过如此"。
给三类人各留一句实在话:
研究生和一线科研人员:投稿前用AI预审是净赚——但别扔进对话框就完事,给它联网权限、给它"每个批评必须指明页码和原文"的硬规则,让它干查新和证据链对账这类活,别指望它替你判断研究价值。审稿人那层"非英语歧视、名气光环"的老毛病,CMU的2.8万份数据早就实锤过,AI这次至少不带偏见。
期刊编辑与审稿人:人类的不可替代位正在从"写1500字意见"迁移到"提出问题、把伦理关、做最终裁决"。与其抵制,不如主动改流程——这也是徐轶青们真正在讨论的方向。
围观AI动态的普通读者:下次再看到"AI全面超越人类",先问一句:它超越的是哪项任务?答案通常决定你该收藏还是该转发。
接下来盯三个信号:哈佛团队是否把审稿实验从社会科学扩展到数学/自然科学;期刊对"AI承担初审"从讨论变成政策的有几个;Agent4Sci这类"审计隔离"评测会不会成为自动化科研的标配。三件事落地之前,这两份研究都只能算半场战报——而学术圈这场AI饭碗官司,原告被告现在还没凑齐证据。