








 深耕数码兴趣领域




5
7
Battlemage的最后拼图——蓝戟 GUNNIR Arc Pro B65 TF 32G 评测
2026-10-27 10:50:23
0点赞
3收藏
1评论
一、前言:补全锐炫Pro B系列的最后一块拼图
进入2026年,本地AI推理与AI内容创作对显存的胃口仍在变大,一个27B级稠密模型在8bit量化下就要吃掉约31GB显存,即使4bit量化,如果想开128K长度的上下文,那也差不多要这么多显存;一套14B级视频生成工作流也动辄需要30GB以上余量。在这样的需求面前,“显存够不够”往往比“算力快不快”更能决定一项工作能否在本地跑起来。
英特尔锐炫Pro B系列正是冲着这一需求来的。而这个系列的产品我们并不陌生。此前我们已先后完成Arc Pro B50、Arc Pro B60、Arc Pro B70三款产品的评测,还就B70在实际工作流中做过一轮深度体验,覆盖海量视频归档的AV1转码、本地大模型推理与ComfyUI出图。随着本次蓝戟GUNNIR Intel Arc Pro B65 TF 32G的到来,锐炫Pro B系列终于可以完整地摆在同一张桌子上。
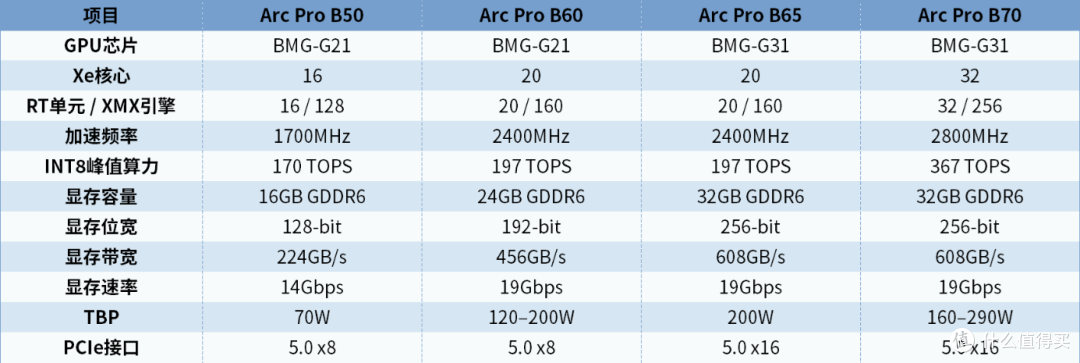
从显存方面来看四款Arc Pro B系列显卡共有三级显存台阶,B50是16GB/128-bit,B60是24GB / 192-bit,B65与B70则同为32GB / 256-bit。也就是说,在显存方面B65与B70完全一致,差别全部落在GPU规模上,所以说把32GB大显存的门槛,拉到了一个相对亲民的位置。
本次拿到的产品仍旧是来自蓝戟(GUNNIR),蓝戟是英特尔显卡在中国大陆的核心合作伙伴之一。品牌名GUNNIR源自北欧神话中的Gungnir,即主神奥丁那柄“永恒之枪”,品牌标识是一道蓝色闪电。从Alchemist到Battlemage架构,蓝戟始终专注Intel Arc显卡的研发与制造,其专业卡在售阵容已完全覆盖Intel Arc Pro系列。
二、外观与拆解:与旗舰同族的工业设计
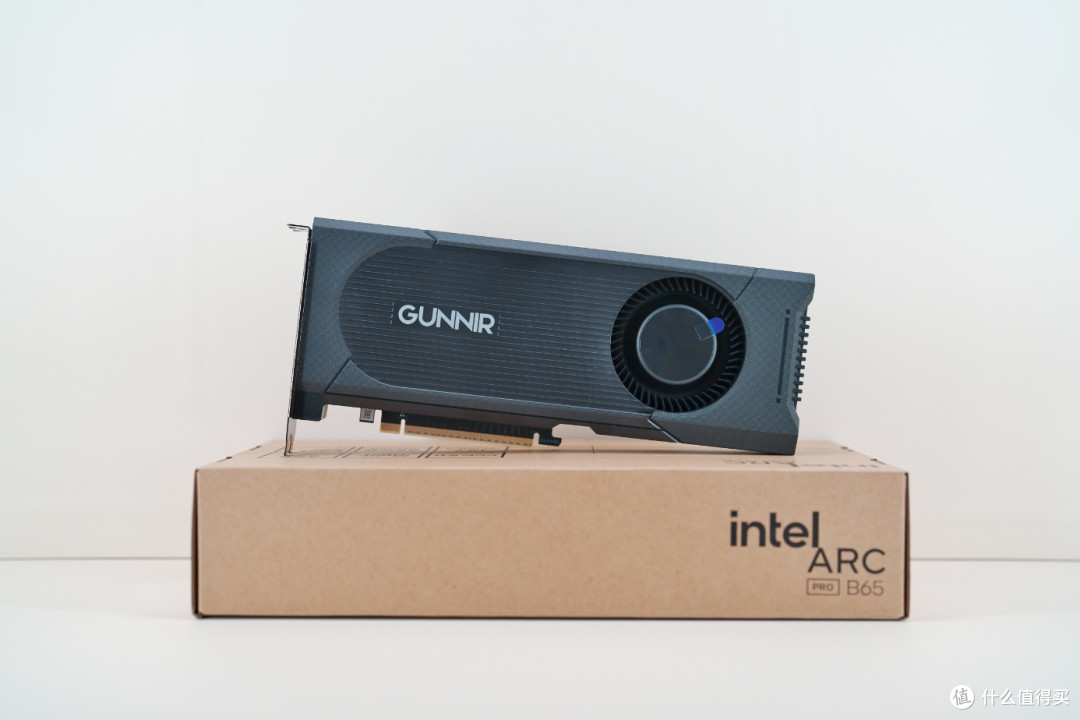
专业卡的“外观”通常没有太多故事可讲,特别是这次的蓝戟B65 TF与B70 TF长得实在太像了。
(一)外包装:环保牛皮纸,核心参数一目了然
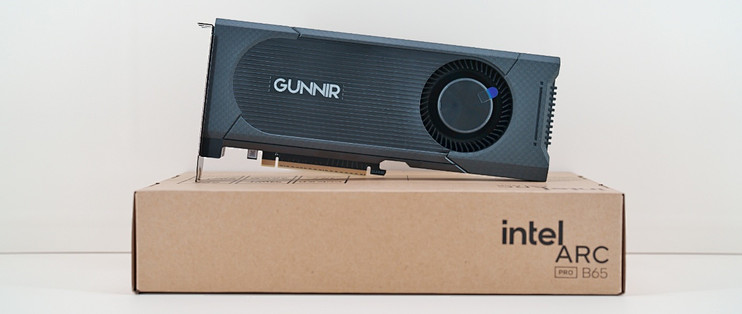
蓝戟B65 TF 32G延续系列一贯的简约牛皮纸环保包装,包装盒上直接印出重要特性:32GB GDDR6显存、608GB/s显存带宽、197 TOPS的INT8算力、 PCI-E 5.0接口、原生Linux系统支持与多GPU协同扩展。
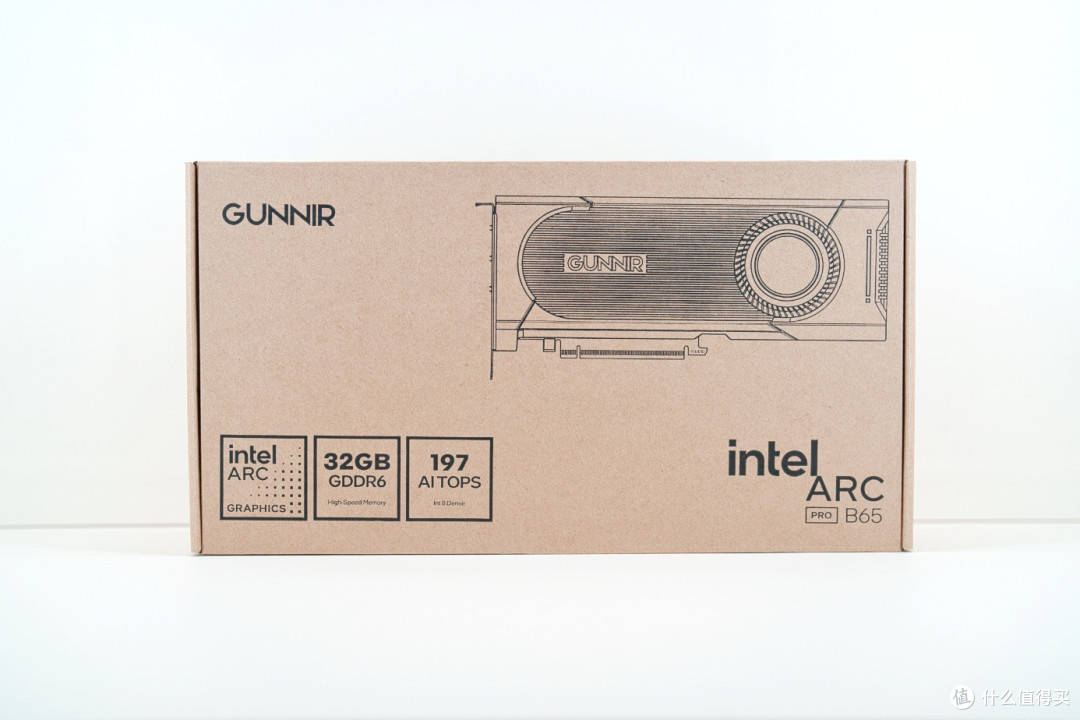
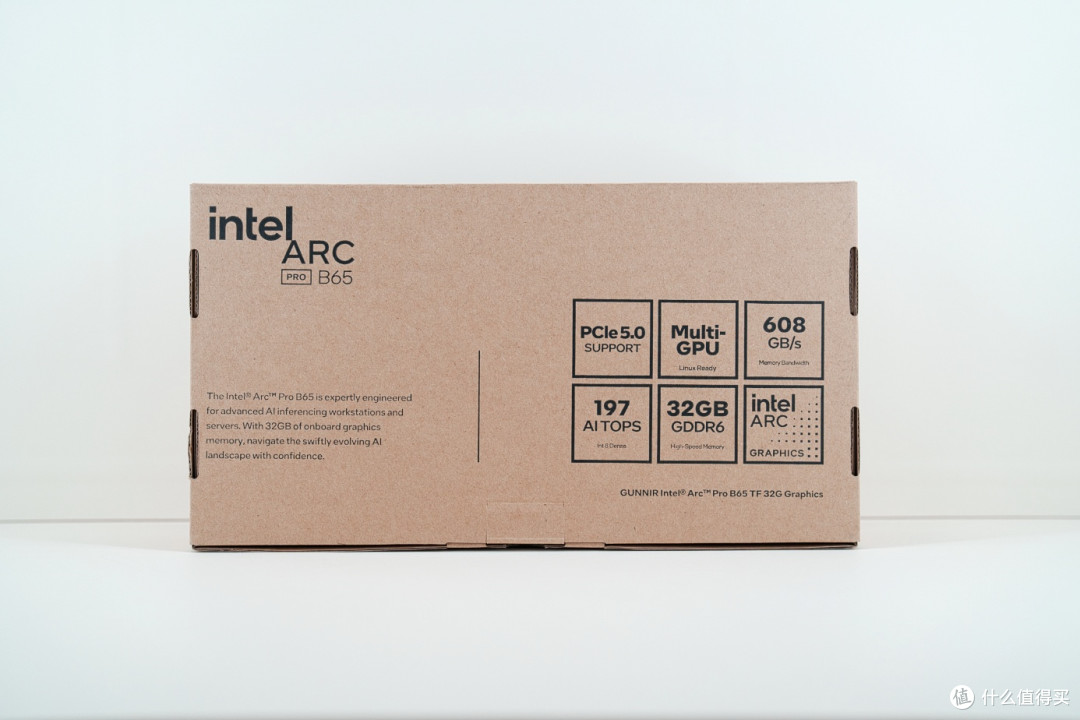
这几个特性勾勒出B65的完整人设:与大哥B70一模一样的显存配置,看齐旗舰;与三弟B60相当的算力,对齐主流。还是要再说明一下,这里的197 TOPS是INT8整数精度下的峰值算力,与NVIDIA Blackwell显卡标注的FP4浮点算力并非同一计量标准,并无法直接换算。
(二)外观设计:不看印字,几乎无法与B70区分
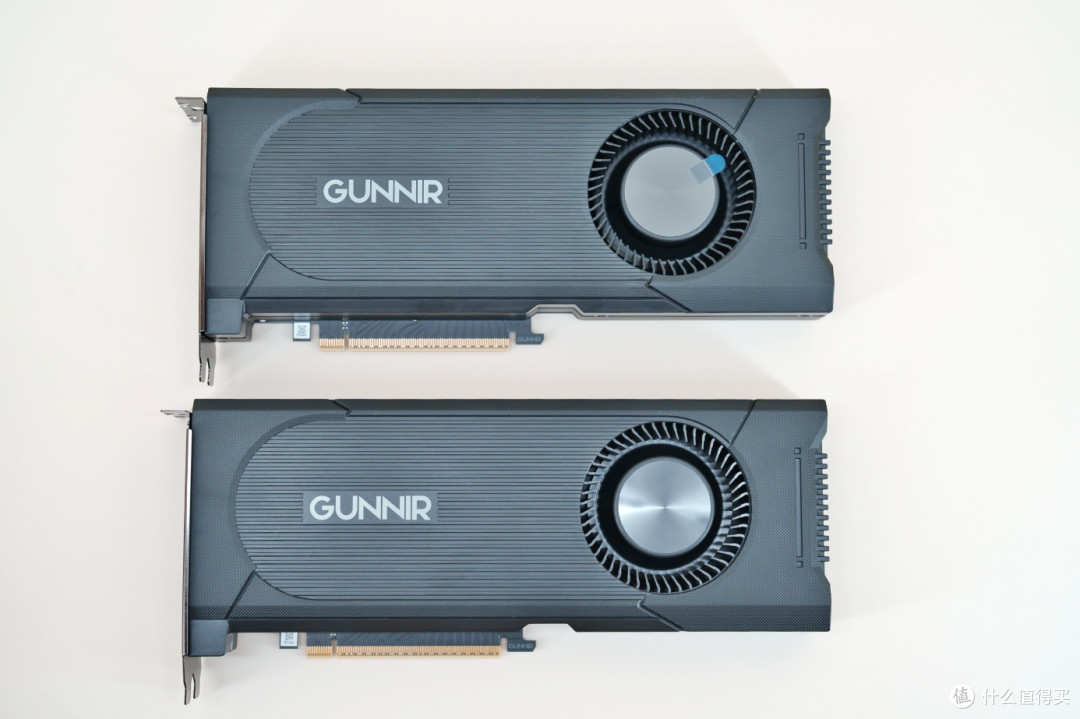
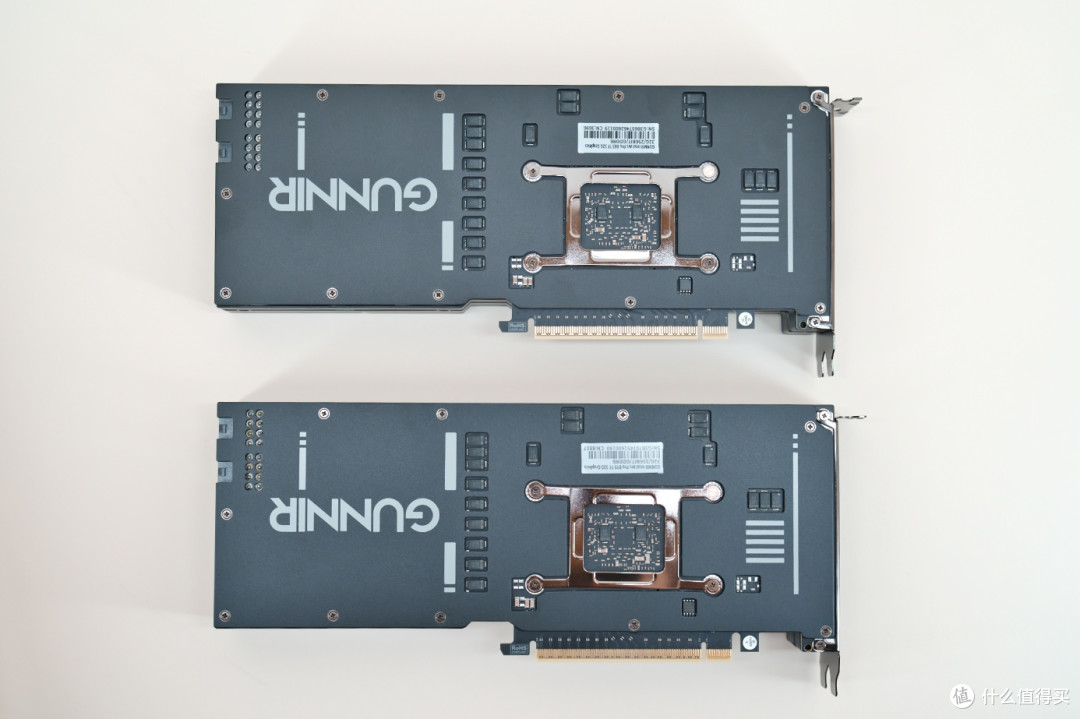
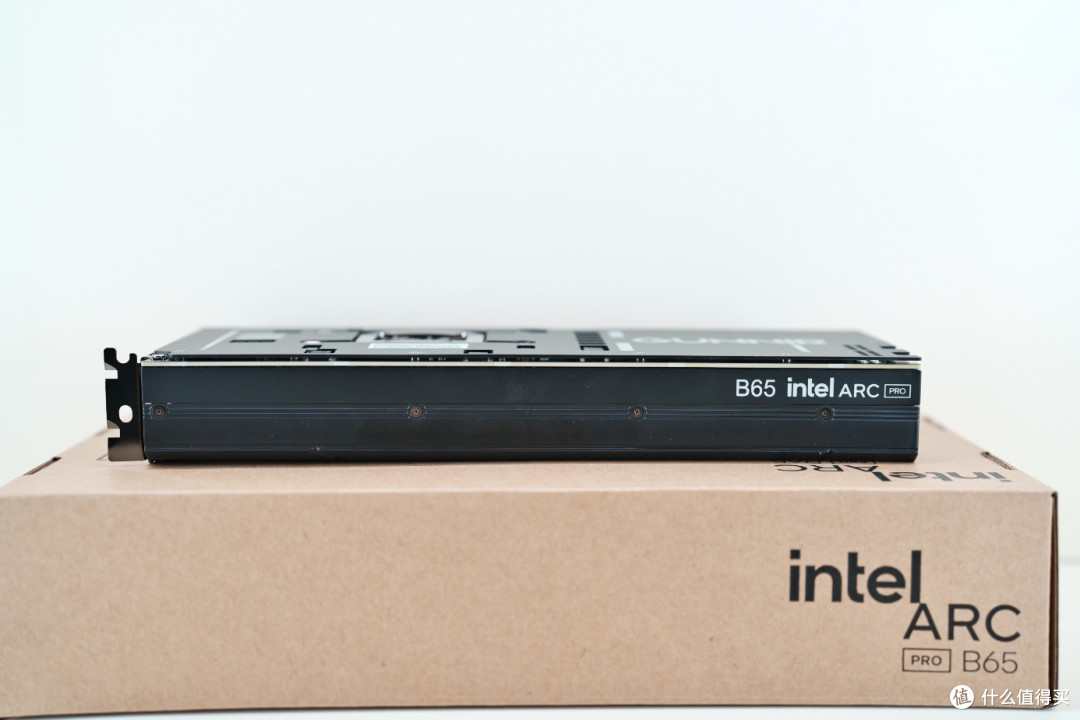
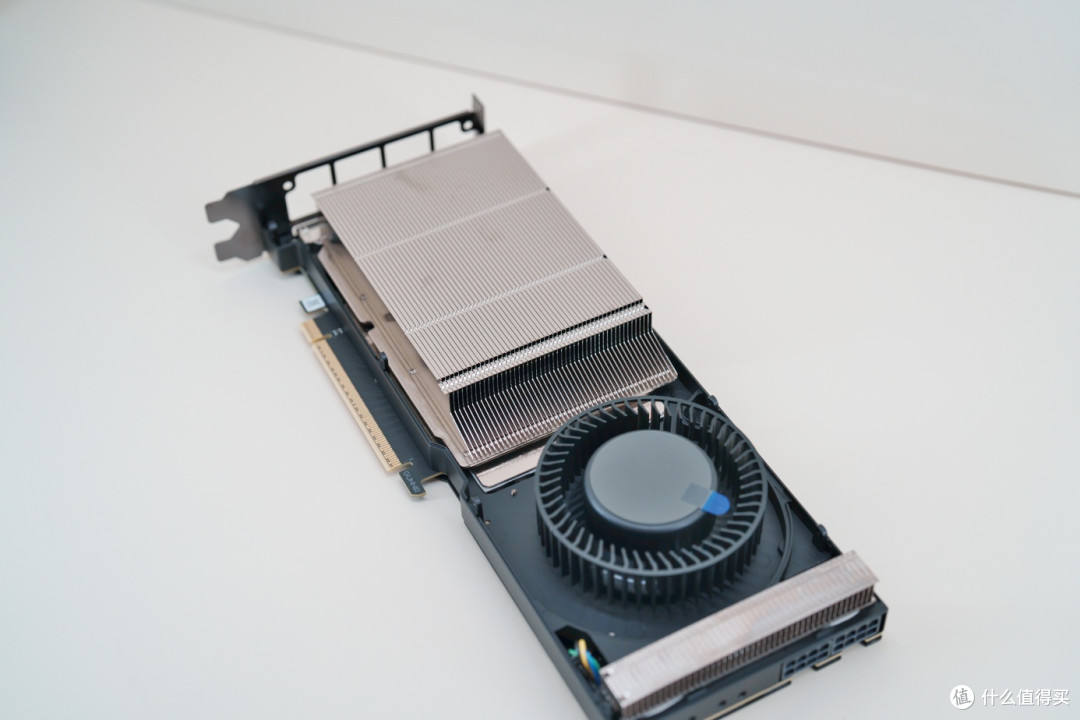
把B65与B70并排放在桌上,不看侧面型号印字,我几乎无法第一眼区分两者。两张卡都是通体纯黑、无灯效的标准双槽涡轮卡:上盖为塑料材质,表面布满细密锉刀状纹理;下方金属中框负责加固PCB并辅助供电与显存散热;正面与背板印有GUNNIR标识,侧面的型号印字则是两者唯一的视觉区分点。
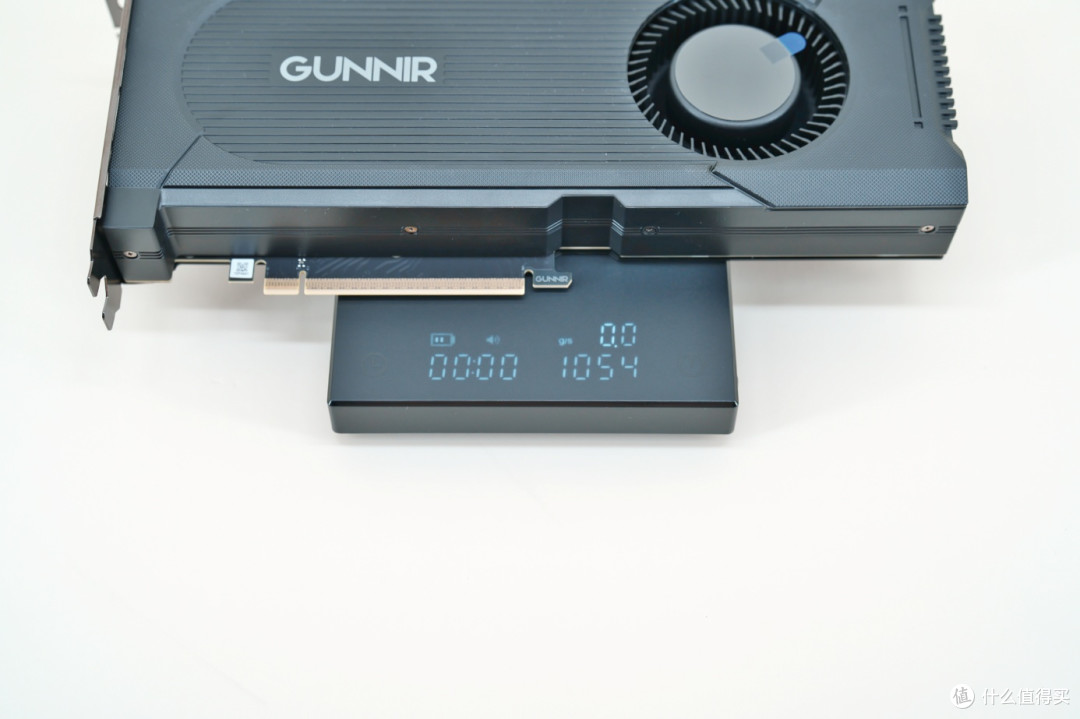
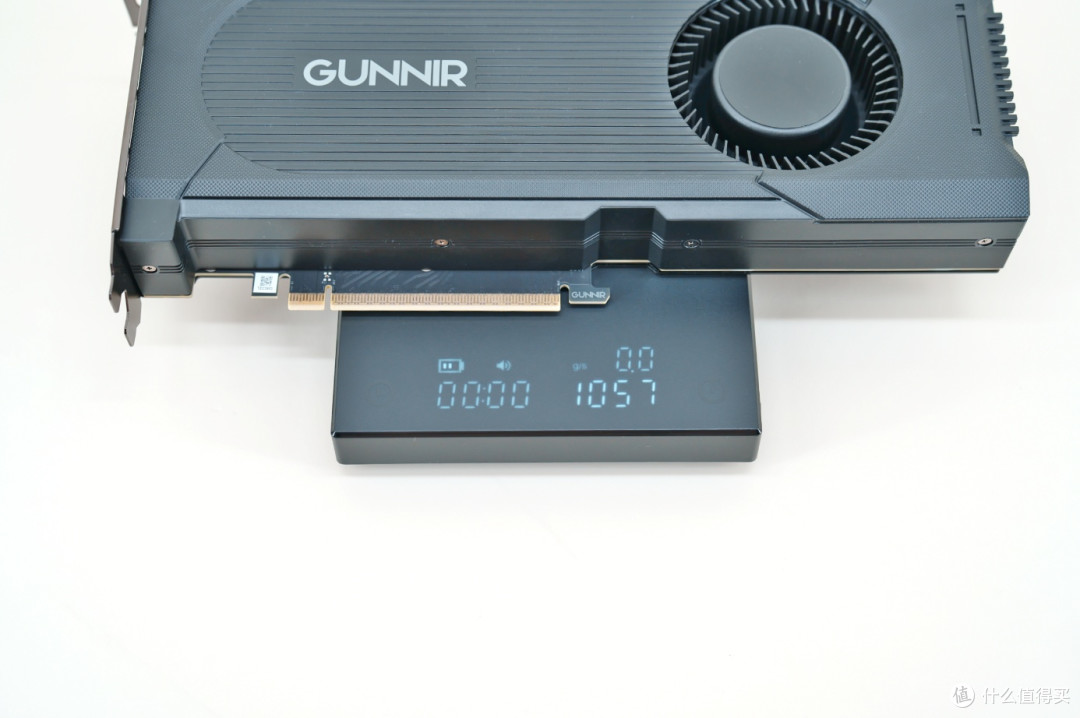
(三)称重对比:1054克与1057克,只差3克
为给上面的判断加一点可量化证据,我们把两张卡分别上了电子秤:蓝戟B70 TF 32G为1057克,蓝戟B65 TF 32G为1054克,仅相差3克。考虑到两块卡在散热模组、金属背板与外壳上的用料几乎一致,这个差值基本落在称量误差与装配公差范围内,从侧面印证两者共用同一套结构与散热方案。
(四)视频输出与供电:3×DP 2.1加1×HDMI 2.1,双8pin冗余
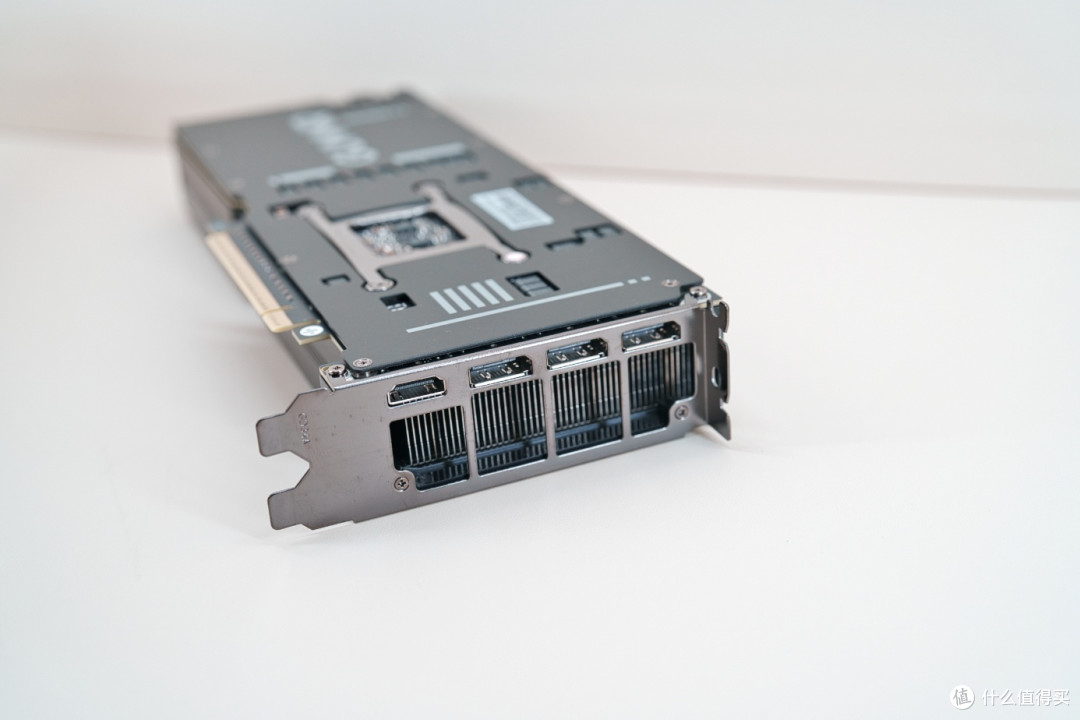
显示输出为1个HDMI 2.1加3个DisplayPort 2.1(1路DP为UHBR13.5、2路为UHBR10),HDMI与DP的最大分辨率均支持7680×4320@120Hz,最多同时点亮4路输出,对普通消费级显示器比纯DP方案更友好。
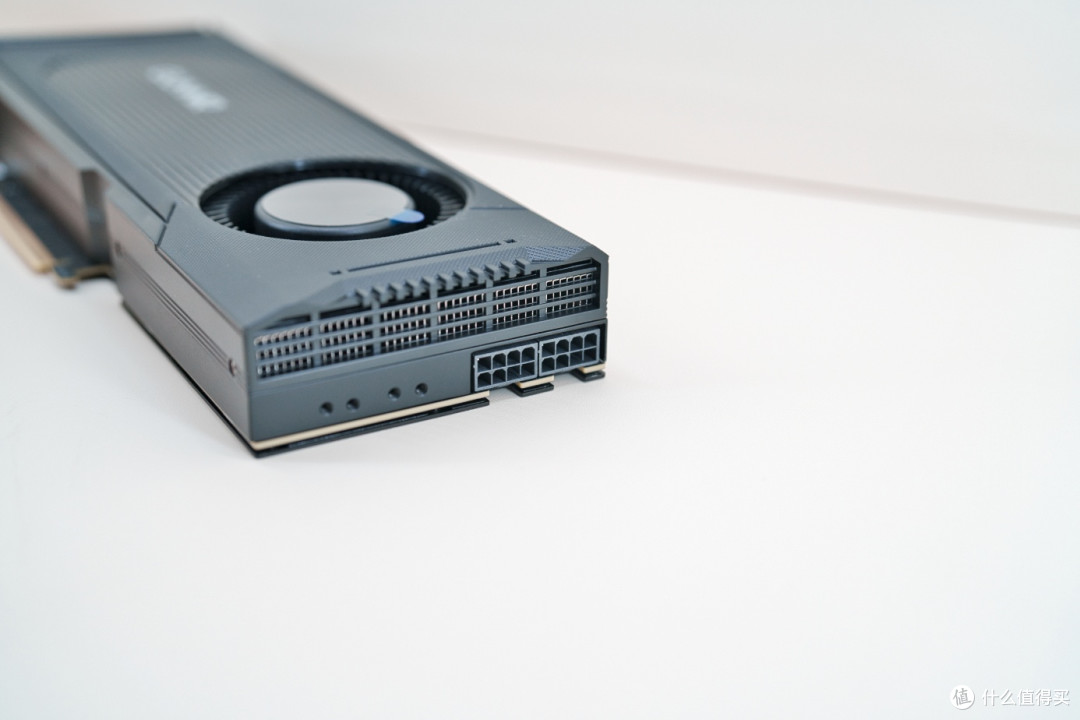
供电接口位于显卡尾部,为两组PCIe 8-Pin,并预留了加装显卡支架的螺丝孔位。这里有一处值得展开:B65官方TBP只有200W,单组8pin已够用,蓝戟依然给了两组。一是双路分流可降低单路电流与接口温升;二是供电模块余量更足,长时间满载电压更稳定;三是在工作站与老旧电源上,双8pin的兼容性远好于12V-2×6 16pin,无需转接线即可部署。对一张主打7×24小时运行的专业卡,这种“冗余优先”是合理的。
(五)内部散热:涡轮风扇加VC均热板加高密度鳍片
既然蓝戟B65 TF 32G的设计与其B70 TF相同,那么B70 TF的散热方案也得到了完整继承,涡轮风扇、VC均热板与高密度鳍片一个不少。涡轮方案把核心与显存热量直接排出机箱,避免多卡并行时互相“吃”热风,这也是工作站显卡偏爱涡轮的原因。
三、上机测试:从架构论证到实机表现
测试平台沿用本站锐炫Pro B系列评测的平台:Intel Core Ultra 7 270K PLUS搭配2 × 32GB DDR5-6400,Windows 11专业版,4K显示输出,驱动为最新的Arc Pro专业版32.0.101.8976。需说明的是,本文引用的B60与B70数据来自本站此前评测,三者并非同一平台:B60出自Core Ultra 7 265K搭配48GB DDR5-8000平台,B70与B65为Ultra 7 270K PLUS平台,驱动版本亦不完全相同。
(一)B65的来历:由B70精简而来,而非B60扩显存
第一次看到B65规格表的人多半会有一个直觉:Xe核心数是20个,和B60一样,那它是不是B60把显存从24GB扩到32GB的产物?这个直觉是错的——它恰好是理解这张卡定位的关键。
正确答案是:B65与B70共用同一颗“大Battlemage”核心BMG-G31,是从G31精简计算单元得到的产品。相对B70,它精简掉12个Xe核心(32到20)、12个光追单元与96个XMX引擎,INT8算力从367 TOPS降到197 TOPS;但256-bit位宽、32GB GDDR6、608GB/s带宽与PCIe 5.0 x16这四件“大芯片外设”被完整保留。
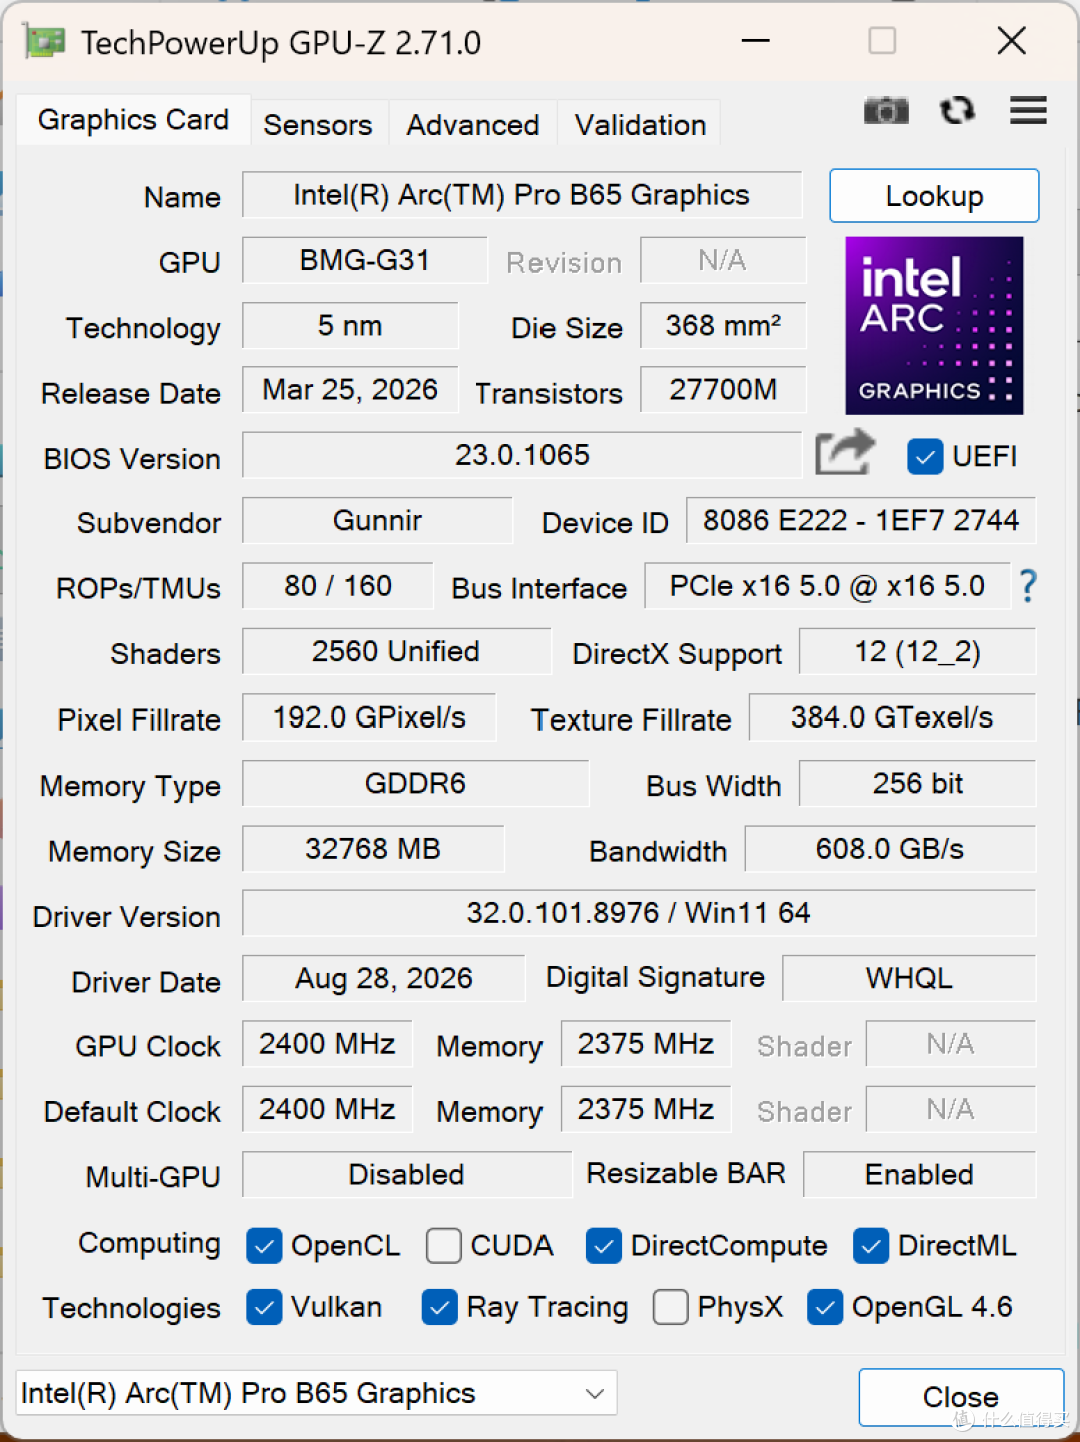
第一条证据是显存控制器位宽。公开可查的BMG-G21显存位宽上限停在192-bit,显存容量只有可能是12GB/24GB/36GB。而32GB必须依赖256-bit控制器, 256-bit只出现在G31上。
第二条证据是PCIe通道数。BMG-G21(B60)的PCI-E接口虽然物理上x16规格、但实际运行只有x8,而B65直接就是x16,x8与x16的差别属于芯片级PHY与控制器配置差异,无法通过修改PCB或刷写BIOS得到。
到此B65的身世清楚了:它是G31的大芯片外设与G21级计算规模的结合体——英特尔不是把小核心“拉大”,而是把大核心“减配”,这正是它既能给到32GB、又能把价格压下来的原因。
(二)Intel AI生态现状:专业驱动、oneAPI与推理框架
专业卡与消费卡最实在的差别在驱动。Intel Arc Pro系列使用独立的专业版驱动,走WHQL认证并面向ISV应用验证。截至2026年10月,最新专业版驱动为32.0.101.8976(Q3.26),支持列表明确包含Arc Pro B65、B70、B60与B50。收益是可量化的:官方口径下,SPECviewperf 15 @1080p中catia-06相对上一版驱动最高提升23%、energy-04提升10%、maya-07提升9%。需要游戏时也可切换到消费级驱动获得day-0支持与XeSS。ISV认证方面,Arc Pro B系列已获认证的应用覆盖Ansys Mechanical、Autodesk的3ds Max、AutoCAD、Maya与Inventor、Bentley MicroStation、SOLIDWORKS 2025 SP3、PTC Creo 11与12等——对工作站用户来说,这份清单的分量比跑分更重。
软件栈底层由oneAPI支撑。OpenVINO最新为2026.4,其2026.1发布说明明确写入“支持Intel Arc Pro B70 Graphics(32GB),单GPU可推理20到30B参数LLM”,2026.2起加入MoE权重卸载、INT4 KV cache量化与EAGLE-3投机解码。IPEX-LLM提供PyTorch侧LLM库,可直接加载GGUF、AWQ与GPTQ,量化覆盖INT2/INT4/INT8/FP8/FP4。
推理工具链一侧:Ollama自0.30起默认启用Vulkan后端,官方称要把GPU加速扩展到包括Intel在内的更广硬件;LM Studio最新为0.4.26,Intel独显主要经其Vulkan后端承载。vLLM对Arc Pro B做了内核优化,官方称在B60上持久化内核可达80%以上硬件利用率,并支持Prefill与Decode分离、EAGLE3投机解码与per-layer在线量化。ComfyUI官方文档也早已把Intel Arc列入支持硬件,走原生torch.xpu路径。总体上,Intel专业卡在“专业软件认证加本地推理可用性”上已经站稳,但在生态厚度与部分兼容性上,与CUDA仍有一定距离。
(三)基础3D性能:3DMark与游戏
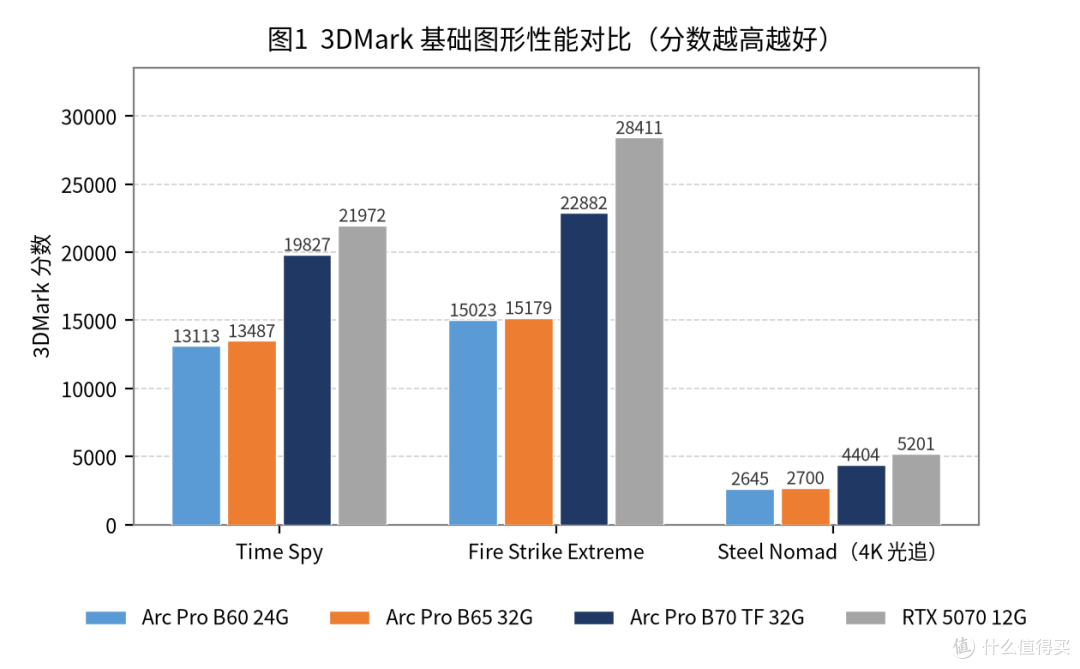
B65定位于专业计算与AI负载,而非消费级游戏应用,但3DMark仍是衡量GPU性能的重要标尺
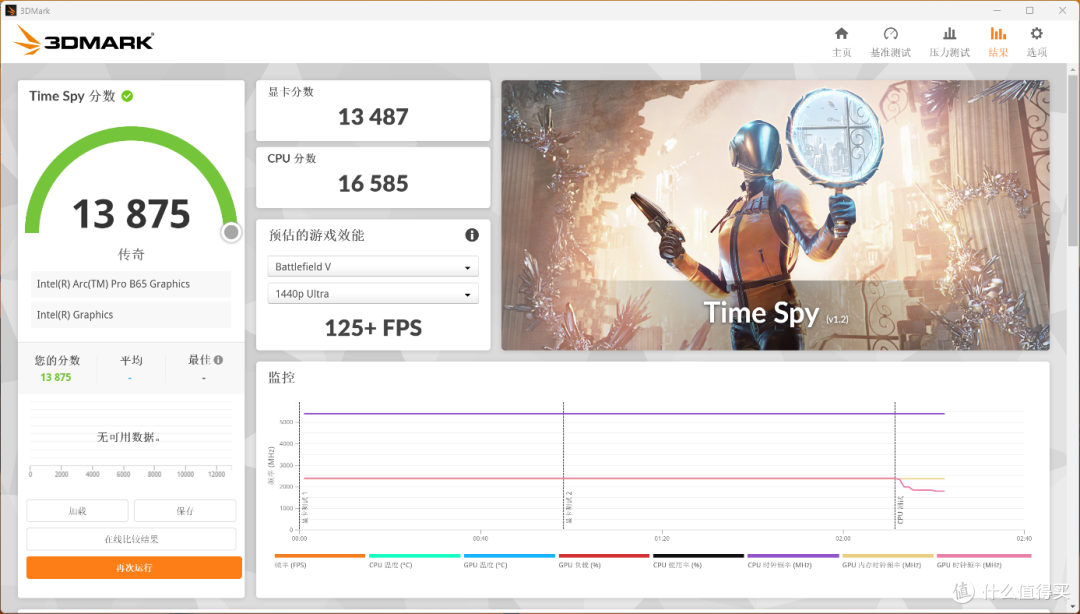
B65的20个Xe核心、160个XMX引擎与2400MHz加速频率与B60完全一致,B65在3DMARK的三个子项测试中的表现符合对其GPU规格的预期,都略微领先B60,这可能是测试平台及后续驱动优化导致的轻微偏差,因此在显存不成为瓶颈的图形与光追测试中两者处于同一水平。
游戏部分,B65在四个场景中分别跑出93帧、136帧、162帧与24帧,约为B70同场景成绩的63% 至81%,与两者20对32个Xe核心的规格差距基本吻合。2K最高画质的3A大作对B65仍偏吃力,开启XeSS后即可进入可玩区间;策略类与网游类负载则相对从容。
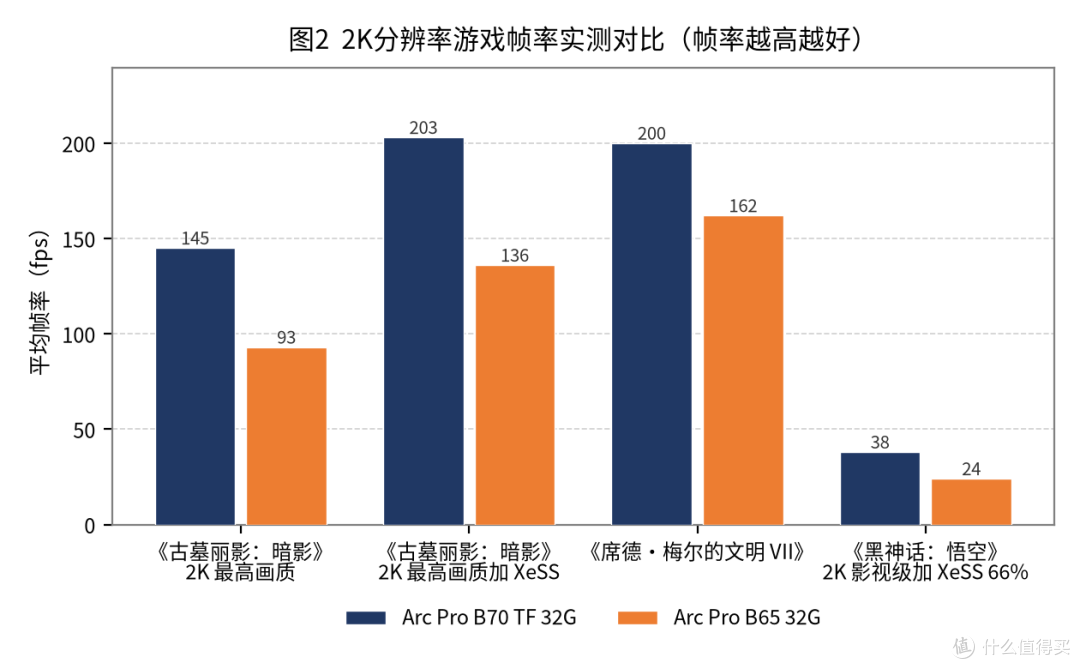
但还是那句话,这张专业卡本不是为游戏设计的,游戏性能只是它作为图形卡的附加能力。
(四)SPECviewperf:ISV认证驱动的价值所在
如果说3DMark看的是图形底子,SPECviewperf看的才是“在专业软件里到底好不好用”,这也是专业卡与消费卡分野最明显的地方。
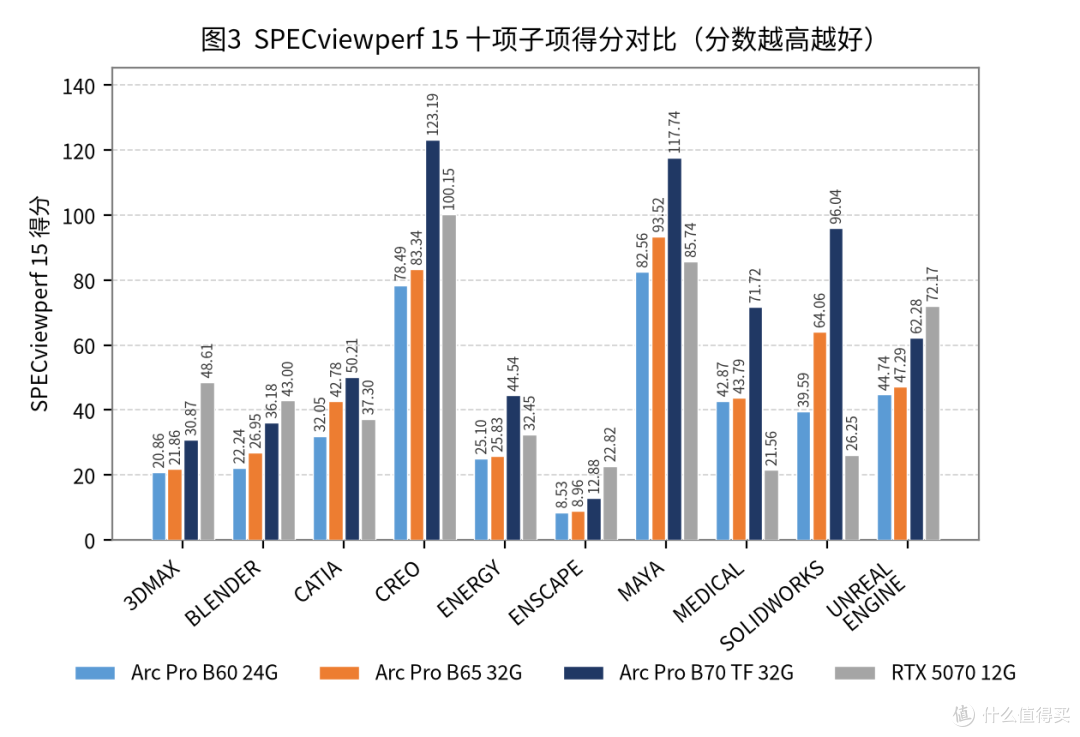
这张表能读出三件事。第一,B65的十项得分全部不低于B60,其中SOLIDWORKS(64.06对39.59)、CATIA(42.78对32.05)、BLENDER(26.95对22.24)与MAYA(93.52对82.56)的提升尤其明显,两者算力规格相同却出现这样的差距,Intel的驱动优化成果可见一斑。第二,B65相对B70仍有明显差距,与两者5比8的算力规模相称。第三,与RTX 5070相比,B65在SOLIDWORKS、MEDICAL、MAYA、CATIA这些传统CAD视口项目上大幅领先,而在3DMAX、ENSCAPE、UNREAL_ENGINE、BLENDER等实时渲染与可视化项目上落后——这正是ISV认证驱动与专业负载取向带来的差异。
(五)本地大语言模型推理:32GB的真正意义
推理测试沿用本站以往的测试方式:Windows下使用LM Studio搭配Vulkan API,以并发数(1、2、3、4)为变量,同时增加Ollama(Vulkan后端)进行交叉验证。曾经在B70测试中出现的LM Studio中默认情况下有概率不能把全部模型加载到GPU,需要手动调整GPU Offload层数的问题,在此次测试未遇到,也侧面说明Intel生态对越来越友好了。
考虑B65定位,实测模型清单锁定在32GB显存真正的甜点区间:Qwen3.6-27B、Qwen3.6-35B-A3B与Qwen3-32B,并保留GPT-OSS-20B与Qwen3.5-9B作纵向对照;量化覆盖F16、INT8、INT4以及GGUF的Q4_K_M、Q6_K与Q8_0。统计decode tokens/s数值。
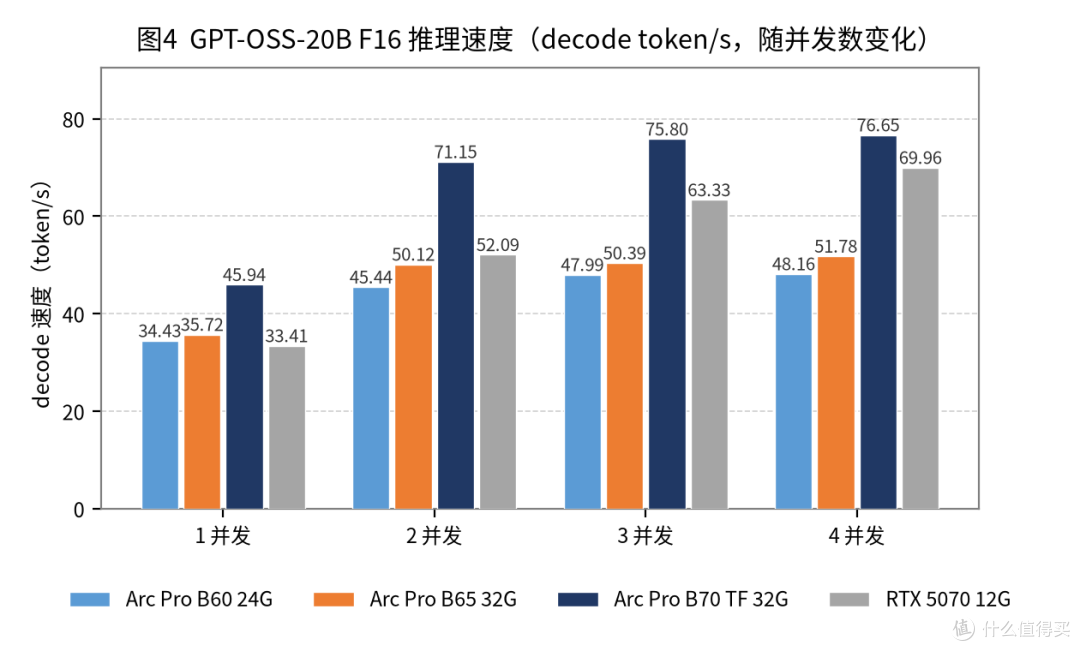
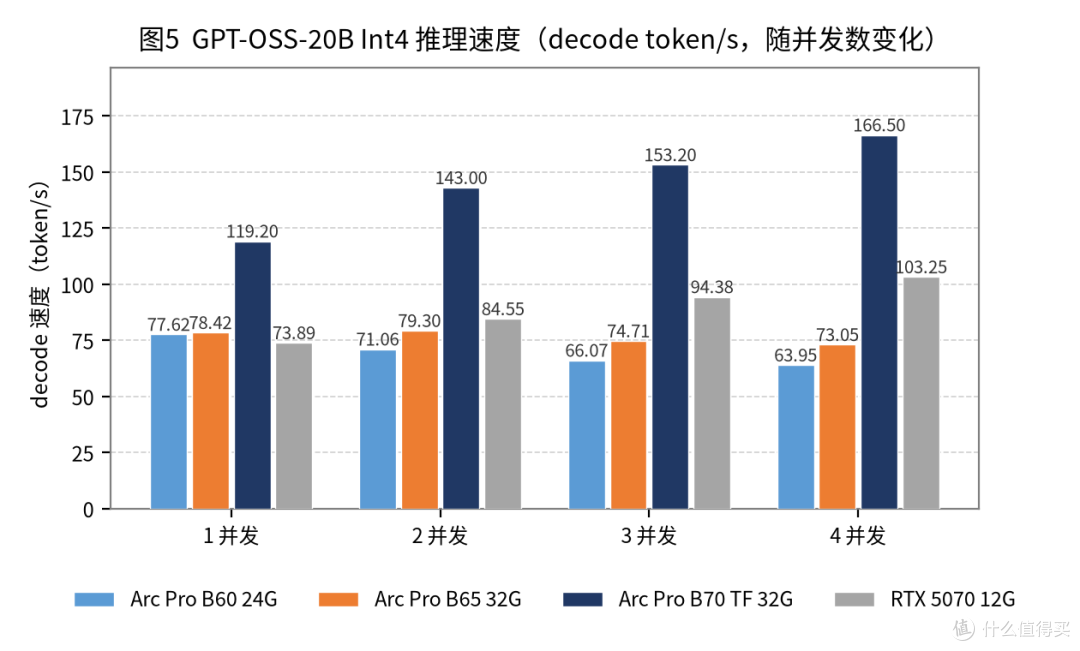
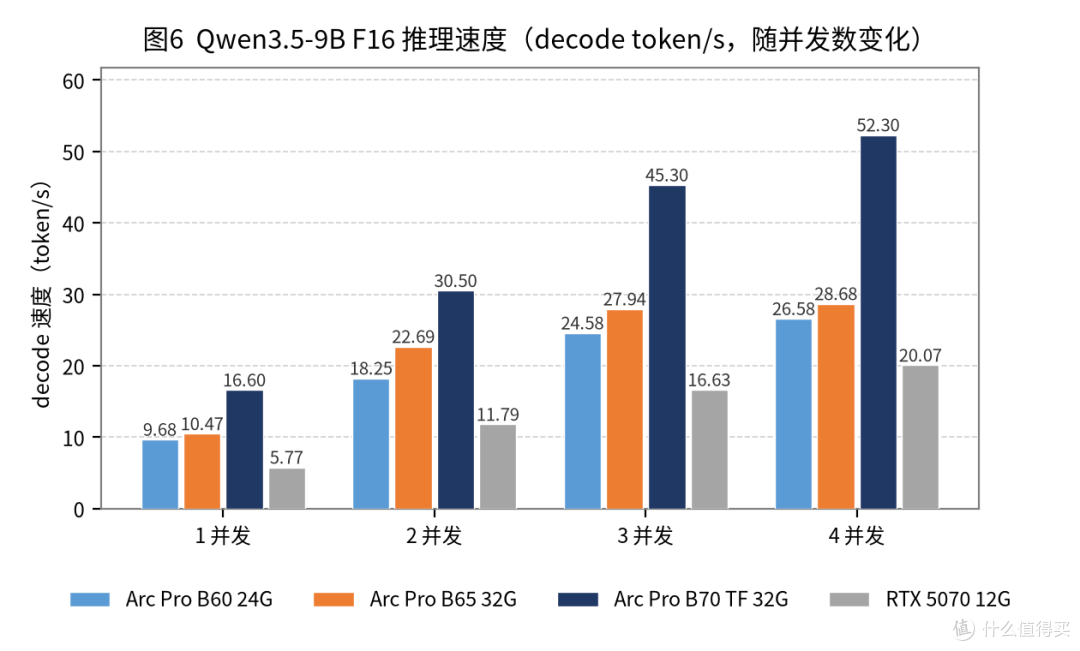
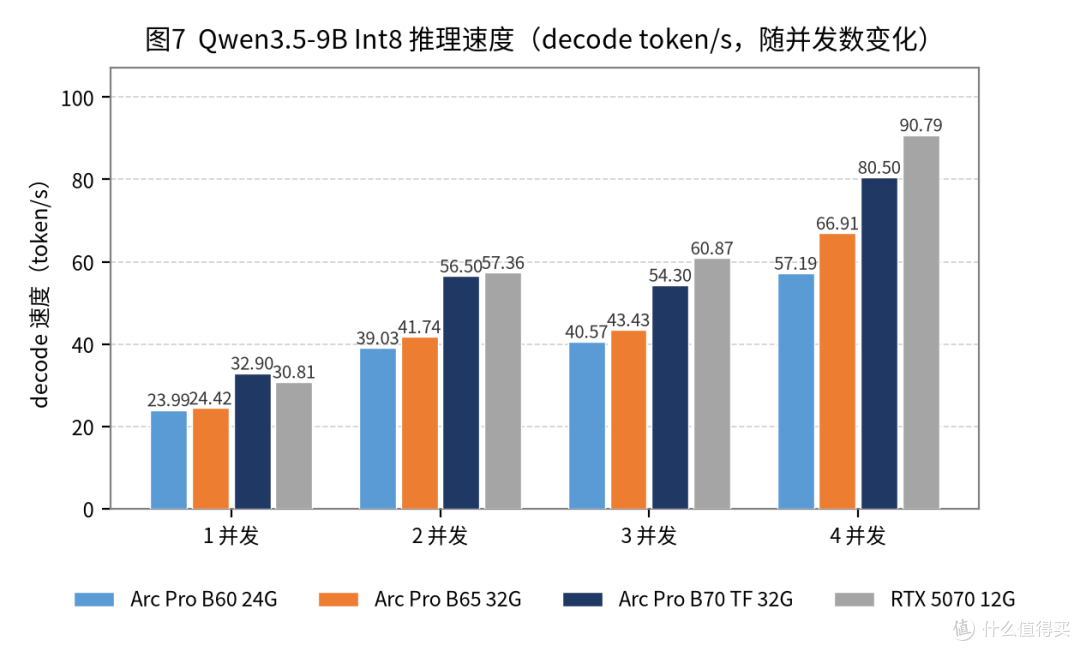
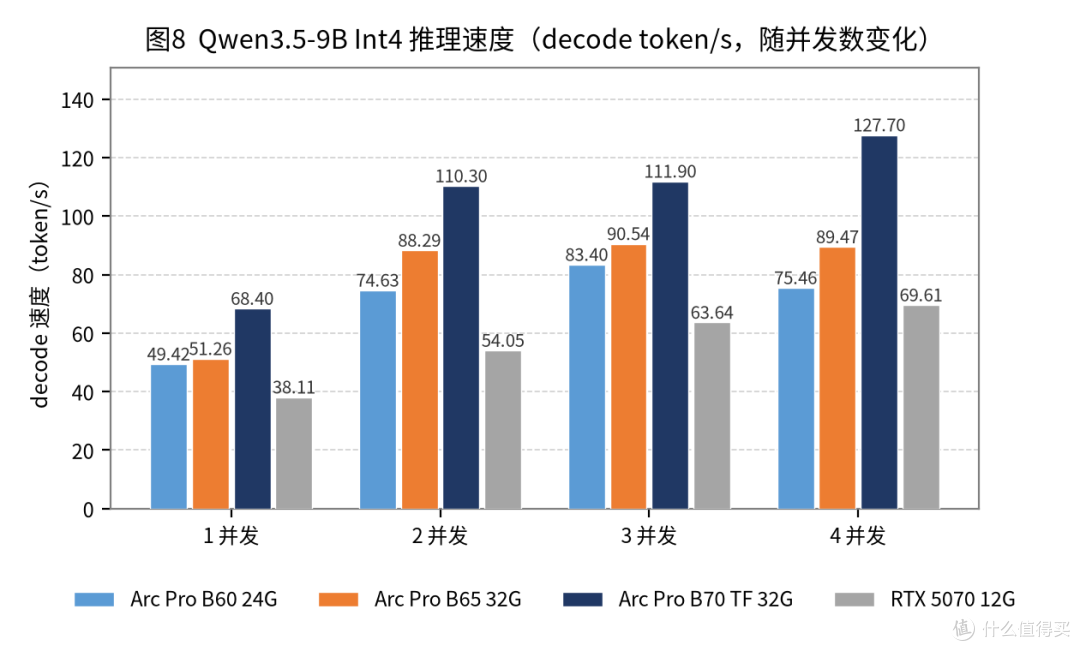
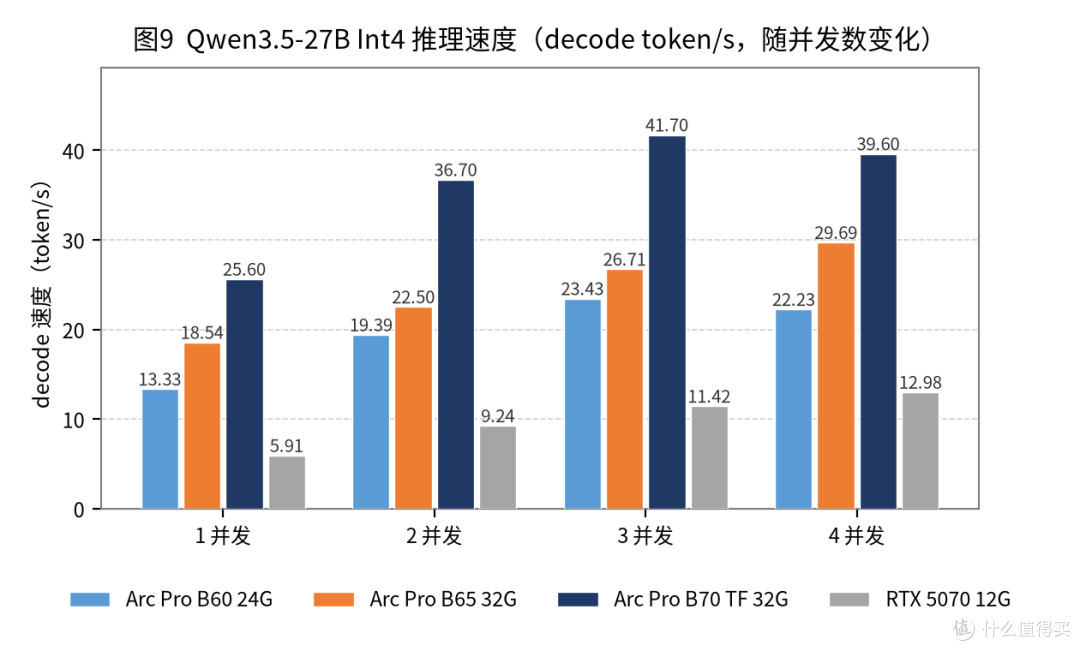
以上的图表表能读出几条规律。一是B70随并发数提升的吞吐余量最大,Int4档位从单并发到4并发可提升四成以上,32个Xe核心在高并发下的余量更充足。二是B65单并发成绩与B60接近,显存带宽更大使得其多并发时略占优势。三是RTX 5070在9B小模型与高并发场景凭借CUDA生态保持领先,显存限制了其模型规模,被三张Intel卡全面反超。四是Int4量化对Intel卡的decode提升显著,而且模型越大,B65相对B60的带宽与通道优势越明显。
(六)ComfyUI内容创作:从出图到视频生成
内容创作是32GB显存的另一块主战场。Z-Image-Turbo是6B级蒸馏文生图模型,8步即可出图,显存占用不到16GB,在B65的32GB上余量很大。实测中B65与B60同为“超过12秒”,确实基本一致——在这一档负载下,32GB并不会带来速度优势,但可以把显存余量用于提高batch,或叠加ControlNet、IP-Adapter等节点。真正吃显存的是视频生成,那才是32GB的主战场。
再看视频生成。把MiniMax H3与WAN 2.2放在一起最能说明32GB的意义:H3约33B的规模本身就是“32GB才敢碰、24GB基本没戏”的典型例证,它不仅要装下权重,还要预留上下文与视频潜空间的开销。WAN 2.2则是目前本地视频生成里落地最扎实的一套, B65 TF 32G运行wan2.2_i2v生成5秒1536×1024的3:2视频平均耗时 约6分钟。需要提醒的是,14B级视频模型即便FP8也需20GB以上显存,4-bit量化几乎是单卡本地跑视频生成的必要前提。
(七)性能阶段结论:显存够用时与B60相当,不够用时是能用与不能用
很多人把大显存理解成“能多跑一个更大的模型”,这只对了一半。更常见的情形是:同一个模型,24GB上已经能加载,但你只能在一个很短的上下文里使用它;32GB让你把这同一个模型跑到真正能用的上下文长度。下表列出32GB与24GB之间的“显存闸门”。
以Qwen3.8-27B为例,Q4_K_M权重约17.4GB,16K上下文合计约17.9GB,24GB卡跑起来相当从容;Q6_K权重约23.7GB,24GB上只剩8K上下文的余量,上下文拉到32K、合计约25GB就已超线;Q8_0权重约28.5GB,24GB直接无法加载,而32GB装入后仍能为32K上下文留出约1.4GB的KV Cache与框架开销(合计约29.9GB)。也就是说,同样一张Qwen3.8-27B,24GB到Q6_K的8K上下文基本到顶,32GB却能把近无损的Q8_0跑到32K上下文。32GB的价值不是“多跑一个模型”,而是“把同一个模型跑到能用的上下文长度”。
回到B65,它推理速度普遍达到B70的约一半到八成,B65与B60处于同一水平;而在24GB不够用的模型上,B65能跑、B60不能跑,这已经不是速度快慢的问题了。
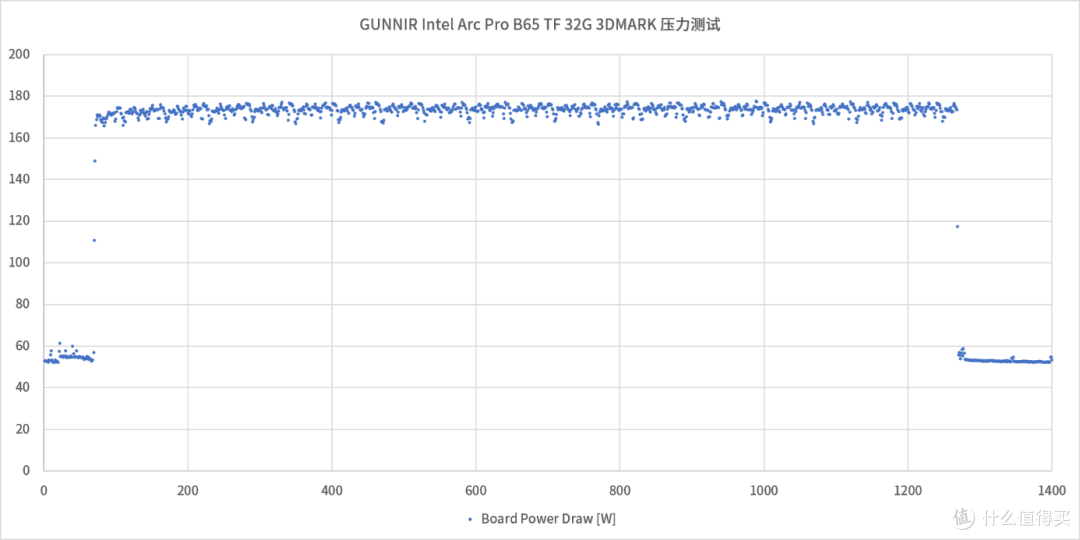
(八)功耗与散热:200W TBP,长时间满载60余度
B65官方的整卡功耗上限(TBP)为200W,长时间满载测试下,B65的整卡功耗稳定在180至190W区间
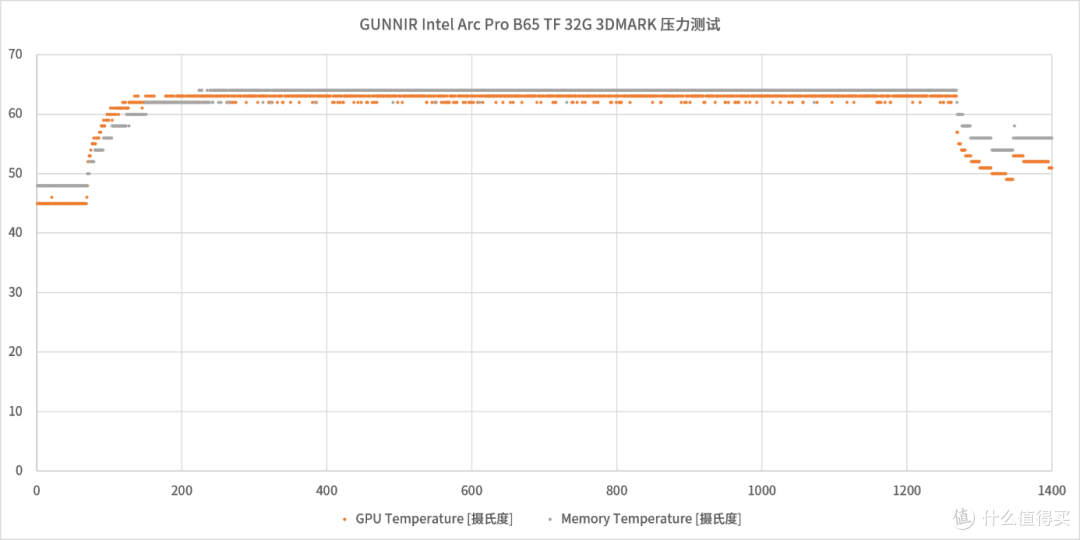
GPU温度维持在63度,显存维持在65度
风扇转速在3100-3300RPM,噪音控制比B70 TF强太多了,即使在室内的听感在可以接受的范围内。
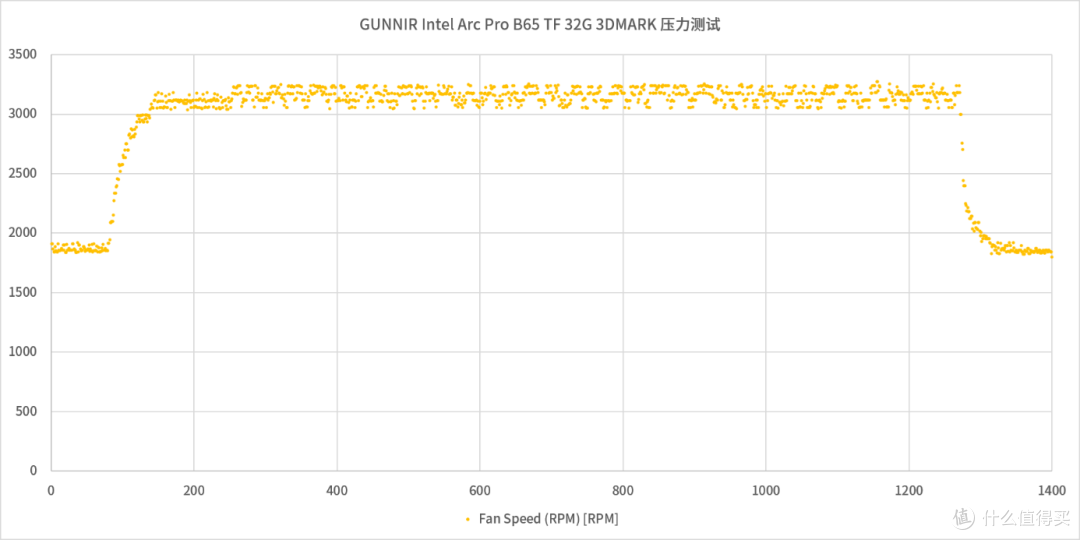
相当于是B70 TF的散热方案,去应对60%左右的功耗,显得游刃有余。涡轮方案把热风直接排出机箱,多卡并行时不会互相“吃”热风,配合双8pin冗余供电,更利于工作站7×24小时稳定运行。
四、总结
回到开头的问题——B65到底是什么?它既不是“B60加显存”,也不是“B70的缩水版”,而是同一颗BMG-G31大核心砍掉一部分计算单元、完整保留256-bit位宽、32GB容量、608GB/s带宽与PCIe 5.0 x16这套大芯片外设之后的结果。
至此,三款卡的应用场景分化已经相当清晰。B60是入门级推理卡,24GB显存配197 TOPS算力,走“够用且便宜”的路线,适合预算有限、模型规模在20B以内的入门推理用户。B65是“大显存、适中算力”的定位,32GB显存是它最核心的价值,适合模型规模上探到27B至32B、需要长上下文,或要跑14B级视频生成的本地推理与内容创作用户——在这些场景里,它与B60的差别是“能不能跑”,与B70的差别只是“慢一点”。B70则是高算力旗舰,适合把显卡当生产工具的工程师与工作室。
当然它也有明确取舍:197 TOPS的算力摆在那里,在纯算力受限的项目上,它跑不过B70,也不会比B60更快。如果你要的是专业图形软件里的顶级性能,B70才是选择;如果模型规模停在20B以内,B60已经够用。B65的价值,恰恰存在于这两者之间的那段空白里。
32GB单卡能承载的模型终究有限,英特尔对于给出的官方解法是Linux下的多卡并行。接下来我们会用两张蓝戟B65 TF 32G做一次双卡体验分享,看Intel的多卡效果究竟如何,多卡扩展上能带来多少实际收益,敬请期待。











校验提示文案
校验提示文案