
















16
25
199 元蓝牙AI录音卡,FunASR+本地大模型用下来真香
2026-10-09 17:08:20
0点赞
0收藏
0评论
录音、转写、整理纪要、出思维导图,一块小卡片搞定
这两年录音设备接触了一圈——QwenNote A2、讯飞听见 M1、飞书妙记那款、钉钉 AI 录音笔这些都上手试过,价格在 1199 到 1999 这一档也都比对过。这些产品在各自领域都做到了前列,但拖了大半年没下手,主要卡在两个点上:
· 价格——QwenNote A2 卖 1199 元,讯飞听见 M1 大约 1799 元,飞书那款要 1999 元;
· 会议信息——这四款默认都会把录音推到自家云端做二次分析,技术评审会、项目立项会、客户合同谈判这种敏感会议,不太敢直接录。
前前后后比了好几轮,也没下手。
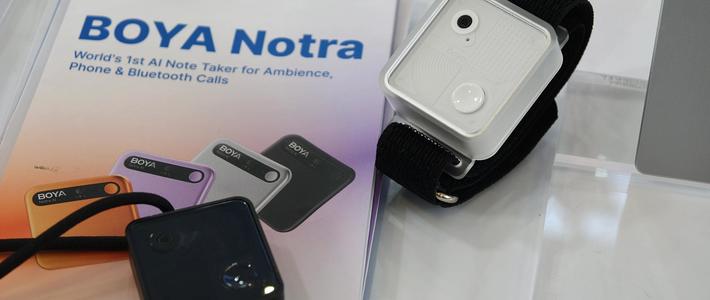
上个月,世界制造业大会上。看到一个小展位,一块蓝牙 AI 录音卡出现在我眼前——信用卡大小、磁吸贴手机。展位不大,但围着的人在试。
工作人员介绍:199 元起售,开源协议、可二次开发,开会时自动分出谁在说话,配套 App 录完自动出 AI 纪要 + 思维导图 + 待办清单,通话录音支持微信 / QQ / 钉钉 / 腾讯会议,骨传导 + 物理层录音让防窃听软件失效。
硬件部分不复杂——信用卡大小、磁吸一搭即充,开源协议,28 克铝合金机身,30 天待机 / 30 小时续航。
当时没买,先记下了线上渠道。回去之后又把产品手册、GitHub 仓库、用户评测、协议文档都翻了一遍,翻完一圈资料后——从线上下单。
到手后,零零散散跑了 20 多场会议。说几个真实的使用感受:
· 3-5 人小会:识别率很稳,谁说了什么分得清清楚楚,会后追责都有据可查;
· 8-10 人大会议室:说话快的人偶尔会窜到下一段,事后靠文字稿核对也能补回来;
· 外勤 / 客户拜访:磁吸到手机上就走,比掏手机开录音省事得多。
用到现在整体一句话:日常会议它都扛得下来,文字稿能搜到、参会人能追责,已经够覆盖大部分场景。
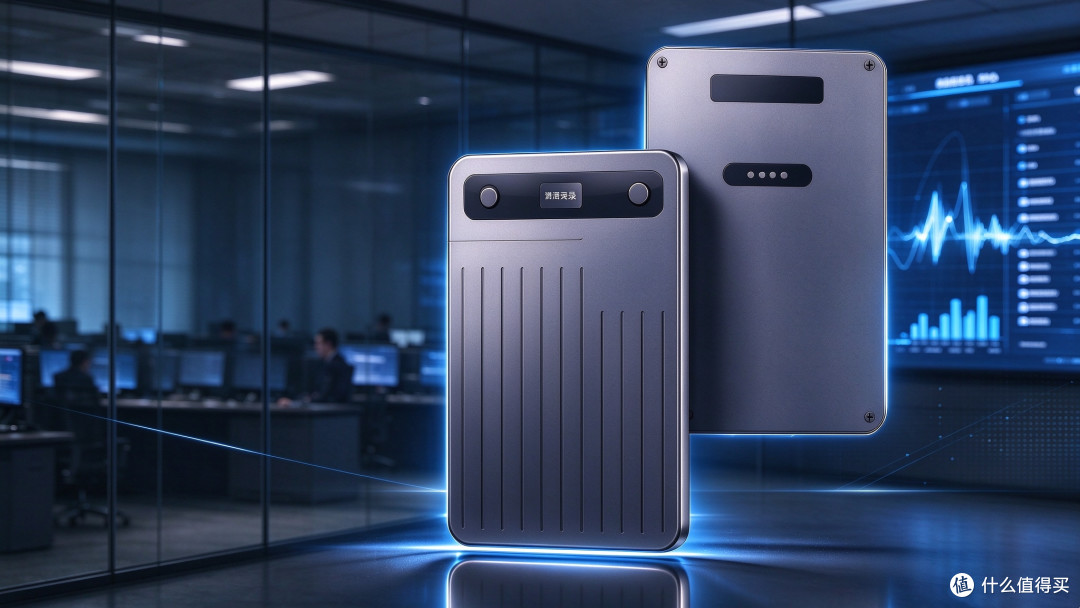
一、卡片本身能干啥、我又用 WorkBuddy 对接了啥
我把这块卡片和 WorkBuddy 接到一起,最终凑成一套"卡片录 + 本地转写 + 本地大模型整理纪要"的小闭环。先说卡片裸机状态下能独立工作啥:
· 裸机录音:单击开录、双击暂停、再单击续录,录完文件落本机存储,关机不丢;
· 通话录音:微信 / QQ / 钉钉 / 腾讯会议 这些工具都覆盖,骨传导 + 物理层通话录音让防窃听软件失效;
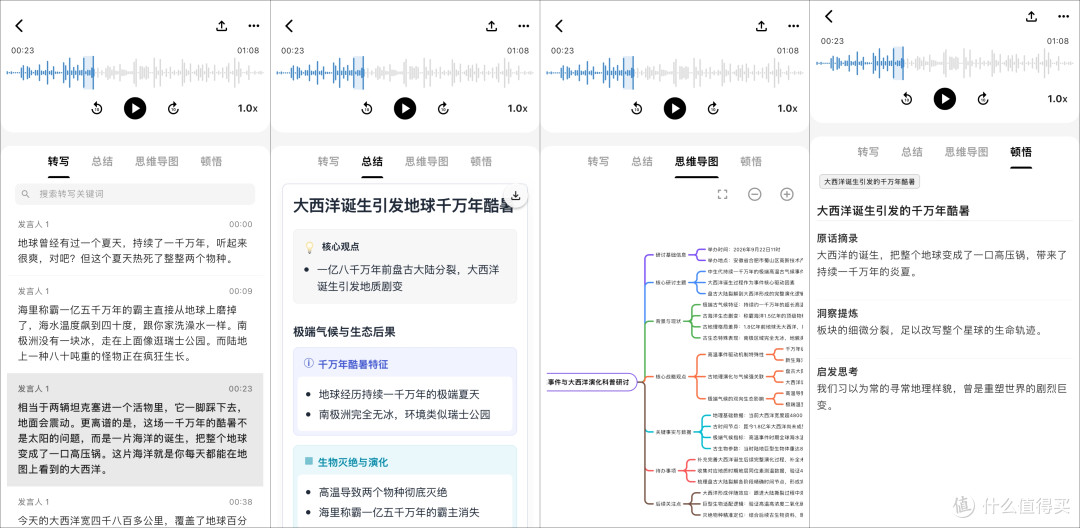
· 配套 App:配套APP端能直接看波形、看文字,录完自动出 AI 纪要 + 思维导图 + 待办清单;
· 蓝牙配对:长按菜单键 + 短按录音键进入配对模式,配合 BLE GATT 协议能被任意客户端接管;
· 导出兼容:基于标准 U 盘模式和磁吸 USB 数据线,任何主机都能直接挂载录音文件。
接下来是 WorkBuddy 在这头做的事——我把卡片和 WorkBuddy 串起来,主要做了下面这些:
· 先帮卡片做协议解析:BLE GATT 协议层、串口协议层、文件系统层全过一遍,把卡片私有协议翻译成标准 JSON 接口;
· 再搭一套本地 Web 后台:设备连接、文件拉取、状态监控、历史会议检索全在一个面板里;
· 把本地大模型接进来做后处理:摘要、思维导图、待办清单全部本地化,会议信息不出本机;
· 历史录音建索引:跨录音跨会议搜索,问一句"上周和法务的合同违约金那条怎么说的",3 秒内返回原文位置和上下文。
最终搭出来的体感:开会时卡片往桌上一放、会完 App 端推一份带思维导图和待办的纪要;从录音到文字到整理全部跑在本机,敏感会议也不用担心被"听"走。
二、把这块卡片硬件拆开看一眼
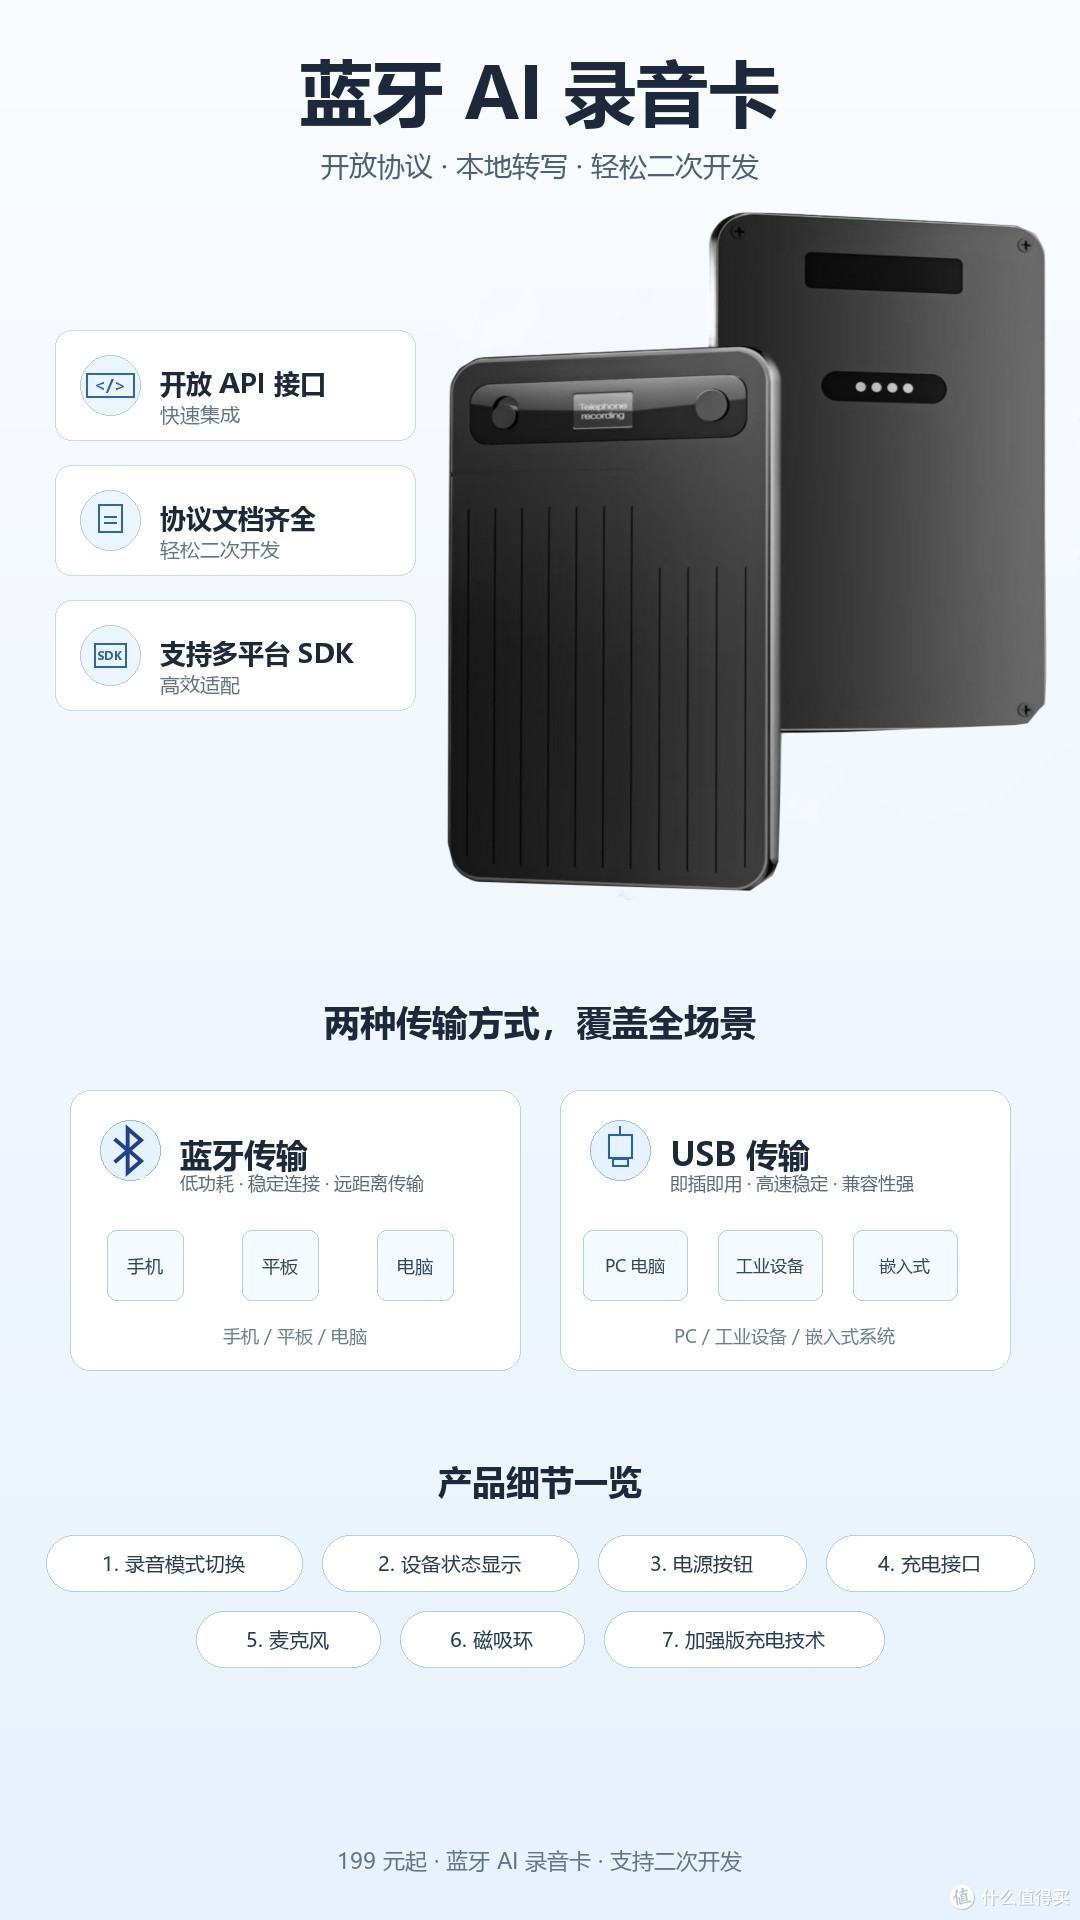
蓝牙 AI 录音卡完整开放 API 协议,能二次开发接入到企业系统、教育平台、办公应用和智能硬件集成场景,给出录音、转写、翻译和协议对接能力。
· 设备管理:屏幕直接显示时间、电量、蓝牙状态、固件版本、时钟同步等信息
· 文件管理:本机自带存储,内置 WAV/OPUS 下载、断点续传、分段下载、单条 / 批量删除,也可用磁吸 USB 数据线连电脑当 U 盘用
· 实时转写:实时音频推流,支持暂停 / 继续 / 停止
· 录音控制:支持电话录音与常规录音,开始 / 保存 / 暂停 / 继续,状态 / 时长 / 文件名实时可查
· 蓝牙传输:通过蓝牙连接 App/PC,可实时转写、文稿复核、内容分享、AI 总结
AI 录音卡硬件参数
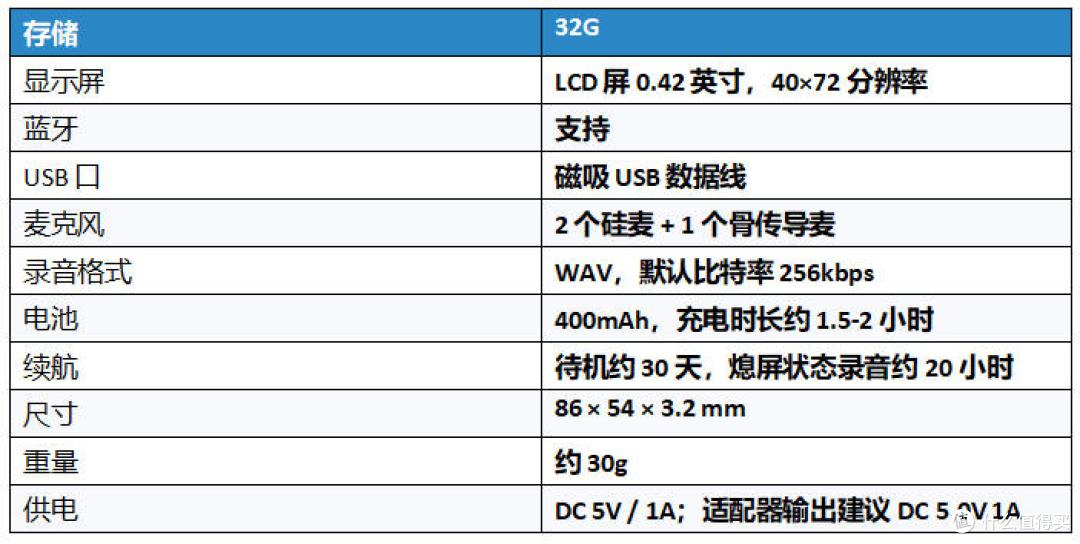
硬件部分不复杂——信用卡大小、磁吸一搭即充,开源协议,价格只要 QwenNote 的 1/6。
三、把声音变成文字那段:阿里达摩院 FunASR
FunASR 是阿里达摩院开源的端到端语音识别模型家族,不是单独一个模型,而是一整套语音处理流水线。底层基于 PyTorch 和 ModelScope,把语音识别相关的能力打包成统一接口,让开发者用几行代码就能跑通整条流程。
Fun-ASR-Nano-2512 基于数千万小时语音训练,覆盖中文、英文、日文及中文方言和地域口音;Fun-ASR-MLT-Nano-2512 是基于数十万小时多语种语音训练的 8 亿参数 checkpoint,覆盖 31 种语言。
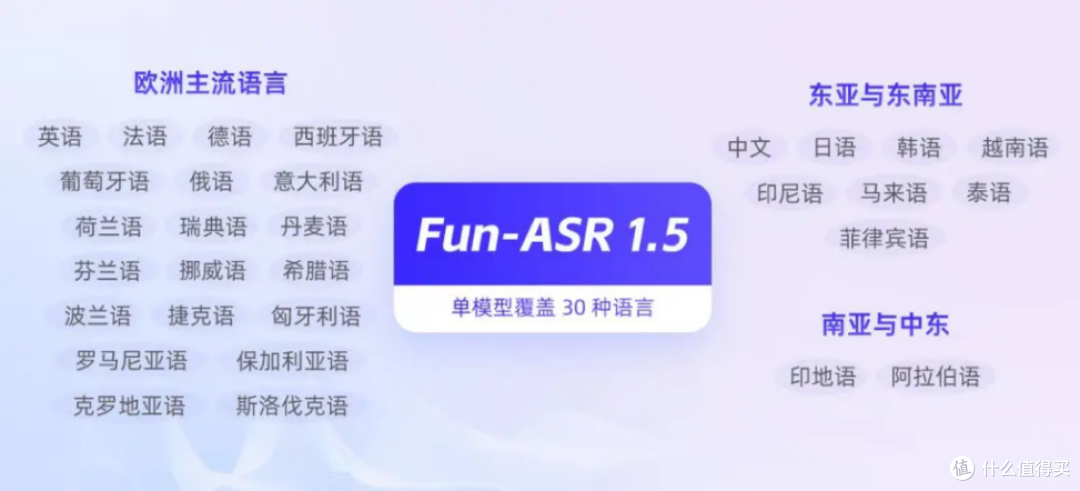
· 核心能力:覆盖 ASR、VAD、标点恢复、说话人验证/分离、情感识别等全链路
· 统一入口:通过 AutoModel 接口加载模型,换模型只改一个参数,也能把 VAD + ASR + 标点自动拼成 pipeline
· 开源生态:2023 年开源,GitHub 上已获 15.2k Star,代码 MIT 协议,模型托管在 ModelScope 和 Hugging Face
本地快速部署 Fun-ASR 服务
git clone https://github.com/QwenAudio/Fun-ASR.git
cd Fun-ASR
pip install -r requirements.txt
语音转文字能力验证
# 健康检查
curl -fsS http://localhost:8000/health
# {"status":"ok"}
# 列出已加载的模型
curl -fsS http://localhost:8000/v1/models
# {"data":[{"id":"sensevoice"}]}
# 转写一段音频
curl -fsS http://localhost:8000/v1/audio/transcriptions
-F file=@meeting.wav
-F model=sensevoice
四、本地大模型用下来几个真实的感受
硬件和 FunASR 准备好之后,我把本地开源大模型接进来做后处理,下面是用下来几个真实的感受。
我本地部署的是基于通义千问开源版本做的中文指令微调模型。接进来之前预期是"凑合出个会议纪要",用下来发现几个点比想象中好用:
· 中文会议纪要:45 分钟的中文周会能整理成 4 条决策 + 1 段总结 + 1 张思维导图,和云端那些专门调过的会议模型只差一点——关键是数据完全没离开我的电脑;
· 多说话人识别:3-5 人小会识别率最稳,每人发言准确归因,自动生成发言人——这一项比 QwenNote 那几款云端录音笔反而更可控;
· 跨文件智慧查询:所有历史录音都建好索引后,我能直接问"上周和法务的会议里关于合同违约金那条怎么说的",3 秒内返回原文位置和上下文;
· AI Agent 多轮对话:会后我会跟本地大模型来回对话让它整理待办、生成周报草稿,响应速度比云端快——因为不联网、不排队、不用担心 token 消耗。
五、使用后,说几句大实话
这段时间用下来,这块 199 元的蓝牙 AI 录音卡配上 FunASR + 本地大模型,把录音、转写、纪要这条链全在本机跑通了,敏感会议敢放心录,开放协议也留足了二次开发的空间——千元录音笔的核心场景,它基本都接得住。
一块 199 元的卡片 + 一套开源生态,既能出活、也能保数据。
如果你也对开源 AI 录音卡感兴趣,或者想聊聊 FunASR + 本地大模型会议纪要那一套,可以在这https://open.sinicloud.com/open.html 一起交流





