













11
9
4090的算力翻倍了,代价是游戏一帧没变
2026-10-26 09:44:37
0点赞
0收藏
0评论
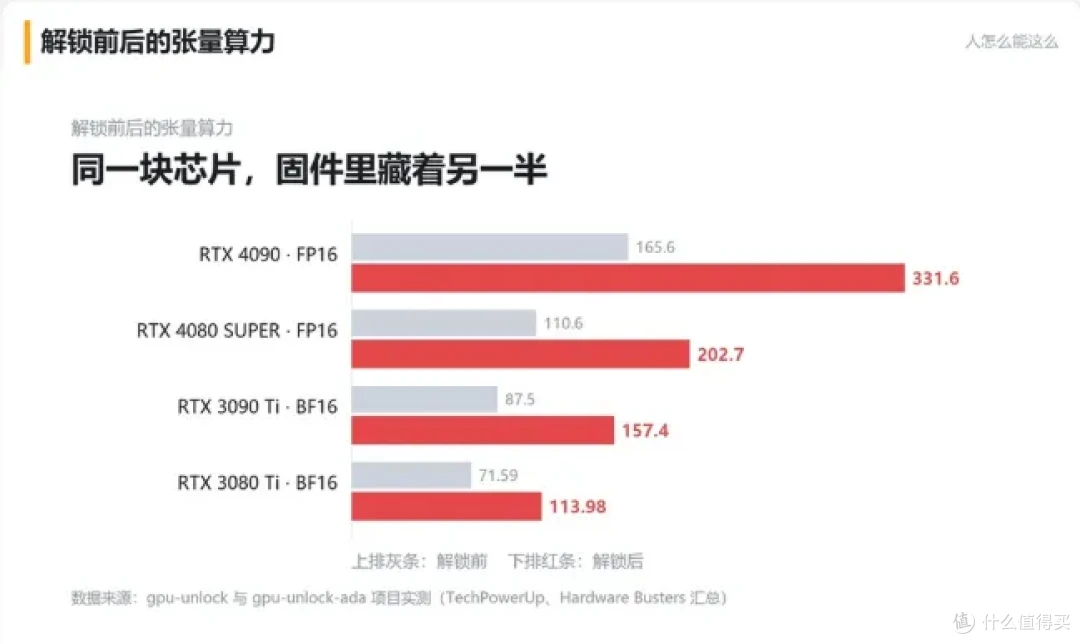
哥们,这两天显卡圈出了件挺荒诞的事。两个开源项目几乎同时把 RTX 30 系和 40 系的张量算力翻了一倍,4090 的 FP16 从 165.6 直接跑到 331.6 TFLOPS。不是换卡,不是超频,是英伟达自己把同一块芯片锁了一半,现在被人从固件里打开了。
 图片
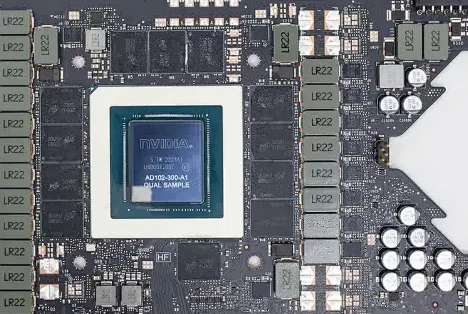
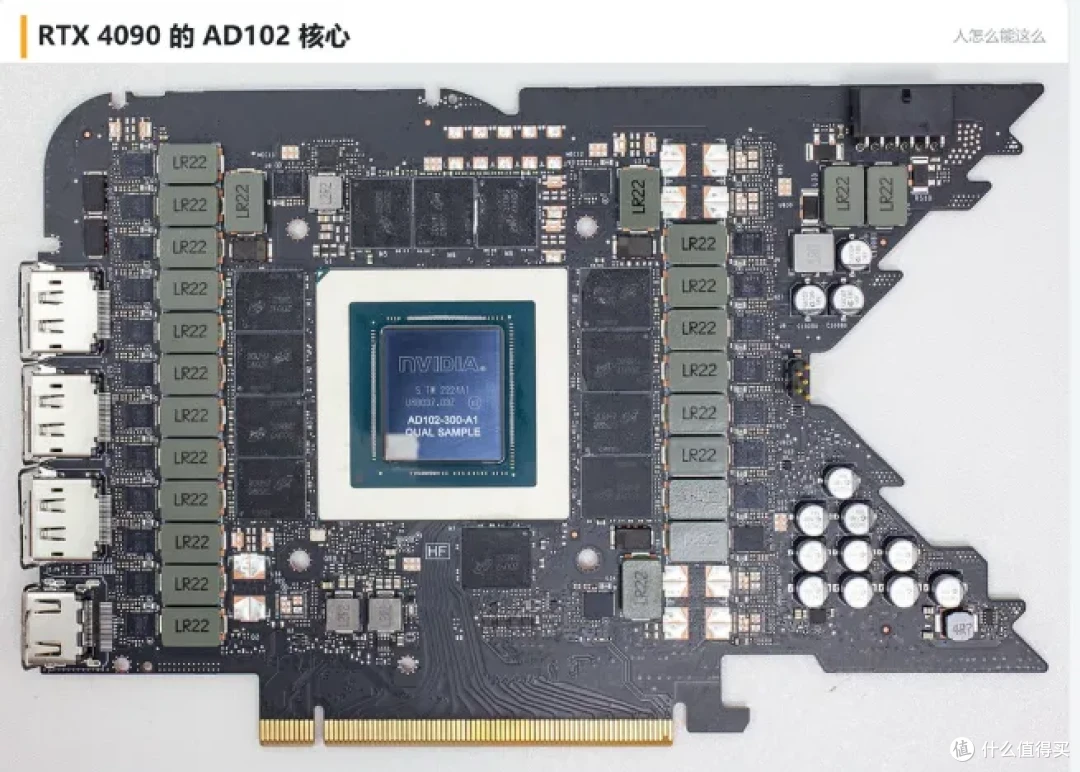
这事最讽刺的地方在于,英伟达从来没藏过。Ada 架构白皮书里白纸黑字写着,GeForce 在 FP32 累加的 FP16 和 BF16 张量运算上跑半速,而用同一块 AD102 核心的专业卡没有这个限制。硬件一模一样,差别就是固件里一个速度档位。说白了,这张卡在出厂那一刻就被分了级。
那么是怎么打开的。开发者写了个 Linux 内核模块,抢在官方驱动加载之前,把流处理器的速度选择寄存器改掉,再触发一次 PCIe 功能级复位,然后原厂驱动照常接管,全程不刷 VBIOS,不改驱动。30 系那套方案的技术底子,还是当年挖矿卡解锁算力的研究。这一手等于绕过了英伟达给消费卡和专业卡划的那条线。
 图片
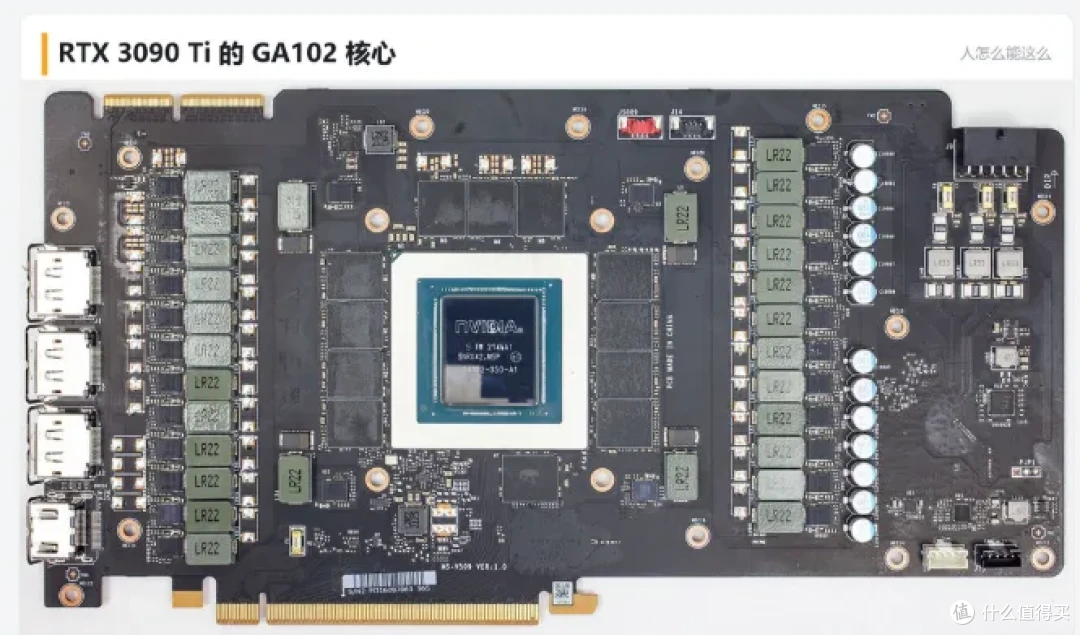
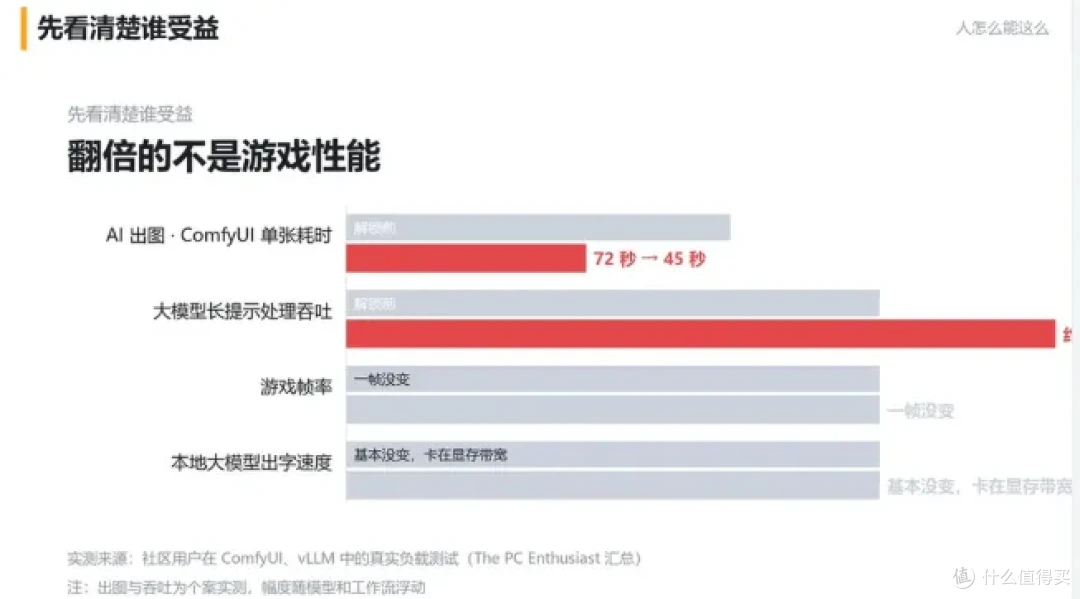
那么对哥们来说,先泼冷水:打游戏的人一分钱好处都拿不到。游戏不调用这条计算路径,帧率一帧没变;本地跑大模型出字的速度卡在显存带宽上,也基本没变。真正受益的是跑图和微调的人,3090 Ti 在 ComfyUI 里出一张图从 72 秒跑到 45 秒,长文本处理快了三分之一。
 图片
 图片
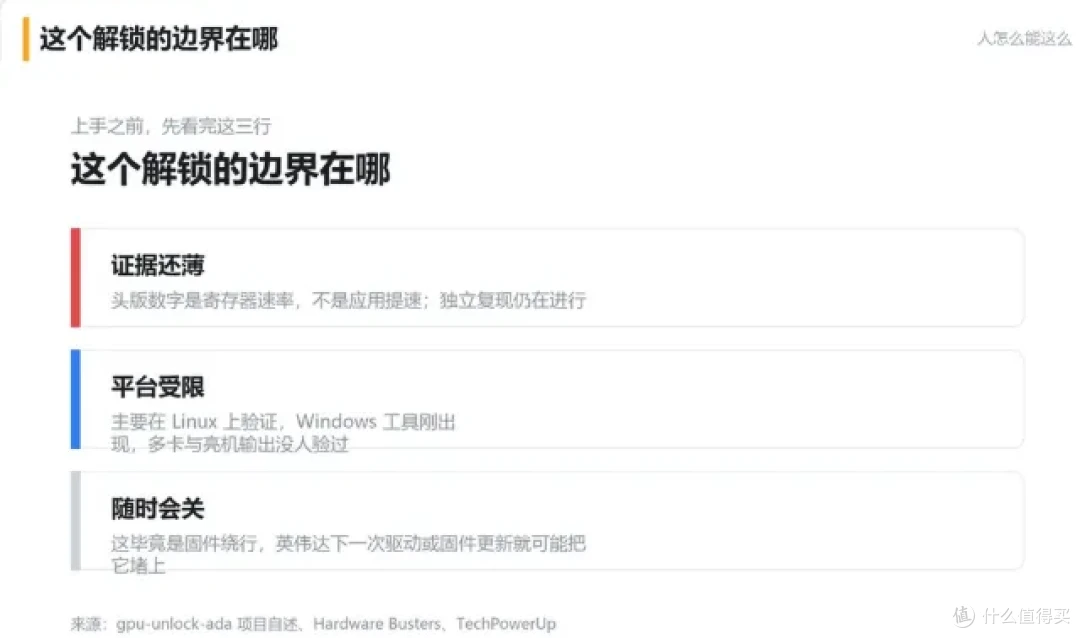
所以这里的钱包账是这样的。手里有 24G 大显存卡又跑 AI 的,等于白捡一次升级,可以关注。纯打游戏的,这事跟你没关系,别被性能翻倍四个字勾着去溢价收二手卡。想靠它买卡跑生产的,再等等,项目自己都承认头版数字是寄存器速率不是实际应用提升,独立复现还没做完,英伟达下一个驱动更新随时可能把这条路堵上。
别忘了边界。目前主要在 Linux 上验证,Windows 工具刚冒头,多卡和亮机输出都没人验过。而且解锁不改变功耗,3090 Ti 翻完倍还是那 450 瓦的电老虎。
 图片
同一块芯片卖你两回,被一段代码戳穿了。
所以兄弟,这事当个乐子看最合适,佩服归佩服,钱包先别动。