10 月 20 日,DeepSeek 把自家生产环境在用的大规模云服务推理框架 DeepInfer 开源了,同步放出生产级 Token 编解码组件 deepseek-recipe。同一份技术报告里,官方首次亮出自己的线上运行规模——这正是热榜词条里"日吞吐达 155 万亿"的原始出处。数字属实,但要真正看懂它,得带上三个限定:它是官方自报的线上口径,"每卡每小时 38 美金"是收入而非利润,这次交出的是推理引擎、不是整套在线服务系统。知乎
155 万亿是从"少重算"里抠出来的
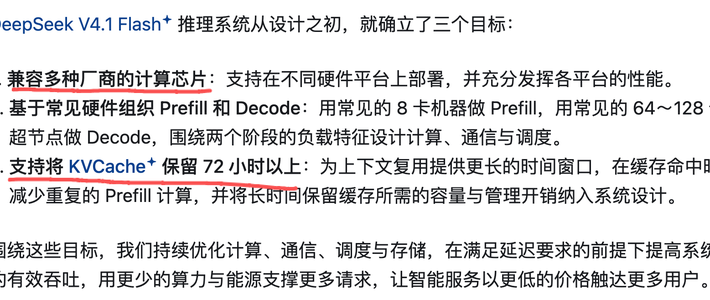
按官方的方案,推理系统用常见的 8 卡机器承担 Prefill,64 至 128 卡超节点承担 Decode,两侧比例再按流量自动扩缩。缓存侧,agent 流量的 KVCache 保留时间达到 3 天,chatbot 流量达到 7 天,底层 3FS 存储集群约 100 PiB SSD 容量、峰值聚合读带宽可达 10 TiB/s。再加投机解码:DSpark 每步先草拟 5 个 token,只验证预期收益最大的前缀子集,官方称比固定验证 5 个 token 再多 6% 吞吐。这套体系省的不是电费,而是重复计算——缓存命中越高,Prefill 重算越少,每张卡吐出的有效 token 就越密。36氪知乎
口径:自报线上值,收入按谷价计算
热榜数字的完整原文是:目前单一集群的服务吞吐是 155 万亿 Tokens/天,整体收入是每卡每小时 38 美金(按谷价)。换算下来约等于单集群每秒输出 17.9 亿 token、单卡满负荷一天创造约 912 美元收入——这只是算术,无法据此反推成本:DeepSeek 未公布集群卡型与卡数,开源仓库的性能图也只标注 prefill 4 张 SM100、decode 64 张 SM100,既没有单卡吞吐的绝对数值,也没有 vLLM 基线,更没有跨 scale-up 域的扩展曲线。38 美金是按谷价口径折算的收入,"单卡日赚几百元纯利"式说法没有成本依据。知乎知乎
边界:开源的是引擎,在线服务层要自己补
官方在报告里明说:推理系统中的 KVCache 管理与负载均衡组件因与内部基础设施耦合较深,相关代码目前尚未完整开源。仓库 README 同时列出三项"本版本不含"——KV 缓存、Prefill/Decode 分离、数据并行副本间的负载均衡,也就是把离线批处理变成线上服务的那一层。换句话说,拿到手的是生产级参考实现:已有推理平台的大厂能照着补全,想照着 README 直接上线的小团队则要自己啃下最难的部分。知乎知乎
硬件门槛同样不低,支持列表只有 NVIDIA SM100 与华为昇腾 950 两行。而昇腾这一行目前还只是"支持",不是"验证"——截至发稿,公开材料里找不到第三方在昇腾 950 上复现 DeepInfer 的数据,DeepSeek 也未说明验证规模。知乎
受益顺序:先有大集群,后有 API 用户
DeepInfer 最初主要基于 vLLM 构建,并借鉴了 SGLang 与 TensorRT-LLM。对开发者生态,短期内更现实的路径是社区把 SWA Bounded Replay、DSpark 这些做法移植回通用框架。对第三方服务商,deepseek-recipe 已把 API 编解码逻辑与官方完整对齐,以接近官方体验提供 V4.1 Flash 的门槛显著降低,本已白热化的 Flash 价格战还会更卷——MiniMax 刚把 M3.1 Flash 的价格砍到一半正面对垒。对普通用户,最先可能感知的变化是 token 单价继续往下走。知乎36氪
至于 155 万亿本身,DeepSeek 给出的预期是:未来新模型的推理代码及后续性能优化也将在 DeepInfer 中持续开源。接下来值得盯的两件事:KVCache、负载均衡等未开源组件何时补齐,以及第三方在公开硬件上的复现数据何时出现——它们将决定这个"日吞吐 155 万亿"在行业里最终值多少。知乎