10 月 29 日凌晨的苹果发布会,首款触屏 MacBook Pro 发布:国行 22999 元起,10 月 30 日上午 9 点开启预购,11 月 6 日发售。14.2/16.3 英寸双层 OLED,内存最高给到 128GB 统一内存;而这个档位这次被话术绑上了一个新卖点——本地跑大模型,有数码博主算过,128GB+16TB 的顶配「可以加到近 12 万」,这条微博下面 6 条评论没有第二种口径,全是“太贵了”。知乎微博
但在本地模型圈,大家讨论的不是价格,是另一笔账:花 12 万跑本地模型,到底跑得动什么?
128GB 跑 27B:每秒不到 20 个词。有用户上手 M5 Max 128G 加载 Qwen3.6 27B,原话就是“20tok/s 不到”;因为同时挂着 gemma-4,内存干到 70GB+,键盘热得能煎鸡蛋。小红书
64GB 更尴尬,卡在门口。另一位满血 M5 Pro 64GB 用户跑 Qwen3.8-27B 4bit 量化,平均 12 tok/s、峰值 15;再挂上 MiniMax H3 生成视频直接撑爆,可回收内存只剩 343MB。这位用户留下著名的三档结论:64GB 是体验线,128GB 是可用线,专用设备才是生产线。小红书
为什么快不起来?记住一句话:容量决定能不能跑,带宽决定多快。27B 4bit 权重约 14GB,每生成一个 token 都要把权重读一遍,理论上限约 20 tok/s 是被内存带宽锁死的。所以 128GB 只留给 40 核 GPU 的 M5 Max,带宽给到 614GB/s——卖点指向哪个档位,写得明明白白。小红书36氪
社区也因此吵成两拨:高赞评论(136 赞)说“本地跑大模型对个体用户来说就是伪命题,买 mac 就是为了 agent friendly”。另一派晒出“128G 内存太爽了,可以布置本地大模型随便跑”。还有 3070 用户在评论区反手一句“60-100 token 每秒,Mac 并不是必须的”。小红书微博
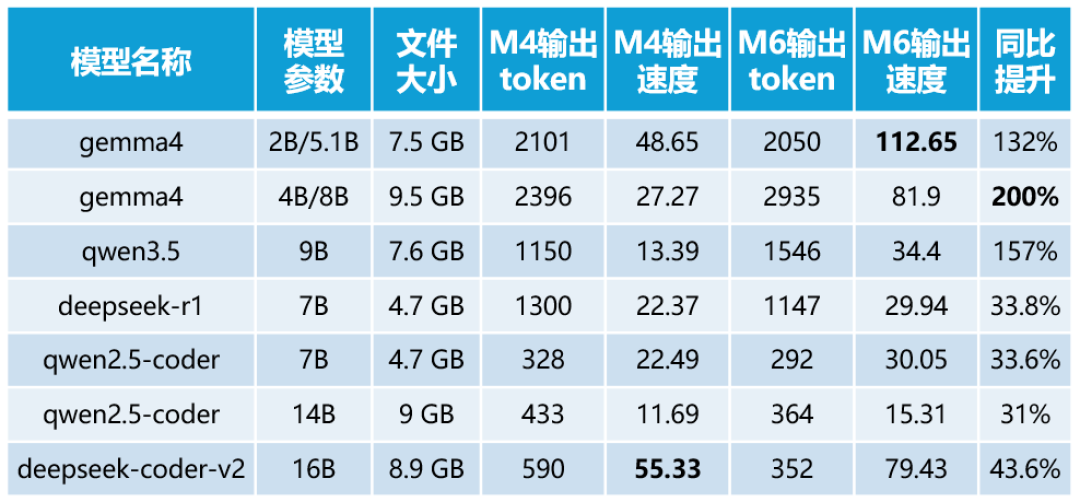
而另一边,OpenAI 买了数万台 Mac mini 和 Mac Studio,Anthropic 在 AWS 上租 Mac 算力——用原文的话说,Mac 的身份正在发生变化,它逐渐从个人电脑变成 AI 基础设施的一部分。入门档也在松动:8 月底发布的 M6 Mac mini 国行 6999 元起,有知乎用户实测本机跑各模型的速度,对比表里相对上一代 M4 最高提升约 200%。36氪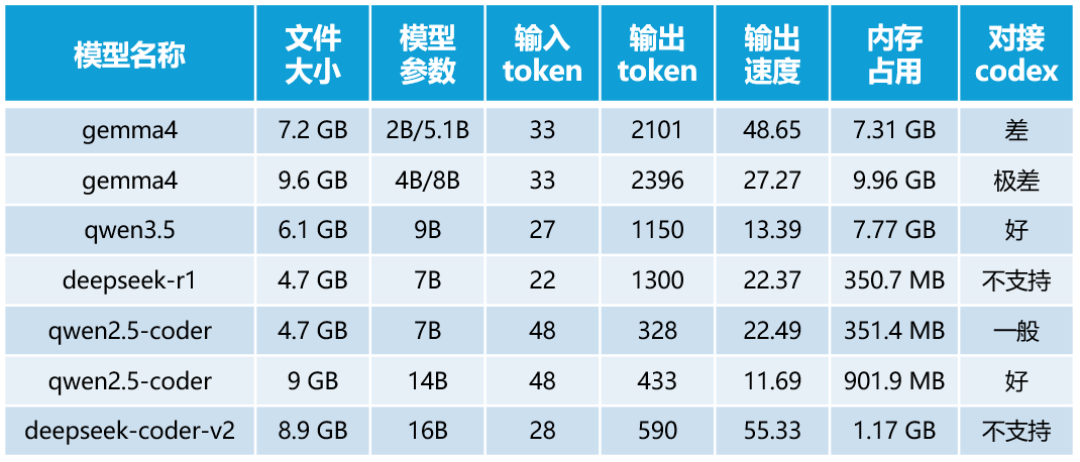
要为这个卖点买单吗?证据目前只够撑到这几句:
冲 27B 档:128GB 也只是“可用线”,一位退了坑的 48G M5 Max 用户临别赠言是“48g 内存下对比 5090 或 4090 没有优势”。知乎
冲 8G/16G 入门档:对照表原话——“8G 内存只适合聊天小模型,别拿它跑编程”。小红书
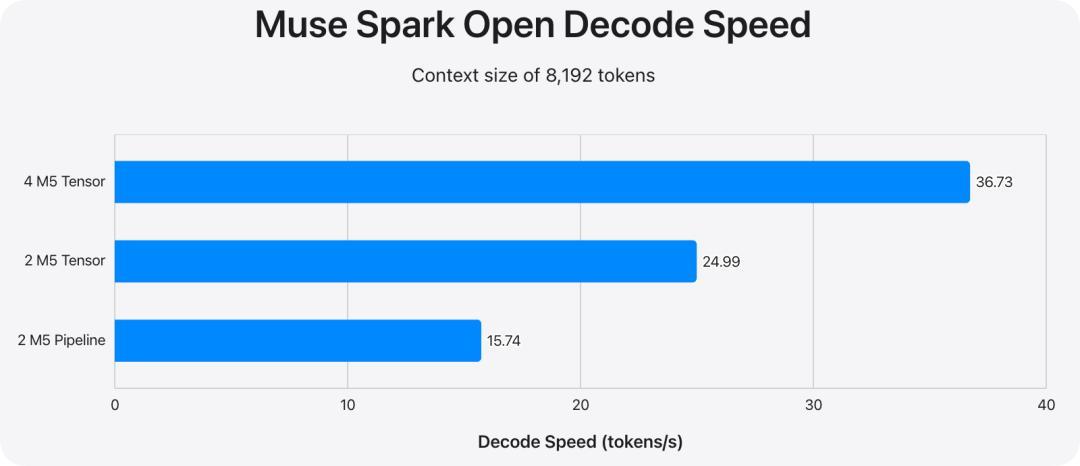
真想跑千亿级:那是另一本账——512GB 的 M5 Ultra Mac Studio 四机集群才跑到 36.73 tok/s、46999 元起,8160 亿参数的模型在桌面上运行,可那是桌面,不是笔记本。36氪
好消息是:爆料称新触屏款继续沿用 M5 Pro/Max 芯片,老机实测数据基本可以直接平移。所以 10 月 30 日预售键按下去之前,你已经知道 12 万买到什么——不是 token 自由,是“一台能慢慢跑 27B 的笔记本,外加发热键盘”。要不要,拿实测数据决定,别拿话术决定。