10月20日,DeepSeek把支撑自家线上服务的推理框架DeepInfer连同Token编解码组件一起开源,许可证是Apache 2.0,并罕见地公开了这套系统的收入账本:单一集群日吞吐155万亿Token,按谷价计算每卡每小时收入38美元。这不是单纯的技术捐赠,而是把行业争论已久的一个问题变成了可验证的实验:当一家公司连“赚钱的机器”都交出去,闭源AI靠信息不对称构筑的优势还守不守得住。DeepSeek给出的答案,与其创始人梁文锋多年前的判断一致:在颠覆性的技术面前,闭源形成的护城河是短暂的。36氪
这次开源的是一整套“会赚钱的工程”
这条开源链路已经拉了两个月:9月10日V4.1-Flash发布时核心kernel同步开源;9月30日适配华为昇腾的编译工具、计算库和分布式通信库官宣开源,与此前面向英伟达平台的组件一一对应;10月17日V4.1-Flash-1017上线;10月20日,轮到通常被视为商业核心的推理引擎。DeepSeek官方账号引用《尹文子》解释动机:为善与众行之,为巧与众能之。微博
DeepInfer的含金量在成本细节里:Prefill(处理输入)用8卡机器、Decode(逐步生成)用64至128卡超节点分开部署;KVCache放进约100PiB的3FS分布式存储,按官方披露,Agent流量的缓存保留3天、聊天流量保留7天。这在行业里是异类——其他家包括Anthropic、OpenAI和Google,同类缓存保留的时间大多在5分钟到24小时之间。36氪36氪
账本公开后最出圈的是一道算术题:按每张B300每小时7美元租金、API利用率足够高估算,这套推理服务的毛利率约82%,Hacker News社区有人把这份公开账本形容为一枚核弹——冷冰冰的数字说明这门生意并没有靠补贴维持。两天后英伟达的回应同样值得玩味:把整套“AI工厂”装进集装箱的DSX POD产品线宣布现场部署周期从传统6个月最短压缩至14天,36氪的说法很直白——配合DeepSeek开源引擎,单卡每小时38美金立刻开赚。买卡、装引擎、出货Token,正在变成一道标准化填空题。36氪36氪
三道机制,解释护城河为什么漏水
第一道:卖出去的输出会反向泄露方法。闭源保护的是权重和训练配方,但对外交付的是API输出本身。每一次调用都沉淀下一条“问题加高质量回答”,对另一家做模型的公司来说就是现成的训练样本——领先者的产品本身在给追赶者喂料,这种泄漏是商业模式自带的,堵不上。知乎
第二道:工程代差的保鲜期被压缩到以天计。DeepInfer开源后不到一周,vLLM在131K上下文、批大小8到256的解码测试中把与官方框架的差距压进6%,预填充吞吐提升35.6%~43.9%。SGLang则把官方没开源的KV缓存系统、Prefill/Decode分离和负载均衡模块一并补齐,在64卡GB300的解码测试中反超约7.4%。更关键的是知乎用户刘景初指出的时间线:所谓“连夜反超”,追平数字主要来自开源前一个多月、基于9月10日就已公开的kernel完成的准备。而DeepInfer本身最初正是基于vLLM构建的——社区与厂商之间的学习是双向的,公开可对照的实现只会让追赶越来越快。对闭源厂商,同样的机制以更高强度运行。36氪知乎
第三道:成本黑箱打开后,高价叙事失去支点。闭源API的溢价长期靠“研发投入巨大”背书;当开源阵营能公开验算出82%的毛利、当推理引擎本身免费可得,“买闭源更贵是因为更贵地研发”就很难再自圆其说。
市场投票:801%的周增长与二十六周的榜首
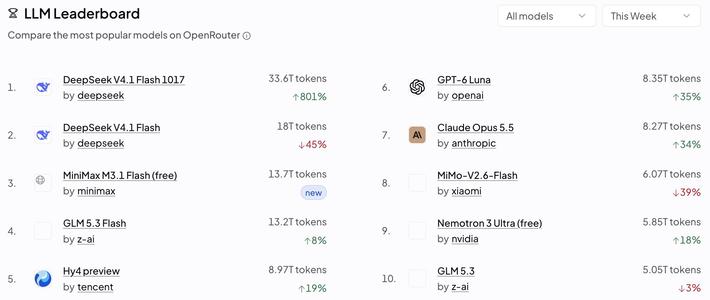
需求侧的反应比评论更诚实。OpenRouter 10月19日至25日的周榜上,10月17日刚更新的V4.1-Flash-1017单周调用量33.6万亿Token,环比暴增801%登顶全球;旧版本因开发者快速迁移,单周环比下滑45%。同一张榜单上,10月19日上线的MiniMax M3.1 Flash以13.7万亿Token排第三,官方披露其推理速度提升近三倍、调用成本下降七成。36氪
把镜头拉远,中国大模型在该平台的周调用量已经连续二十六周高于美国,稳居首位——尽管这一口径只统计聚合API渠道、不含官网、App和私有化部署,趋势仍然清楚:模型的领先窗口正在按周坍缩,竞争重心转向单位Token成本下的有效产出,而这是开源阵营最容易堆人力追赶的战场。
守不住,不等于不存在
梁文锋也说过另一面:把所有东西告诉别人,别人要用起来的门槛依然很高。DeepInfer当前只支持V4.1-Flash一个模型、英伟达SM100与昇腾950两种硬件,完整线上服务仍需配套KVCache系统、视觉编码与Prefill/Decode分离部署,以及跨副本负载均衡等组件。普通用户的体感也没反转那么快:本地量化模型常常只有每秒20-30个Token的输出速度,最难的任务上闭源旗舰依旧守擂,8月SemiAnalysis那份广为流传的报告,结论也只是“开源模型已经几乎追平闭源模型”——追平,不是反超。甚至曾以开源立身的Meta,也在10月推出了闭源Agent模型MuseWonder。微博36氪
所以更准确的说法是:闭源守不住的,是把差距变成永久性围墙的可能性;守得住的,只剩以年和以季度计的领先窗口。在颠覆性技术扩散期,护城河的正确形态不是锁住资产,而是让对手始终追不上你的迭代速度——这正是梁文锋那句旧话的后半句:把价值沉淀在团队和know-how上。下一个观察节点已经出现:10月28日,开发者在DeepSeek官方代码库的测试文件里发现了三个新模型标识,业界预测V5最快11月登场。届时无论闭源阵营交出怎样的答卷,都会被放在同一架公开成本账本的天平上重新称重。微博