





















7
9
换个芯片要重写几个月?现在改一个配置就行
2026-10-20 20:59:11
0点赞
0收藏
0评论
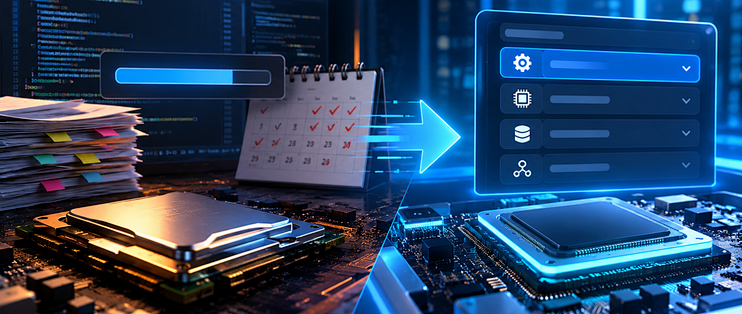
10 月 20 日,加州圣何塞的 PyTorch 大会上,亚马逊开源了一个叫 TorchNeuron 的工具:同一份 AI 训练脚本,只改一个指定芯片的配置项,就能在自家 Trainium 上跑完,代码一行没动。换芯片在过去从来不是改配置这么轻的一件事,英伟达真正在卖的也从来不止那块卡。
换芯片最贵的不是卡,是把代码重写一遍
真正卡住迁移的,往往不是机房账单,是工程师的时间。亚马逊在自己的发布页里写得很直白:把代码挪到新硬件上要重写、要重新验证,而这份工作往往要几个月才能调好。改数据加载、改通信、改算子实现,每一样都得重新跑一遍验证。对小团队来说,这笔时间账甚至能决定产品能不能活到下一轮。
这就是 CUDA 待的位置。它不是一块显卡的驱动,是十多年攒下来的算子库、调试工具和踩坑经验:你写的代码、你同事写的代码、你随手 clone 的开源仓库,默认都长在它上面。按亚马逊给出的数字,今天 85% 的 AI 研究者和开发者用 PyTorch 写代码,而同一份代码能高效跑起来的硬件一直很少。
它没跟英伟达比算力,动的是“注册”那一层
PyTorch 本身留了一个口子:新硬件可以把自己注册成合法后端,注册完就接入同一套编译和调试流程。TorchNeuron 接的正是这个口子,于是开发者平时拿来测试、调试、扩缩容的工具,不改一行就能指向 Trainium。
亚马逊工程师做过一次并排演示:同一个训练脚本,在传统芯片和 Trainium 上各跑一遍,唯一的差别是那行指定芯片的设置,结果两边学到的东西一致,学习速度也相同。
配套的东西也一起放出来了。Hugging Face 已经在自家工具里内置 Trainium 支持,分布式训练能走 TorchTitan 的 FSDP 标准路径,做推理加速的 vLLM 拿到了亚马逊的代码贡献,性能算子整套开源,并且承诺每次构建都跑几十万个模型做回归测试。它支持 Trainium2 和 Trainium3,许可是 Apache 2.0。
还有一步走得更远:亚马逊在往 PyTorch 上游提交改动,把那些让框架绑死在某一颗芯片上的代码删掉。这话听着像给社区做公益,对亚马逊却是稳赚,因为 PyTorch 越不挑硬件,Trainium 越容易被顺手用上。
演示很干净,但有三件事它没说
那个“学习速度也相同”说的是训练收敛,不是跑得快不快。亚马逊没有公布吞吐、每 token 成本、算力利用率这些真正决定账单的数字,而能跑通和跑得划算之间,隔着一整条工程路。
真正会被卡住的,是自己写过算子的团队。用纯 PyTorch 搭起来的模型、标准注意力结构、现成的 Hugging Face 权重,多数改个配置就能动;可代码里一旦有定制的通信逻辑、特殊量化内核或者手写的融合算子,那部分还是得回到芯片文档前一行行改,迁移的深浅全看你离标准路径有多远。
至于 CUDA 十几年的积累,不是一两年能追平的。它在训练和推理两条路上都躺着大量调优过的库,新后端只能一个个补、补一个测一个,亚马逊自己的做法就是每次构建拿几十万个模型压一遍,漏一个会有什么后果他们比谁都清楚。
落到你身上,是一个可以算的判断
如果你只是调用 API 的用户,这事离你隔着好几层,方向却是清楚的:云厂商手里多一条能压成本的硬件路线,推理单价往下走的动力就多一分。
如果你是写代码的人,选型时可以按条件过一遍:代码里绕开 PyTorch 的定制部分多不多,依赖的那些库在 Trainium 上有没有对应实现。这两条都过得去,再谈能不能接受先做一轮性能回归测试、然后决定切不切。前两条卡住,这次发布带来的红利基本与你无关。
真正被改变的,是全球 AI 算力市场的谈判筹码。英伟达的优势一直建立在“换掉我就得重来一遍”这句话上,而现在这句话第一次有了价格:一个配置项,加一轮回归测试。
下一回你在机房账单上看到推理成本那一栏,可以顺便算一算——这笔钱里有多少是付给算力的,有多少是付给“懒得搬代码”的。
作者提示含AI生成内容。作者声明本文无利益相关,欢迎值友理性交流,和谐讨论~